许多 AI 工作负载只需要 GPU 的一小部分。为每个工作负载分配整个设备会导致容量闲置;共享 GPU 可以让平台团队利用现有基础设施服务更多工作负载。
NVIDIA GPU 已支持多种共享方式。多实例 GPU(MIG)将 GPU 划分为对应用程序透明的硬件隔离实例,时间切片允许多个进程轮流使用而不进行内存强制,而 多进程服务(MPS)则让它们在独立的地址空间中并发运行(sm-sharing)。
CUDA 13.4 现在通过一种新的时间共享模式,对应用程序透明地强制执行内存边界,同时保留了 MPS 中已有的计算共享模式(sm-sharing)。
以下是 CUDA 版本 带来的内容:
- 精确内存量: 工作负载请求一个内存大小,CUDA 将其保持在该限制内。超过该大小的分配会失败,就像在较小的 GPU 上一样。
- 一个范围: 工作负载获得一个保证的最小值,以及一个在内存空闲时可以增长到的最大值。
- 一种计算模式: 每个工作负载可以选择使用 sm-sharing 模式来使用其计算资源,而不是使用默认的时间共享模式。
- 透明的内存限制: 每个工作负载只能看到 GPU 内存的一部分。
缺失的一环:从 Kubernetes 入手
CUDA 提供了内存强制能力,但 Kubernetes 集群无法自行使用它。在每个 GPU 节点上,必须有组件来:
- 运行并监督这些功能所依赖的守护进程
- 在进程启动前应用每个 Pod 容器的内存限制和计算模式
- 报告每个分片实际使用的资源,而不是整个 GPU 使用的资源
这项工作属于节点,与哪个调度器放置工作负载无关。
GPU 分片:一个开源 Kubernetes Operator
一个新的开源 Kubernetes Operator,gpu-fractioning,托管在 GitHub 上的 KAI Scheduler 组织下。它与 NVIDIA GPU Operator 一起运行,后者提供驱动程序和容器运行时设置。
GPU Fractioning Operator 处理三项工作:
- 它在每个 GPU 节点上设置并运行 MPS。
- 它应用每个工作负载的内存限制和计算模式。
- 它按分片而不是按 GPU 来测量内存和计算使用量。
调度器如何将 GPU 分配传递给 Operator
开发人员在 Pod YAML 中编写资源和模式注解。然后调度器为工作负载选择 GPU,并在每个容器的 Pod 注解中记录其内存分配和计算共享模式。GPU Fractioning Operator 读取这些注解,并配置分配的 GPU 以应用工作负载的内存限制和计算模式:
表 1:GPU Fractioning Operator 读取以强制执行 GPU 分片的每个容器 Pod 注解
| 注解 | 含义 |
|---|---|
nvidia.com/container.<name>.gpu-memory.request |
保证的 GPU 内存 |
nvidia.com/container.<name>.gpu-memory.limit |
容器可增长到的最大值 |
nvidia.com/container.<name>.gpu-compute.mode |
时间切片(默认)或 sm-sharing |
nvidia.com/container.<name>.gpus.devices |
容器被分配到的 GPU |
任何能够写入这些注解的 Kubernetes 调度器都可以使用 CUDA 强制执行 GPU 分片。调度器仍有自己的职责:选择具有足够空闲内存的 GPU,并且绝不在一个 GPU 上混合计算模式。
将 GPU Fractioning 与 KAI Scheduler 一起使用
KAI Scheduler 是第一个与 gpu-fractioning 集成的调度器。从 v0.18.0 开始,KAI Scheduler 具有一个名为 NvFractions 的 GPU 共享模式。KAI Scheduler 选择每个工作负载获得哪个 GPU 的哪个切片,并写入注解(参见上表 1),而 gpu-fractioning 在节点上强制执行它们。
KAI Scheduler 的其他共享模式仍然可用,管理员为每个集群选择一种。可以在安装 KAI 时启用它:
helm upgrade -i kai-scheduler oci://ghcr.io/kai-scheduler/kai-scheduler/kai-scheduler \
  -n kai-scheduler --create-namespace \
  --set global.nvFractions.set=true
这也会将 gpu-fractioning 作为依赖项安装。从那时起,您可以通过 Pod 注解来描述分片工作负载。
有四个重要的注解,回答四个问题:
1. 需要多少内存
2. 工作负载可以增长到多少
3. 计算如何共享
4. 它跨越多少个 GPU
多少内存:请求
有两种请求内存的方式:
1. 作为绝对大小: 使用每个容器的 NVIDIA 注解和标准 Kubernetes 单位:
容器名称(app)是键的一部分,因此它始终针对正确的容器。
2. 作为 GPU 的一部分,使用 KAI Scheduler 的现有注解:
gpu-fraction: "0.5"
它可以增长到多少:限制
这是 KAI Scheduler 中的新功能。工作负载可以声明一个保证的最小值(请求)和一个在内存空闲时可以突发到的最大值。使用哪个限制注解取决于您如何编写请求:
表 2: 每种内存请求类型使用哪个限制注解
| 请求类型 | 注解 | 示例 |
|---|---|---|
| 绝对大小 | nvidia.com/container.<c>.gpu-memory.limit | “80Gi” |
| 一部分 | kai.scheduler/container.<c>.gpu-memory.portion.limit | “0.8” |
限制是可选的。如果省略,限制等于请求,工作负载被限制在它请求的量。部分限制必须大于 gpu-fraction 且小于 1。
计算如何共享:时间共享或 sm-sharing
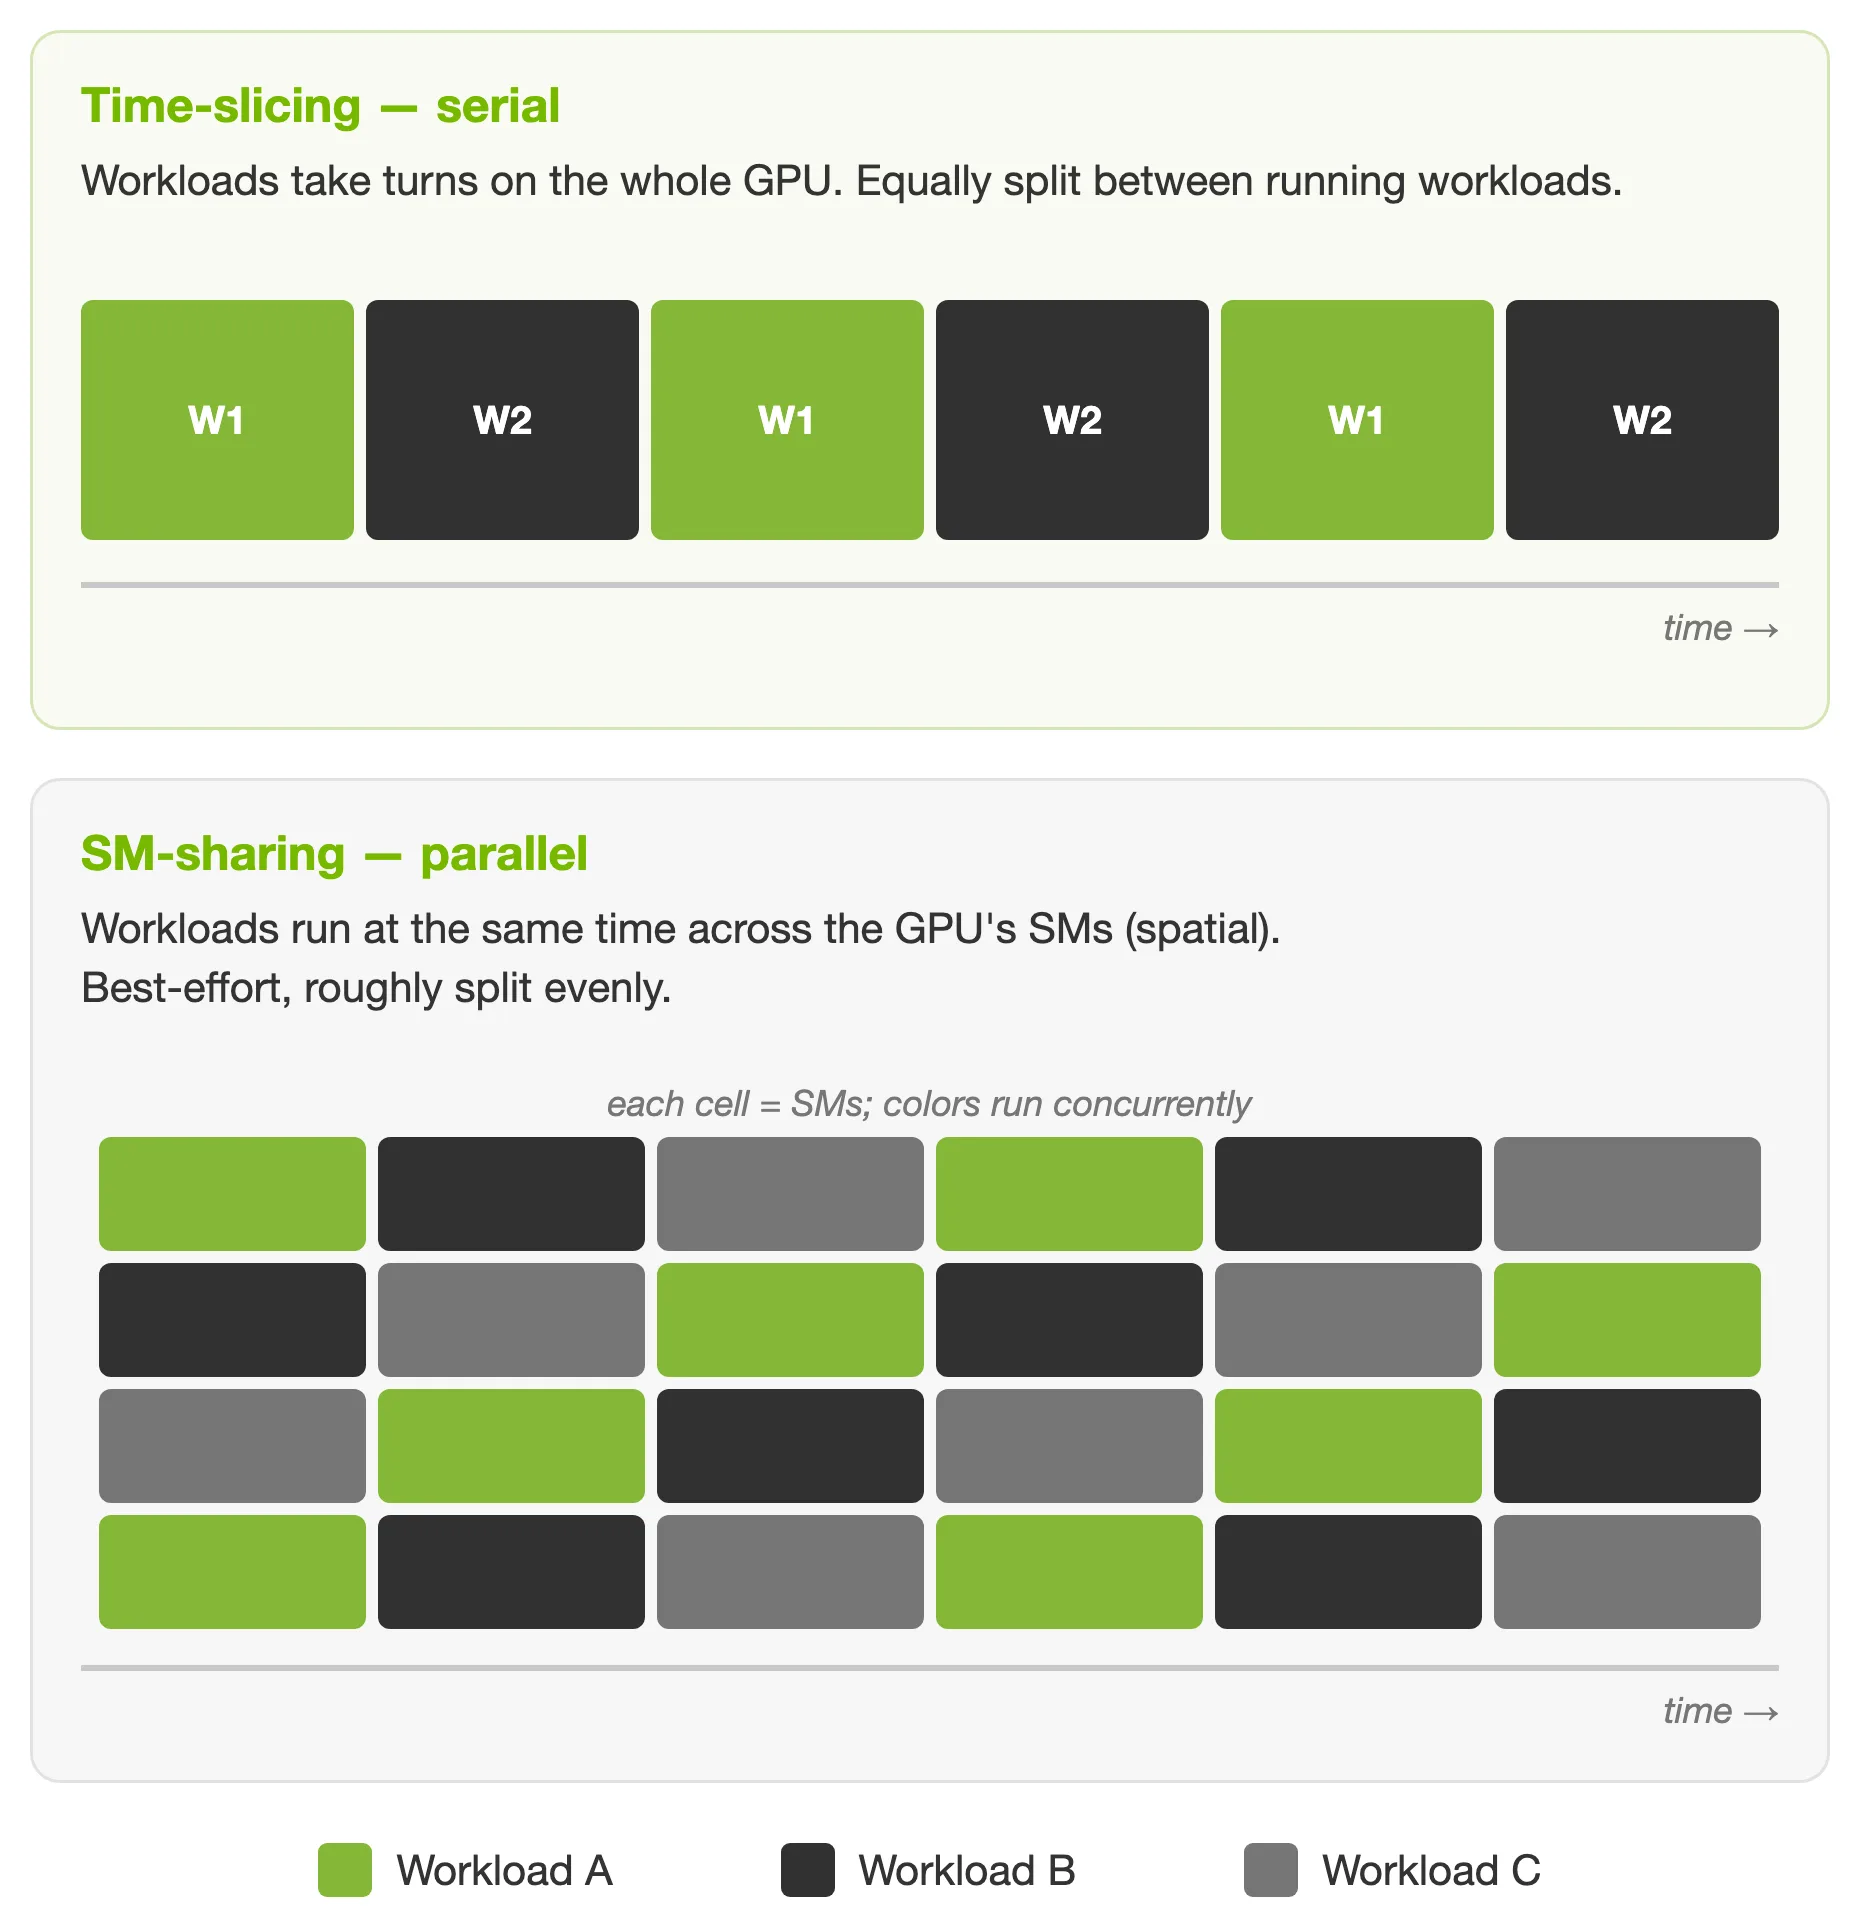
计算现在可以被划分。设 n 为共享一个 GPU 的工作负载数量:无论哪种方式,每个工作负载大约获得 1/n 的计算资源,不同之处在于它们是轮流使用还是一起运行。
- 时间切片是串行的: 工作负载在整个 GPU 上轮流使用,当每个工作负载都使用其完整切片时,每个大约获得 1/n 的时间。一个工作负载未使用的时间在其他工作负载之间平均共享。这是默认值。每个工作负载在自己的错误域中运行,即完全错误隔离。
- SM-sharing 是并行的: GPU 的流式多处理器(SM)在工作负载之间划分,并且全部同时、持续运行。不会预先划分出任何部分。GPU 硬件根据工作负载的需要分配和释放 SM。当每个工作负载都繁忙时,划分大致稳定在 1/n;当某个工作负载空闲时,其 SM 会分配给其他工作负载,而单个活跃的工作负载可以使用全部 SM。在此模式下,工作负载共享同一个错误域。
计算模式现在是显式的,并且可以按容器设置:
nvidia.com/container.app.gpu-compute.mode: "sm-sharing" # or "time-slicing"
共享 GPU 一次只运行一种计算模式,因此 KAI Scheduler 绝不会将时间切片工作负载和 sm-sharing 工作负载放置在同一 GPU 上。KAI Scheduler 按 GPU 而非按节点跟踪这一点,因此一个节点可以在不同 GPU 上同时承载两种模式。
使用了多少块 GPU
要在多个设备上获得分数容量,请添加:
gpu-fraction-num-devices: "4"
该请求适用于每个设备。带有四个设备的 40Gi 请求会在四块 GPU 上各获得 40Gi。
综合起来:GPU 分数化示例
在四块 GPU 上使用 SM-sharing 的绝对大小,并留有突发余量:
apiVersion: v1
kind: Pod
metadata:
  name: inference
  labels:
    kai.scheduler/queue: default-queue
  annotations:
    nvidia.com/container.app.gpu-memory.request: "40Gi"
    nvidia.com/container.app.gpu-memory.limit: "60Gi"       # optional
    nvidia.com/container.app.gpu-compute.mode: "sm-sharing" # optional, default time-slicing
    gpu-fraction-num-devices: "4"                           # optional, default 1
spec:
  schedulerName: kai-scheduler
  containers:
    - name: app
      image: nvcr.io/nvidia/cuda:13.0.2-base-ubuntu24.04
这是一个跨四块 GPU 拆分的推理服务器,每块 GPU 需要保证 40Gi,当邻居空闲时最多可使用 60Gi,并与其他工作负载一起运行而不是等待轮次。SM-sharing 将工作负载放在同一个错误域中,因此请将其用于你信任可以一起运行的工作负载。
半块 GPU,在两块 GPU 上使用时间切片(默认)可增长到 80%:
metadata:
  annotations:
    gpu-fraction: "0.5"
    gpu-fraction.limit: "0.8"  # optional
    nvidia.com/container.app.gpu-compute.mode: "time-slicing"    # optional
    gpu-fraction-num-devices: "2"                                # optional
spec:
  schedulerName: kai-scheduler
  containers:
    - name: app
这是一个用于开发或批处理作业的示例,例如 notebook 或小型微调运行,它们需要保证两块 GPU 各一半的容量,并在内存空闲时可增长到 80%。时间切片为每个工作负载提供自己的错误域,因此一个作业崩溃不会影响其邻居。在容器中运行 nvidia-smi 应显示两块 GPU,每块都具有此工作负载的分数内存份额。
开始使用
KAI Scheduler 和 GPU Fractioning Operator 都在 GitHub 上的 KAI Scheduler 组织 下,包含所有三种共享机制的安装和配置说明(参见 管理员 和 用户 指南)。加入 Slack 频道 或 双周社区会议 来提问和贡献。
有关 CUDA 13.4 的更多信息,请参阅公告。
你也可以在 KubeCon + CloudNativeCon NA 2026 期间参与,该活动于 11 月 9 日至 12 日在犹他州盐湖城举行。