▶ American Sign Language version | Putting sign language AI into users’ hands
▶ International Sign version | Putting sign language AI into users’ hands
我们推出手语转文字(sign-language-to-text,SL2T)模型,这一突破性成果为聋人和听障用户带来全新的手语功能。
近几十年来,AI 处理口语的能力突飞猛进,让自动翻译、听写和对话式界面对听力正常的用户而言变得毫不费力。然而,这场技术革命却没有惠及全世界 200 多种手语,也没有惠及使用手语的约 7000 万聋人和听障人士。
今天,我们推出一款大规模多语言的手语转文字(SL2T)翻译模型,其质量与通用性都实现了突破。借助它,我们首次把手语 AI 从实验室带入消费级产品:SL2T 为 Pixel 11 上 Gboard 和 Live Transcribe 的手语转文字听写功能提供支持,首先支持从美国手语(ASL)到英语。更多设备即将支持,更多语言也会陆续跟进。
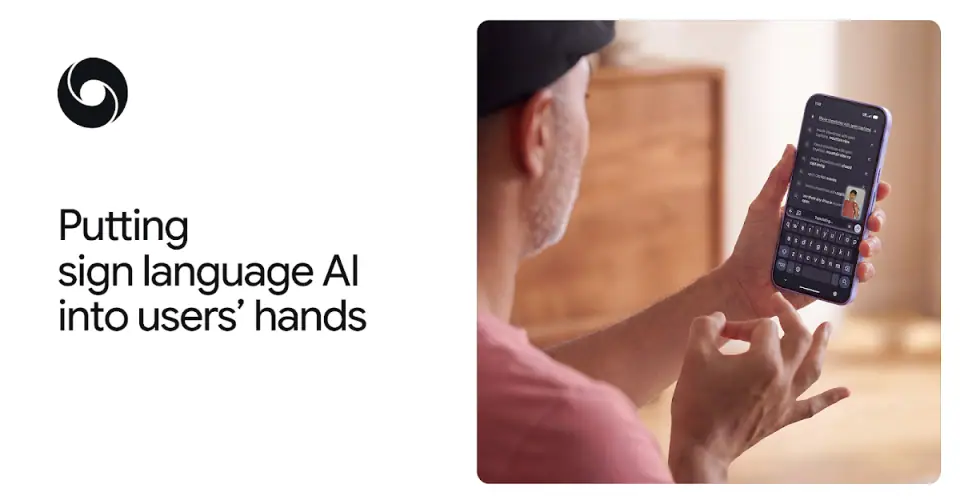
就像听力正常的用户可以用语音听写代替打字一样,这项功能让聋人用户在任何通常需要打字的地方,都可以对着手机打手语。你可以用手语搜索网页、撰写消息或文档,也可以让 Gemini 解答问题或执行任务。在 Live Transcribe 中,你可以在对话里直接用手语回应,不必来回打字。据我们的测试者反馈,用 ASL 手语输入比用英文打字更快、更自然,也更愉悦。
由 SL2T 驱动的手语转文字功能,让用户在任何通常需要打字的地方都可以对着手机打手语。
为什么手语很重要
手语是世界各地聋人社群的主要语言,也是聋人文化认同的基石。聋人在手语、口语、阅读和书写方面的熟练程度差异很大,因此必须支持所有模态的无障碍访问。聋人可以像听力正常的人受益于口语处理那样受益于手语处理,而且这项技术还为弥合聋人与听人社群之间的沟通鸿沟打开了新的可能。尽管这是产生积极社会影响的机会,手语 AI 的进展却一直很缓慢,一方面是因为为手语构建 AI 面临复杂的挑战,另一方面是因为人们对手语本身的运作方式存在广泛的误解。
与口语转写相比,手语翻译面临两大核心挑战。第一,转写语音是在同一种语言内完成从声音到文字的顺序映射,而手语是独立的自然语言,有自己独特的语法和词汇。因此,它需要真正的机器翻译,而不是逐个把手势转换成单词的顺序过程。第二,模型必须学会“看见”并理解肢体动作。手语通过双手、手臂、躯干、头部和面部的同步动作来传达意义,要以高帧率准确追踪这些动作,是一项困难且计算量很大的计算机视觉任务。
了解这些背景,就不难明白为什么手语手套等早期手语技术尝试存在根本性的局限:手语并不只是“用手比划的英语”。它们既需要对精细的全身动作进行复杂的视觉感知,也需要完整的语言翻译。SL2T 的设计目标就是同时做到这两点。
SL2T 把手语输入看作打手语者身体上的一组点,并将其翻译为流式文本输出。示例来自 FLEURS-ASL 基准测试。
SL2T 如何工作
我们构建 SL2T 的方式,是将以用户为中心、具有文化意识的方法与大规模数据扩展相结合。模型在涵盖 50 多种手语、超过 10 万小时的数据上训练,其中约四分之一为 ASL 数据。在不同语言、方言和熟练程度上联合训练,使模型能够学到共享的底层结构,在我们的实验中表现优于单语言模型。
为了保护用户隐私,SL2T 看到的手语是一串姿态关键点位置,而不是原始的摄像头画面。设备端模型(MediaPipe Holistic)负责追踪打手语者身上各点的位置,只有这些几何坐标会被发送到服务器进行翻译,原始视频则可以立即丢弃。
SL2T 直接把这串坐标序列翻译成文本,绕过了此前手语翻译研究中广泛使用的中间标注“手语注释(gloss)”。Gloss 无法捕捉手语中丰富的非线性特征,例如非手控标记和空间构造。直接从关键点翻译,消除了人为的词汇量限制,使翻译质量可以随数据量直接提升。
根据 FLEURS-ASL(sd-test)等关键基准测试,SL2T 是迄今能力最强的手语翻译模型,该基准评估的是 ASL 到英语的翻译质量。SL2T 取得了 70 BLEURT 的出色零样本成绩,显著高于此前报告的任何成绩。但仅仅针对学术基准测试进行优化,并不能保证在真实应用中好用,所以我们在一些实际问题上下了很大功夫:尽量降低流式延迟,避免在非手语输入上产生幻觉,确保对占 10% 的左撇子打手语者公平,以及提升单手打手语的表现,因为用户在使用手机时另一只手要拿着手机。
来自 FLEURS-ASL 基准测试的示例。SL2T 能把复杂的 ASL 准确翻译成流畅的英语。在罕见手势、快速指拼("prey" → "grey")、被动结构、类标记描绘(漏掉了 "claws")以及缺少上下文的时态("kicked off" → "start")上,偶尔仍会出错。
| 英文原文 | SL2T 的 ASL → 英语输出 |
|---|---|
| 库克群岛没有城市,由15个不同的岛屿组成,主要的岛屿是拉罗汤加岛和艾图塔基岛。 | 库克群岛没有城市,由15个岛屿组成,两个主要岛屿是拉罗汤加岛和艾图塔基岛。 |
| 比赛上午10点开始,天气极佳,除了上午晚些时候下过一阵很快就停的毛毛雨,这是适合打七人制橄榄球的完美一天。 | 比赛在天气极佳的上午10点开始。早上有一阵小雨,随后很快放晴。这是适合打七人制橄榄球的完美一天。 |
| 在美国和加拿大等一些联邦制国家,联邦和地方两级都会征收所得税,因此税率和税档可能因地区而异。 | 在美国和加拿大等一些联邦制国家,联邦和地方两级都会征收所得税。这意味着税率和税档会因所在地区而不同。 |
| 据信,这种全身长满羽毛的温血猛禽用两条腿直立行走,脚上长着类似伶盗龙的爪子。 | 这种生物是温血动物,吃灰色的东西,全身覆盖羽毛。据信它像伶盗龙一样用两条腿行走。 |
| 也许有一天,你的曾孙辈会站在一个外星世界之上,思索着他们远古的祖先? | 也许有一天,你的曾孙辈会站在外星世界上,追思他们的祖先。 |
与社区共同构建
我们相信要与聋人社群共同构建,而不只是为他们构建。聋人的视角塑造了这个项目的每个阶段:从聋人 Google 员工 Sam Sepah 提出构想,到与聋人合作伙伴一起收集数据,在聋人用户研究中进行评估,再到邀请聋人专家评估这项技术的影响。
为了指导负责任的真实世界部署,我们成立了 AI 手语咨询委员会(AI Sign Language Advisory Committee,AISLAC),汇聚了众多全球聋人组织和领域专家。通过这种参与式治理模式,受我们技术影响最大的社群可以直接左右我们的开发优先级。针对 SL2T 1.0 在 Gboard 和 Live Transcribe 中的发布,我们共同撰写了一份联合影响报告,坦诚详述了这项技术的能力和当前的局限,今后所有重大手语版本的发布,我们都计划延续这种协作方式。
展望未来
SL2T 建立在学界和业界数十年基础研究之上,但让 ASL 输入走进用户手机,只是一个开始。Google 的使命是整合全球信息,使人人皆可访问并从中受益。实现普遍的无障碍访问,意味着要与口语和书面语言完全对等。我们的团队正致力于把这项技术扩展到更多手语、手语生成以及前沿 AI 能力上。我们期待以负责任的方式分享进展,让通过手语获取信息成为整个数字世界的标准。
你可以首先在 Pixel 11 上的 Gboard 和 Live Transcribe 中体验 SL2T,更多设备即将支持,且无需额外付费。
致谢
这项工作由 Google DeepMind 和 Android 团队联合完成。开发 SL2T 模型的核心团队成员有:Garrett Tanzer、Benoit Brard、Elizabeth Clark、Tim Dozat、Sebastian Ebert、Dan Garrette、Manfred Georg、Vicky Holgate、Shankar Kumar、Mohammad Saboorian、Miloš Stanojević、Megh Umekar、John Wieting、Andy Zhang 和 Chris Dyer。
将该模型集成到 Gboard 和 Live Transcribe 的 Android 团队成员有:Ausmus Chang、Sai Aditya Chitturu、Dayle Chiu、Anna Chou、Ajay Dudani、Angana Ghosh、Alex Huang、Joanne Kim、Ed Lee、Thomas Lin、James Su、Yanchao Su 和 Sharlene Yuan。
我们还要感谢以下人员提供的额外支持:Anelia Angelova、Abhishek Bapna、Sara Basson、Glenn Cameron、Scott Crowell、Trevor Cohn、Noah Fiedel、Zoubin Ghahramani、Raia Hadsell、Tom Hudson、Alexander Hauerslev Jensen、Kazuya Kawakami、Phoebe Kirk、Peike Li、Liam McCafferty、Caroline Pantofaru、Abhinav Parashar、Christopher Patnoe、Laura Rimell、Sagar Savla、Sam Sepah、Thad Starner、Dave Uthus 和 Biao Zhang。
我们同样要感谢 MediaPipe Holistic(Google AI Edge)团队:Ivan Grishchenko、Artsiom Ablavatski、Valentin Bazarevsky、Esha Uboweja、George Sung、Jonathan Baccash、Gregory Karpiak、Sebastian Schmidt、Suril Shah、Raman Sarokin 和 Juhyun Lee。
同时也非常感谢参与我们模型早期测试的各位。