AI Agents 现在为数百万人上网执行操作。对于网站来说,Agent 可以呈现多种形式。它可能与执行任务的人类用户无法区分,也可能看起来像一个访客代表许多用户。这使网站失去了识别、服务并追究 Agent 背后用户的能力,并在出现问题时让网站承担成本。本文认为,为了让网站最大化向 Agent 提供的访问权限,生态系统必须开发新机制来维护网站与用户之间的关系。传统上,在安全和欺诈预防领域,这需要三样东西:身份、声誉和问责制,使网站能够回答:行为者是否如实说明了自己是谁?这个人是否可信?以及谁对行为负责?
“个人 AI Agents”(简称“Agents”)是从人类(“用户”)接收指令并通过控制云计算机或浏览器来追求目标的自动化程序。它们通常由“运营商”作为托管服务或消费者产品的一部分进行托管和维护。例子包括 Meta 的 Muse 和 OpenAI 的 dots,而且新的产品不断推出。Agents 可能采取其用户能采取的任何在线操作,而不受限制人类的那些限制。它们不会疲劳,全天候运行,并行行动,并忍受没有人会忍受的摩擦。网络的许多方面,从网站规划容量到如何赚钱,都假设了这些限制的存在。
从根本上说,远程托管的 Agents 是中介。中介是任何位于用户和网站之间的东西,因此网站看到的是它而不是用户。Agents 是最新类型的中介,但中介已经存在很长时间了。云浏览器(由软件代表用户控制的托管浏览器)和代理(中继用户流量的服务,包括 VPN)也是中介。改变的是轨迹。Agentic 流量正在快速增长,并可能在不久的将来超过互联网上的传统人类浏览。这迫使今天运营网站的任何人进行反思。历史上,网站可以简单地阻止中介流量并要求用户禁用中介服务。当大多数流量是 agentic 时,这种方法就不再有效。一旦阻止不再可行,网站运营商就面临中介一直造成的问题。网站失去了关于用户的直接信息,必须决定是否在没有这些信息的情况下信任中介。
本文涵盖托管在用户设备以外地方的 Agents。本地 agents(例如 OpenClaw)或在用户自己的浏览器、自己的设备上运行的 Agents 不在本文主要讨论的主题范围内(见下文“关于开源和本地 Agents”)。
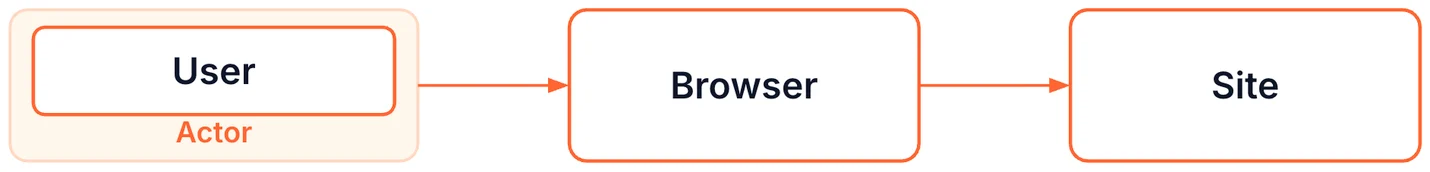
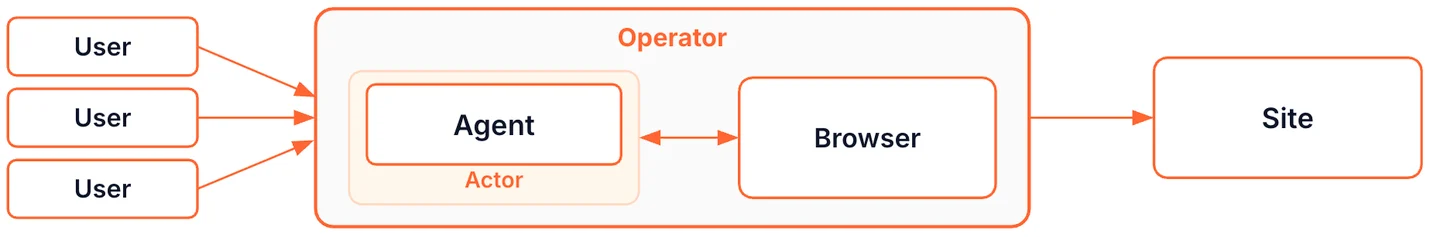
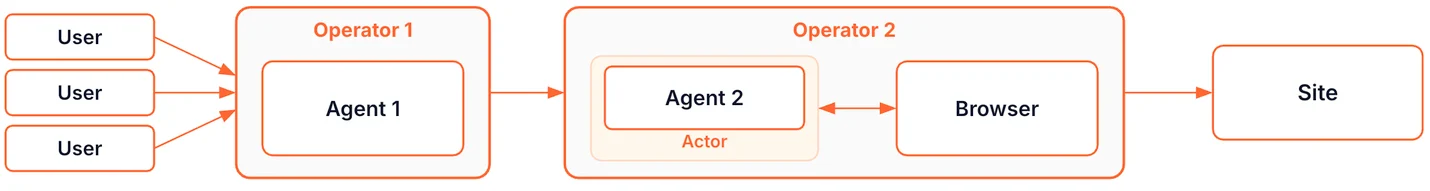
本文基于一个原则:
中介原则:用户与网站之间的业务关系,以及每个参与者的安全责任,无论是否有中介,都必须得到维护。
网站需要新工具来识别、服务并追究通过 Agent 行动的用户,就像该用户直接访问时一样。Agent 及其背后的运营商也必须可识别和可问责,因为 Agent 能做任何用户都做不到的事。Agents 能够几乎无限制地扩展人类访问,因此它们创造了新的风险,即使是以前无害的行为也是如此。
中介问题
认识一下 Ezra。Ezra 为她所在城市的人们担任私人助理。她最好的客户是当地 CEO Amy,但她也为 Bob、Charlie 和 Debra 工作。她为他们跑腿:杂货、预约、文书工作和航班。Ezra 融入人群。
街角杂货商过去认识 Amy。他知道她买什么,并把她可能喜欢的东西留出来。现在只有 Ezra 进来,带着四个人的订单,杂货商分不清谁是谁的偏好。他不想拒绝 Ezra,因为她给他带来了很多生意。
然后 Bob 让 Ezra 给他买一部 iPhone。一周后,他打电话给商店,说他从未授权这笔费用,并保留了手机。为了赢得争议,商店必须证明 Bob 要求了它。但商店唯一见过的人是 Ezra。
然后 Charlie 给 Ezra 一份密码列表:“我忘了我的,但它是其中之一。”Ezra 在 Charlie 的银行耐心地尝试每一个。银行可以看到攻击正在发生,但它唯一能禁止的人是 Ezra。禁止 Ezra 也会禁止 Amy、Bob 和 Debra。
这些企业主都没有对 Ezra 本人有意见。他们的问题是,他们只能看到 Ezra,而不是她代表的人。把 Ezra 换成 AI Agent,把企业换成网站,你就有了今天的网络。
网站所有者希望有足够的可见性,既能防止不良行为,又能有效地通过其网站获利或获取价值。但就像 Ezra 一样,大部分可见性随着 AI Agents 而消失。下面列出了网站所有者可能希望解决的操作,这些操作以前已经解决,但允许 Agents 后变得更具挑战性。
| 挑战 | 网站所有者的目标 |
| 账户共享 | 网站需要确保一个付费订阅不被滥用来服务许多用户。通过 Agent 访问时,网站看到一个账户和一个客户端。 |
| 合规和非法活动 | 网站必须满足法律要求以验证其用户的信息。例如,一些网站有年龄或地理限制。 如果允许 Agent 访问,Agents 不提供能够满足网站保持合规标准的保证。 |
| 友好欺诈 | 友好欺诈是指用户批准了 Agent 的购买,随后又以未经授权为由提出争议。网站可能凭借间接证据胜诉:与用户过去无争议购买相同的设备、IP 和地址。Agent 的购买来自 Agent 的基础设施,因此这些证据并不存在。即使网站胜诉,争议本身也会产生成本。 网站需要出于防欺诈目的保留结账行为记录。维护这些记录有助于网站减少额外验证带来的整体摩擦,并降低交易拒付率,最终带来更多结账量。 |
| 人工验证无关紧要 | 网站希望能够区分其所拥有的用户类型。CAPTCHA 和其他人工验证用于检查控制浏览器的实体是否为人类。 Agent 从不被期望是人类。将此信号传递给人类用户的方案不会增加新信息,只会降低 Agent 的效率。 |
| 身份欺骗 | 网站希望将内容访问限制为人类用户,或对特定用户可访问的内容施加限制。Agent 通常运行在住宅 IP 上并使用真实浏览器,与人类引导的流量混杂在一起,并努力不将自己与人类流量区分开来。攻击者会复制知名 Agent 的 user agent 字符串,以获得相同的许可。 |
| 身份验证失效 | 网站可能要求对用户身份或其他信息进行额外验证,以便提供对敏感操作或内容的访问。活体检测、KYC 身份检查和类似机制假定在场的人就是被验证的人。Agent 从来不是那个人。网站必须接受由 Agent 传递的验证(这会削弱检查)、拒绝 Agent,或放弃检查。 |
| 错位 | 网站可能希望保护自己免受较新或更具实验性的 Agent 所采取的错误操作的影响。 Agent 会犯错:错误的商品、错误的日期、重复的订单。网站可能通过退款和支持来吸收成本,以维持客户好感,却无法分辨哪些 Agent 是可靠的。 |
| 策略规避 | 网站希望实施基于身份的策略(例如阻止、仅允许合作伙伴、速率限制),但 Agent 并不总是表明自己的身份,而且它们通常不携带其所代表的用户的信息。 |
| 资源耗尽 | 提供免费服务或依赖用户参与度的网站,在设计时通常假定用户行为存在限制。 Agent 会不断轮询(例如库存和价格检查)、访问昂贵的端点(例如搜索、库存或支持聊天),并耗尽免费试用和促销活动。 |
| 基于风险的认证失效 | 网站希望维护其基于风险的认证系统,该系统期望设备、位置和行为与用户匹配。Agent 运行在云基础设施上,每次看起来都不寻常。 |
| 流量混杂 | 网站希望保护自身和用户账户免受滥用或欺诈活动的影响。当一个用户滥用共享 Agent 进行撞库、抓取或信用卡测试时,网站可以检测到滥用行为,但只能封禁该 Agent,这同时也会封禁其所有合法用户。 |
| 未经授权的持卡人使用 | 网站和支付提供商需要保护持卡人免受未经授权的交易,同时尽量减少争议成本和其他与欺诈相关的成本。 当授权用户在卡上进行购买时,持卡人承担责任。如果持卡人将卡交给非授权用户,他们仍对交出卡承担责任。Agent 没有授权用户身份,因此网站无法判断用户是否支持此次购买。在实践中,当用户提出争议时,网站承担损失。 |
| 无补偿消耗 | 通过内容变现的网站需要能够查看并控制谁访问该内容,以便应用正确的变现模式。 Agent 读取或提取内容(文章、产品数据、评论),以便在其他地方回答用户。网站为提供内容付费,却得不到访问、广告展示或购买。 |
| 用户归属 | 网站向同意的用户提供关于个性化、推荐和忠诚度计划的额外能力,使用与用户会话和设备绑定的分析。Agent 流量要么将许多用户归入一个客户端,要么完全不带用户会话出现。 |
在上述几乎每一项挑战中,网站都承担主要成本。这一结果源于涉及中介时信任的运作方式。
我们的愿景
我们的目标是打造一个互联网,让所有用户对网站的访问权限等于或大于以往。在 Agent 出现之前,网站通常能够通过一系列技术来缓解这些风险,包括对用户设备、会话和历史进行指纹识别。用户仍然可以使用隐私浏览模式进行浏览,我们认为 Agent 也应该能够这样做。但它们可能无法在没有额外验证的情况下登录银行。
这一切都不需要 Agent 表现得像人类,也不需要每个操作都有人类在场。它要求网站有办法获取或要求提供用户信息,以便在适用时追究用户的责任,无论是否有 Agent 参与。
人们尝试过什么,以及为何不够
一个常见的提议是让 Agent 将网站的 CAPTCHA 传递给用户来解决。这只能证明那一刻有某个人类在场(“human in the loop”,即 HITL),仅此而已。HITL 主要是一种防止错位导致错误的机制。错位是 Operator 与用户之间的问题,解决它并不能解决上述大多数问题。例如,它无法将 Bob 与其他人区分开来(流量混杂),也无法说明 Agent 在其他时间代表谁。此外,Agent 的存在是为了消除摩擦,而 HITL 又增加了摩擦,因此 Operator 有动机为用户移除或绕过它。
另一种常见的提议是使用严格限定范围的访问控制。Agent 被构建为能够执行用户所能做的一切,因此实践中它们会请求并获得执行一切操作的权限。范围为“一切”的授权对网站来说毫无信息量。而且即便是狭窄的范围,也只说明了 Agent 被允许做什么,并没有说明当 Agent 出错时由谁来承担责任,而这恰恰是网站真正需要回答的问题。
网络需要什么
网络需要工具和协议,让网站与 Agent 能够协作确定允许哪些行为和操作,并让网站向 Agent 表达偏好与策略,且所有这些都要以所有网站和 Agent 都能合理支持的方式实现。幸运的是,所有这些方向上的工作已经在进行中,而且其中许多(即便不是全部)都可以通过应用现有标准来解决。
协议
Agent 与网站可以参与明确的协议来解决上述部分问题。例如,MOLE 是一种即将推出的方法,旨在无需用户特定标识符的情况下实现速率限制,让网站能够从隐式身份转向使用显式协议来达成同样的目标。这与 x402 protocol 类似,后者旨在实现网络支付的同时保持隐私保护。我们正在积极探索如何利用现有协议来解决其他问题,并在现有方案不足时探索设计新协议。
身份
在讨论 Agent 身份时,Web Bot Auth(WBA)是我们首选的方法。WBA 允许 Agent 对其请求进行签名,为 Agent 提供了一种安全的自我标识方式(并隐含地标识 Operator)。我们仍需定义一种支持多重中间方的机制:当 Agent A 在浏览器 C 中使用 Agent B 时,网站需要能够知晓这一点,以便网站能正确地确保对 Agent A 的访问被正确理解和控制,例如为了防止策略规避。
根据具体情境,可能还需要其他类型的标识信息,例如会话、账户,甚至用户特定的 ID。我们正在与相关标准组织合作,探索传达此类标识信息的方式。
让我们来看看与用户相关的身份类型。归根结底,身份是一个光谱,它在用户信息的不同程度上进行权衡,同时理想情况下践行数据最小化原则。身份为我们提供了一种回答“你是谁?”的机制,以进一步回答后续问题:“你是否如你所说的那样?”以及“我们能否信任你?”。
在许多情况下,并不需要标识信息,而用于调节 Agent 访问的隐私保护方法(例如通过 Privacy Pass 和 MOLE)可以帮助我们在无需回答“你是谁?”的情况下回答“我们能否信任你?”。Private Access Tokens 是我们早期尝试在不识别用户的情况下建立信任的一种方式,而 MOLE 旨在成为该技术的后继者。然而,在某些情况下,需要沿着这一光谱采用渐进式的披露形式,通常可以按以下方式加以描述:
- 无 - 用户可以在不提供任何标识符的情况下在互联网上活动。
- 会话 - 网站需要某种方式将同一会话中的请求关联到单个 Agent。这使网站能够为给定会话建立声誉并据此采取行动。例如,Poppy 正是为此目的而设有会话 ID 的概念。
- 账户 - 网站需要一种方式将跨会话的请求归属于同一用户。这可能是由 Operator 或第三方分配给用户的稳定标识符,在与 Operator 的账户中持续存在,例如单个 Agent 每天使用同一标识符访问同一网站。这将支持的一个示例用例是:“将你的网站账户绑定到你的 Agent 账户”。
- 唯一 - 某些网站可能要求由第三方提供的、跨 Operator、账户、Agent 和会话持续存在的唯一用户标识符。这对于高风险操作可能有用,或者对于需要为昂贵资源提供有限访问权限、或有非常严格的义务或合规要求的网站有用。政府 ID、第三方身份验证以及像 Proof of Human 这样的去中心化技术,都是可以提供此类标识的技术示例。
归根结底,网站决定需要哪些信息来让客户端回答“此请求背后的实体此时是否被允许执行此操作?”在许多情况下,传达此信息的协议已经存在或正在开发中:WBA 用于传达 Agent 的平台身份,MOLE 用于传达用户声誉,OAuth 用于传达账户身份,等等。
声明
除身份之外,某些操作需要关于真实个人的事实,例如年满 18 岁或是持卡人(身份验证失效、友好欺诈)。通常 Operator 在注册时已验证这一点,或者第三方已拥有此信息。
为了让 Agent 能够访问带有此类限制的网站或操作,我们需要机制让网站请求此信息,并让 Operator 或第三方提供此信息。
网站 Agent 访问策略
如今,Agent 通过尝试某些操作并解读网站响应(通常是是否被阻止)来推断网站的规则。这浪费了双方的资源,在某些情况下还会让诚实的 Agent 显得恶意。Robots.txt 说明了爬虫可以去哪里,但并不完全适合表达 Agent 可以做什么。
网站需要一种机器可读的方式来发布允许 Agent 执行哪些操作。互联网工程任务组(IETF)正在积极研究一些偏好表达机制,主要在 AI Preferences Working Group 中进行。然而,该工作组的重点在于表达使用偏好(例如训练、推理和搜索),目前仍没有一个工作组专注于这里讨论的更大范围的偏好表达机制需求。
关于开源和本地 Agent
不以“中介”形式运行的 Agent(例如设备上的 Agent,或本地托管的 Agent,如 OpenClaw)引发了不同的担忧。主要是,它们看起来像(并且确实是)自动化程序,并且没有单一实体来建立声誉或承担责任。
对此有许多解决方案,其中之一是要求这些 Agent 提供唯一 ID。然而,解决这个问题并不是 Trusted Agent Delegation 的初始重点。
下一步是什么
网站所面临问题的现实解决方案不会来自碎片化的、供应商特定的机制。它们需要植根于现实世界经验的开放、可互操作的标准。我们一直并继续积极与主要 Operator、身份验证公司、支付提供商、商家、出版商、代理提供商和云浏览公司等整个生态系统合作,将运营需求直接与 IETF 及其他地方针对这些问题的积极工作对齐。
我们的重点是在运行代码与新兴规范之间架起桥梁,涉及 Web Bot Auth、AIPREFs、OAuth、WIMSE 和 MOLE 等工作组和活动。我们部分通过共同编写和完善 WBA 和 MOLE 等开放协议,并大规模构建和部署这些协议的实现来实现这一点。
我们还宣布成立 Trusted Agent Delegation(TAD)联盟。TAD 的目标是汇集整个生态系统的代表,讨论本文档提出的整体问题集,审查所有现有协议,然后根据需要将更明确的问题提交给 IETF 解决。我们打算未来在 IETF 举行边会并举办研讨会以促进讨论。
如果您正在构建 Agent、Agent 运行时、运营边缘或云平台,或管理商业或合规应用程序或基础设施,我们需要您也参与这些工作。查看 此页面 了解如何参与的更多信息。
您现在可以做什么
我们的目标是建立一个开放、可互操作的基础,从 TAD 开始。但您不必等待新协议来开始重新获得可见性和控制权。截至 本周,Cloudflare 客户可以采取三个具体步骤:
查看您网站上有哪些 Agent,以及它们在做什么。Security Analytics 现在将个人助理作为独立的流量类别列出,并且一个新的小部件会列出访问您网站的每个 Agent、每个 Agent 发送的请求数、访问的路径以及遇到的错误。无法解释的自动化流量变成了您可以分析的流量。对于 AI 爬虫和机器人如何影响您业务的更广泛情况,包括每个 Operator 爬取多少与它发回多少流量,Enterprise Bot Management 客户可以使用 Business Insights。
按您的条件为每个 Agent 设置访问权限。使用 AI Crawler and Agent access policies,您可以欢迎为您带来业务的 Agent,并限制那些不带来业务的 Agent——允许 Agent 访问整个网站,仅在有广告的页面上阻止它,或完全阻止它。您的搜索和训练策略保持独立。
将 Agent 与其代表的用户关联起来——并据此采取行动。对于使用 Account Abuse Protection(早期访问)的网站,现在每次登录和注册都会显示是否是个人 Agent 发起的请求,以及是哪个 Agent。当攻击者在一个账户上滥用共享 Agent 时,您可以缓解该账户——通过对其 Hashed User ID 应用 WAF 规则——而不会阻止该 Agent 为其他所有合法用户服务。这是对上述 流量混合 挑战的第一个具体答案:您终于可以透过 Agent 看到用户,并相应地做出响应。
这些是愿景的第一批构建模块,已经投入生产。随着标准的成熟,还会有更多。
如果您的公司对 Agent 有更严格的立场,我们很乐意听取。请直接联系我们并分享您的问题。我们希望帮助构建一个互联网,让网站所有者拥有可见性和控制权,同时 Agent 在这些控制范围内拥有最大合理访问权限。您可以联系您的客户支持团队,或发送电子邮件至 crawlercontrols@cloudflare.com。