当我们在四月发布关于 AI 代码审查器的博客文章时,一次平均审查的成本是可接受的 1.19 美元。到八月底,这个数字飙升至约 2.46 美元。我们并没有做出任何重大的架构变更:协调器仍然将工作交给同一组专业审查器,同样的风险等级决定了我们进行审查的强度。
九月中旬左右,我们让智能体找出这些 token 都去了哪里,并大幅削减它们。在代码质量设为高投入的情况下,现在一次平均审查的成本仅为 0.77 美元,比我们开始之前最昂贵的两周平均 2.43 美元下降了 68%。我们的主要目标是降低成本,但作为这项工作的一部分,我们还成功优化了审查器,使审查的中位耗时从之前的 4 分 09 秒缩短到现在的 1 分 32 秒。
约 40% 的节省来自对审查器代码的更改和优化,其余来自试验我们使用哪些模型以及它们投入多少精力。
一次审查的成本如何翻倍
下图显示了自三月以来每个工作日一次平均审查的成本。它固定了审查等级的构成,因此大型审查较多的一天不会使数据产生偏差。
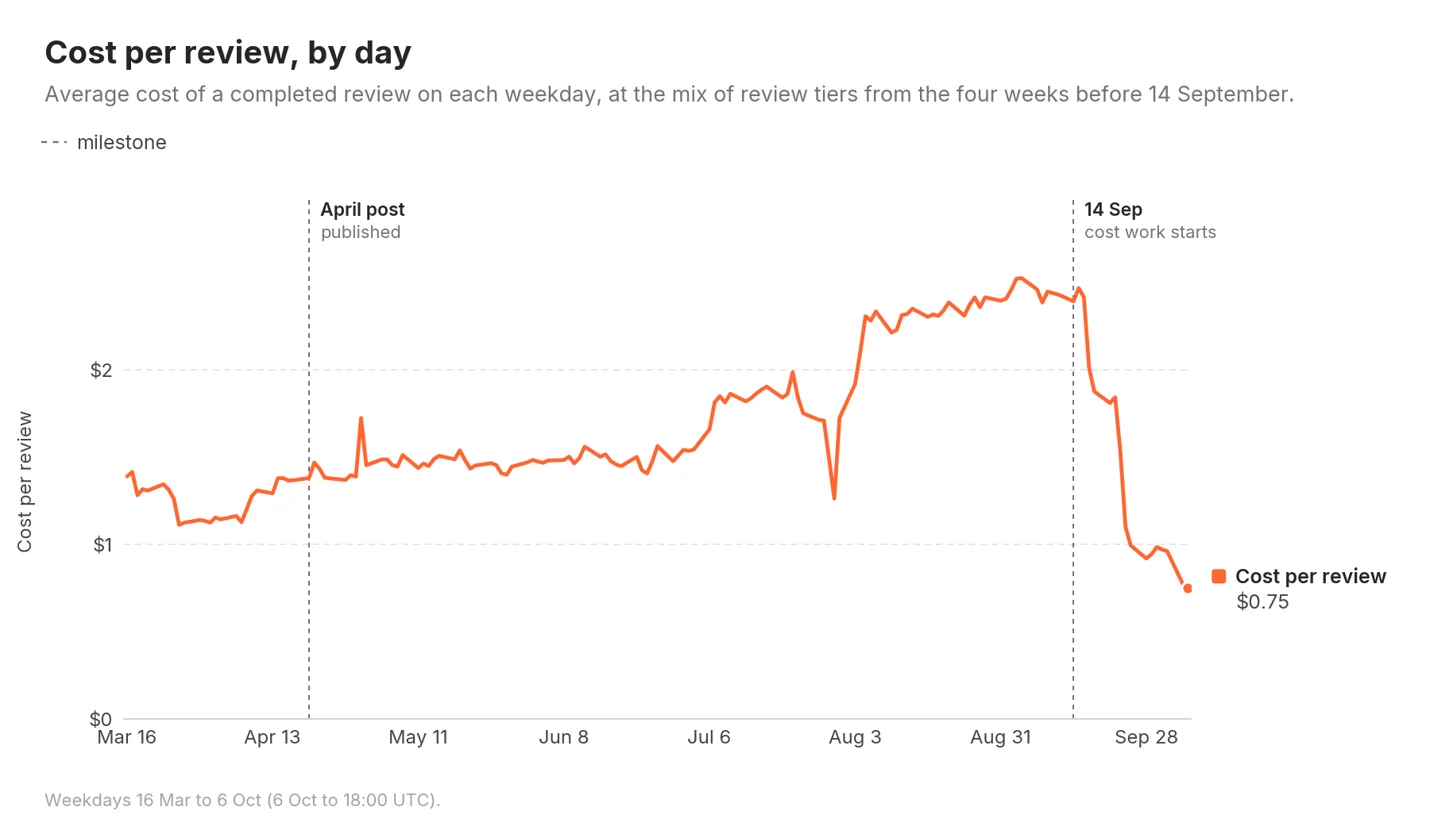
每次审查的成本稳步上升,从 1.22 美元(三月)→ 1.44 美元(六月)→ 1.74 美元(七月),最终升至 2.32 美元(八月)。其中一小部分原因是更多审查落入了最昂贵的等级(三月为 59% 的审查,八月为 65%)。我们认为对此有一个简单的解释:模型正变得越来越好、能力越来越强。自然,工程师们正在产出更大、更复杂的变更,这意味着其中更多会落入我们的“完整审查”等级。不过我们发现,大部分成本增长实际上来自这几个月间的模型变更。
八月初,我们将每个审查器都迁移到了 Anthropic 模型上,这使每个任务的成本从 1.38 美元提高到 2.03 美元。我们做出这一选择,是因为在评估中发现 Anthropic 模型在这一特定工作负载上表现优于其他模型。
我们的内部标准审查器 Codex最终采用了 Claude Opus 4.7,这是出于性能和可靠性的综合考虑。这使其在八月的每次审查成本从约 0.25 美元升至 0.88 美元,从而比协调器智能体本身还要昂贵。
缓存命中率也有所提高,从四月的 85.7% 升至九月的 97%,而每次审查的 token 数量增长了两倍多,从 91 万增至 299 万。即使缓存读取成本很低,三倍 token 上的高命中率仍然要贵得多。
自我们上一篇文章以来还发生了什么变化?
最大的变化之一是审查器现在运行在 OpenCode v2 上,这是对 v1 的彻底重写。在将所有审查从 v1 切换到 v2 之前,我们在比较影子模式下,对每个金丝雀仓库中的每次审查同时运行 v1 和 v2。在我们测试的合并请求中,两者在 98% 的情况下对批准决定达成一致,因此我们在十月初一次性将所有人迁移过去,并移除了 v1 代码。在相同模型下比较两天,v2 上的完整等级审查完成速度快约 13%。我们目前还在试验其他运行内部 AI 审查器的方式,包括仅使用 pi-durable 在 Durable Objects 上运行。我们希望很快能提供更多相关信息,敬请关注!
那么,token 都去了哪里?
就在我们开始专注于成本优化之前,我们的 AI 审查支出按以下方式划分:输出 token 约占 23%,缓存写入成本占 43%,缓存读取成本占 34%。这意味着大部分费用花在了模型已经见过或即将再次见到的上下文上。
当你深入查看单个会话时,这就完全说得通了。代码质量审查器每次审查平均进行 16.6 次大语言模型(LLM)调用,在这些调用中,它向缓存写入 7.2 万 token,并读回 108 万 token,因为每次调用都会将整个对话作为上下文发送。一个会话的成本随调用次数和上下文大小两者增长,而在过去几个月里,我们逐渐增加了这两者。
值得花几分钟阅读一下 Anthropic 的提示缓存是如何工作的。它的工作原理是缓存大语言模型(LLM)已经计算过的提示部分。这些被称为前缀,因为它们只对对话开头的消息有效,对中间或结尾的消息无效。这意味着未来的请求可以复用较早的前缀,直到对话中与已缓存内容不同的部分为止。在我们的案例中,AI 审查器会话开头的 harness 工具、系统提示和消息很少变化,因此它们是前缀缓存的绝佳候选。前缀只存储在缓存断点结束它的位置。写入缓存的成本是正常输入价格的 1.25 倍,读取成本是 0.1 倍,并且条目会在五分钟后过期,除非有东西读取它。
这意味着我们有两件事要做:让每个会话的第一次请求从缓存读取而不是写入缓存,并让每个会话使用更少的调用。
在每个仓库之间共享缓存前缀
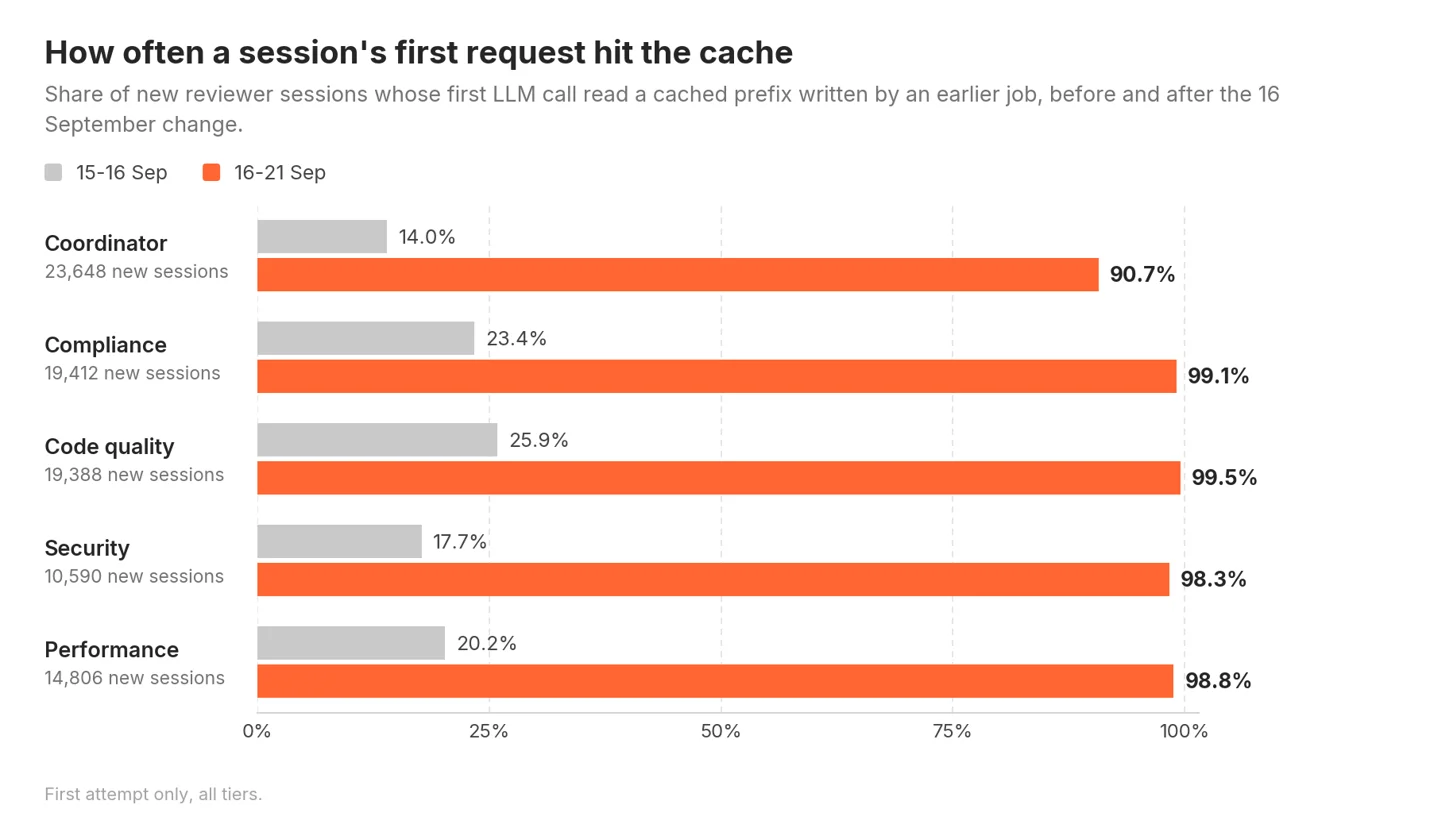
从 9 月 14 日开始,审查器记录了每个审查器第一次 LLM 调用的 token 使用量,以及第一个系统块的哈希值,完全按照发送给提供商的原样。
数据显示,会话的第一次请求只有 14% 到 26% 的情况下找到了缓存前缀。每个会话都以相同的工具定义和相同的智能体提示开始,在我们审查的每个仓库中,这 1.1 万到 2.1 万 token 都是相同的,因此几乎所有这些都应该是缓存命中。
问题最终出在 OpenCode v1 构建系统提示的方式上:它构建了一个块,其中包含我们的智能体提示,随后是一个包含工作目录和日期的环境部分,并将唯一的缓存断点放在该块的末尾。共享部分从未被单独存储,因此在一个仓库中的审查永远无法复用另一个仓库中的审查器所写入的内容。
9 月 16 日,我们在每个智能体提示的末尾添加了一个标记,并添加了一个插件钩子,在该标记处将块一分为二。前半部分现在以每个作业都共享的字节结尾,并获得了自己的断点。为了保持这一点,我们不得不移除其前面的任何仓库特定内容,因此可用技能列表被禁用,工具描述不能在作业之间变化。
同一天,我们还将内部标准(Codex)审查器的参考索引(一个内部标准表、一个技能文件和一个参考文件列表)移入了其提示中。在此之前,每个会话的前三轮都花在用工具调用读取这些文件上。其每次运行的 LLM 调用次数从 15.9 降至 9.6,每次运行的成本从 $1.12 降至 $0.72。
这些变化共同将每次审查的成本从 $2.47 降至 $2.02,而且我们一启动发布就能明显看到下降。
更少的调用,更少的费用
下一组变更于 9 月 21 日和 23 日发布。它们单独来看都不特别引人注目,但合在一起使每次审查减少了约 $0.20。
| 变更 | 当时的情况 | 变更的效果 |
| 移除审查器无法使用的工具 | 子审查器可以看到发布最终审查评论的工具。在 57% 到 76% 的会话中,它们尝试调用它,被服务器上的检查拒绝,并又花了一次调用来恢复。 | 消除了一次浪费的调用,并且每个子审查器请求中的工具定义减少了约 2.9k token |
| 并行读取文件 | 在代码质量审查器 64% 的轮次中,模型恰好进行了一次工具调用,通常是读取单个文件。 | 审查器在首次响应中读取共享上下文及其所有补丁,最多 150 KB |
| 在重新审查时跳过审查器 | 我们大约三分之二的作业是对同一合并请求的第二次或更晚的审查,而且通常有三个审查器没有新内容可看。 | 在完整层级重新审查中,AGENTS.md 审查被跳过 56% 的时间,性能审查被跳过 23%,文档审查被跳过 13%。 |
| 在发布审查后停止 | OpenCode 将结果传回模型再进行一轮,模型再次读取整个对话以编写无人查看的摘要。 | 每个作业节省约 $0.07 |
| 将缓慢的审查器与故障的提供商区别对待 | 达到时间限制的审查器被当作提供商故障处理,并以相同的时间限制重新开始。 | 结合更长的时间限制和更低的努力,安全审查器超时从运行次数的 1.8% 降至几乎为零 |
| 取消已取消的作业 | GitLab 的 Kubernetes 执行器在作业被取消时不会向作业脚本发送信号。在 446 个已取消作业的样本中,有 358 个继续运行直到审查完成。 | 作业每 15 秒检查一次自身状态,如果被取消则停止 |
最复杂的变更是在三个审查器之间共享一个前缀。代码质量、安全和性能审查器现在发送相同的首次请求,使用相同的工具、共享规则文件,然后是包含所有补丁的合并请求。每个审查器自己的指令紧随其后,我们确保其中一个写入缓存,另外两个从中读取。
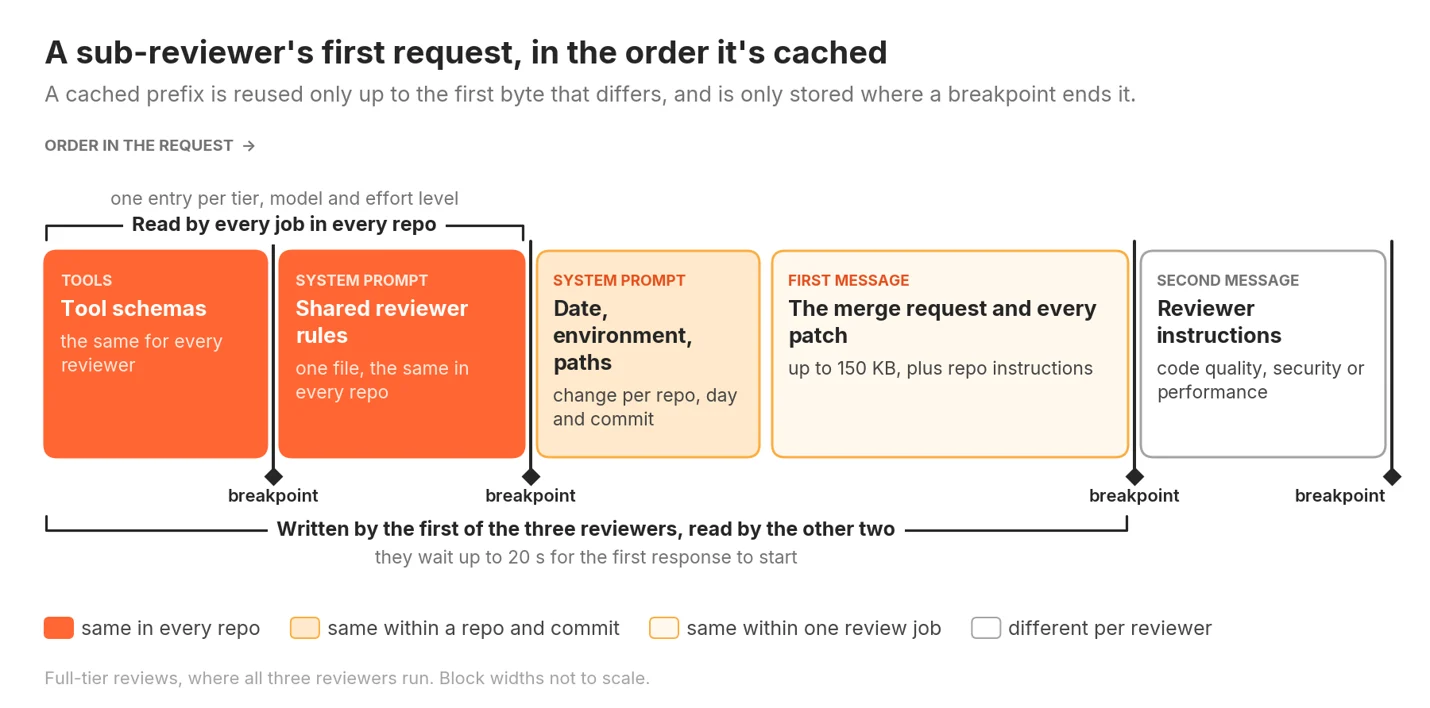
缓存条目在写入它的响应开始流式传输之前无法被读取,而三个审查器同时启动。因此第二个和第三个会等待第一个的响应开始,最多等待 20 秒,然后再发送自己的首次请求。这会使它们稍微变慢,但每个审查器节省约九美分。
更改模型和努力
下一张图表显示了自 9 月初以来的同一条线,并标记了每项变更。
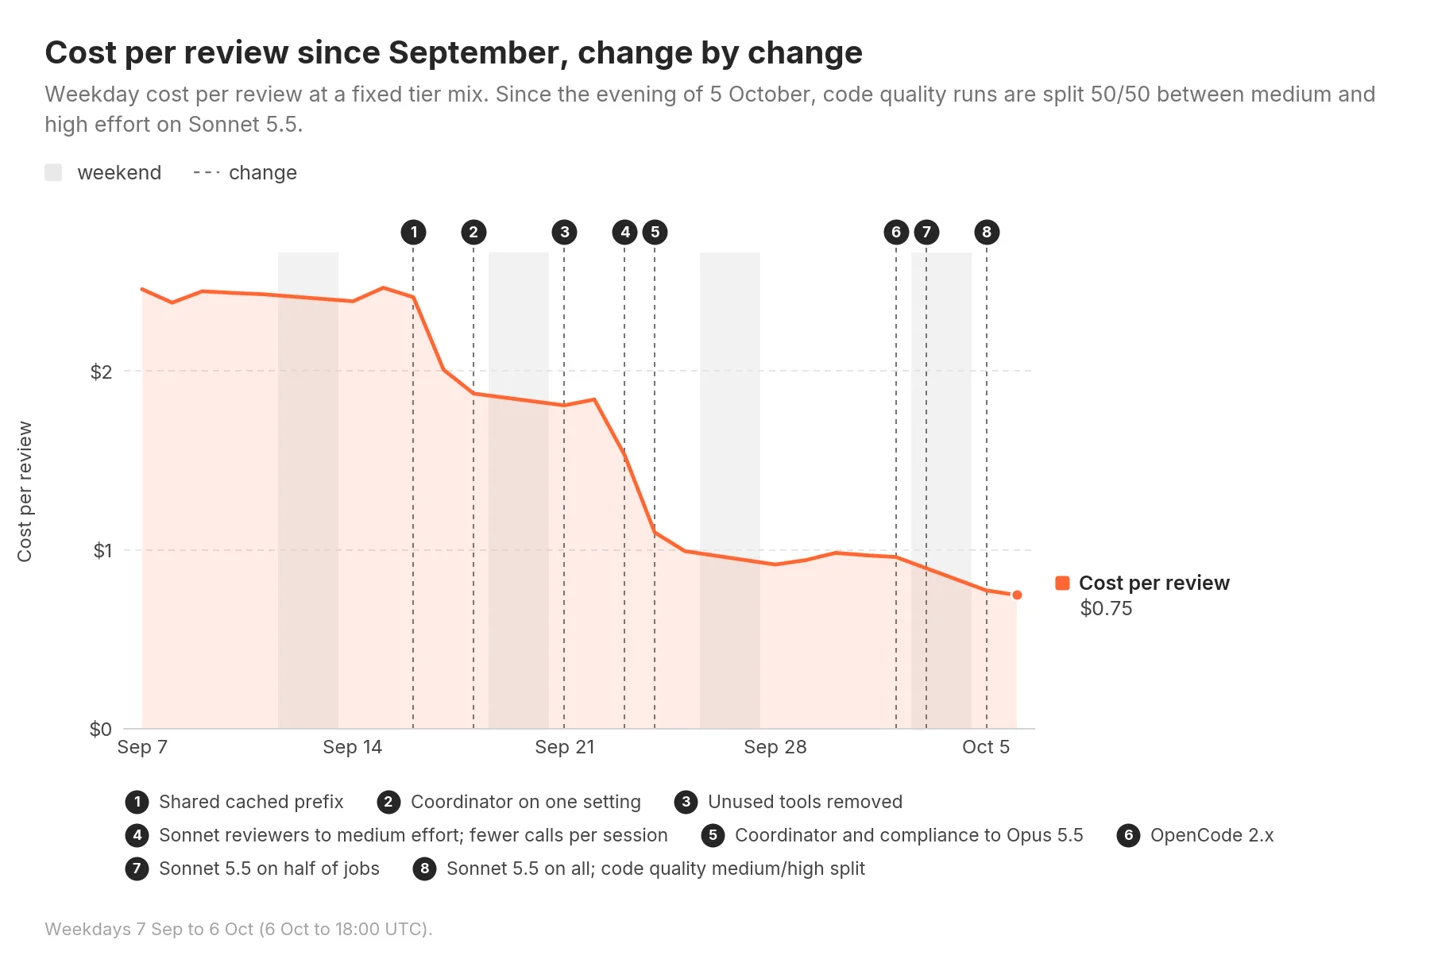
当我们按每次发布和每次配置变更划分时间段时,代码变更只占节省的较小部分。
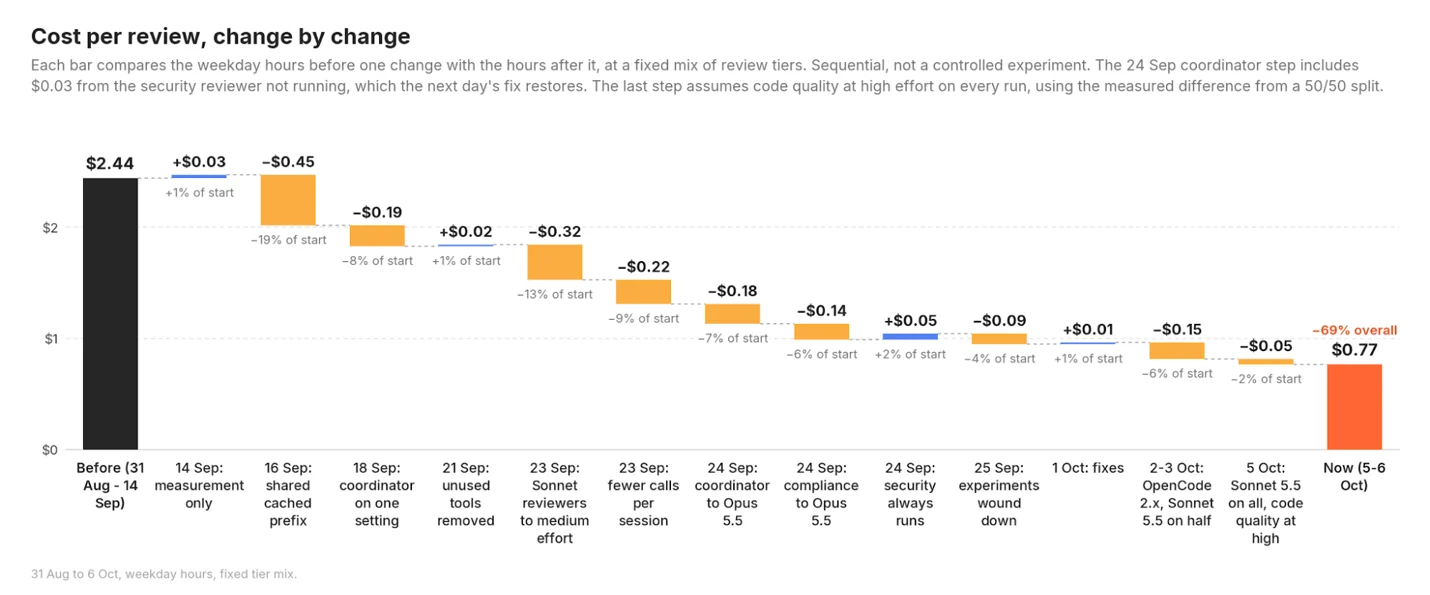
在 $1.67 中,代码变更占 $0.65,模型和努力变更占 $1.06。每一步都比较变更前的工作日小时数与变更后的小时数,因此这不是一个统计上可靠的对照实验。
协调器自 8 月以来一直运行三种模型和努力组合。在相同模型上,中等努力的完整层级作业完成速度快 20%,因此我们放弃了另外两种。在后来的一次随机拆分中,中等努力的 Opus 5.5 与 Opus 5 相比,在审查结果或关键发现上没有可测量的变化,因此我们进行了切换。高努力的 Opus 5.5 比中等努力的 Opus 5.5 成本更高,而发现数量没有显著增加。
Opus 5.5 每 token 比 Opus 5 便宜,但价格只占下降的约 $0.20。其余来自发送和生成更少的 token。自 9 月初以来,每次审查的缓存读取下降了 82%,缓存写入下降了 54%,输出下降了 67%。
最近的一次变更是换用新模型。10 月 3 日,我们将每个 Sonnet 审查器在 Sonnet 5 和 Sonnet 5.5 之间按 50/50 拆分。两天半后,Sonnet 5.5 在代码质量上每次运行便宜 62%,性能上便宜 58%,安全上便宜 47%。两个模型每 token 成本相同,因此全部节省都来自使用更少的 token。在完整层级审查中,5.5 审查器发布的关键和警告发现数量与 Sonnet 5 审查器大致相同,因此我们在 10 月 5 日将它们全部迁移到 5.5。
在中等努力的 Sonnet 5.5 上,代码质量审查器每次运行进行 1.7 次 LLM 调用,而不是 6.2 次,并且超过一半的运行在单次调用中完成,这意味着它们不会打开仓库中的任何其他文件。在高努力下,它每次运行进行 3.4 次调用。我们担心这会使审查变得肤浅,我们在下面的质量部分对此进行了讨论。
为了查看更多努力是否能在更大层级上找回发现,自 10 月 5 日起,代码质量审查器在 5.5 上按 50/50 在中等和高努力之间拆分。一天后,高努力每次运行成本高 61%,并发布多 58% 的关键和警告发现。这大约是每次审查两美分,下面的质量部分显示这些额外发现值得拥有,因此我们将代码质量迁移到高努力。本文中的成本数字假设了这一点。
延迟
我们并非旨在让审查更快,但更少的调用也意味着更少的等待,这意味着更快的审查和更快乐的工程师。
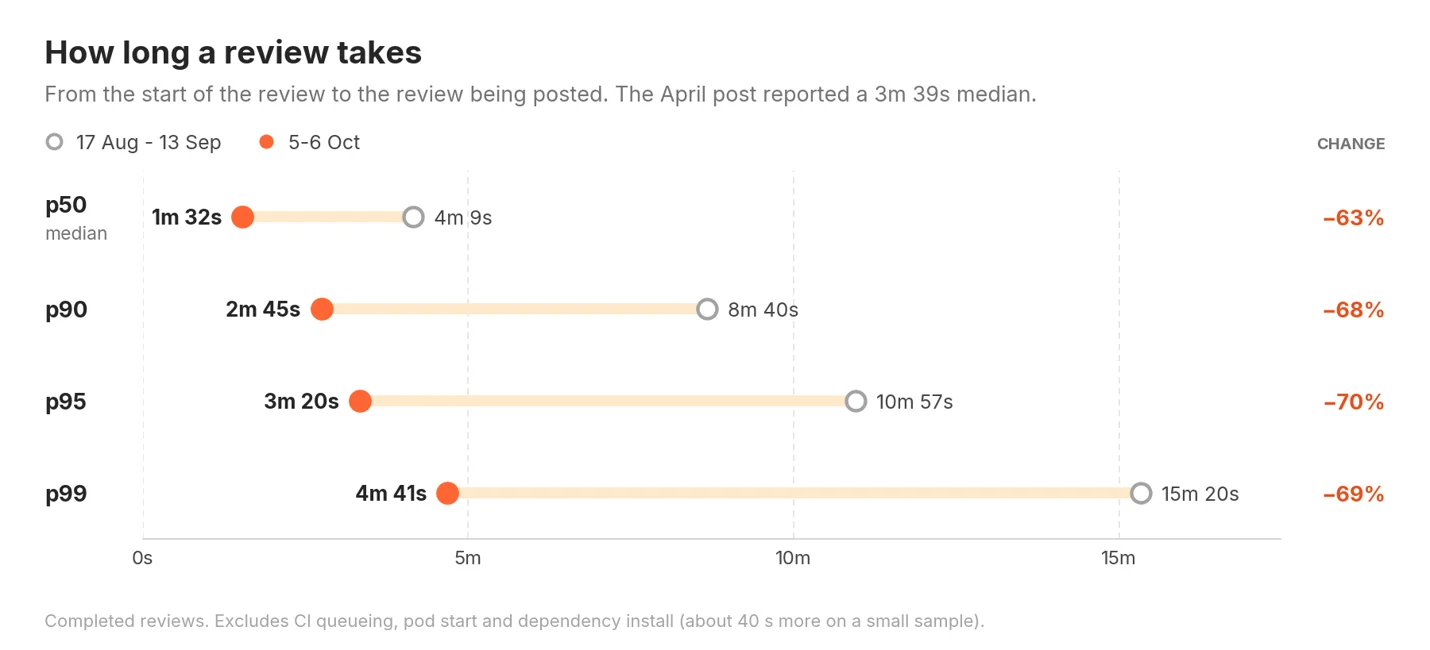
最慢的审查改进最大。在 9 月 14 日之前的四周内,37.9% 的审查耗时超过五分钟,而现在只有 0.7%。今天的第 99 百分位比四月份四分之三的审查都要快。每个层级都一路变快,完整层级审查的中位数从 5 分 16 秒降至 1 分 54 秒,lite 从 2 分 58 秒降至 1 分 14 秒,trivial 从 77 秒降至 30 秒。
到 8 月,中位数审查比我们在四月份报告的速度慢 14%,第 99 百分位慢 48%,因此这项工作的很大一部分只是让我们回到了原来的水平。
审查质量
如果更便宜的审查也发现更少的问题,那就不值得多少,而这里的第一个图表看起来就是这样。
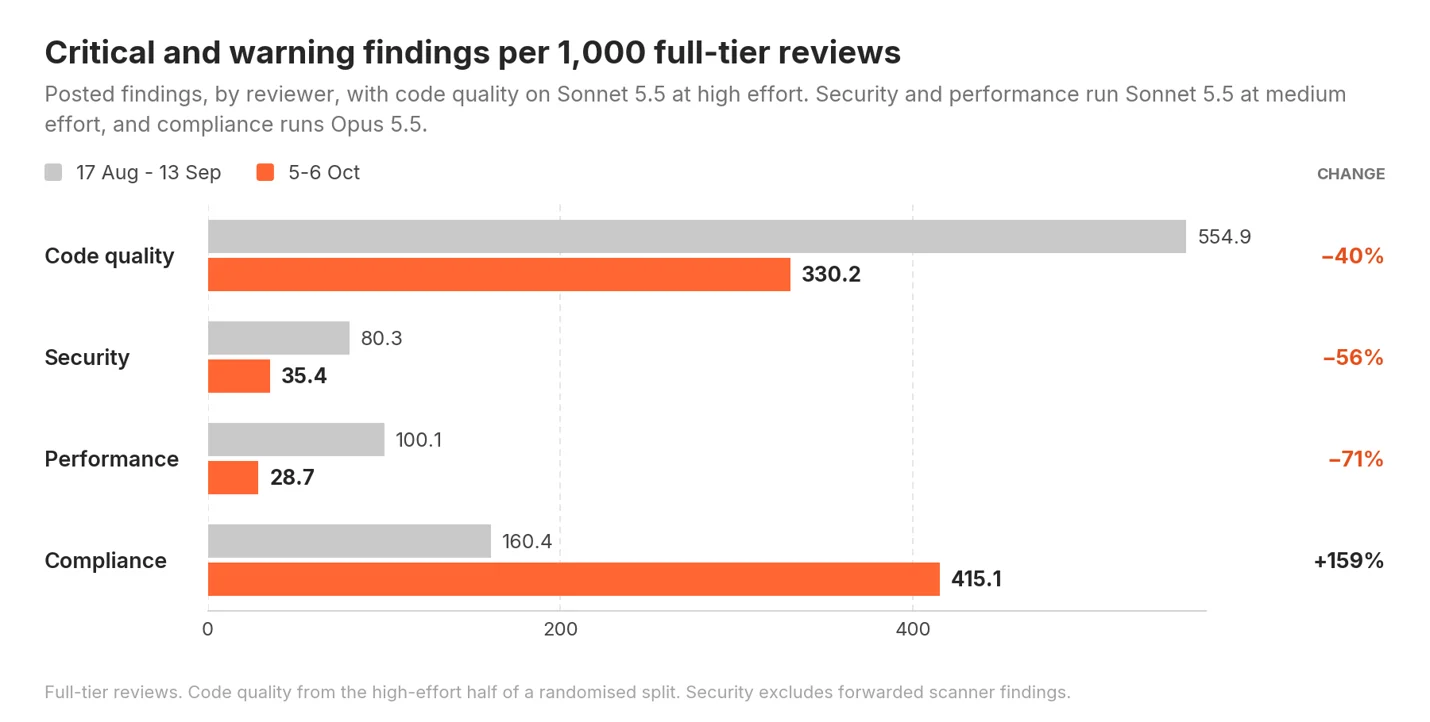
在高努力下使用 Sonnet 5.5 的代码质量,它发布的关键和警告发现比八月下旬少 40%。保持中等努力的安全和性能,分别少 56% 和 71%。严重发现的下降本身并不能告诉你是在遗漏真实问题还是在减少噪音,因此我们从两个方向进行了查看。
首先,我们检查了作者是否对审查器标记的内容采取行动。对于关键和警告发现的样本,我们将被审查的提交与作者的下一次推送进行比较,如果发现指向的行发生了变化,则将该发现计为已采取行动。在每个时期,距离每个发现 30 到 40 行的行大约有 15% 的时间发生变化,这为巧合发生的编辑提供了基线。
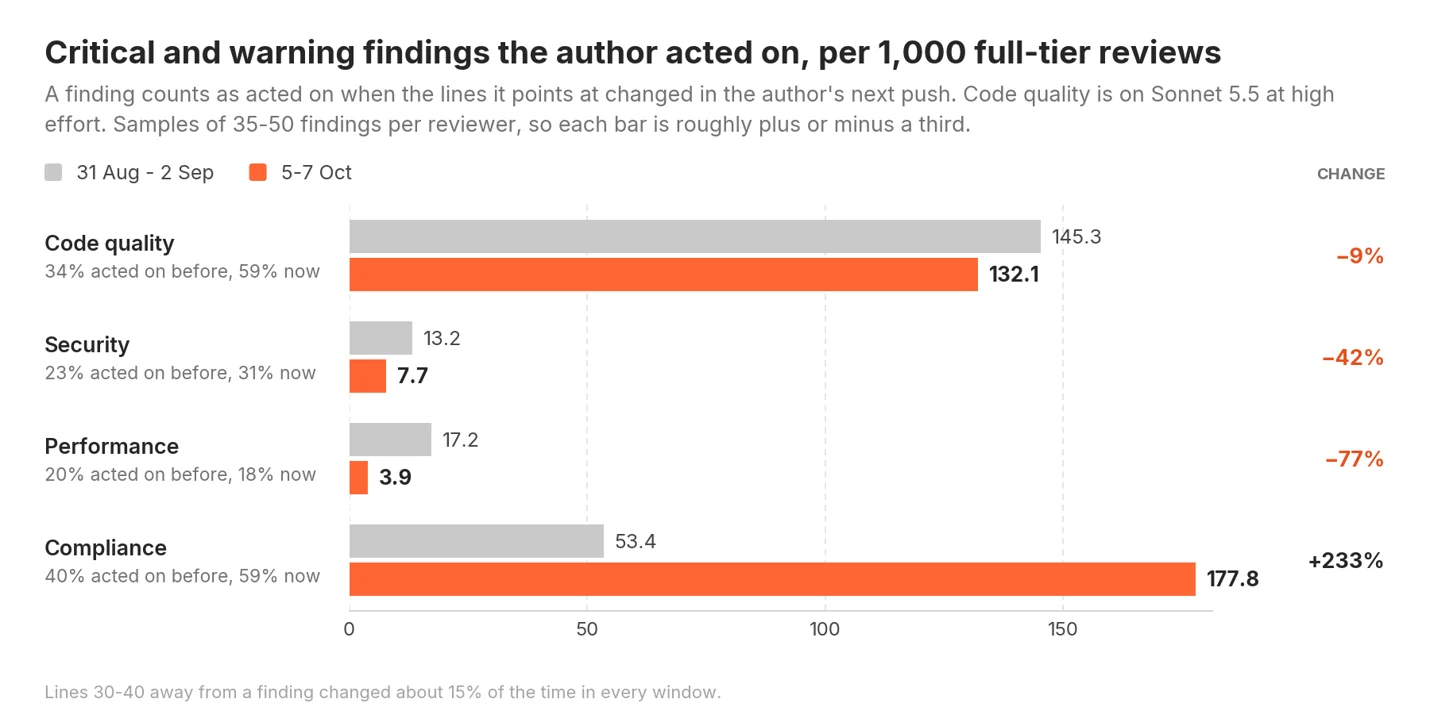
在变更之前,作者对代码质量审查器严重发现的 34% 采取行动。现在是 59%。审查器标记的东西更少,但被标记的东西更有可能导致变更,因此每 1,000 次审查中导致变更的发现数量大致相同。我们现在看到 132 个,而之前是 145 个,这在误差范围内。在所有四个审查器中,导致变更的严重发现从每 1,000 次审查 229 个增加到 321 个。
其次,我们让来自不同提供商的两种模型对来自三个 Sonnet 审查器的 657 个发现的盲样本进行评判,附上每个发现所指的 diff,并且不知道它来自哪个时期。分歧交给第三个模型。每个发现被标记为重要、次要、重复、错误或无法验证,其严重性被标记为合理、过高或过低。
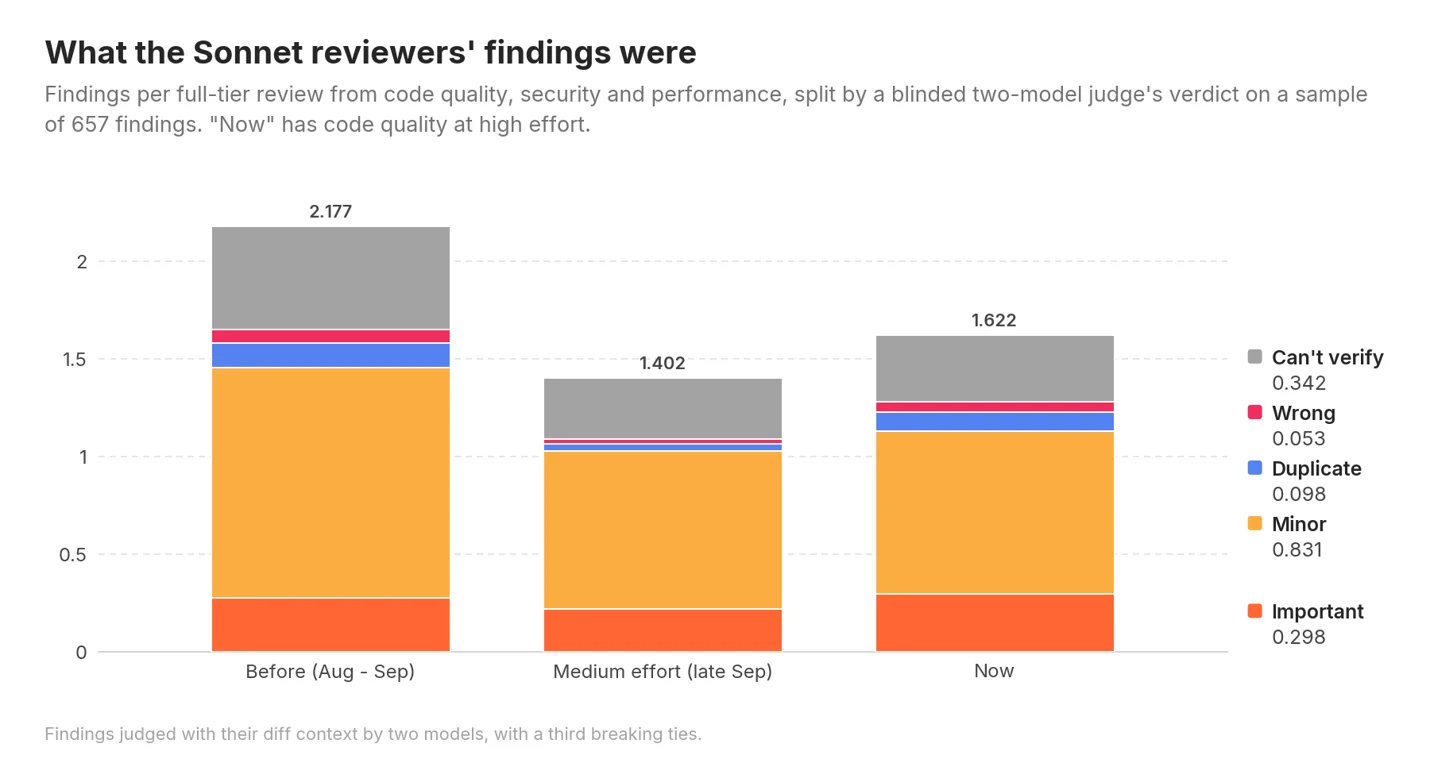
消失的大部分是次要发现,加上一些重复项和评判者无法从 diff 中验证的发现。每次审查的重要发现从之前的 0.28 变为现在的 0.30,区间重叠。更大的变化在严重性上。之前,评判者将每次审查 0.46 个关键或警告发现评为比其应得的更严重。现在是 0.14,下降了 70%,这是研究中最清晰的结果。关键发现下降的很大一部分是审查器不再将次要事物称为关键。
因此答案取决于审查器。对于高努力的代码质量,消失的主要是噪音和夸大的严重性,它仍然发现与之前大致相同数量的真实问题。中等努力确实丢失了真实发现。在随机拆分中,中等努力的代码质量导致采取行动的发现大约是高努力的四分之一,这就是我们将其迁移到高努力的原因。性能也丢失了真实发现:评判者发现每次审查的重要性能问题减少了约 64%,在实践中大约是每 24 次完整层级审查少一个重要发现。安全下降了约四分之一,尽管这在统计上不显著。两者仍处于中等努力,接下来将在高努力下测试它们。
两种方法都不完美。作者更改被标记的行表明他们做了某事,而不是发现是正确的。评判者也是模型,每组只有 35 到 66 个发现。“现在”窗口也只有一天长。即便如此,两种方法相互一致,并且都没有表明代码质量发现的真实问题更少。
可靠性也保持住了。没有给出结论就结束的审查从 0.79% 降至 0.27%,安全审查器的重试从 3.5% 降至 0.04%。
这让我们处于什么位置
现在一次平均审查花费 $0.77 而不是 $2.43,中位数审查在 1 分 32 秒内完成而不是 4 分 9 秒。最大的单项节省来自检查每个会话第一次请求时实际到达提供商的内容,并找到一种方式,使这些消息在提交、合并请求和仓库之间尽可能一致地排序。其余的成本节省来自不断尝试不同的模型和努力组合,同时确保我们搁置对特定模型的任何先入为主的偏见。
成本更低的审查并不自动意味着质量更差,但也不自动意味着没问题。高努力的代码质量发现的真实问题与之前大致相同,噪音少得多,夸大的严重性也少得多。性能在中等努力下丢失了真实发现,安全可能也是如此,所以接下来要在高努力下测试两者。如果你以任何规模运行智能体,我们首先会检查的两件事是:每个会话的第一次请求是否真的从缓存读取,以及你的审查器在你付费的努力水平下是否仍然发现真实问题。
如果你在旧金山参加 Cloudflare Connect,我会在我的会议 It’s time to build, not buy 中讲述我们如何构建审查器而不是购买一个,时间是 10 月 20 日星期二太平洋夏令时下午 12:30。下午 1:10 起我也会在 Speaker Connection Lounge,如果你想询问本文中的任何数字。