Global Performance Tuner 是 NVIDIA TensorRT 11.1 中发布的自动性能调优功能。它通过在 TensorRT 内为不同模型定制不同的优化,提供自动、精度感知的端到端性能调优。更多细节请参阅本系列的 第 1 部分,其中介绍了与调度(深度学习编译器优化中的关键阶段)相关的挑战、在 TensorRT 中开发 Global Performance Tuner 功能的动机,以及为形式化该问题而建立的数学理论。
本文是第 2 部分,使用第 1 部分中的符号来描述 Global Performance Tuner 功能的算法和架构设计,并提供使用它的最佳实践。
在 TensorRT 中设计 Global Performance Tuner 功能
Global Performance Tuner 的核心设计思想是将备选调度策略表示为显式且可搜索的构建路线。编译器旋钮(也称为编译器标志或编译器选项)是一种配置设置,用于改变编译流水线的某些方面,例如启发式规则、融合决策或代码生成路径。
每个可调旋钮都暴露一组有限的允许值,并具有一个默认值。构建路线是旋钮值的具体组合。当未指定构建路线时,TensorRT 使用默认构建路线,其中每个旋钮都保留其默认值。
考虑一个由三个 pass(、 和 )组成的假设编译器。假设一个二元旋钮 控制 使用的融合策略:当 时,该 pass 应用水平融合;当 时,它应用垂直融合:
的两个可能值定义了两条构建路线,因此为输入模型 产生了一个大小为二的候选解集:
两种融合策略都不是普遍更优的。水平融合可能为某个模型生成更快的引擎,而垂直融合可能对另一个模型更有效。即使模型本身保持不变,结果也可能随张量形状和目标 GPU 而变化。因此,选择更好的路线需要构建两个候选引擎并比较它们的端到端性能。
即使这个双路线示例也抓住了调优的本质思想:编译器暴露有意义的调度备选方案,而实测行为决定哪个完整解决方案最适合当前的部署场景。
在前面引入的数学框架中,构建路线是编译器 pass 的组合。在实现中,旋钮赋值的组合提供了该路线的紧凑规范。更改一个或多个旋钮值会改变模型在编译流水线可调部分中的行进方式。在此抽象中,旋钮组合可以被视为标识一条构建路线。
更准确地说,旋钮组合是构建路线规范,而不是对最终引擎的完整描述。TensorRT 仍会执行引擎构建的其余阶段,包括 tactic 选择,并可能根据网络施加的约束来协调各个旋钮值。该路线指定了可调配置空间中所请求的选择,它并不替代 TensorRT 构建器的其余部分。
TensorRT 围绕两个基本能力暴露了紧凑的 API 接口:
- 应用并检查一条构建路线:setter 将固定路线应用于构建器配置,而相应的 getter 返回当前指定的路线。
- 发现可调配置空间:一个单独的 getter 描述可用的旋钮、它们的允许值、默认值及其用途。
相应的 C++ API 为:
bool IBuilderConfig::setBuildRoute(char const* buildRoute);
char const* IBuilderConfig::getBuildRoute() const;
char const* IBuilderConfig::getAllBuildRoutes() const;
你可以使用这些 API 实现自定义调优器。trtexec 中还提供了一个示例 C++ 实现。
在高层次上,trtexec 按如下方式组织调优:
- 当用户指定输入模型和类似正则的可调构建路线表达式时,
trtexec将根据搜索算法将该表达式展开为具体构建路线的列表。 - 将有一个循环遍历所有固定构建路线。在每次迭代中,将使用该单条构建路线构建模型,然后在每次迭代期间测量精度和性能。
- 所有在构建期间崩溃或在推理期间未通过精度要求的构建路线都被排除在最佳引擎选择之外。选择实测端到端性能最佳的引擎。
TensorRT 11.1 提供了 200 多个用于调优的旋钮。更多细节请参阅 Global Performance Tuner 文档。相同的 Python 实现将在 Torch-TensorRT 2.15 中发布。
探索多条构建路线的实际价值在端到端测量中变得可见。图 1 将默认 TensorRT 构建路线(每个工作负载归一化为 1.0x)与调优期间找到的最佳合格路线进行比较。在这十个评估的工作负载中,调优带来的性能提升范围为 1.14x 到 1.63x。
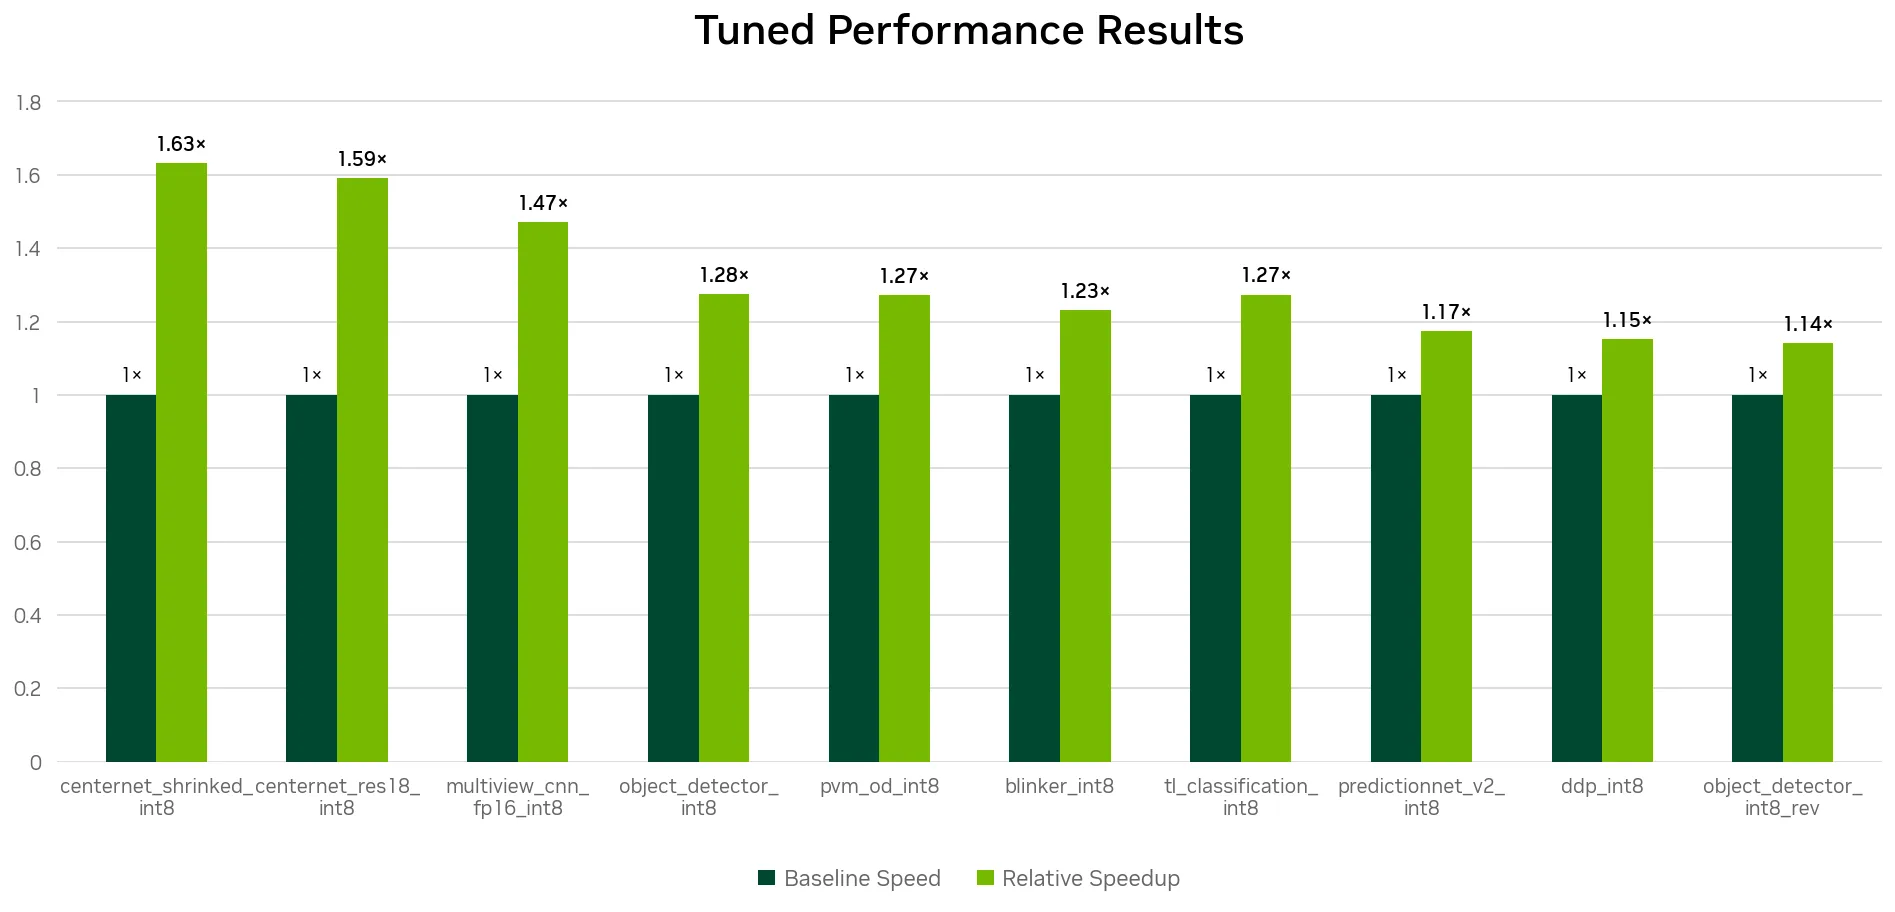
工作负载之间的差异是这一结果的核心。不同模型暴露出不同的优化机会,因此不能期望单一的默认调度策略实现每个模型的最佳性能。Global Performance Tuner 探索备选构建路线,拒绝不满足精度要求的候选方案,并选择在目标环境中实测最快的合格引擎。
案例研究:性能与精度的纠缠
Global Performance Tuner 功能应用精度感知调优,因此理论上可以完美解决性能与精度的纠缠问题。考虑以下思想实验。
对于一个简单的神经网络模型,如图 2 所示,想象有一些旋钮控制是否强制某些 IR 使用低精度内核,这相当于通过在算子之间插入 Q/DQ 节点将图转换为量化图。TensorRT 11.0 及更高版本不支持这种做法,因为弱类型 API 已被弃用。
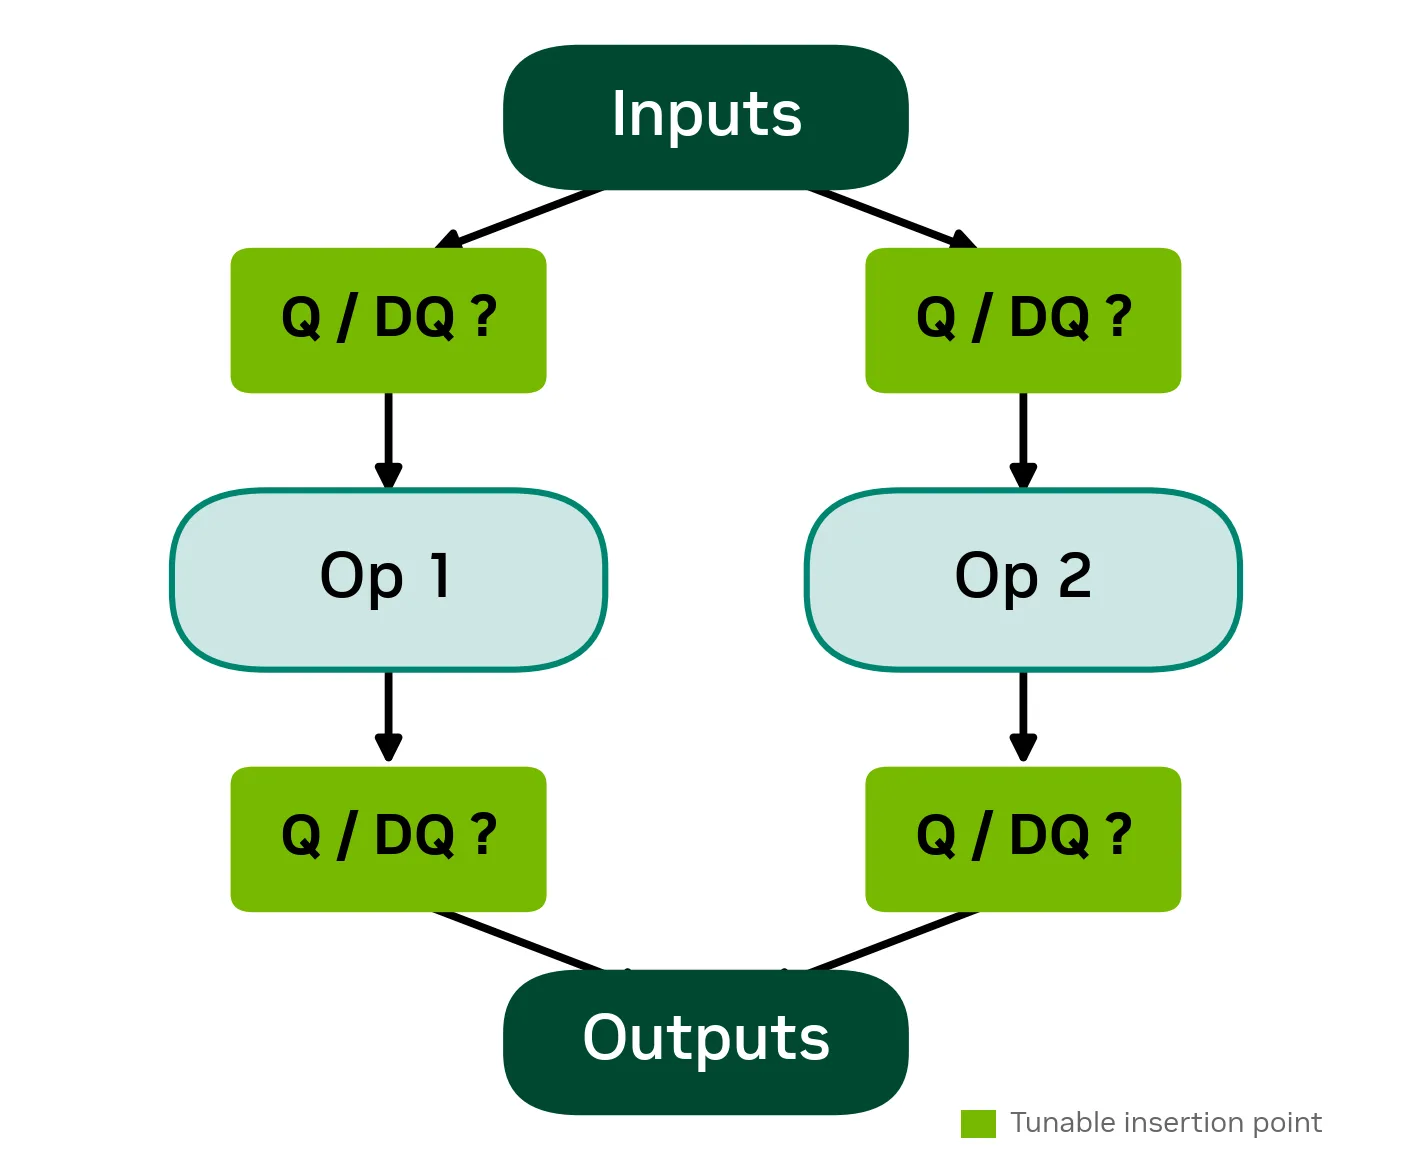
该模型有四个可插入 Q/DQ 的位置。假设这些位置由四个不同的二元旋钮控制。深度学习编译器随后可以在解空间中提供 24 = 16 个解。显而易见,在这 16 个候选中,性能最好的解是插入所有量化的那个。然而,该解可能不满足精度要求。不插入 Q/DQ 的解精度最好,但性能最差。性能与精度相互纠缠,因此很难知道“中间”的哪个解同时满足两项要求。
回顾一下,构建器算法的概念包含精度容差。将精度与性能解耦的关键是定义一个清晰的精度接受边界,并且该边界需要由用户提供的精度指标和数据集作为黄金值来支撑。
TensorRT 中的 Global Performance Tuner 功能也有一个精度容差阈值 。考虑以下三种情况:
- :在此思想实验所假设的精确匹配指标下,候选输出必须与参考输出逐位相同。如果每次低精度替换都至少改变一个被评估的输出,那么只有不进行任何低精度替换的那个解仍然合格。
- :精度要求不施加任何有效限制,因此全部 16 个候选解都保持合格。更一般地,想象理论解空间允许一个“空”解,它不执行任何有用的计算,因此运行时间为零。仅以性能为导向的优化器可能会选择这个无意义的解。这一极限情况说明了为什么仅靠性能不足以作为优化目标。
- 从 逐渐变为 0:随着精度要求变得更严格,合格候选集不断收缩——例如从 16 个解减少到 14 个,然后 13、8、7,最终为 1。这些数量仅作说明;实际的转变点取决于模型、参考数据和所选的精度指标。在每个 值下,选择算法都会在仍合格的已评估候选中选择实测最快的解。
Global Performance Tuner 并未消除底层的权衡。相反,它解耦了性能与精度在优化过程中的角色:
- 精度决定哪些候选解是可接受的
- 性能对可接受的候选解进行排序
作为开发者,你为应用定义一个合适的精度边界,而调优则在该边界内识别出性能最佳的已评估构建路线。其结果是一个系统化的约束优化过程,而不是在速度与精度之间做临时选择。
这一思想实验与任何 TensorRT 版本所暴露的具体编译器旋钮无关。其目的是展示更广泛的设计原则;也就是说,当调度选择被表示为可调优的构建路线,并且精度被视为显式约束时,性能与精度的优化就变得可度量、可复现,并由应用定义。
使用 Global Performance Tuner 的最佳实践
Global Performance Tuner 使构建路线探索系统化,但有效的调优仍然受益于有意的搜索策略。当一个表达式包含许多可变旋钮时,可能的组合数量会迅速增长。以下实践有助于保持调优受控、可复现,并与目标应用保持一致。
根据搜索空间选择搜索策略
将默认构建路线视为比较备选路线的基线。对于广泛的初始扫描,fast 搜索会评估默认路线并一次改变一个旋钮。mixed 搜索通常是较大表达式的实用起点:它先执行 fast 扫描,然后探索产生改进的旋钮值组合。将 full 搜索保留给一小群精心挑选的旋钮,因为它会评估它们的完整笛卡尔积。
在开始 fast 或 full 扫描之前,--dryRun 可以在不构建引擎的情况下显示具体的路线列表。这提供了一种在投入完整调优运行之前快速检查搜索空间的方法。--dryRun 不支持与 mixed 搜索一起使用,因为第二阶段依赖于第一阶段收集的测量结果。
将调优视为增量且可恢复的过程
当指定 --tuningCacheFile 时,每个完成的迭代都会连同其构建路线、实测 GPU 时间和精度结果一起记录。如果扫描被中断或达到时间限制,之后可以使用 --continue 从记录的状态恢复。通过这种方法,可以将调优作为渐进式实验来进行,而不要求每次搜索都在一次不间断运行中完成。
当特定路线的失败或精度回退需要更深入调查时,--saveAllEngines 可以保留每次迭代产生的引擎。由于此选项可能消耗大量存储空间,它最适合用于调试而非日常调优。
使调优工作流适应应用
提供的输入和参考输出应代表对应用至关重要的部署条件。在一个狭窄数据集上满足精度要求的引擎,仅在该数据集、指标和阈值上得到了验证。应包含有代表性的输入、重要的边界情况,以及能反映应用实际质量要求的精度指标。
trtexec 实现提供了一个可直接使用的调优器,但它并非唯一可能的调优策略。构建器配置 API 暴露了可用的调节项,并支持应用各个构建路线,而开源 trtexec 实现则展示了如何组织周边的调优循环。开发者可以构建针对特定应用的搜索策略、引入启发式过滤器,或在比较候选性能之前应用应用级精度验证。
将先前结果视为指导,而非可普遍迁移的解决方案
最佳构建路线取决于模型、输入形状、目标 GPU、软件栈,以及搜索期间使用的 TensorRT 和调优器版本。改善某一部署的路线在另一部署中可能毫无效果,甚至导致性能回退。在更改模型、形状、目标硬件、CUDA 或驱动环境,或相关 TensorRT 版本后,应重新调优。
来自先前调优实验的知识仍然有价值。如果某些调节项反复改善相关的一类工作负载,该经验可以指导未来的搜索空间设计,并帮助优先考虑有前景的候选方案。此类启发式方法应作为聚焦探索的先验,而每条最终路线都要在其实际部署环境中进行验证和测量。
开始使用 TensorRT 中的 Global Performance Tuner 功能
Global Performance Tuner 功能将 TensorRT 性能优化从依赖单一通用调度策略,转变为评估针对特定模型的备选方案。可自定义的构建路线通过允许不同模型和部署环境探索不同的调度决策,来实现性能定制。
将候选生成与路线搜索分离,提供了一条可扩展的路径,摆脱启发式方法的泛滥,减少将每一项模型特定发现编码为又一个硬编码异常的需要。精度感知调优还解决了性能与精度相互纠缠的问题。精度决定哪些候选引擎可接受,端到端性能决定哪个可接受引擎胜出。因此,所选结果是针对目标模型和环境评估的构建路线中,实测最快且符合条件的引擎。
TensorRT 提供了出色的基础配方,编译器调节项提供了受控的变化,而调优则为每位客户找出最佳可接受的变化。这种从通用预测到模型特定证据的转变,正是 Global Performance Tuner 功能将 TensorRT 优化扩展到单一构建路线之外的方式。
要开始使用,请查阅 Global Performance Tuner 文档 以及 开源 trtexec 实现。使用您自己的精度验证算法、搜索策略或优先考虑有前景构建路线的启发式方法扩展该示例。如需更大控制权,请使用 TensorRT 构建路线 API 从头构建调优器,根据应用的精度要求和性能目标定制候选探索与验证。