DeepInfer
DeepInfer 是支撑 DeepSeek 大规模生产服务的高性能推理框架。本次开源发布提供了离线推理,包含大规模服务所需的核心功能。
支持的模型:
- DeepSeek-V4.1-Flash
支持的功能:
- 优化的内核、模型和采样器运行时
- 并行:注意力 DP / 均衡 CP,MoE EP + EPLB
- DSpark 和置信度调度验证
- SWA 有界重放
- 异步调度(零开销批调度器)
- 批不变推理
- 确定性采样
- 结构化输出
功能详情和配置
- 优化的内核: FlashMLA、DeepGEMM、DeepEP、TileKernels、DeepSelect 以及自定义 TileLang 内核。
- DSpark 和置信度调度验证: 使用草稿令牌加速解码,并使用置信度估计来调度验证。设置
DEEPINFER_ENABLE_MTP_VARLEN=1;DEEPINFER_USE_NEXTN_DECODE控制最大草稿长度(默认值:5)。 - 解码器 SWA 有界重放: 通过仅重放有界后缀来减少解码器预填充工作。设置
DEEPINFER_YOCO_PREFILL_TRUNCATION_MODE=compact和DEEPINFER_YOCO_PREFILL_KEEP_TOKENS=140以使用默认 V4.1 设置;保留的后缀必须覆盖 SWA 窗口加上最大回溯长度。 - 异步调度: 将 CPU 批调度与设备执行重叠。默认启用。
- 批不变推理: 在不同批组合下保持模型结果一致。使用
DEEPINFER_BATCH_INVARIANT=1启用(仅限 NVIDIA)。 - 确定性采样: 对于相同的输入令牌和采样参数产生相同的输出。设置
DEEPINFER_BATCH_INVARIANT=1 DEEPINFER_ENABLE_MTP_VARLEN=0并将固定的seq_seed传递给SamplingParams(仅限 NVIDIA)。 - 结构化输出: 将生成约束为正则表达式、JSON 模式或 EBNF 语法。将
so_args={"schema_type": ..., "schema": ...}传递给SamplingParams;参见 示例。
支持的硬件:
- NVIDIA SM100 GPU
- 华为昇腾 950 NPU
完整推理服务所需(本版本未包含):
- KV 缓存系统
- VE/预填充/解码分离(大多数所需引擎功能已实现)
- 预填充和解码的数据并行副本间的负载均衡
快速开始
先决条件
- Linux
- GCC >= 13.0
- Python 3.12
- CUDA 13(仅限 NVIDIA)
- CANN 9.2(仅限昇腾)
从源码构建
在构建 DeepInfer 之前,请创建并激活一个空的 Python 3.12 环境。
# Use `ascend` instead for the Ascend platform
# Keep it exported in the environment where you run DeepInfer
export DEEPINFER_ACCELERATOR=nvidia
./build.sh
离线推理
默认检查点 deepseek-ai/DeepSeek-V4.1-Flash-1017 在首次运行时下载到 Hugging Face 缓存中;设置 DEEPINFER_HF_MODEL_DIR=/path/to/DeepSeek-V4.1-Flash-1017 以改为从本地副本运行。
python examples/offline_inference.py
详情参见 示例。
性能基准测试
预填充
解码
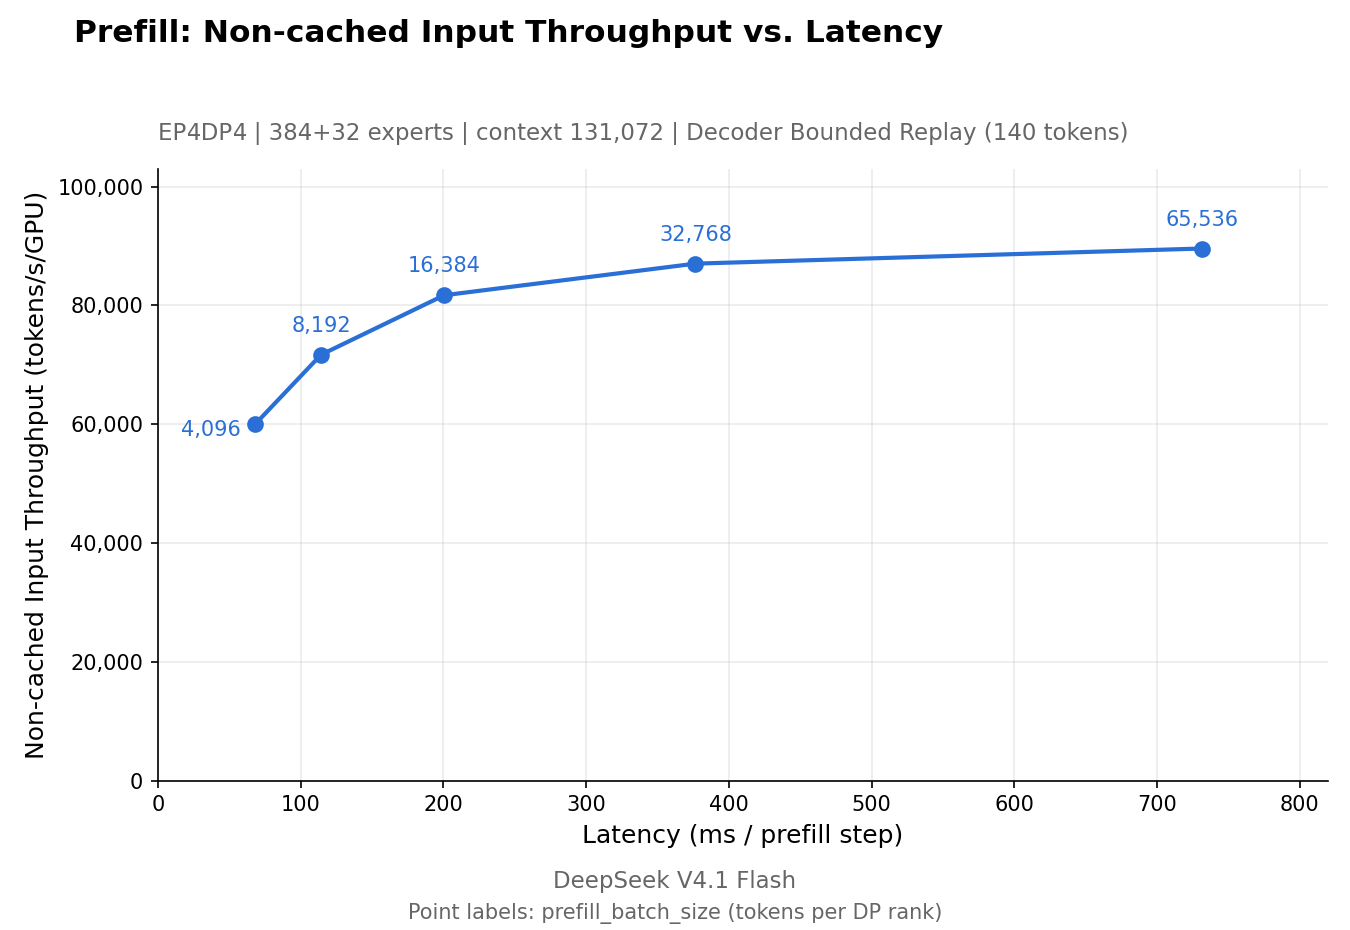
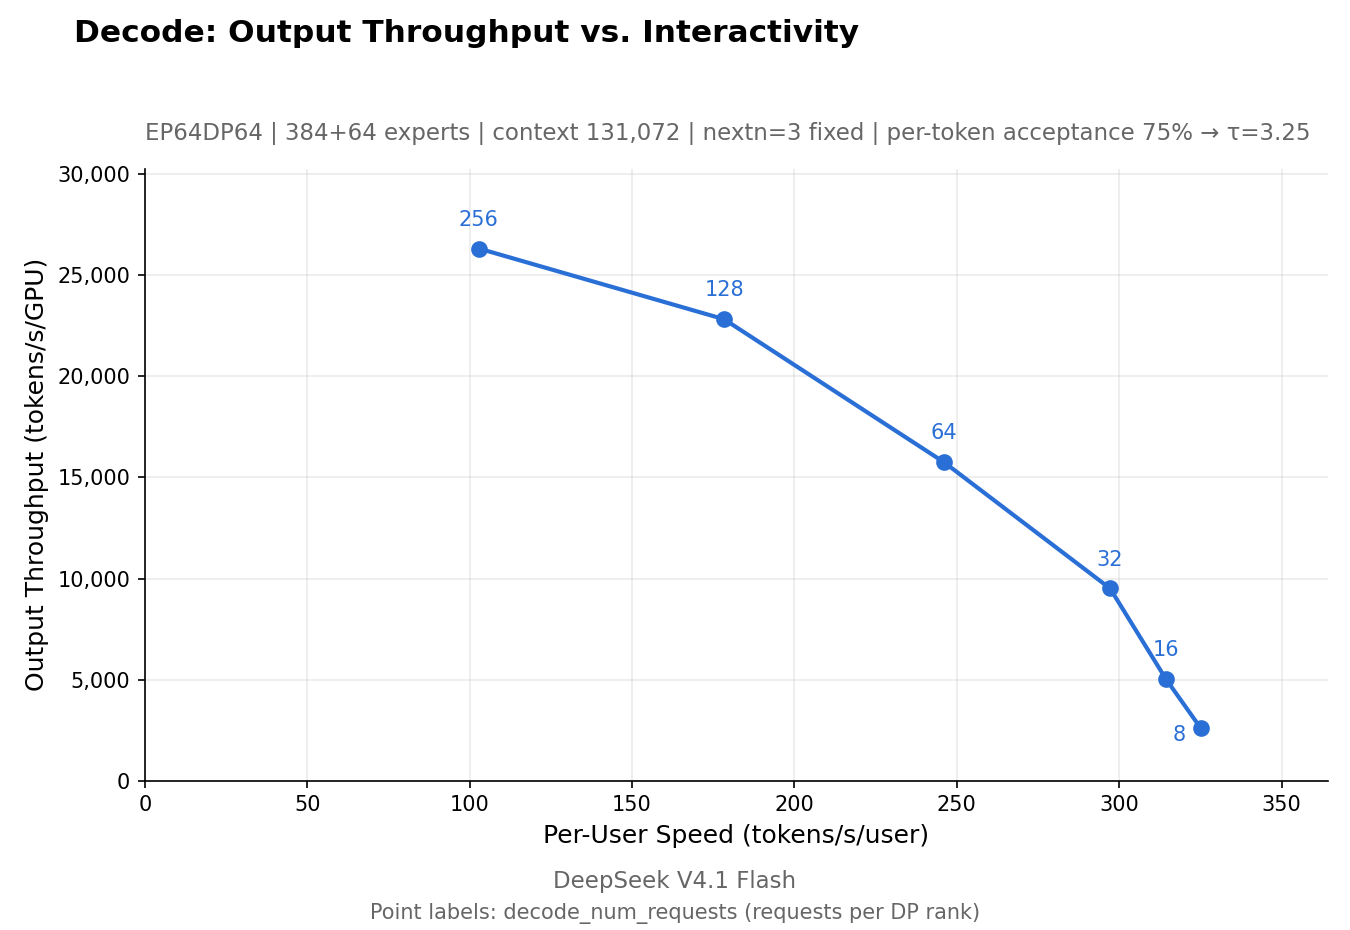
预填充在 4 个 SM100 GPU 上测量,解码在 64 个上测量——每个都在一个扩展域内。要复现基准测试,请参见 run_sweep.sh。
评估基准测试
参见 eval/README.md。
许可证
DeepInfer 在 Apache License 2.0 下发布。详情参见 LICENSE。
致谢
DeepInfer 最初主要基于 vLLM 构建,并受到 SGLang 和 TensorRT-LLM 的额外启发。我们感谢他们的开发者。
引用
@misc{deepinfer2026,
  title = {DeepInfer: High-performance, large-scale inference framework for DeepSeek models},
  author = {DeepSeek-AI},
  year = {2026},
  publisher = {GitHub},
  howpublished = {\url{https://github.com/deepseek-ai/DeepInfer}},
}