摘要
在 Together AI,我们致力于让每个个人用户和组织都能充分使用 AI。我们的研究团队——FlashAttention、ThunderKittens、ThunderAgent 等背后的研究者——一直是我们推理卓越表现的关键驱动力。随着推理市场呈指数级增长,我们一直专注于如何扩展我们的研究能力,以实现为所有人提供充裕智能的目标。
这要求我们的思维从静态推理(Static Inference)转向 多态推理(Polymorphic Inference) ——这是我们对新模型发布速度、模型架构多样性、快速变化的工作负载以及快速变化的硬件平台的回应。在这篇博客中,我们将重点介绍我们在多态推理时代的研究议程——以及我们如何持续使用 AI 智能体通过 持续编译(Continuous Compilation)来优化它们自身的推理。
什么是多态推理?
在过去一年中,开源模型的多样性以及这些模型在生产环境中的部署方式发生了显著变化。我们认为这种显著变化需要一种新的方法,我们称之为多态推理。
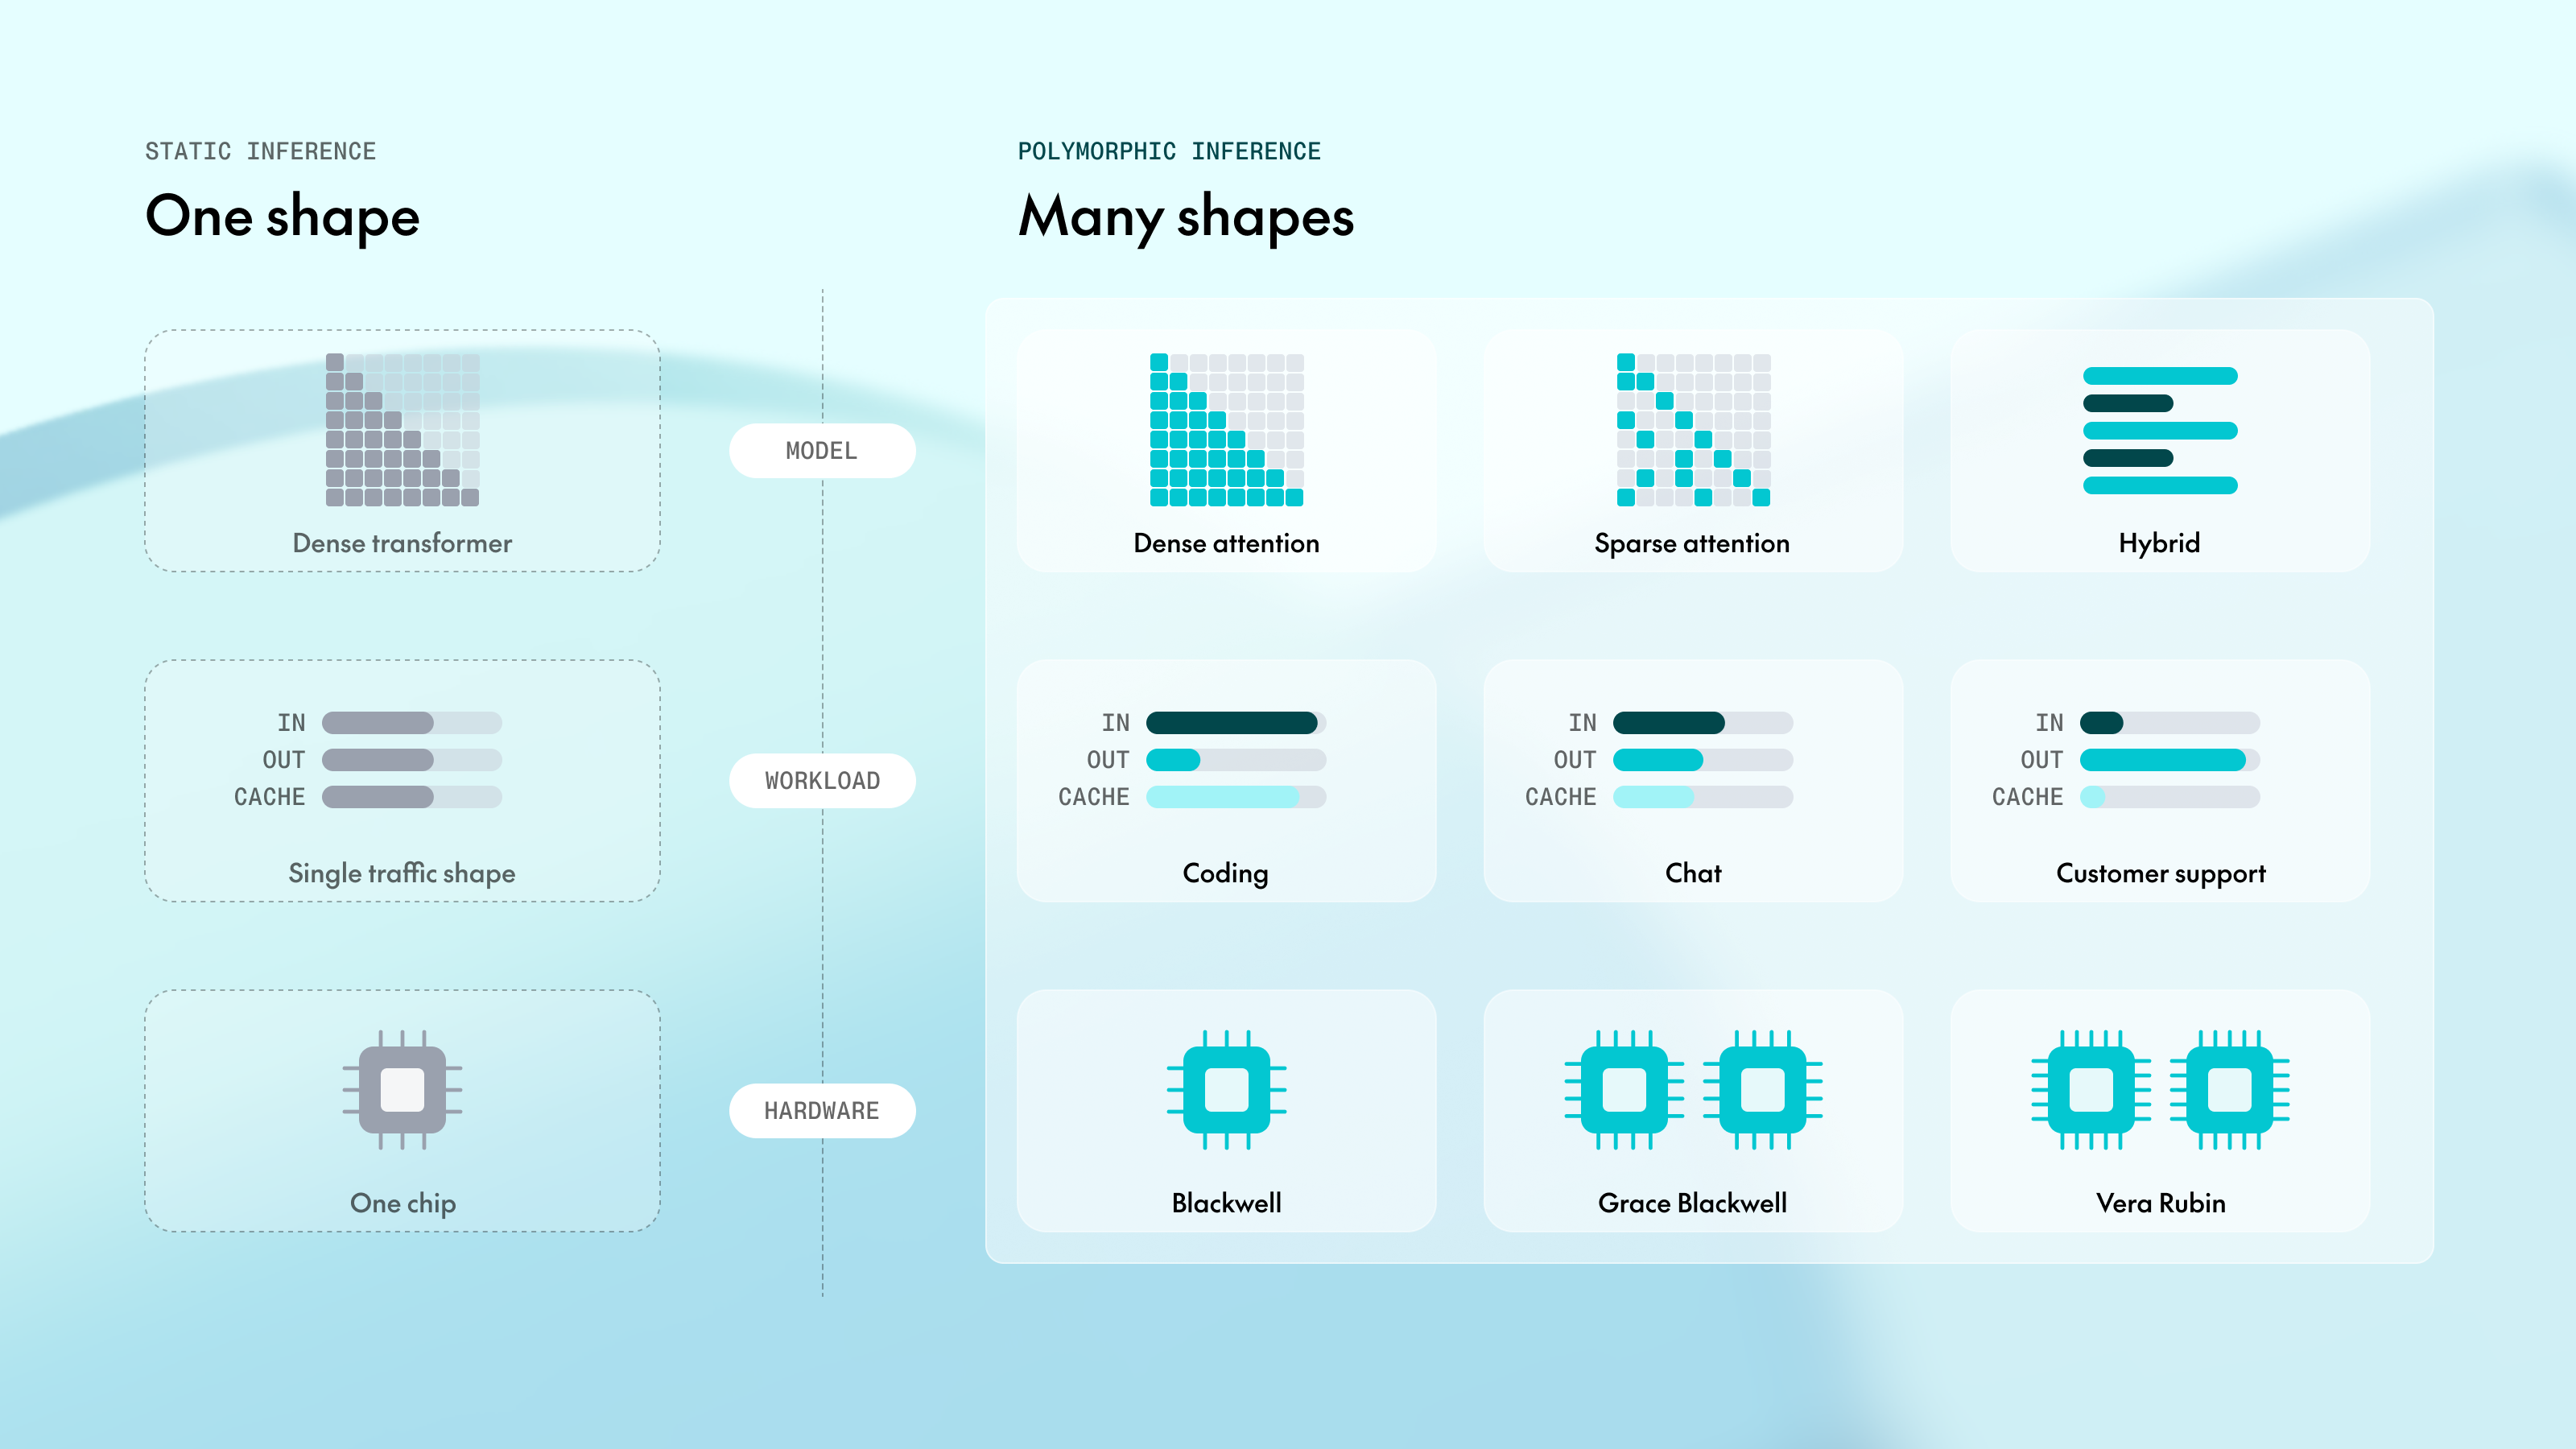
多态推理(源自希腊语,意为“多种形态”的推理)是对我们在整个行业中看到的诸多变化的回应,对我们而言,这主要由几个趋势的汇聚所定义:
- 模型发布的速度不断加快。开源模型的发布节奏比以往更快——而且多样性远超以往。OpenRouter 上 80% 的流量流向了过去三个月内发布的模型。
- 模型架构的多样性不断增加。当今使用的前十大最受欢迎的开源模型全都采用不同的架构(更不用说我们的合作伙伴所服务的众多闭源架构了)。
- 流量形态持续演变。我们每天为新的用户、组织和地区提供服务,涵盖广泛的工作负载形态和 SLA。产品变更或 harness 的算法变更、开源模型的后期训练都可能导致流量形态发生变化(例如,新的后期训练增加了模型用于思考的 token 数量,以换取更高质量)。
- 硬件变化更快、更频繁。我们已经看到从 B200 到 GB300 推理服务能力的重大变化,并且正处于首批 Vera Rubin 部署的前夕(更不用说 CPU 级优化、先进存储系统和替代推理芯片了)。
多态推理是我们对这些变化的回应——即能够变化并适应这些快速变化环境的推理。
我们将其与开源推理爆发之前的世界状态进行对比——我们回溯性地称之为“静态推理”时代。现代多态推理呈现出无限不同的形态,而静态推理则由闭源模型、传统 Transformer 架构、单用户和单硬件平台推理所定义。
从静态推理到多态推理
我们撰写这篇博客文章的动机之一是,围绕推理系统的许多讨论仍然相当集中于传统的静态推理范式。
- 例如,网上典型的 vLLM、SGLang 或 InferenceX / AgentX 方案都是以静态超参数调优的推理引擎配置启动的。针对一种设置优化的配置不一定适合另一种设置。
- 开源 kernel 在发布时经常假设某些静态的流量形态和设计决策,这些可能与真实生产流量不匹配。一个典型的例子是 MoE kernel;一个在随机 token 上表现良好的 MoE kernel 可能无法迁移到真实生产环境。
我们在此负有一定责任!长期以来,编写适用于多种设置的 kernel 一直是可能的。FlashAttention——我们心中珍视的成果——仍然是运行训练工作负载和许多 prefill 工作负载的最佳方式之一。
大约两年前,我们撰写了关于 AI 推理 megakernel 的文章,即围绕单一静态形态(例如,batch size 为 1 的 Llama 1B)精心设计的单个 kernel。但通过去年为客户将首批 megakernel 投入生产的经验,我们学到了一个有趣的教训:megakernel 融合实际上并不是现代多态推理的正确设计目标!在多态推理时代,每一种变化——从模型架构(例如 MoE)到工作负载(大于 batch size 1 的动态工作负载)——都需要不同的技术方法。
针对多样、快速变化的条件优化多态推理
在 Together,我们本质上是系统和 AI 研究者——因此我们认为这是一个令人无比兴奋的时刻,可以为这个光明的新未来重新思考我们的研究议程。
那么,当你的生产流量变得日益多样时,解决方案是什么?让 AI 智能体优化它们自身。这就是开源模型的 RSI 时刻!
实现多态推理需要解决我们在模型服务方式上的诸多技术挑战。理想的多态推理体验能够响应快速变化的模型架构和工作负载格局。
例如:
- 如果你的流量形态发生变化——无论是通过产品变更还是用户行为变化——你应该期望你的推理系统快速适应。
- 如果你在新模型上部署工作负载——你应该期望你的推理提供商尽快接近理想的手动调优基线。
- 如果你有一个用户流量稳定的现有产品,并将其部署到新的硬件平台上——你应该期望性能尽快接近硬件极限。
这些是崇高的目标,但我们相信它们值得为之努力。对我们来说,实现这些目标的关键之一就是让 AI 智能体帮助优化自身。RSI 循环已经为开源模型准备就绪!
使用 Together Compiler 进行持续编译
我们今天宣布的项目之一,是实现 Polymorphic Inference 目标的第一步,它就是Together Compiler,一个由 AI 驱动的快速性能优化 RSI 循环。如今,Together Compiler 为我们许多顶级生产推理工作负载提供持续编译优化循环。
Together Compiler 将优化推理工作负载这一经典挑战,从传统的编译器翻译问题重新构建为智能体搜索问题。Together Compiler 识别出一组核心的关键优化模式,并将一群智能体与一个高保真持久化引擎配对,以实现快速迭代。这项工作由 Together 的 Frontier Performance 团队历时数月完成,尤其是 Reyna Abhyankar 和 Dylan Lim!
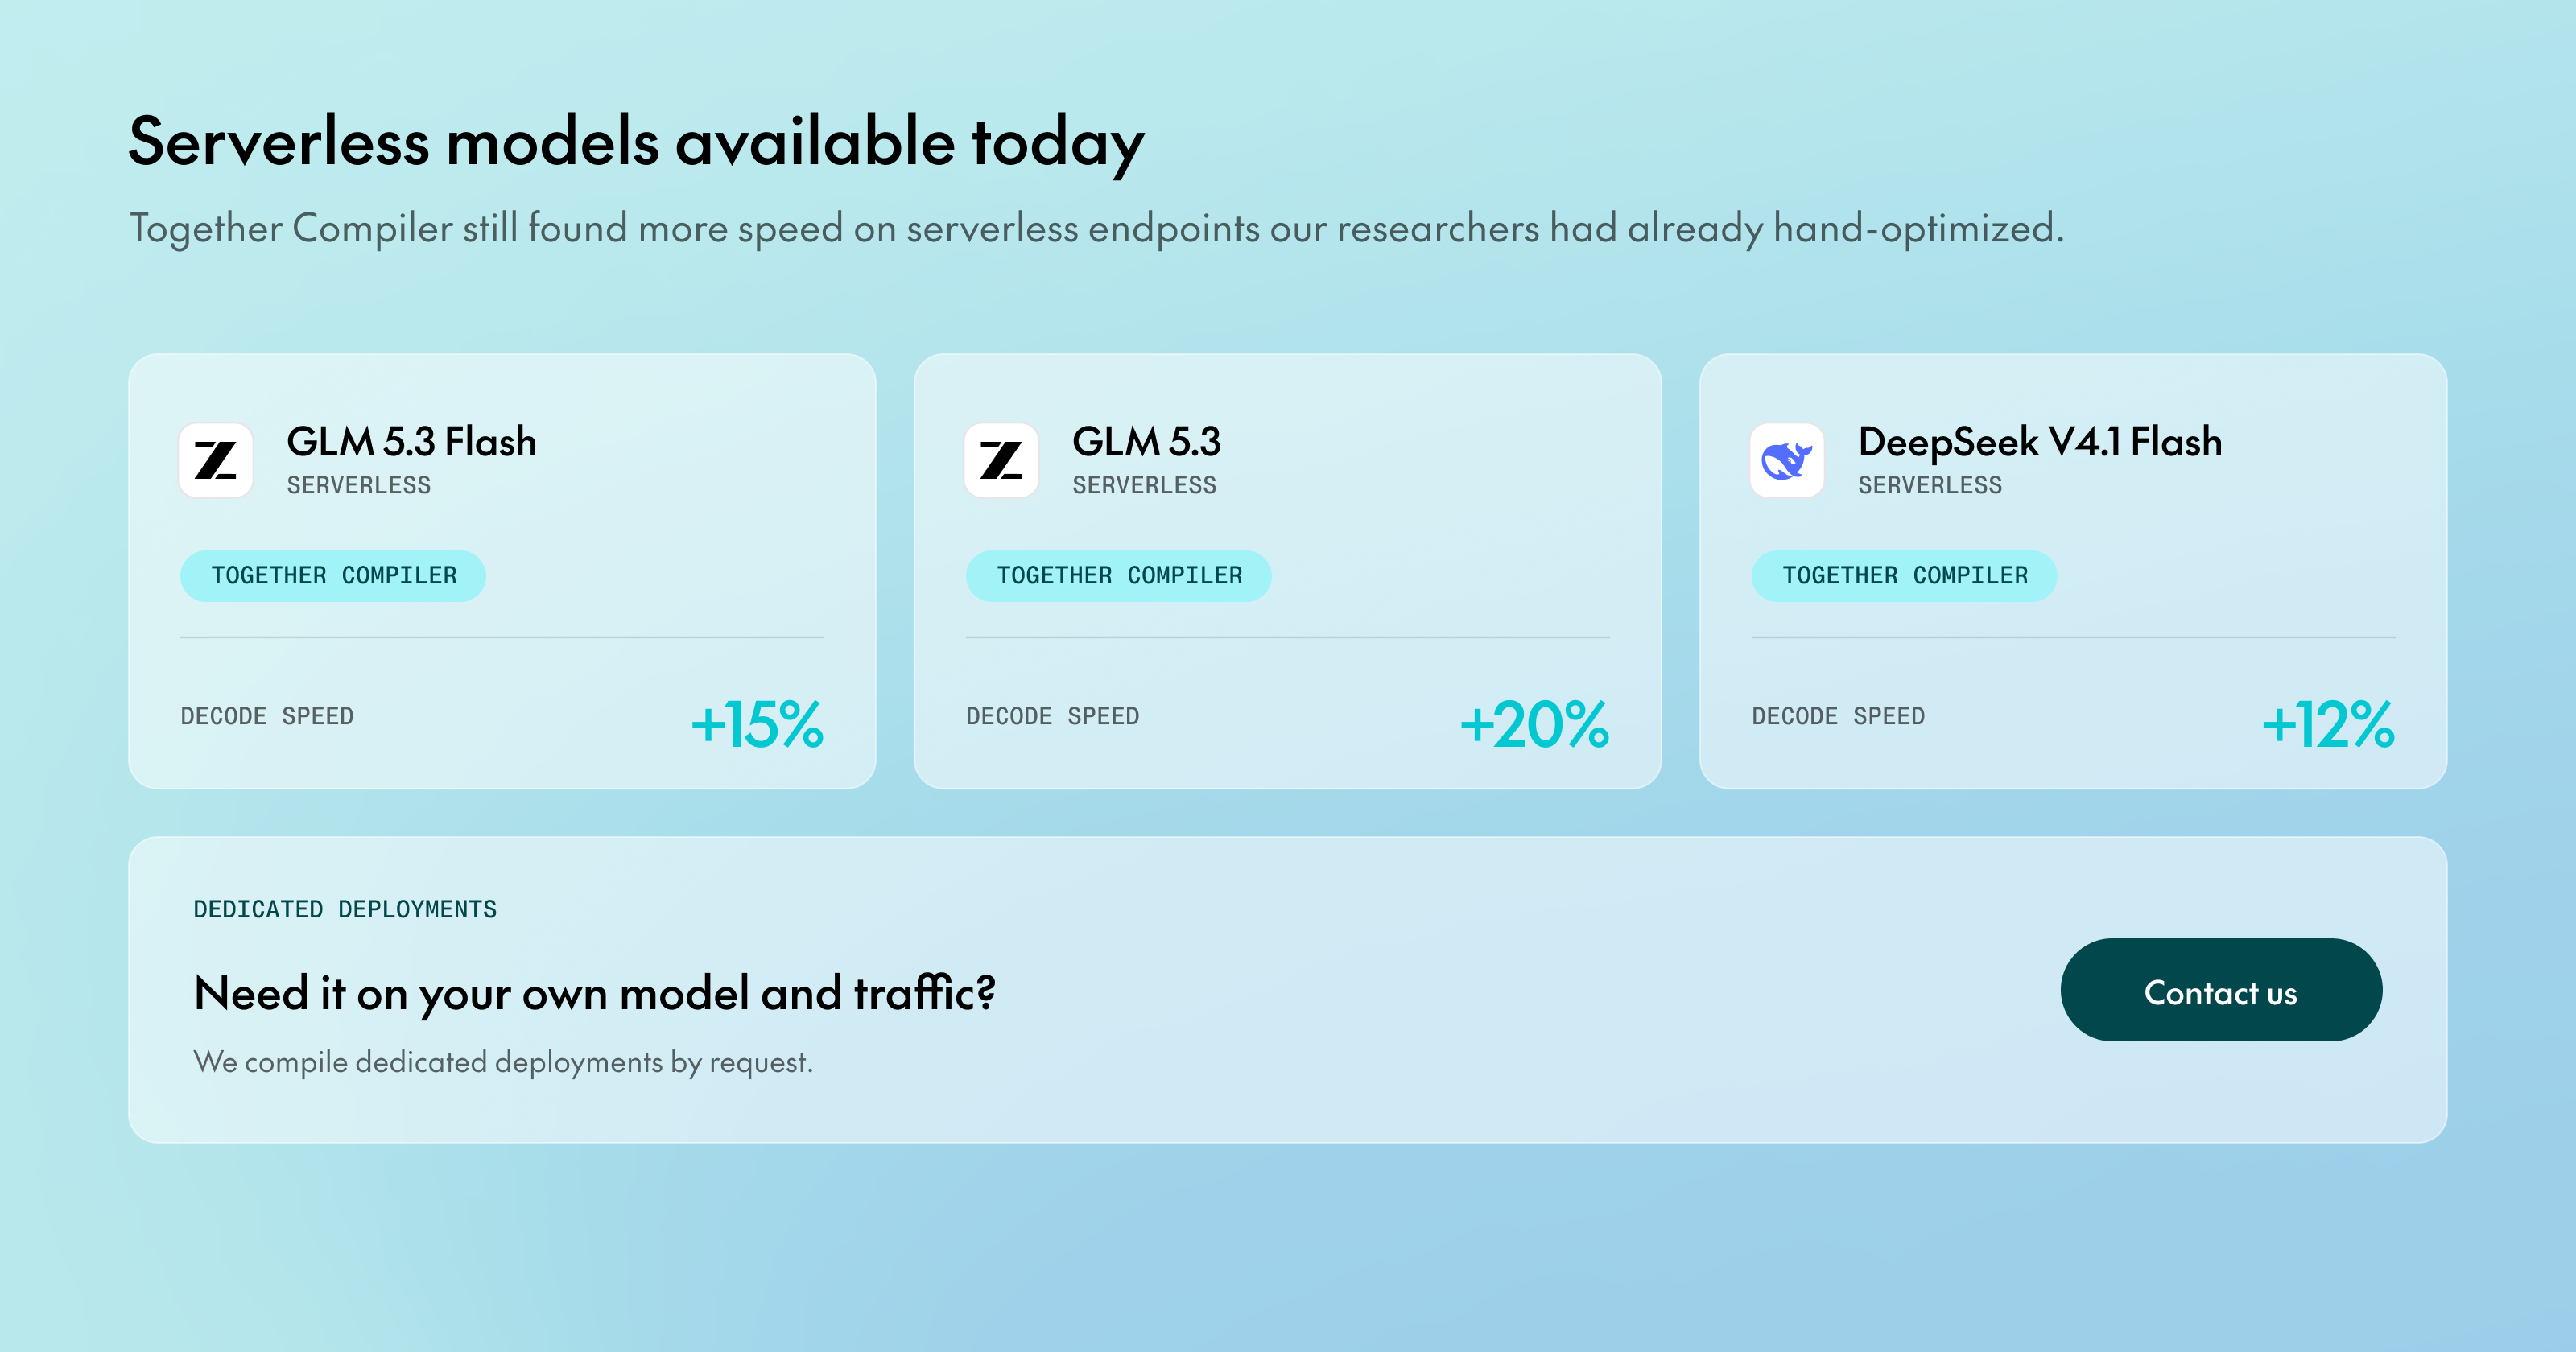
Together Compiler 目前已在一些最受欢迎的 serverless 端点上投入生产运行,并在已经高度优化的代码之上进一步获得了收益。
令人兴奋的是,Together Compiler 使我们能够快速适应快速变化的模型架构和流量工作负载。我们将这一能力称为持续编译。此前,新的工作负载需要新的手写内核和优化,而由 Together Compiler 驱动的持续编译意味着我们可以自动适应新的流量形态和工作负载。
Together AI 研究团队的下一步计划
在将 Together AI 扩展到每天服务数万亿 token 的过程中(甚至在 10 月早些时候,我们在 OpenRouter 上服务的 token 数量首次超过了闭源模型实验室!),我们学到了大量经验。这塑造了我们对 Polymorphic Inference 时代的愿景和研究议程。以下是我们研究议程中即将推出的一些内容的预览:
使用 Together Compiler 的自助式持续编译
性能优化需要成为工作负载部署的函数:模型、引擎、流量形态和客户用例。很快,我们的客户将能够通过点击按钮,使用 Together Compiler 为其专用端点针对其独特工作负载进行优化。
Together Compiler 目前以有限测试版向最终客户提供——如果你想获得早期访问权限,请联系我们!
可变形态的推测解码
开源仓库、VLLM、InferenceX、AgentX 中提出的推理引擎配置,会以固定的推测解码草稿模型和前瞻参数启动引擎。推测解码需要按领域、按请求、按 token 以及作为流量负载的函数进行自适应。
ThunderAgent Router:跨异构部署的路由
Serverless 推理端点服务于海量用户,每个用户都带来自己的流量形态和 SLA。这种异构性要求我们在集群内跨 worker 和部署配置动态路由请求。我们发布了 ThunderAgent 作为 ICML 2026 Spotlight 论文,以分享一些早期见解,并在生产环境中扩展了这些基础。
Together 后训练
现在有多个客户希望将开源模型后端集成到他们的 AI 应用中。这需要选择一个开源模型,根据客户的具体工具调用和用例选择和定制 harness,并对模型进行后训练,使其与该 harness 良好交互。我们与包括 Moonshot、Minimax 等在内的模型实验室的紧密合作,使我们能够帮助客户为其自身用例定制开源模型,并真正拥有自己的智能技术栈。
TogetherLink:工作负载感知的模型路由
随着开源模型的进步,一个关键环节是让它们进入每个人的手中。普遍的看法是,像 Opus 5.5 这样的闭源模型总是最好的。但是,正如 AI 的历史反复向我们展示的那样,如果以正确的方式组合,将几个相当不错的模型进行集成,绝对可以胜过使用单个出色的模型。这建立在我们在斯坦福 Hazy Research Lab 从事弱监督工作的根基(Ask Me Anything)以及我们自己关于组合模型的工作(Mixture-of-Agents,ICLR 2025)之上。
为所有人提供丰富的智能
推理是 AI 系统中最迷人的问题之一,我们通过服务规模解锁了大量新见解。为了实现让 AI 对每个人都丰富可及的目标,我们需要我们的推理系统在 Polymorphic Inference 时代持续为每个用户和每个工作负载进行定制。我们很高兴能帮助闭合这一循环,并在使 AI 系统真正递归自我改进方面发挥一点作用。
如果 Polymorphic Inference 背后的理念与你的组织或用例产生共鸣,请联系我们以获取早期访问权限——我们很乐意帮助你应对这些新的复杂性。
最后——如果你想帮助我们共同应对 Polymorphic Inference 的挑战,请查看我们的招聘页面——我们正在招聘!