我对 Web 开发社区的一大不满是,我们做出的许多决定都是基于感觉的。框架“快如闪电”,工具会“超级加速”你的开发,正确的抽象会让开发者和用户都受益(DX 和 UX 一举两得!)。所有这些不喘气的吹嘘通常都没有任何证据。Alex Russell 称之为“前端的失落十年”,Baldur Bjarnason 称编程为流行文化,而我试图在我的博客中用事实和基准测试来对抗这一趋势(至少在我最好的时候是这样)。
很长一段时间里,我们社区对证据的过敏似乎是由对更好 DX 的渴望驱动的。换句话说,开发者就是喜欢在 React 中敲 JSX 的感觉,而推广 React 或相关工具(“虚拟 DOM 很快!”)的论点在很大程度上是为了证明那些最初直觉的事后合理化。(Jonathan Haidt可能会同意这一评估。)
但在智能体时代,当开发者不再手写代码、因而受 DX 的约束更少时,我仍然看到感觉主导一切(而且不只是“氛围编程”意义上的)。前端被重写,是因为某个框架“对智能体更好”。(有人想过问问智能体吗?)结果代码“更快”,智能体“犯更少的错误”,等等。再一次,这些说法往往没有证据。每当我读到这类叙述时,我都会想:“基准测试在哪里?”
好吧,我很好奇,所以我写了一个基准测试。这个基准测试的结构相当直接:
- 使用PokéAPI设计一个小巧但不简单的 Pokémon 应用(关注我的工作的人不会感到意外)
- 指示智能体用特定的 JavaScript 框架/元框架(例如 Next.js、Nuxt、SvelteKit 等)构建应用
- 用规范一致性测试套件测试输出(以避免智能体作弊)
- 从开发时间、消耗的 token 数、代码行数,以及Lighthouse中的性能和可访问性分数来评估结果
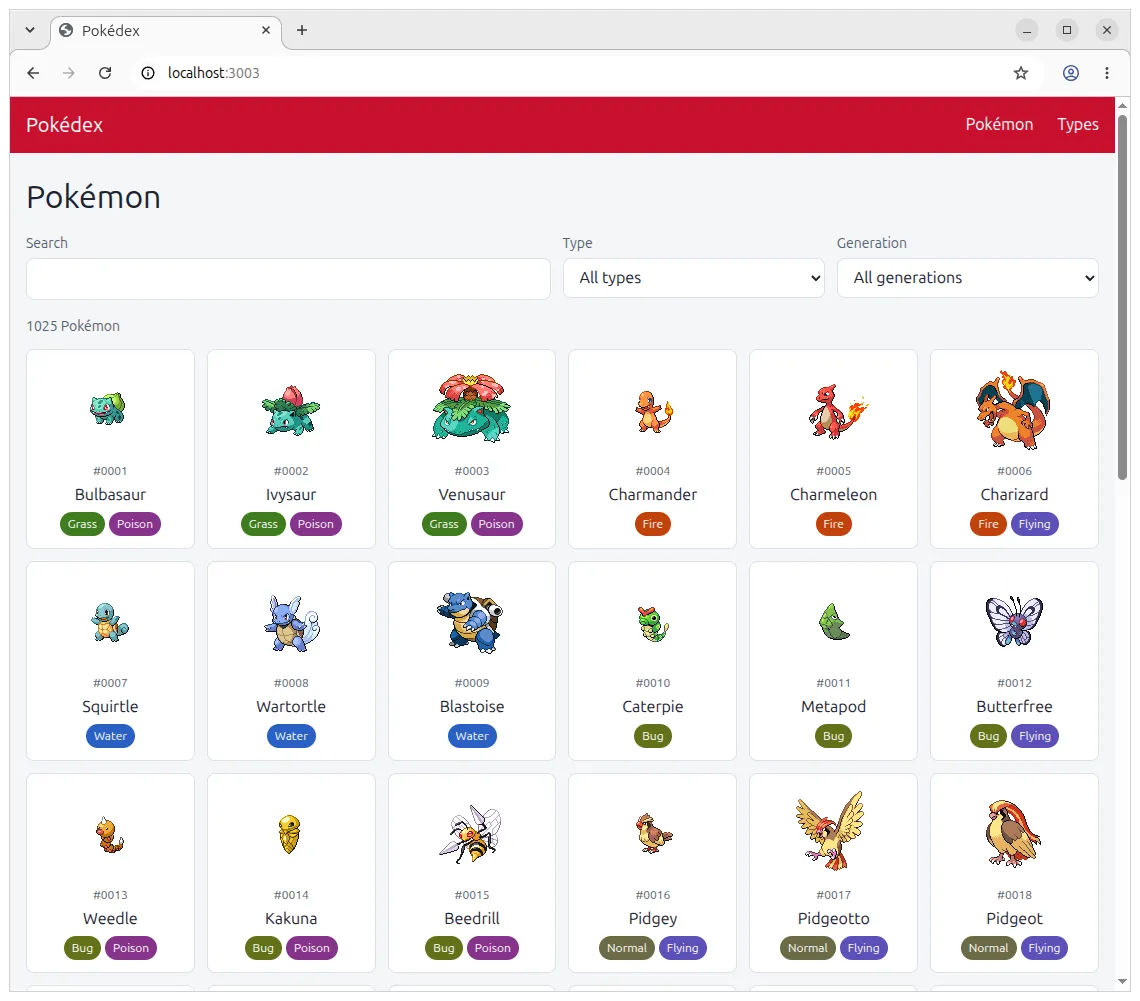
这个应用相当简单:你有一个 Pokémon 列表,包含它们的属性、招式以及来自各种游戏的数据。你可以搜索、筛选等:
我应该先说明一些注意事项:这不是一个完美的实验。这个应用只代表一个正模标本——它是一个相对以内容为主的网站,交互性很少,更接近 Wikipedia 而不是 Figma、GMail 等。话虽如此,我总得选择某个应用来构建,而这个应用至少在高层次上容易理解,并且相对容易编写规范和测试。
为了尽量公平,我让每个框架/元框架使用该工具的官方 MCP 或 skills。我想避免“这个框架在训练数据中代表性不足,这就是我们构建 MCP 的原因,我们期望人们使用它”之类的指责。我也没有过度指定要使用的确切架构(例如 SSR 还是 CSR),也没有指定应用应尽可能高性能。我只是把规范交给 Opus 5.5,并设置高努力,告诉它使用给定框架的最新版本。每个智能体都在沙箱中运行,并且不知道它将在 Lighthouse 中接受性能和可访问性测试,尽管它获得了规范一致性测试套件。
注意,我也没有强制任何 CSS 方法论,只是避免使用 Tailwind、Bootstrap 或任何其他组件框架,并基于一组规范 token 进行设计以强制某种视觉一致性。我不想让这个测试完全围绕 CSS,而是围绕 JS 框架、CSR 与 SSR、SPA 与 MPA 等。生成的应用基于可访问性树而不是原始 DOM 进行一致性测试套件测试,以避免强制任何特定的 HTML 结构——一个框架使用了依赖 shadow DOM 的 Web Components,所以这是必需的。
我从这个实验中学到的一件事是,我所测量的一切都非常随机。LLM 是随机词生成器,所以有时你会掷出低点数,智能体会跑偏到某个奇怪的切线,浪费大量 token,而这并非框架或其工具的过错。Lighthouse 本身也可能给出不一致的结果:最大内容绘制(LCP)可能决定一张图像是“最大”元素,然后在下次运行时选择另一张。很难有一个完全公平的实验,但运行多次迭代确实有帮助,我也尽量对差异保持诚实。
清完嗓子,让我们进入结果。
结果
我将从多个维度来分解:构建成本、质量和可维护性。对于每个框架/元框架,我取 5 次运行的中位数:换句话说,我在同一框架中构建了同一个应用 5 次。(是的,这就是如今用编码智能体可以做的疯狂事情。)
例外是 Angular,它两次未能创建可测量的应用,所以对于某些指标我改用了 3 次迭代。(下面会解释。)
成本
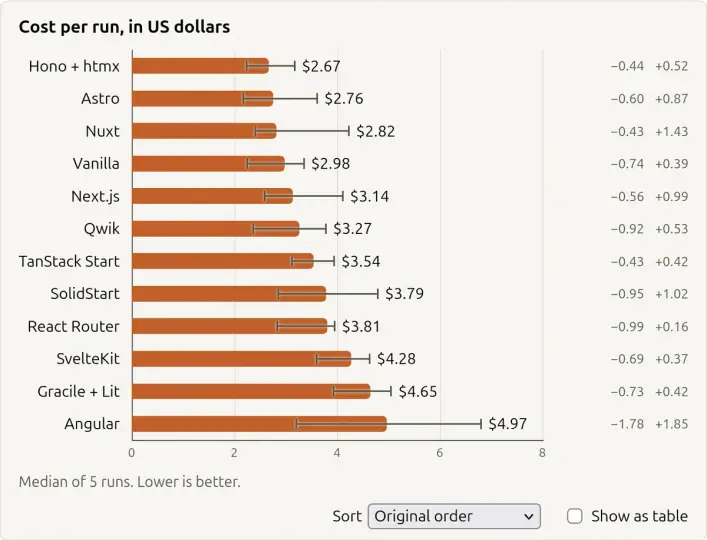
每次运行的成本,以美元计
| 框架 | 成本($) |
|---|---|
| Hono+htmx | $2.67 (2.23–3.19) |
| Astro | $2.76 (2.16–3.63) |
| Nuxt | $2.82 (2.39–4.25) |
| Vanilla | $2.98 (2.24–3.37) |
| Next.js | $3.14 (2.58–4.13) |
| Qwik | $3.27 (2.35–3.80) |
| TanStack Start | $3.54 (3.11–3.96) |
| SolidStart | $3.79 (2.84–4.81) |
| React Router | $3.81 (2.82–3.97) |
| SvelteKit | $4.28 (3.59–4.65) |
| Gracile+Lit | $4.65 (3.92–5.07) |
| Angular | $4.97 (3.19–6.82) |
| 02468 |
5 次运行的中位数。
请注意,这直接引用了 Claude Code 的 API 价格,并不实际代表我花了多少钱。我使用的是 Max 计划,所以这只是我每月 100 美元总支出的一部分。
还要注意方差:React Router 的中位数比 Hono+htmx 差约 1 美元,但 React Router 最便宜的版本(2.82 美元)仍然比 Hono+htmx 最贵的版本(3.19 美元)便宜。然而,一些可靠的模式确实出现了。
最明显的是,SvelteKit、Gracile+Lit 和 Angular 的构建成本高于其他框架。对于 SvelteKit,这可能是因为智能体在每次运行中都会阅读 SvelteKit v3 迁移指南,很可能是因为它太新,不在 Opus 5.5 的训练数据中。Gracile 同样如此,智能体对该框架不太了解,要么克隆了 Gracile 仓库,要么从 node_modules 读取其编译后的源码。对于 Angular,这似乎是代码总规模的函数(见下文)。
我还应该提到,并非每个智能体都使用了 MCP/skill/Claude Code 插件,也并非每个框架都有这样的插件:
点击查看 AI 工具使用情况
| 框架 | 已安装 | 智能体是否使用? |
|---|---|---|
| Angular | Angular MCP 和 Angular agent skills | 5 次运行中 3 次使用 MCP,5 次运行中 4 次使用 skill 工具,5 次运行中 2 次使用 skill 文件 |
| Astro | Astro MCP server | 5 次运行中 2 次使用 MCP |
| Gracile+Lit | 不适用 | 不适用 |
| Hono+htmx | Hono skills | 5 次运行中 5 次使用 skill 工具 |
| Next.js | next-devtools-mcp 和 next-dev-loop skill | 5 次运行中 1 次使用 skill 文件,5 次运行中 2 次使用 AGENTS.md |
| Nuxt | Nuxt MCP | 不适用 |
| Qwik | 不适用 | 不适用 |
| React Router | React Router skill | 5 次运行中 5 次使用 skill 工具,5 次运行中 5 次使用 skill 文件 |
| SolidStart | 不适用 | 不适用 |
| SvelteKit | Svelte Claude Code 插件 | 5 次运行中 5 次使用 MCP |
| TanStack Start | 不适用 | 5 次运行中 2 次使用 skill 文件 |
| Vanilla | 不适用 | 不适用 |
例如,TanStack Start 的智能体仅在 5 次运行中的 2 次发现了其 skill 文件(它们随项目的 node_modules 一起提供)。对于 Nuxt,智能体从未使用过 MCP。对于 Next.js,智能体仅在 5 次运行中的 1 次阅读了 skill 文件,在 5 次运行中的 2 次阅读了 AGENTS.md。结果范围很广,这又指向了 LLM 的随机性。不过,我仍然认为这是一个有效的实验,因为我怀疑很多 vibe-coder 并不会用全大写字母对智能体大喊要求使用 MCP(而且很多人可能完全跳过它)。
另外,如果你想知道我是如何想到 Hono+htmx 的:基本上,我想以某种方式代表 htmx,而 Hono 似乎是一个不错的搭配(即作为 Rails/Django 等的 JavaScript 替代品)。至于 Gracile+Lit,我想通过其标准承载框架(Lit)来代表 Web 组件,而我只知道 Gracile 是一个元框架。如果有更好的候选者,那么它们将非常适合后续实验。
对于“Vanilla”,请注意智能体被告知使用“vanilla JavaScript 或 TypeScript 配合 Vite,不使用 UI 框架”。令人惊讶的是,它的表现不如几个框架,这似乎表明拥有某种框架总比没有好(或者至少比原始 Vite 好)。选择 Vite 是因为它支撑了许多框架,并代表了相当标准和无关的 JavaScript 基础设施。
总时间和 token 与成本跟踪得相当紧密:
每次运行的时间
| 框架 | 时间(分钟) |
|---|---|
| Astro | 8.2 分钟(6.2–9.7) |
| Hono+htmx | 8.6 分钟(5.9–9.6) |
| Nuxt | 9.0 分钟(8.0–17.6) |
| Vanilla | 10.1 分钟(6.9–18.6) |
| TanStack Start | 10.3 分钟(8.3–13.9) |
| Qwik | 10.7 分钟(7.1–12.9) |
| SvelteKit | 10.8 分钟(8.6–13.8) |
| Next.js | 10.9 分钟(8.3–11.9) |
| SolidStart | 11.2 分钟(8.2–15.9) |
| Gracile+Lit | 12.1 分钟(10.8–12.9) |
| React Router | 12.5 分钟(8.4–13.6) |
| Angular | 17.2 分钟(9.8–23.7) |
| 0510152025 |
从智能体视角计的挂钟分钟数。5 次运行的中位数。
每次运行的 token 数,单位为百万
| 框架 | Token 数(百万) |
|---|---|
| Nuxt | 3.85 M(3.16–8.18) |
| Astro | 4.13 M(3.03–7.57) |
| Hono+htmx | 4.26 M(3.40–5.61) |
| Next.js | 4.99 M(3.54–8.82) |
| Vanilla | 5.00 M(3.44–6.32) |
| Qwik | 5.64 M(3.41–7.03) |
| TanStack Start | 7.07 M(5.85–7.99) |
| SolidStart | 7.13 M(5.02–10.07) |
| React Router | 7.58 M(4.55–8.18) |
| SvelteKit | 8.53 M(6.79–9.29) |
| Gracile+Lit | 9.04 M(7.36–11.10) |
| Angular | 9.76 M(4.92–14.94) |
| 051015 |
缓存读取、未缓存输入与输出。5 次运行的中位数。
顺便说一下,这些 token 数是由 Claude Code 报告的。时长只是总的挂钟时间。
质量
当然,因为我认为结果很重要,所以我也用 Lighthouse 测试了这些智能体。作为软件开发者,我认为重要的是我们不仅要低成本地构建东西,还要保证性能和可访问性。
我首先应该说明关于我的基准测试的两点注意事项:
- 这个 Pokémon 应用很小,并不能代表大型、复杂的真实世界应用。
- Lighthouse 以及总体上核心网页指标(Core Web Vitals)对 SPA 存在偏见,因此 MPA 框架几乎必然会在总阻塞时间(TBT)、JavaScript 字节数等指标上胜出。我曾考虑加入一些应用内性能指标,但最终放弃了,因为这会给基准测试增加复杂性和变异性,而且这些指标会是我自己发明的,而非行业标准。
为简单起见,我只报告首页的分数。还有其他页面,但它们的得分都相当相似,或者像 LCP 这样的指标波动很大,所以把它们包含进来只会让事情复杂化。
简而言之:性能、可访问性和 CLS(累积布局偏移)的 Lighthouse 分数几乎已经饱和,并且不会因框架而有太大差异:
| 框架 | CLS | 性能 | 可访问性 |
|---|---|---|---|
| Angular | 0.000 | 98 | 100 |
| Astro | 0.000 | 100 | 100 |
| Gracile+Lit | 0.000 | 100 | 100 |
| Hono+htmx | 0.000 | 100 | 100 |
| Next.js | 0.000 | 99 | 100 |
| Nuxt | 0.000 | 100 | 100 |
| Qwik | 0.000 | 100 | 100 |
| React Router | 0.000 | 100 | 100 |
| SolidStart | 0.000 | 100 | 100 |
| SvelteKit | 0.000 | 100 | 100 |
| TanStack Start | 0.000 | 99 | 100 |
| Vanilla | 0.111 | 97 | 100 |
因此,要得到一些更有意思的数字,我们需要看其他指标。最可靠的是发送的 JavaScript 字节数,它很大程度上反映了客户端框架的大小:
传输的 JavaScript 字节数
| 框架 | JS(KiB) |
|---|---|
| Astro | 0 KiB(0–1) |
| Vanilla | 7 KiB(6–7) |
| Gracile+Lit | 8 KiB(1–13) |
| Hono+htmx | 18 KiB(18–18) |
| SvelteKit | 36 KiB(35–36) |
| SolidStart | 40 KiB(38–40) |
| Qwik | 40 KiB(40–41) |
| Nuxt | 84 KiB(83–85) |
| Angular | 93 KiB(81–102) |
| React Router | 115 KiB(115–119) |
| TanStack Start | 118 KiB(112–119) |
| Next.js | 142 KiB(136–143) |
| 050100150 |
由 Lighthouse 报告。5 个应用的中位数(Angular 为 3 个)。
总阻塞时间(TBT)有意思的地方在于,它并不纯粹是 JavaScript 字节数的函数;有些应用在主线程上花费的时间比其他应用更多。话虽如此,这些数字都相当小:
总阻塞时间(TBT)
| 框架 | TBT(ms) |
|---|---|
| Astro | 0 ms(0–0) |
| Gracile+Lit | 0 ms(0–0) |
| Hono+htmx | 0 ms(0–0) |
| SvelteKit | 0 ms(0–1) |
| Vanilla | 0 ms(0–0) |
| TanStack Start | 1 ms(0–36) |
| Qwik | 3 ms(0–30) |
| SolidStart | 11 ms(0–12) |
| React Router | 17 ms(0–52) |
| Nuxt | 40 ms(14–54) |
| Next.js | 71 ms(66–121) |
| Angular | 103 ms(93–123) |
| 0255075100125 |
由 Lighthouse 报告,模拟移动端节流。每个应用取 5 次 Lighthouse 运行的中位数,然后再取 5 个应用的中位数(Angular 为 3 个)。
最大内容绘制(LCP)由于前述该指标本身的问题而波动很大。不过正如预期,它总体上会惩罚 SPA 而奖励 MPA:
最大内容绘制(LCP)
| 框架 | LCP(ms) |
|---|---|
| Astro | 810 ms(792–1662) |
| Gracile+Lit | 956 ms(796–980) |
| Hono+htmx | 978 ms(977–1662) |
| Qwik | 979 ms(954–1278) |
| SvelteKit | 1130 ms(1129–1131) |
| SolidStart | 1204 ms(1203–1278) |
| Vanilla | 1667 ms(764–1676) |
| Nuxt | 1727 ms(1427–1844) |
| React Router | 1729 ms(1729–1770) |
| Angular | 1954 ms(1351–1955) |
| TanStack Start | 2028 ms(1805–2104) |
| Next.js | 2090 ms(1028–2187) |
| 05001000150020002500 |
由 Lighthouse 报告,模拟移动端节流。每个应用取 5 次 Lighthouse 运行的中位数,然后再取 5 个应用的中位数(Angular 为 3 个)。
测试环境:2025 款 Framework 13 笔记本电脑,运行 Ubuntu 24.04,4 倍 CPU 节流,以及“Slow 4G”网络节流。我只运行了 Lighthouse 的移动端测试,没有运行其桌面端测试。
请注意,Next.js 数值的巨大差异可以解释为:一个应用避免了图片懒加载,而另外四个应用没有。Astro 和 Vanilla 也有类似的波动,似乎是由优先级或 LCP 的怪癖造成的。
不过总的来说,这个指标倾向于奖励用 HTML 快速绘制的 MPA,而不是在客户端 JavaScript 运行后才绘制的 SPA(后者可能还需要多次受节流影响的往返来获取 Pokémon 数据),这并不令人意外。忽略波动的话,这里的 LCP 主要是 JavaScript 包大小的函数。(Qwik 在这里是一个显著的例外:严格来说它是一个使用客户端路由的 SPA,但它的得分却处于 MPA 框架之列。)
不过请注意,一些框架在更侧重客户端还是服务器上存在差异,甚至是否使用客户端框架也不尽相同。例如,Gracile 智能体在两次运行中甚至没有使用 Lit。对于“Vanilla”,智能体拥有完全的自由(除了被告知要使用 Vite),但仍然在全部 5 次中都选择构建 SPA。
SSR 与 CSR 也是 Angular 部分问题的来源:在 2 次运行中,智能体构建了一个拒绝非 localhost 的 SSR 应用(尽管说明中明确写道该应用将位于反向代理之后)。我认为这是未遵守规范的有效失败,并决定不重新运行这 2 次失败的迭代。(这只影响代码大小和性能测量;在“成本”部分,我报告了全部 5 次 Angular 迭代。)
可维护性
衡量可维护性的方法有很多(包括圈复杂度之类花哨的东西),但我决定保持简单,报告一个久经考验的指标:代码总行数。
代码行数
| 框架 | 代码行数 |
|---|---|
| Hono+htmx | 1370 (1264–1489) |
| Nuxt | 1415 (1382–1458) |
| Astro | 1461 (1379–1503) |
| Vanilla | 1492 (1437–1742) |
| Next.js | 1539 (1452–1627) |
| React Router | 1564 (1421–1621) |
| SvelteKit | 1611 (1503–1816) |
| SolidStart | 1630 (1528–1894) |
| TanStack Start | 1697 (1506–1771) |
| Gracile+Lit | 1717 (1412–1748) |
| Qwik | 1744 (1646–1827) |
| Angular | 2009 (2003–2051) |
| 05001000150020002500 |
非空源文件行数。5 个应用的中位数(Angular 为 3 个)。
对我来说,这是比较有趣的图表之一。从某种意义上说,框架的全部意义就在于减少你需要维护的代码量。用 Rich Harris 令人难忘的话来说:
“框架不是组织代码的工具;它们是组织思维的工具。”
——Rich Harris,“重新思考响应式”
在智能体时代,这一点更加重要,因为代码大小最终会影响 token 数量,包括在未来的编辑中,这意味着它会影响随时间推移维护代码库的实际成本。这并不意味着简洁是唯一重要的价值,但看到 Hono+htmx 能用约 70% 的代码完成与 Angular 大致相同的事情(而且速度还更快),确实很有趣。
结论
你可以用很多方式改进这个基准测试。例如,你可以要求智能体使用 Service Workers 进行离线缓存,或者优化 Pokémon 图片文件,或者使用懒加载、fetchpriority、Speculation Rules API 等。尽管我知道很多这类性能技巧,但我刻意没有引导智能体去使用其中任何一种,因为这不是典型的 vibe-coder 会做的事。
另一方面,只要把所有 HTML 文件预生成为静态资源(Pokémon 数量有限),整个基准测试就可以被作弊。我在指令中明确禁止了这一点,并在测试框架中将其设为显式检查,因为我觉得这不符合基准测试的精神。(我的目标是模拟大量可能是动态的数据,这比纯静态站点更具挑战性。)
你也可以改进我运行基准测试的方式:运行更多迭代、使用不同的编码智能体、尝试不同的努力程度、使用不同的框架或框架的不同版本、尝试使用和不使用 MCP/skills、在 Chromium 之外的更多浏览器中测试、构建不同类型的应用等。我没有做这些事,主要是为了节省时间。不过,如果有人想自己运行这个基准测试或 fork 它,它就在 GitHub 上,所以我鼓励你尽情折腾。我会很乐意在这里报告你的结果(以及你可能发现的任何错误或缺陷)。
我在这里的目标不是写出“我是个 vibe-coder,该选哪个框架?”的终极基准测试。这篇文章的重点是证明,在 AI 编码时代,仍然有可能基于证据而不是感觉来做决定。这个基准测试本身很大程度上是 vibe-coded 的,尽管我确实审查了代码,所以如果有错误,请把它们算在我头上。我也非常乐意看到竞争框架尝试改进我在这里所做的工作。
我也不是想诋毁任何特定框架。在运行基准测试之前,我并不知道哪一个会“赢”,尽管我确实怀疑 MPA 会胜过 SPA(我在整篇文章中都乐于承认这一点)。你当然可以通过把应用做成复杂仪表盘、电子游戏、生产力应用等,来编写一个更偏向 SPA 的基准测试。你也可以选择不同的指标:Lighthouse 和 Core Web Vitals 对 SPA 相当苛刻,所以你可以改为衡量应用内交互性。
我也确信,框架作者们自己可以改进他们的框架或 AI 工具,并在这个基准测试中做得更好。例如,我强烈怀疑当前这批 MCP 和 skills 可能弊大于利。所以,如果这篇文章成为这些框架性能的最终定论,我会非常失望。我也确信,还有一些新兴框架正迫不及待地想在这样的基准测试中取得好成绩。
至少,我希望这篇文章能启发你在这个奇异的 vibe coding 新时代,对 JavaScript 框架的选择进行额外的审视。你真的是基于证据来选择技术栈吗?还是只是沿用你已经熟悉的东西?这完全可以理解,尤其是如果你仍然亲自阅读、审查和调试代码。但如果你已经基本放手不管,那么你对当年像动物一样逐行敲代码时所做的选择,究竟还有什么执念?如果你正在重新评估构建软件的整个方式,也许值得重新评估一下你在 npm install 之后输入的内容?只是说说而已。
就个人而言,除了我相信我们应该努力为用户构建尽可能最好的体验之外,我对上面评估过的框架没有任何执念。我认识并尊重上述许多框架的作者,我知道他们正在为我所倡导的相同价值而不懈努力。我只是希望推动整个社区朝着更好的方向前进,打造更好、更快、更易访问的框架,为下一代 Web 应用提供动力。
附录
测试中使用的框架版本(注意 Qwik 在测试中途发布了一个补丁版本):
| 框架 | 版本 |
|---|---|
| Angular | @angular/core 22.2.3 |
| Astro | astro 7.4.2 |
| Gracile+Lit | @gracile/gracile 0.11.0, lit 3.3.3 |
| Hono+htmx | hono 4.13.14, htmx.org 2.0.11 |
| Next.js | next 16.4.3, react 19.3.1 |
| Nuxt | nuxt 4.6.2, vue 3.5.44 |
| Qwik | @builder.io/qwik-city 1.20.2(第 1 次迭代),1.20.3(第 2、3、4、5 次迭代),@builder.io/qwik 1.20.2(第 1 次迭代),1.20.3(第 2、3、4、5 次迭代) |
| React Router | react-router 8.5.0, react 19.3.1 |
| SolidStart | @solidjs/start 2.1.0, solid-js 1.9.17 |
| SvelteKit | @sveltejs/kit 3.1.0, svelte 5.57.2 |
| TanStack Start | @tanstack/react-start 1.169.4, react 19.3.1 |
| Vanilla | vite 8.3.5 |
更新:本文早期版本夸大了 Angular 智能体无法构建可运行应用的程度。我已澄清每个指标的迭代次数,并重新措辞本文以避免歧义。
你可以在 fediverse 或 Hacker News 上发表评论。