自主智能体可以在复杂任务上工作数小时,访问文件、工具、互联网,并生成其他智能体与之协作。在长时间跨度上执行复杂任务会带来叠加风险:智能体可能下载代码、构建新工具、请求额外权限,并触及更多底层基础设施。
智能体的行动路径是在其工作并推理完成目标所需步骤的过程中确定的。当它们与周围的工具和系统交互时,会调整其推理和行为以完成任务。
智能体的适应性正是其强大之处,但它们以目标为导向,在追求目标时可能不会优先考虑安全性。为了让智能体既能自主又能安全地工作,我们需要构建能够对智能体行为提供控制和可见性的环境。
智能体无法自我治理。安全与治理应属于智能体运行所在的基础设施。
OpenShell 在智能体触及范围之外提供确定性治理
NVIDIA OpenShell 是一个开源运行时,用于将智能体系统所需的安全与治理构建到计算基础设施中。OpenShell 定义并强制执行智能体可以访问哪些系统和数据,从文件和互联网服务到与物理设备交互的系统。
它是用于构建安全 AI 智能体的 NVIDIA OpenShell 参考架构 的基础。OpenShell 在整个执行过程中将智能体工作负载视为不可信。智能体在需要时获得其所需之物的访问权限。
OpenShell 有四个关键组件:
- 网关(Gateway):管理沙箱生命周期和策略的控制平面
- 监督器(Supervisor):根据策略检查出站请求并中介对凭据的访问。它完全独立于沙箱运行
- 沙箱(Sandbox):隔离智能体工作负载并限制文件系统和进程访问
- 策略证明器(Policy prover):增加形式化验证,检查策略的权限是否保持在组织定义的上限之内。
随着智能体的演进,这些组件提供使其能够安全工作的基础设施控制。
扩展和集成 OpenShell
可扩展性是 OpenShell 设计的核心原则。监督器中间件让你可以检查、阻止或更改智能体通过网络发送和接收的内容,作为额外的执行层。网关拦截器让操作员无需修改网关即可为 OpenShell 控制平面操作添加特定于部署的治理。
组织还需要确定智能体代表谁行事、它拥有什么权限,以及某项操作是否符合任务。身份、授权、数据保护和审计各自解决该问题的一部分。OpenShell 提供了可以集成这些系统的执行点。
在参考架构中,OpenShell 运行在 NVIDIA Vera CPU 上。
NVIDIA Vera,控制层之下的计算层
OpenShell 定义智能体能做什么。Vera 决定它们能多快做到。智能体通过相互依赖的步骤循环运行,每一步必须完成后下一步才能开始:推理、调用工具、执行代码、查询数据。
AI 工厂 并发运行数千个这样的循环,在五个维度上对 CPU 架构提出了新要求:
- 它们需要大量核心数来运行许多并发工作流,并需要快速的单核来缩短每个顺序步骤。
- 它们需要高带宽互连和内存,以便为这些核心持续提供智能体所依赖的实时数据。
- 它们需要大规模 I/O,以在 CPU、GPU、存储和网络之间高速移动数据。
- 它们需要硬件强制的安全性,因为智能体越来越多地处理敏感的企业数据,必须彼此隔离并与主机隔离。
- 它们需要在现代数据中心的功耗范围内提供所有这些能力(每瓦更多智能体工作,而不仅仅是更多原始性能)。
NVIDIA 将这种组合称为大规模下的最高单线程 CPU,而 NVIDIA Vera 正是为此而构建:大量 Olympus 核心、第二代可扩展一致性互连(Scalable Coherency Fabric)、LPDDR5X 内存、Gen 6 I/O、机密计算,以及专为功耗受限数据中心打造的节能设计。
三项架构特性使 Vera 在智能体工作负载上表现出色
- 第一,88 个 NVIDIA 设计的 Olympus 核心,配备 10 宽前端、神经分支预测器和深度乱序执行,在关键智能体工作负载上相比 x86 提供高达 2 倍的性能,缩短每次工具调用、代码执行和评估的时间。
- 第二,Vera 的第二代可扩展一致性互连相比 x86 替代方案提供高达 3 倍的核心间带宽和高达 50% 更低的核心间延迟,在负载下保持数据可预测地流动。Vera 还集成了 96 条 PCIe Gen 6 通道,提供以智能体基础设施所需吞吐量连接 GPU、高速存储和网络的 I/O 带宽。
- 第三,高达 1.2 TB/s 的 LPDDR5X 内存带宽,以及相比基于小芯片的设计高达 40% 更低的加载内存延迟,为智能体持续提供其所需的实时上下文,而不会因内存访问而停滞。LPDDR5X 还使 Vera 显著更高效:Vera 每瓦性能是 x86 CPU 的 2 倍,而 LPDDR5X 内存子系统本身的功耗比基于 DDR5 的竞争内存配置低一个数量级,从而在相同功耗范围内实现更多智能体工作。
智能体工作负载依赖沙箱:隔离的执行环境,智能体在其中运行代码、调用工具并完成任务,而不会相互干扰或干扰主机系统。这些沙箱启动得越密集、越快速,给定基础设施占用所能维持的智能体工作就越多。
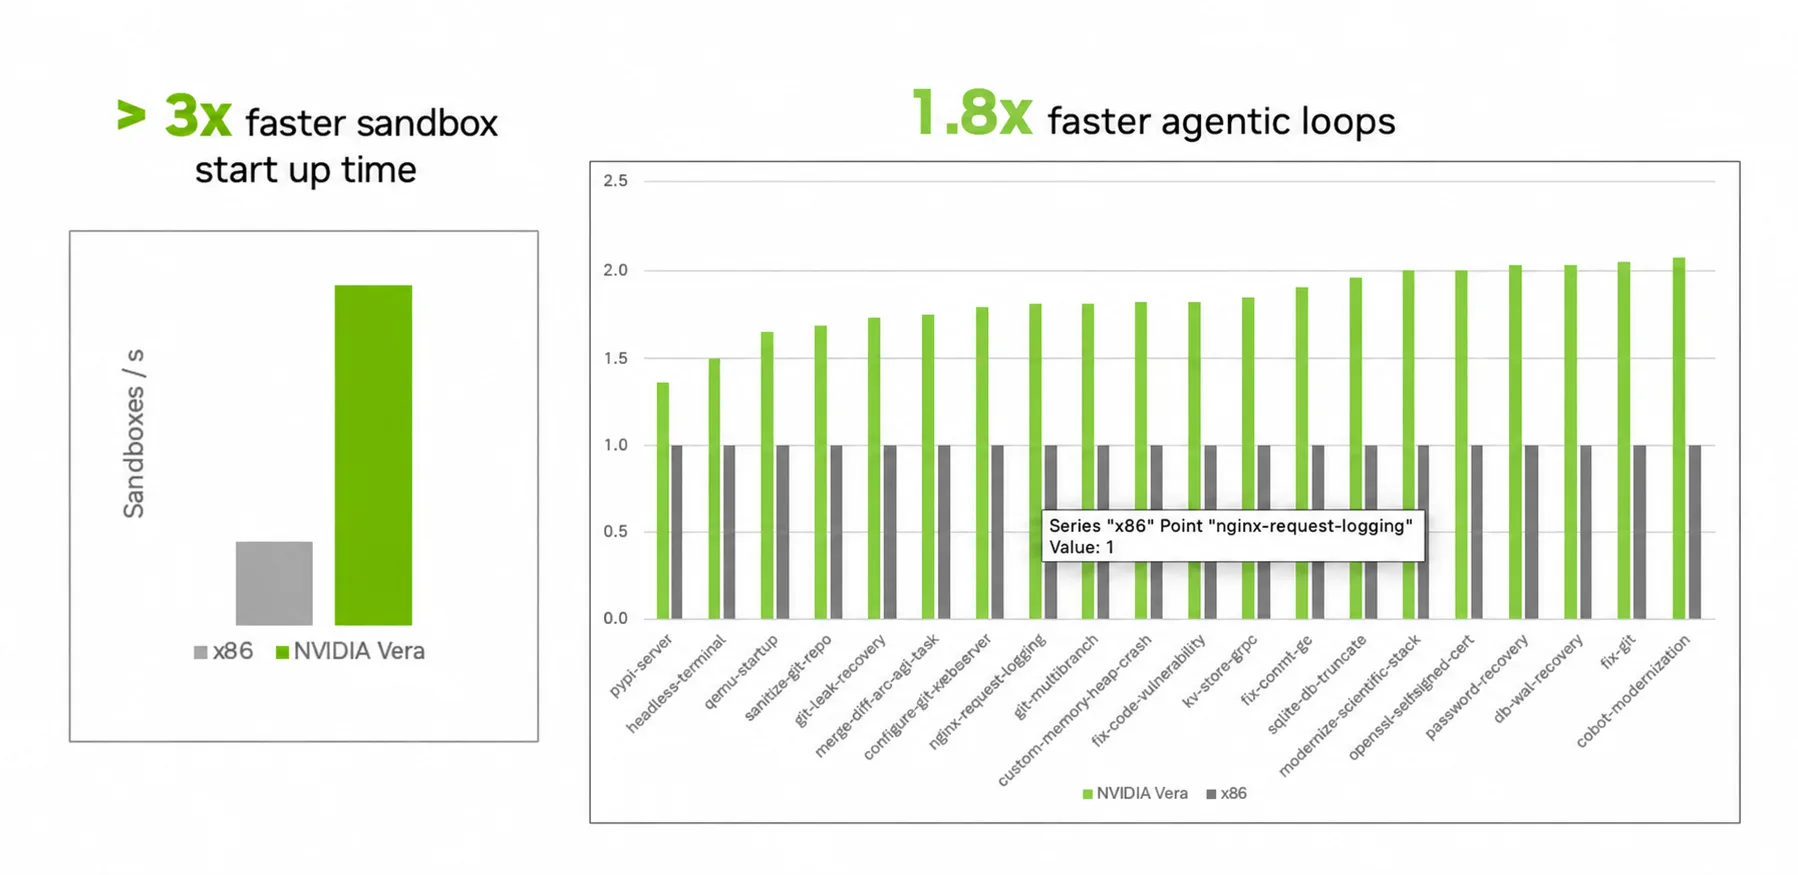
CoreWeave 是专为大规模训练和提供模型服务而构建的 AI 云平台,它发现 Vera 上的沙箱启动速度比 x86 快 3 倍以上,单个机架可支持超过 11,000 个并发智能体环境。
在运行 Terminal Bench(该基准测试衡量真实智能体循环任务中的 CPU 性能)时,CoreWeave 发现 Vera 在从脚本编写到数据库恢复等各类智能体任务中,性能比 x86 快 1.8 倍。这种负载下的密度和性能正是智能体基础设施实际所需的。
NVIDIA BlueField 和 NVIDIA Sentry 提供硬件强制保护
OpenShell 将权限置于智能体之外。对于需要额外保护的部署,这种分离还可以延伸到专用芯片中。
NVIDIA BlueField-4 DPU 提供智能体无法触及的硬件隔离信任域。在 OpenShell 参考架构中,BlueField-4 位于 Vera 上运行的智能体与其访问的模型之间的 I/O 路径中。NVIDIA Sentry 是构建在 NVIDIA DOCA 之上的安全软件框架,在此独立域中运行,持续监控智能体行为并执行运行时策略。
NVIDIA Sentry 观察请求和响应、网络和文件活动,验证身份和委托权限,并分析选定的主机内存,以检测偏离授权行为的情况,而无需依赖智能体自我报告。
当检测到威胁或策略违规时,BlueField-4 在芯片中执行策略,使 NVIDIA Sentry 能够在毫秒内隔离智能体。二者共同在 OpenShell 的软件边界之外增加可选的硬件保障。在此技术深度解析中了解更多关于 NVIDIA Sentry 的信息。
将安全智能体运行时扩展到规模化
在生产环境中运行智能体需要能够保持数千个工作流持续运转、同时治理其每一项操作的基础设施。Vera 提供维持这些工作流所需的计算、内存带宽和 I/O。OpenShell 提供运行时边界,决定哪些操作可以执行以及智能体可以访问哪些资源。
Vera 和 OpenShell 共同使安全智能体执行成为规模化的基础。智能体可以运行更长时间、使用工具,并在其控制之外执行的策略范围内处理企业数据。对于需要额外保护的部署,BlueField-4 上的 NVIDIA Sentry 增加了独立监控和芯片内强制执行。
NVIDIA Vera Rubin 平台(LLM 运行之处)与 OpenShell 以及 BlueField-4 上的 NVIDIA Sentry 共同构成 OpenShell 参考架构的支柱。它们组成安全 AI 智能体的完整技术栈:一个完整的、以硬件为根基的基础,使组织既能获得让智能体高效工作的性能,又能获得将其工作保持在授权边界内的控制能力。
开始使用
要在您的组织中实施安全的智能体治理,请从 NVIDIA OpenShell 开始,遵循文档,并探索 NVIDIA Vera CPU 如何加速智能体工作负载。