摘要
我们很高兴推出 Provisioned Throughput(预置吞吐量):为前沿开放模型预留的推理容量,按 token 计价,并提供 99% 的可用性 SLA。
开放权重模型已成为任何希望拥抱充裕 AI 未来的公司的必备要素。但过去,公司使用开放权重模型时不得不在两者之间取舍:要么选择便捷但仅尽力而为的 serverless,要么选择强大但需要调优的专属推理。Provisioned Throughput 是一种新的推理形态,提供了另一种选择:以 token 价格获得预先优化好模型的简便性,同时享有带可用性 SLA 的容量保证所带来的可预期性。按标价计算,成本最多可比 Claude Opus 4.8 低 90%。
目前已支持 MiniMax M3 和 GLM-5.2,容量覆盖北美、EMEA 及更多地区,最短租期为一个月。
推理支出已成为董事会会过问的一项开支。
在不远的将来,每位知识工作者都会有多个智能体替自己工作,但如果没有天文数字般的推理预算,企业很难做到这一点。要想成功,企业需要使用覆盖帕累托前沿的一系列模型,让任务难度与模型质量(及成本)相匹配。开放权重模型在这条前沿上占据的比例越来越大。
随着企业转向多模型、多框架(harness)的架构,开放模型正在驱动越来越多的日常智能体,涉及编码、财务、营销和工作流自动化等场景。
已经完成切换的公司反馈,使用开放模型的推理成本比专有方案低 6 至 20 倍。我们自己的数据也印证了这一转变:九个月内,经由 Together AI API 的 token 量已从每月 300 亿增长到超过 400 万亿。其中相当大一部分流量,是过去运行在闭源 API 上的工作负载。
一直缺失的是:值得信赖的 token 容量
充裕的 AI 需要的不只是帕累托前沿上的开放模型,还需要安心:有承诺的容量、可预测(且可影响)的价格,以及客户可以依赖的 SLA。到目前为止,开放模型市场只提供两种选择,都不符合这样的需求。Serverless 推理基本是尽力而为:用于开发没问题,但对生产工作负载来说不可预测。专属推理(即独占 GPU)能提供保证和对服务环境的完全控制,但许多团队不想管理一个完全可配置的推理平台的复杂性。他们想要的是简单 API 背后可靠的模型提供商,而不是 GPU 小时数的计算、容量规划和需要自行配置的服务栈。
团队真正想要的其实很简单:就是他们与闭源模型提供商已有的那种按 token 计的容量协议,只不过对象换成前沿开放模型。这就是我们打造的产品。
推出 Provisioned Throughput
Together AI 的 serverless 推理是“用多少付多少”,SLA 为尽力而为;而 Provisioned Throughput 则是“为保证可用的容量付费”,并带有可用性 SLA。
你购买的是预置吞吐量单元(Provisioned Throughput Units,PTU)。每个 PTU 是一份固定的容量切片:为你所运行的模型提供有保证的每分钟 token 速率,为你独占保留,价格为每 PTU 每分钟 $0.05。Provisioned Throughput 会考虑你流量的变化;输入、缓存输入和输出 token 消耗 PTU 的方式各不相同,让你可以针对自己的流量模式优化支出。无需计算 GPU 小时数,也无需管理基础设施。Provisioned Throughput、专属推理和 serverless 推理的推理 API 完全一致。
Provisioned Throughput 目前已支持 MiniMax M3 和 GLM-5.2,更多模型即将推出。我们在北美、EMEA 及更多地区都有可用容量,最短租期为一个月,承诺量越高折扣越大。
“我们的模型是为要求严苛的生产工作负载而打造的,Together AI 的 Provisioned Throughput 让团队能够以这些工作负载所需的可靠性来运行它们。随着团队把流量从闭源 API 迁走,Together AI 的基础设施让他们能够大规模采用 M3,并获得足以支撑业务的承诺。这正是我们希望为自己的模型提供的那种接入方式。”
—— Linda Sheng,MiniMax 全球业务总裁
成本测算
一个 PTU 涵盖三类流量:输入 token、缓存输入 token 和输出 token,它们消耗容量的速率各不相同。在 MiniMax M3 上,一个 PTU 可提供每分钟 138,840 个输入 token、每分钟 694,200 个缓存输入 token、每分钟 23,140 个输出 token,或三者的任意组合。

真实的工作负载形态各不相同。输出占比高的流量消耗容量的速度比缓存效率高的流量更快,但流量形态绝不会改变 SLA,只会改变你消耗容量的快慢。
在满负荷利用时,MiniMax M3 上一个 PTU 折合每百万输入 token 约 $0.36、每百万输出 token 约 \$2.16,而 Claude Opus 4.8 的标价为 \$5 和 \$25。以下是三种具有代表性的生产场景:
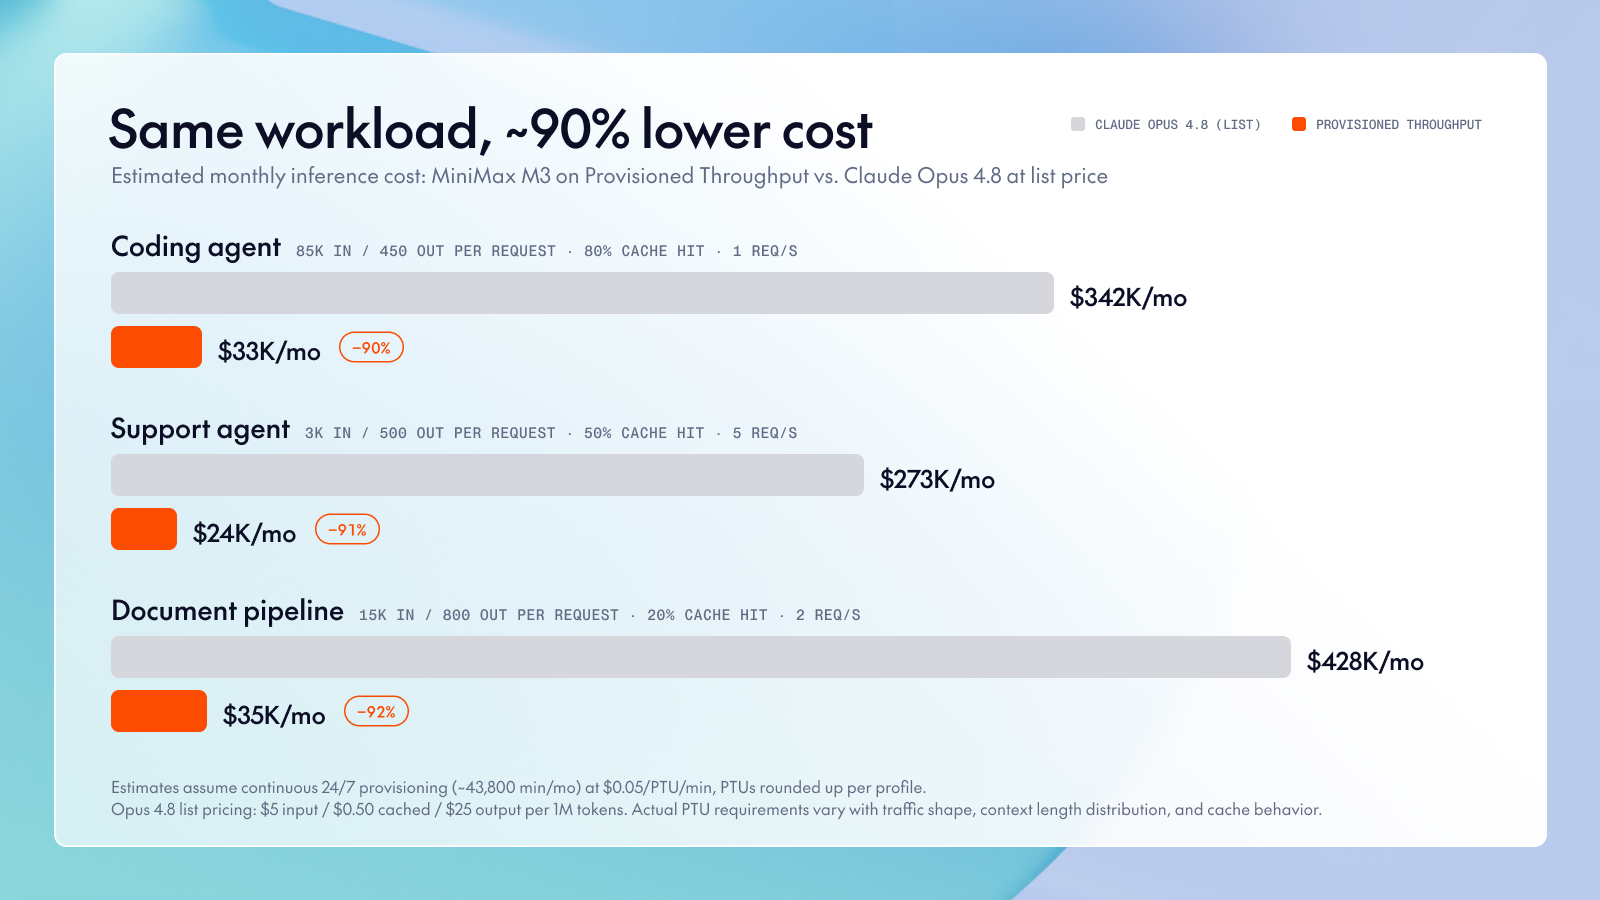
以上均为估算。实际的 PTU 用量会随你的流量形态而变化。在定价计算器中测算你自己的数字
适用场景
Serverless 是在开放模型上起步构建的最快方式。Provisioned Throughput 适用于需要保证的、基于标准开放模型的生产工作负载。如果你需要微调过的或自定义的模型,并希望对服务环境有深度控制,那么专属推理(Dedicated Inference)更合适。
如果你在专有 API 上运行的生产流量可以由前沿开放模型承接,那么迁移路径现在已经完整:前沿质量的模型、可据以规划的按 token 计价,以及客户可以依赖的可靠性保证,成本最多可降低 90%。
→ 联系我们的团队
→ 阅读文档