GPU 应用正在使用日益强大的加速器处理不断增长的数据集。根据 2025 年斯坦福 AI 指数,知名 AI 模型的计算量大约每五个月翻一番,而用于训练 LLM 的数据集规模大约每八个月翻一番。随着计算与数据规模同步增长,高效地从存储移动数据已成为为加速器持续供数的必要条件。
NVIDIA Magnum IO GPUDirect Storage(GDS) 通过在受支持的存储与 GPU 内存之间建立直接数据路径来应对这一挑战。这避免了经由 CPU 内存进行不必要的暂存,并降低了系统中的整体 CPU 利用率。GDS 受到不断壮大的生态系统的支持,其中包括许多主要存储厂商。
在应用层,Python 在现代 AI 开发中扮演着核心角色。截至 2025 年 8 月,GitHub 上近一半的新 AI 项目主要使用 Python 构建,而 GDS 的主要应用接口是 cuFile C API。
NVIDIA KvikIO 是一个用于高性能文件 I/O 的 Python 和 C++ 库,它弥合了这一差距。它提供高层、符合语言习惯的 Python 和 C++ 接口,并额外提供对 I/O 请求执行方式的控制。
本文中的教程演示如何使用 NVIDIA KvikIO Python API 配置存储 I/O、将数据读入 GPU 内存,并确认 GDS 内的加速路径已被激活。它还展示了如何检查影响每个操作所走路径的 KvikIO 和 cuFile 设置。
NVIDIA KvikIO 如何利用 GDS?
GDS 是更广泛的技术,可在受支持的存储与 GPU 内存之间实现加速的数据移动。对于基于文件系统的存储,cuFile 提供 C 库和 API,应用程序和框架通过它们访问 GDS。KvikIO 位于 cuFile 之上,提供更高层的 Python 和 C++ 接口,并自带对 I/O 请求执行方式的控制。图 1 展示了这些层次及其两个独立的路径选择点。为清晰起见,初始化失败、不受支持的配置和错误处理路径均已省略。
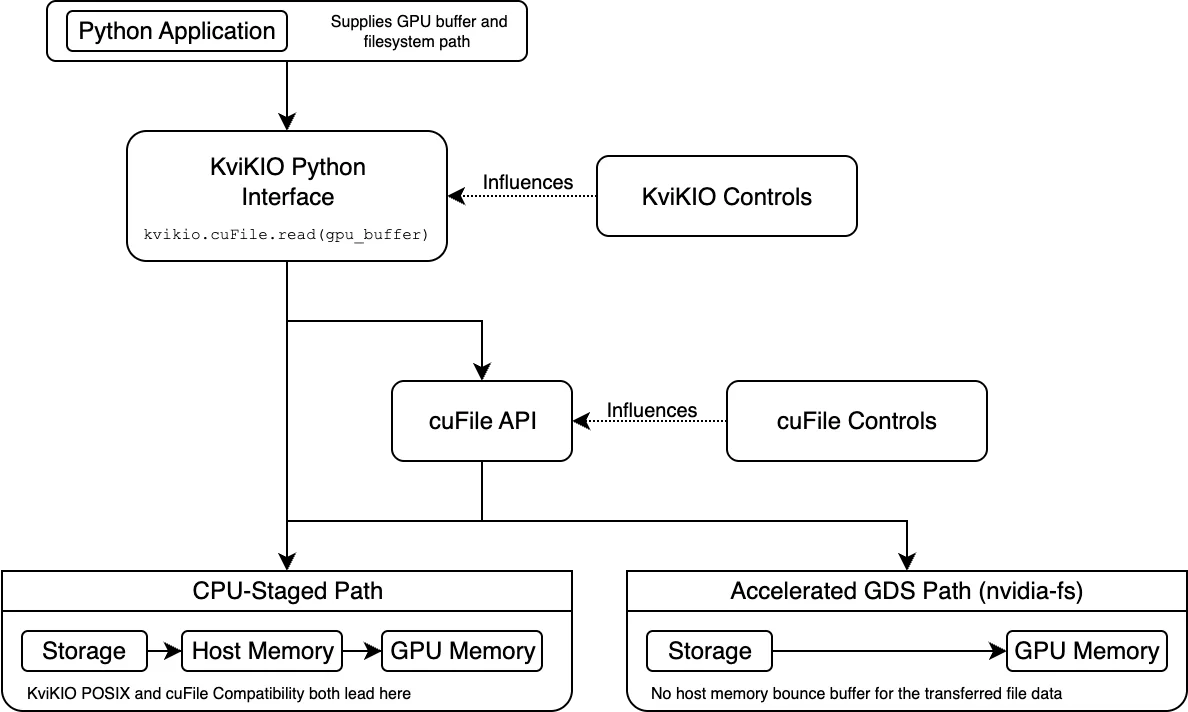
应用程序提供文件系统路径和 GPU 缓冲区,KvikIO 决定是通过 cuFile 发送请求,还是使用其 POSIX 兼容路径(该路径经由主机内存暂存数据)。当选择 cuFile 时,KvikIO 注册文件并使用目标 GPU 缓冲区发起 I/O。
随后 cuFile 根据系统支持、文件系统及其配置确定实际传输路径。它可能使用加速的 GDS 路径,也可能使用其 CPU 暂存的兼容路径。因此,到达 cuFile API 只能确认 KvikIO 选择了 cuFile,但本身并不能确认加速的 GDS 路径已被激活。
以下各节将逐步介绍如何配置系统、执行 KvikIO 读取,并验证最终所走的路径。
先决条件
在开始本教程之前,你需要:
- 一台安装了 NVIDIA GPU 和 GPUDirect Storage 的 Linux 系统。
- 受 GDS 支持的存储和文件系统配置。
- 在存储端点创建、读取和写入文件的权限,以及对
gdscheck和gds_stats等 GDS 工具的访问权限。
有关完整的安装和平台要求,请参阅 NVIDIA GPUDirect Storage 文档。
教程系统
本教程使用以下配置进行测试:
- 一台配备 NVIDIA H100 GPU、CUDA 13.3 和 cuFile 1.18 的
x86_64系统。 - 一个使用
ext4格式化的本地 NVMe 设备。 - 所选 GPU 与 NVMe 设备之间为 PIX 连接,即路径最多经过一个 PCIe 桥。
- 禁用 IOMMU 和 ACS,以保留 PCIe 点对点传输。
- 加载
nvidia-fs内核模块以提供加速路径。
你可以使用以下命令检查 GPU 到存储的拓扑:
$ nvidia-smi topo -nvme
步骤 1:设置 NVIDIA KvikIO
首先,创建一个 Python 环境并安装 CUDA 13 版本的 KvikIO。CuPy 将作为依赖项安装。
$ python3 -m venv kvikio-env
$ source kvikio-env/bin/activate
$ python -m pip install kvikio-cu13
你可以使用以下命令验证安装:
$ python -m pip show kvikio-cu13 cupy-cuda13x
步骤 2:检查配置
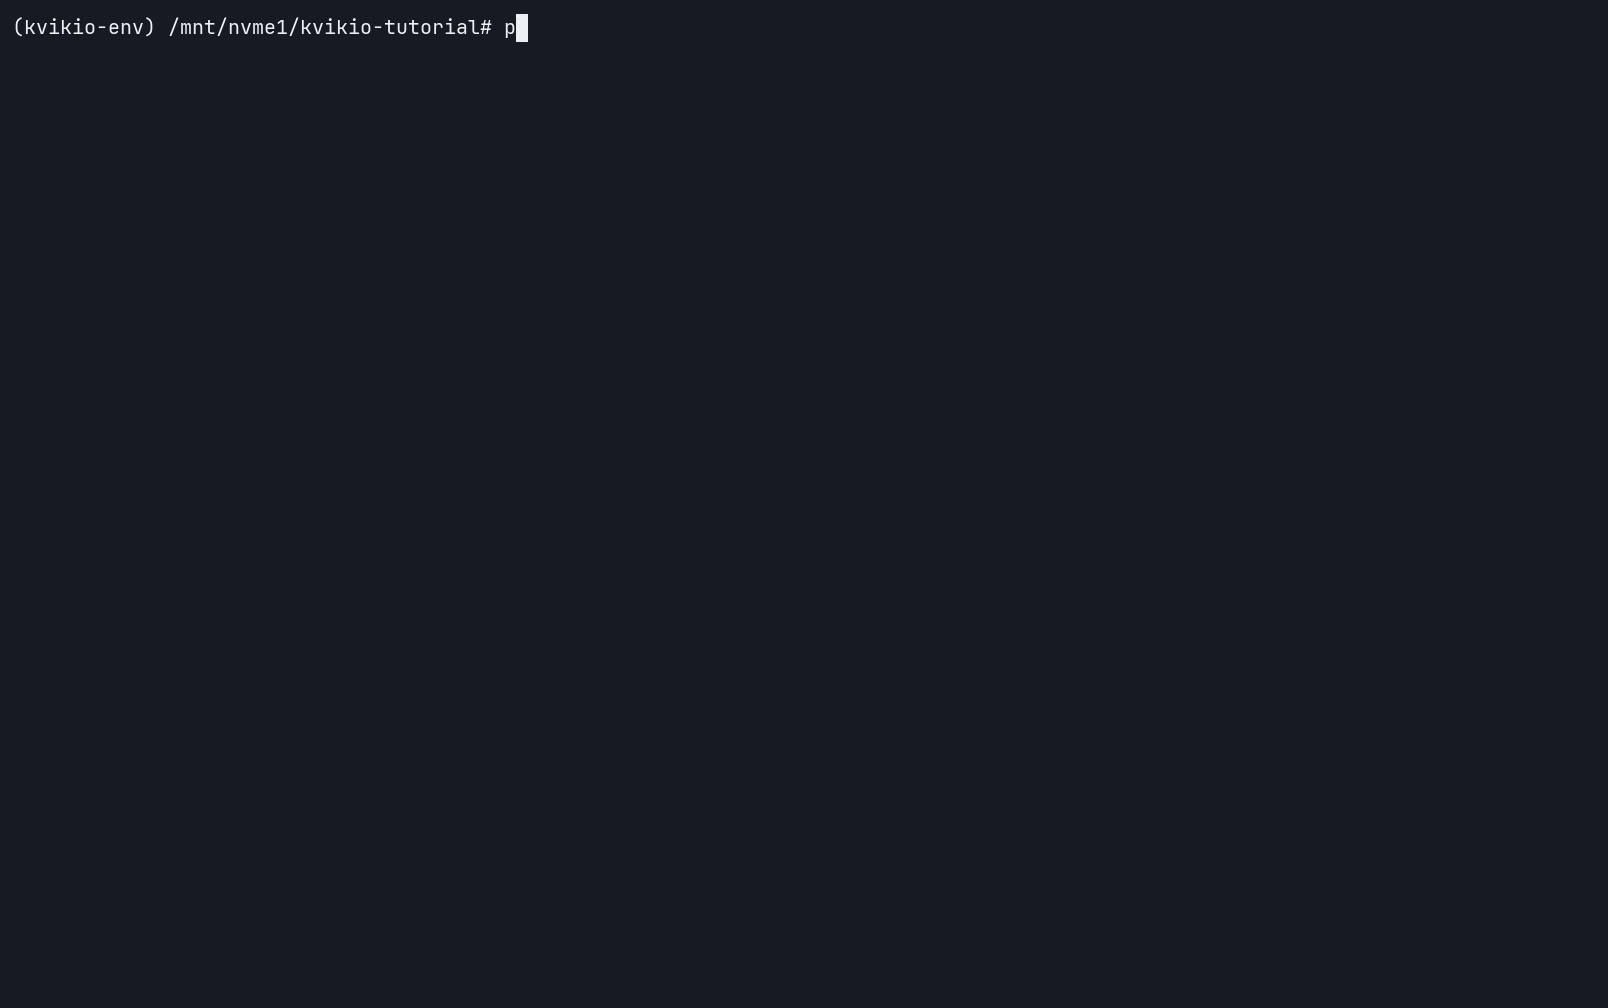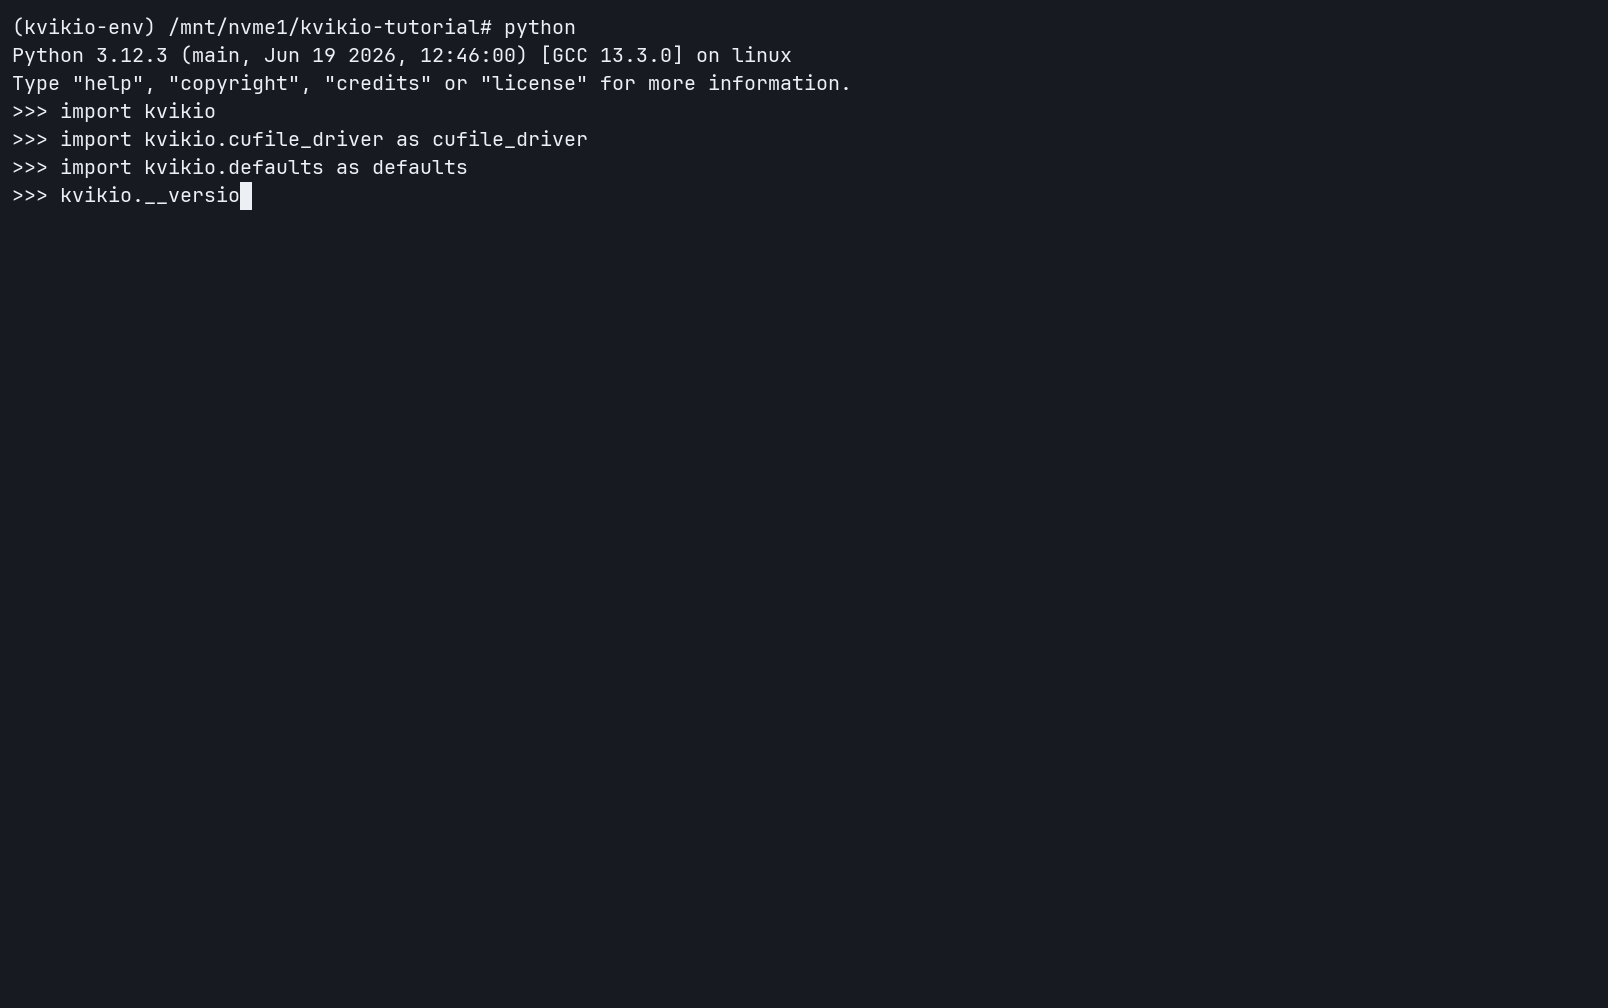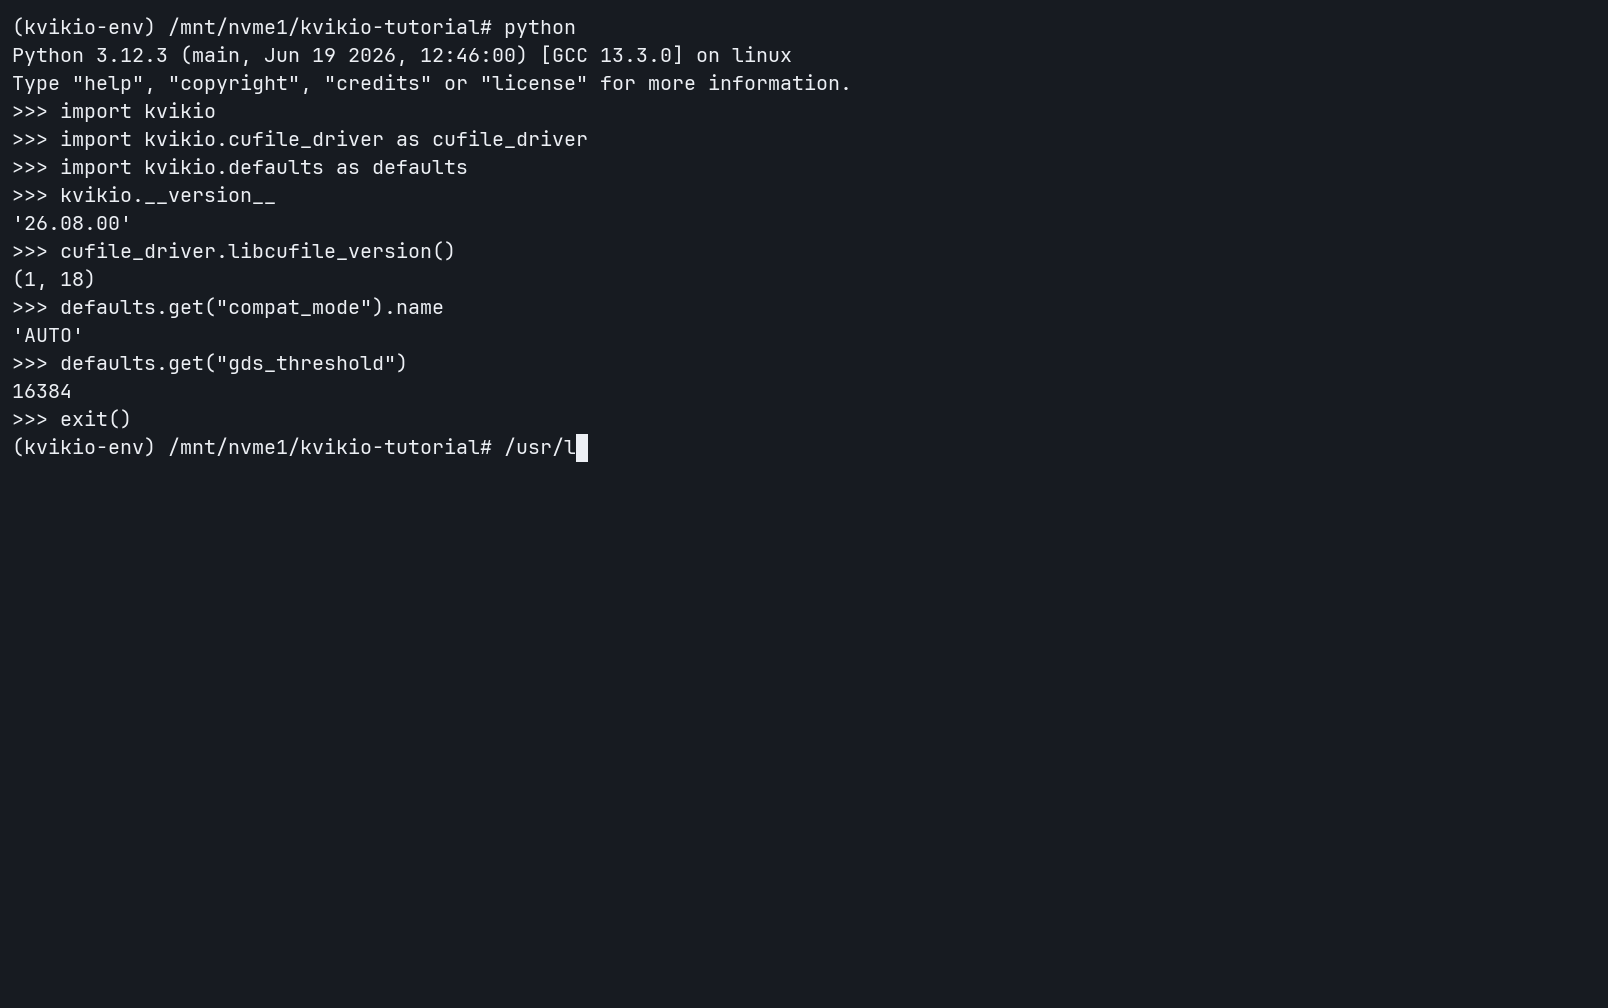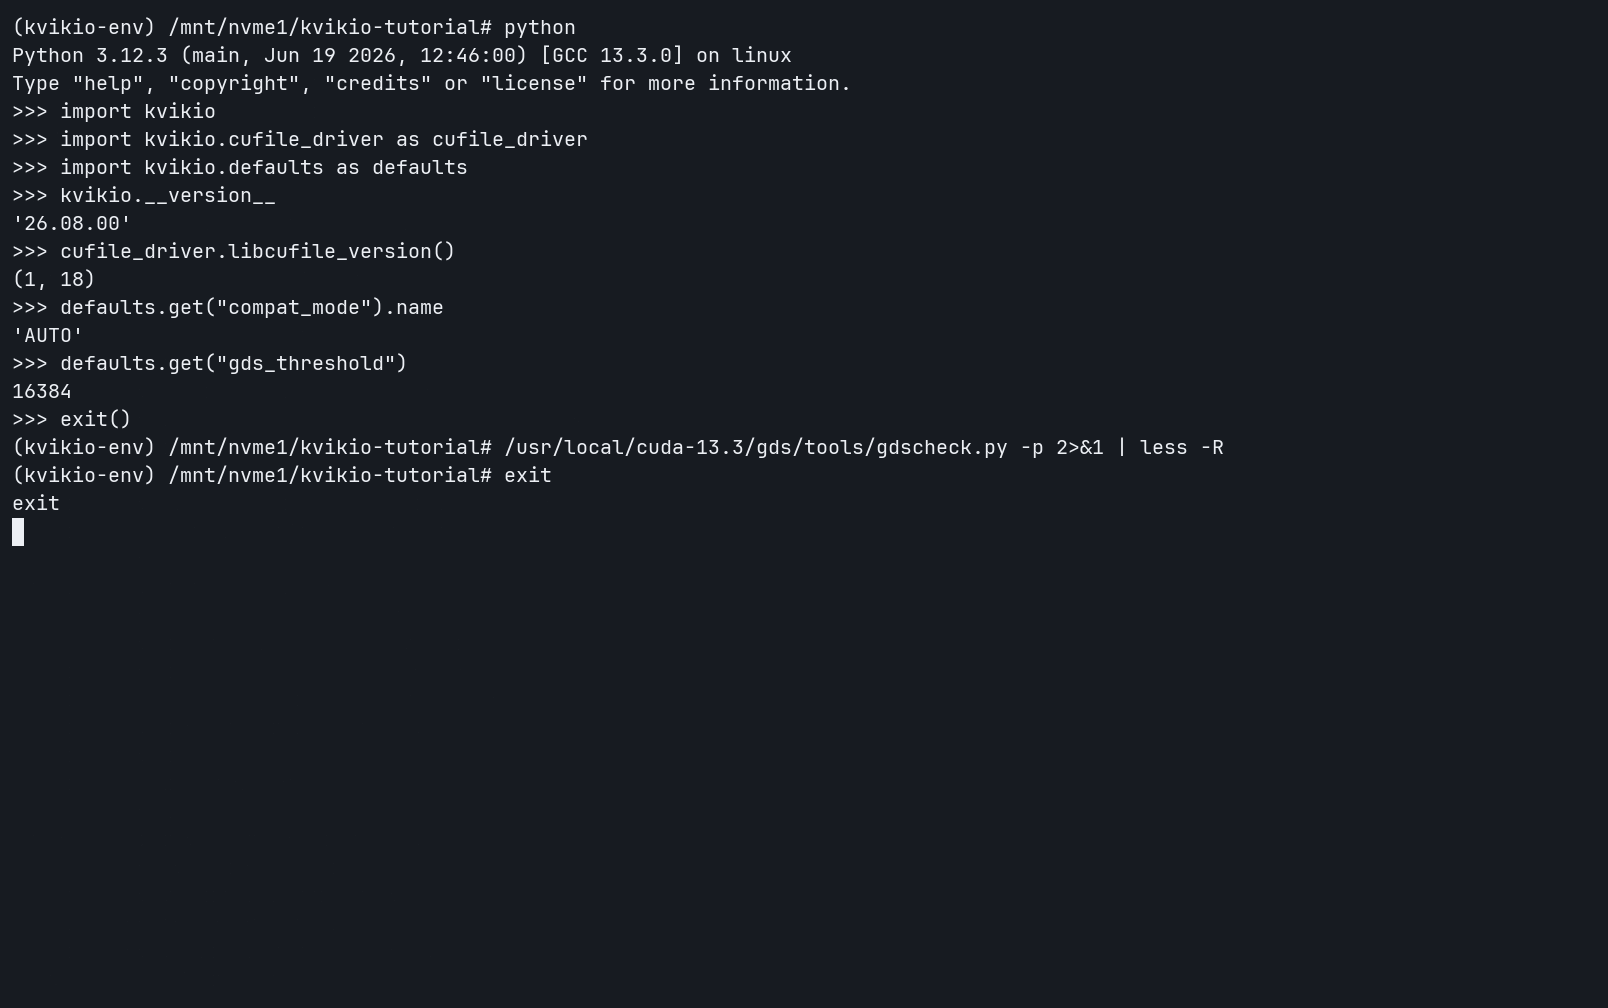
在执行任何 I/O 之前,检查当前生效的 KvikIO 设置,并确认系统识别到 GDS 组件。在 KvikIO 默认值 API 中,兼容模式设置名为 compat_mode,其 name 属性报告当前生效的模式为 AUTO、ON 或 OFF。以下命令报告已加载的 KvikIO 和 cuFile 版本、当前生效的兼容模式,以及 KvikIO 发送给 cuFile 的最小请求大小:
import kvikio
import kvikio.cufile_driver as cufile_driver
import kvikio.defaults as defaults

kvikio.__version__
cufile_driver.libcufile_version()
defaults.get("compat_mode").name
defaults.get("gds_threshold")
在教程系统上,KvikIO 报告的兼容模式为 AUTO,GDS 阈值为 16 KiB。AUTO 指示 KvikIO 尝试使用 cuFile,并在 cuFile 不可用时回退到其 POSIX 后端。小于该阈值的读取直接使用 KvikIO POSIX 路径。这些设置也可以通过 KVIKIO_COMPAT_MODE 和 KVIKIO_GDS_THRESHOLD 控制。完整列表请参阅 KvikIO 运行时设置。
接下来,检查 GDS 平台和 cuFile 配置:
$ /usr/local/cuda-13.3/gds/tools/gdscheck.py -p 2>&1 | less -R
输出列出了已安装的 GDS 组件、受支持的文件系统、检测到的 GPU 以及当前生效的 cuFile 配置。图 2 展示了如何检查本教程中使用的 KvikIO 和 GDS 配置。
KvikIO 设置也可以在 Python 中更改。例如,defaults.set 接受一个字典以同时更改多个设置,或接受一个名称和值以更改单个设置:
defaults.set({"task_size": 1024**3, "num_threads": 8})
defaults.set("compat_mode", kvikio.CompatMode.OFF)
步骤 3:将文件读入 GPU 内存
接下来,在运行 Python 示例之前先创建一次输入文件。以下命令使用直接 I/O 写入一个包含随机数据的 1 GiB 文件,并将其刷新到存储:
$ dd if=/dev/urandom \
    of=/mnt/nvme1/kvikio-tutorial/kvikio-example.bin \
    bs=1M count=1024 \
    oflag=direct conv=fsync \
    status=progress
以下程序在 GPU 内存中分配一个 1 GiB 的 CuPy 数组,并将其作为目标缓冲区提供给 KvikIO:
from pathlib import Path
import cupy as cp
import kvikio

file_path = Path(
    "/mnt/nvme1/kvikio-tutorial/kvikio-example.bin"
)

# Allocate a GPU buffer large enough to hold the file.
gpu_buffer = cp.empty(
    file_path.stat().st_size,
    dtype=cp.uint8,
)

# Read the file into the GPU buffer.
with kvikio.CuFile(file_path, "r") as file:
    bytes_read = file.read(gpu_buffer)

# Validate that 1 GiB was read.
assert bytes_read == gpu_buffer.nbytes
上下文管理器打开文件并完成读入 GPU 内存的操作。尽管返回值确认整个文件已被读取,但它并不标识底层的数据路径。
步骤 4:确定数据路径
验证任何基于 cuFile 的应用程序所用数据路径的一种方法是观察 cuFile 运行时的每进程统计信息。可以通过设置 CUFILE_STATS_LEVEL=3 来启用这些统计信息,然后在进程保持活动状态时用 gds_stats 进行检查。
对于这个 KvikIO 示例,环境变量将该设置的作用范围限定为单次运行,不过它也可以在 cufile.json 中配置。
$ CUFILE_STATS_LEVEL=3 python3 -i read_with_kvikio.py
以交互方式运行 Python 可在读取后保持进程存活,从而允许 gds_stats 检查其累积的计数器。
图 3 演示了这一工作流程。在每 GPU 输出中,nvfs 统计代表经由 nvidia-fs 内核模块所走路径的操作数,而 posix 统计由 cuFile 兼容路径处理的操作数。
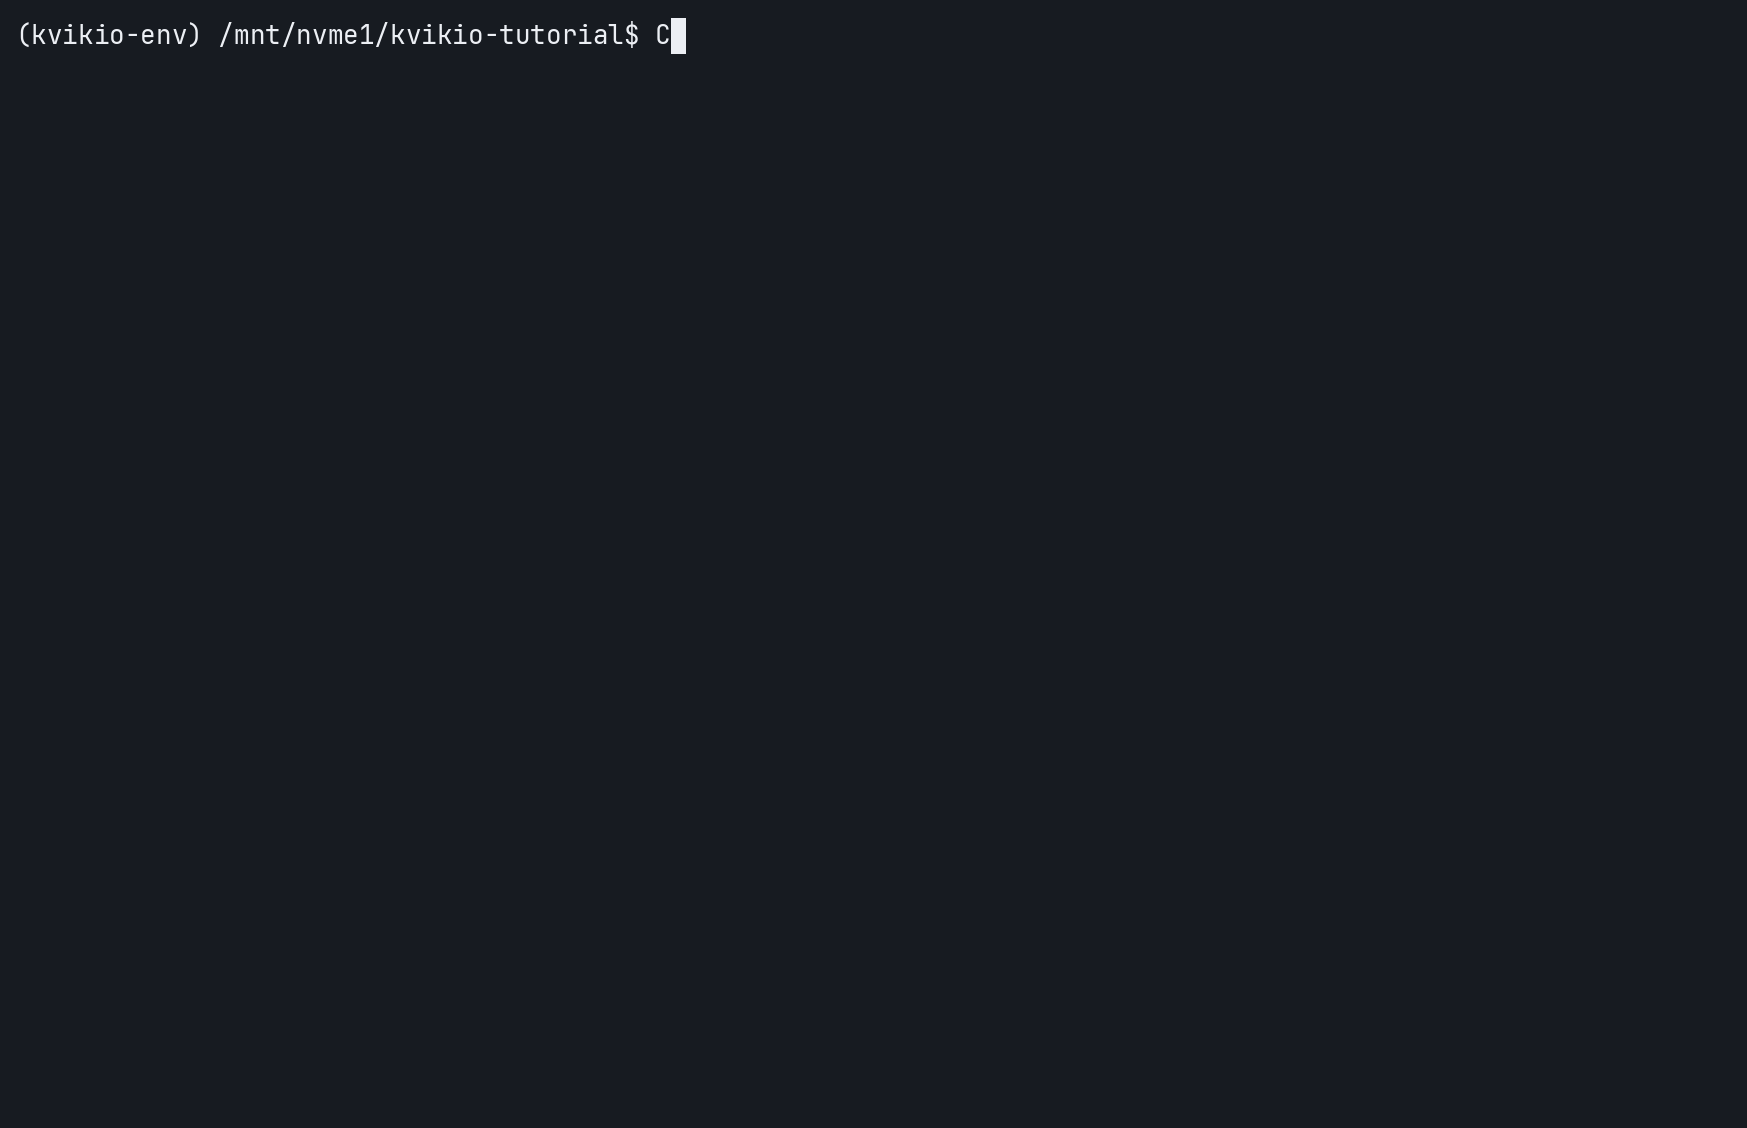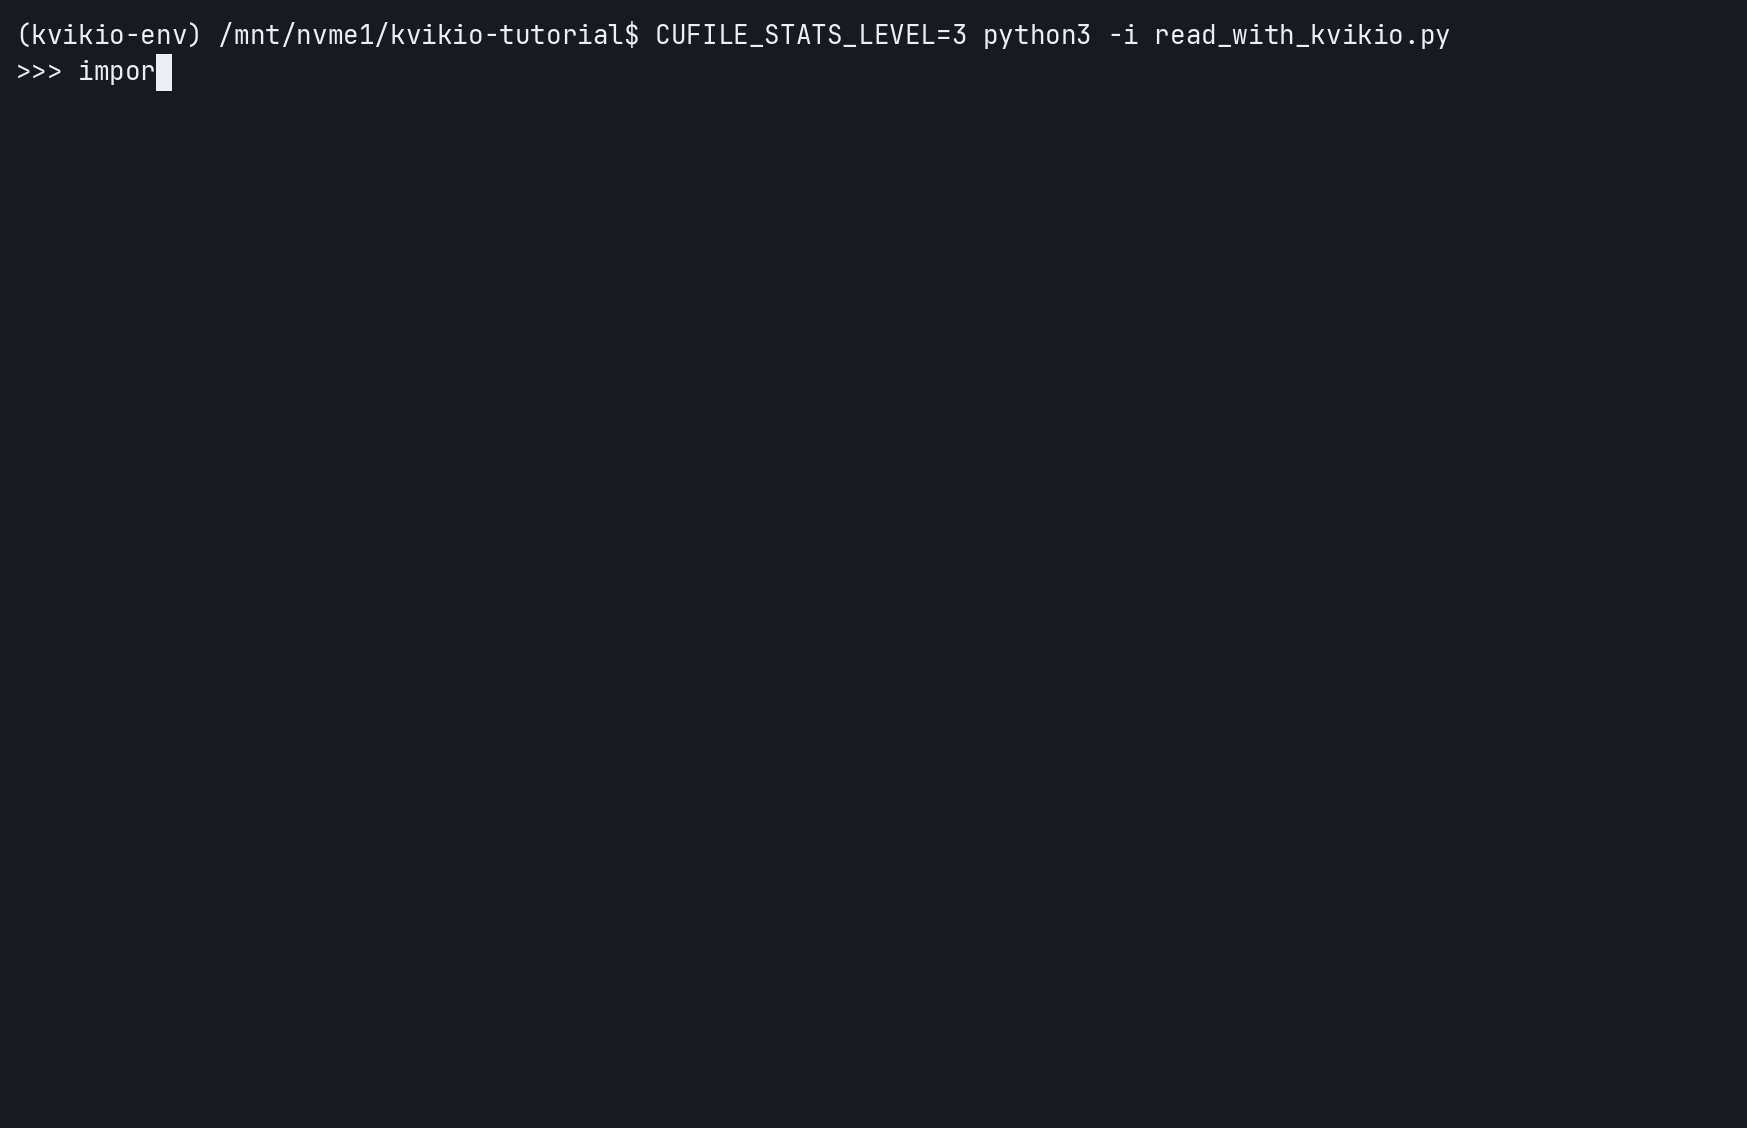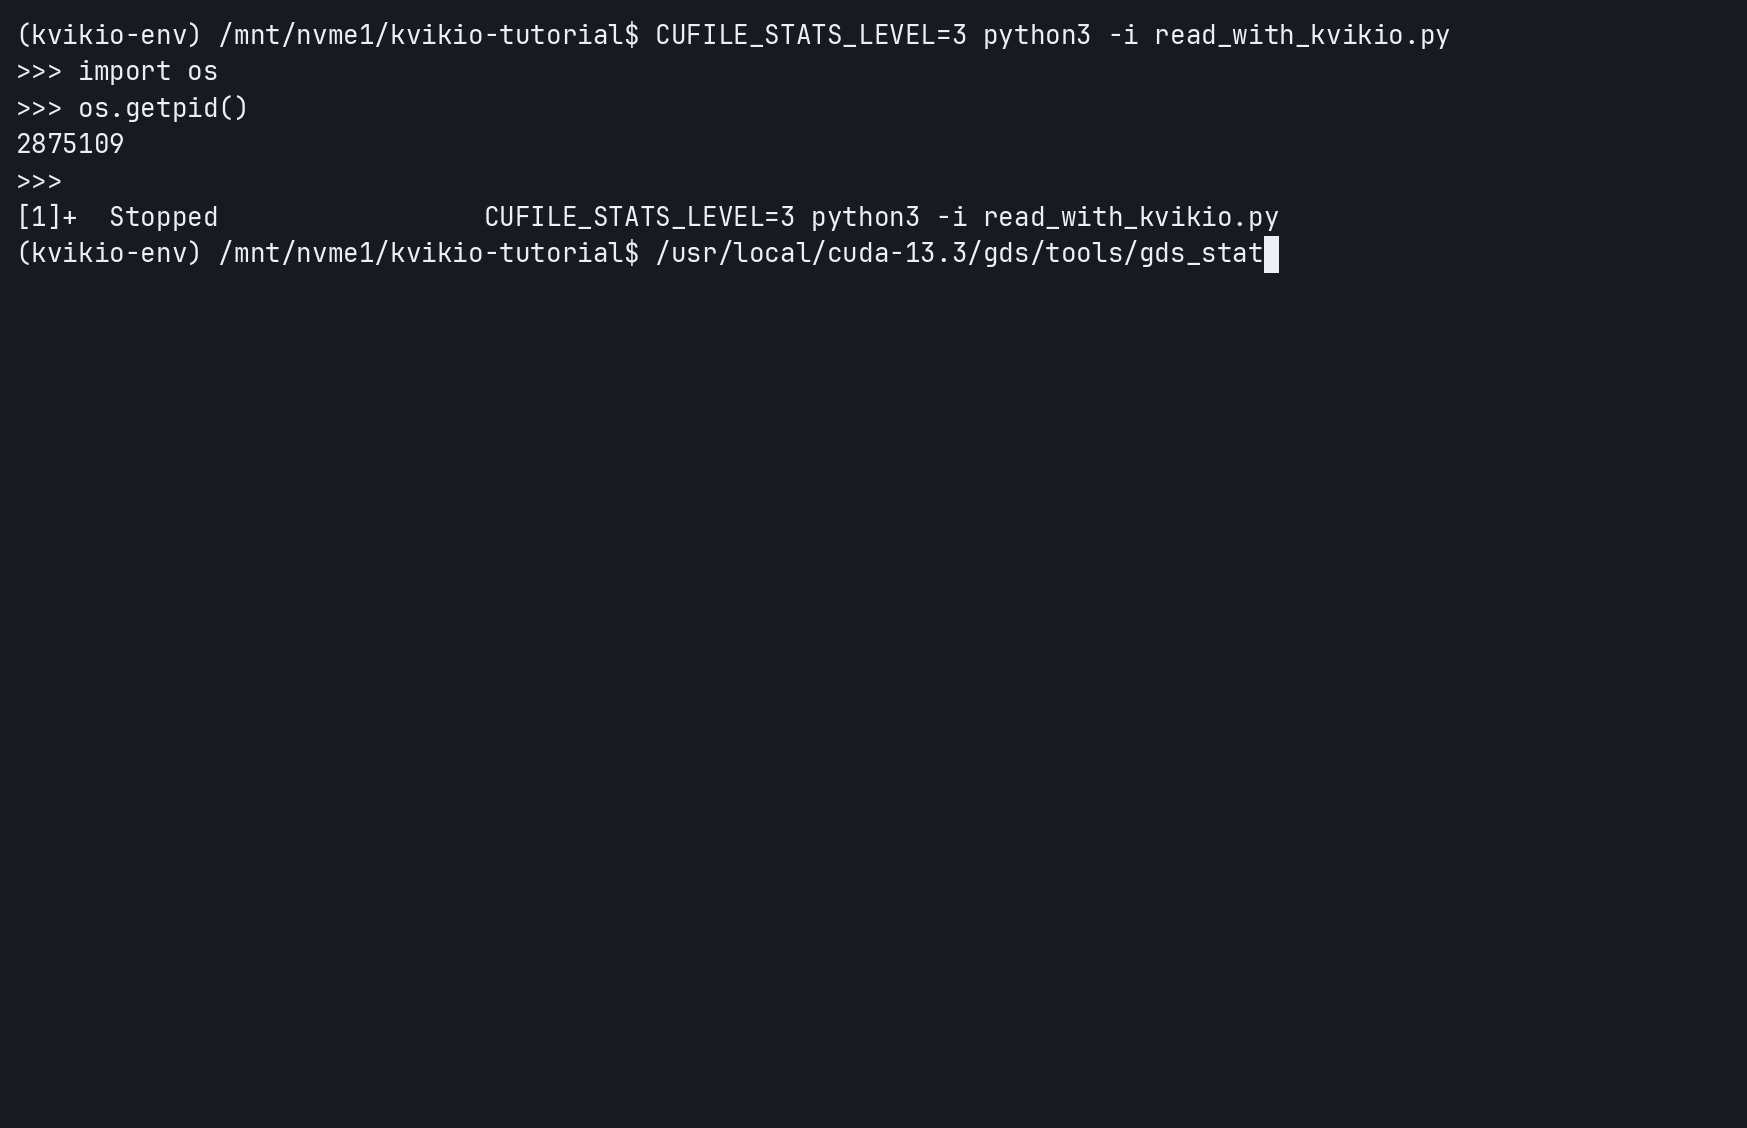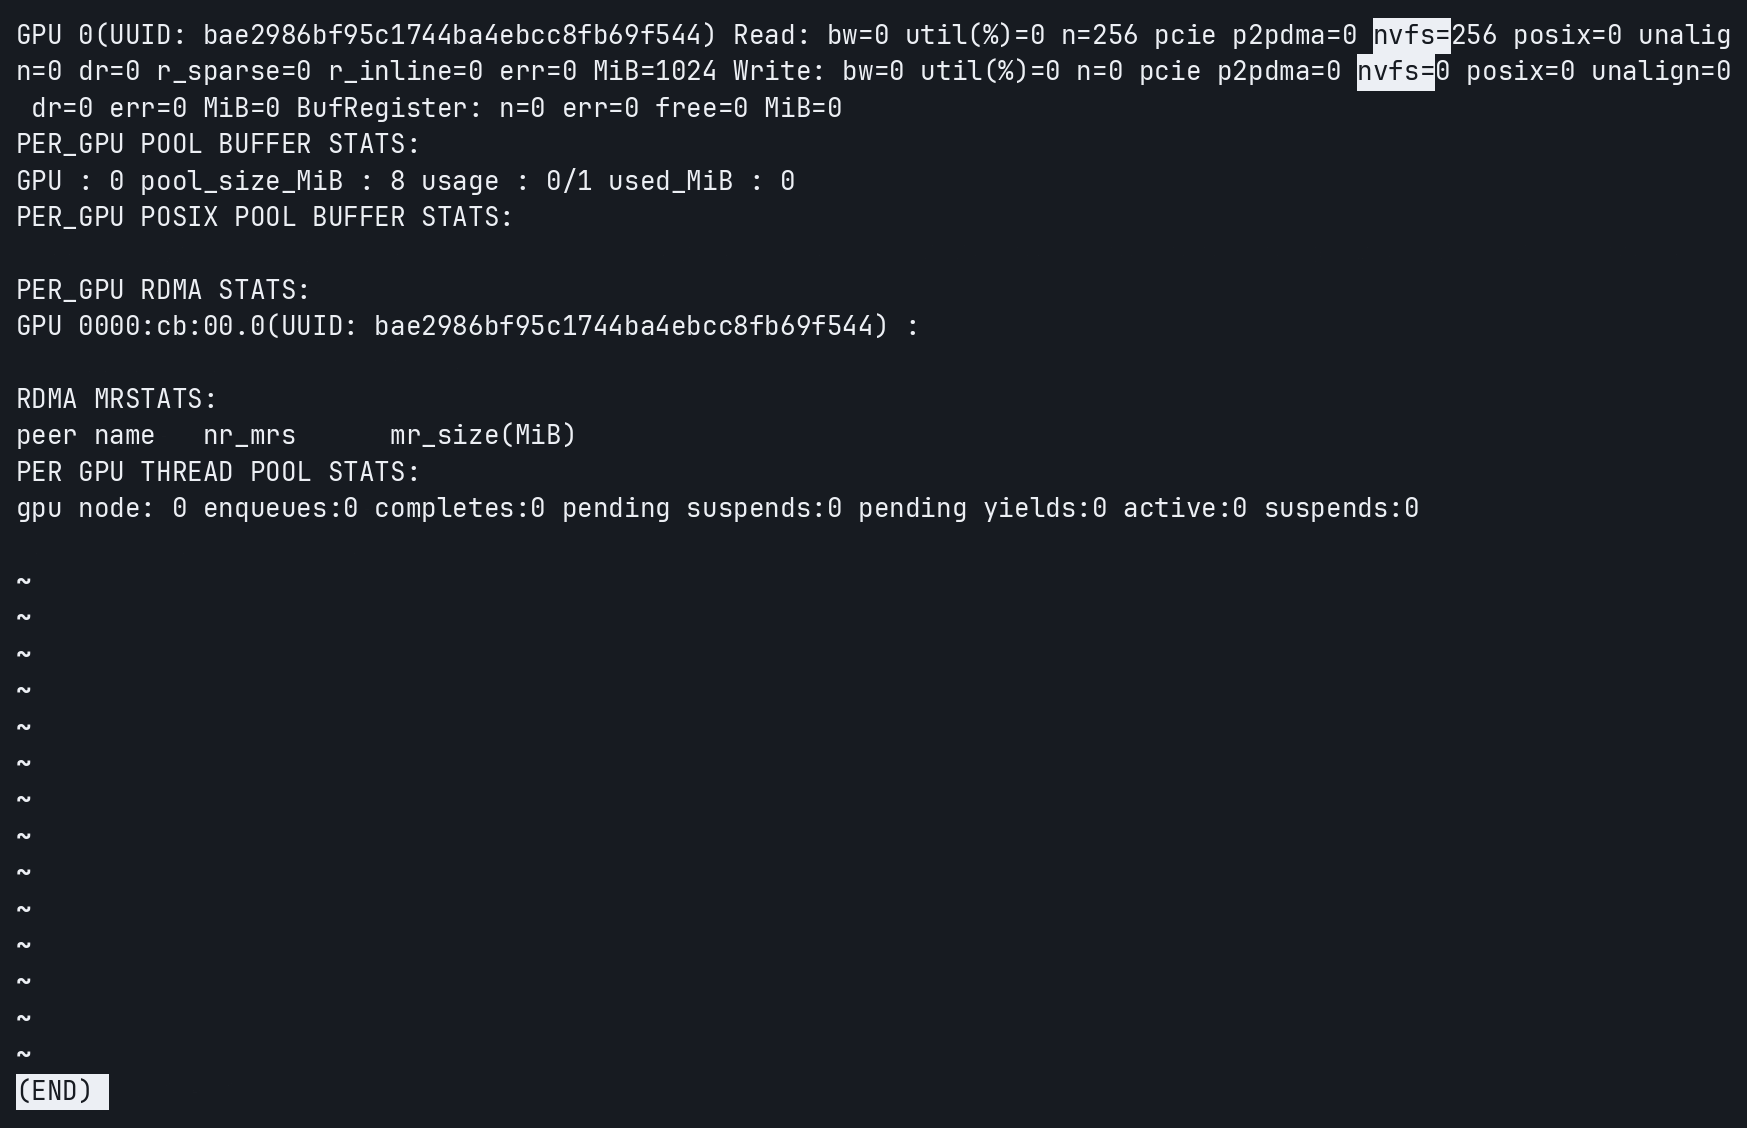
KvikIO 默认的 4 MiB 任务大小将 1 GiB 请求划分为 256 次读取操作。每 GPU 统计信息报告 n=256、nvfs=256 和 posix=0,表明全部 256 次操作都使用了 nvidia-fs 路径。
步骤 5:比较可用路径
可以用不同的设置重复相同的读取,以演示这两个控制层。首先,要求 KvikIO 使用 cuFile:
$ CUFILE_STATS_LEVEL=3 \
    KVIKIO_COMPAT_MODE=off \
    python3 -i read_with_kvikio.py
在教程系统上,gds_stats 报告 nvfs 操作,确认 cuFile 选择了加速路径。接下来,强制 cuFile 使用其兼容路径:
$ CUFILE_STATS_LEVEL=3 \
    KVIKIO_COMPAT_MODE=off \
    CUFILE_FORCE_COMPAT_MODE=true \
    python3 -i read_with_kvikio.py
KvikIO 仍然调用 cuFile,但操作现在出现在 posix 下而不是 nvfs 下。最后,KvikIO 兼容模式完全绕过 cuFile:
$ KVIKIO_COMPAT_MODE=on \
    python3 read_with_kvikio.py
在这种情况下,KvikIO 通过其 CPU 暂存的 POSIX 后端执行读取,因此 cuFile 不会记录该操作。下一节将考察控制请求执行的 cuFile 设置。
步骤 6:KvikIO 读取的 cuFile 配置
在 KvikIO 选择其 cuFile 路径后,cuFile 会应用另一组控制来决定请求如何执行。这些控制定义在 cufile.json 中,并独立于 KvikIO 运行时设置运行。
请求分解与并行执行
KvikIO 和 cuFile 都可以将大型操作划分为更小的片段。KvikIO 首先应用 KVIKIO_TASK_SIZE,由 KVIKIO_NTHREADS 控制这些任务如何调度。cuFile 路径上的每个任务都会成为单独的 cuFile 请求。一旦 cuFile 收到其中一个请求,其执行设置就决定了该请求是否可以再次划分并使用 cuFile 内部线程池处理。以下 cuFile 设置控制此行为:
表 1. 影响 KvikIO 请求处理方式的 cuFile 执行设置
| 设置 | 用途 |
|---|---|
execution.parallel_io |
启用 cuFile 内部并行处理。 |
execution.max_io_threads |
限制每个 GPU 队列可用的 cuFile 工作线程数。 |
execution.min_io_threshold_size_kb |
为内部调度的片段设置目标最小大小;最后的剩余部分可能更小。 |
execution.max_request_parallelism |
限制 cuFile 为单个请求准备的并行度。 |
execution.max_io_queue_depth |
限制内部队列中待处理工作项的数量。 |
一次 1 GiB 读取的分步过程
此处使用的配置有四个 cuFile 工作线程,max_request_parallelism 设为 4,min_io_threshold_size_kb 设为 8192(8 MiB)。在 KvikIO 默认 4 MiB 任务大小下,一次 1 GiB 读取会变成 256 个 cuFile 请求。每个 4 MiB 请求由 cuFile 作为单个片段处理。这就是在先前统计信息中产生 nvfs=256 的那次运行。
如果将 KVIKIO_TASK_SIZE 设为 1 GiB,KvikIO 会改为向 cuFile 发送一个大型读取请求。CuPy 目标缓冲区未显式注册到 cuFile,因此 cuFile 使用其未注册缓冲区调度路径。它将请求限制为 min(4 个工作线程,4 个最大请求并行度)= 4 个片段。
将 1 GiB 分成四份,每份为 256 MiB,已经大于 min_io_threshold_size_kb 的 8 MiB。由于队列中有空间,cuFile 将三个片段分配给工作线程,在调用线程上处理第四个片段,并等待它们完成。
这些 256 MiB 片段是调度工作单元,而不是单独的存储传输。由于目标缓冲区未注册用于存储 DMA,cuFile 会读入已注册的 GPU 反弹缓冲区,再将数据复制到目标缓冲区。自 GDS 1.17 起,这些反弹缓冲区可以配置为 slab。此配置中的 nvidia-fs 路径使用不超过 16 MiB 的 slab,因此每个 256 MiB 片段都通过更小的传输来处理。8 MiB 调度目标并不决定它们的传输大小。
8 MiB 拆分目标何时起作用
在此配置中,execution.min_io_threshold_size_kb 设为 8192(8 MiB)。该目标不会改变 1 GiB 的拆分,但会影响 16 MiB 的 cuFile 请求。四个等分片段将各为 4 MiB,因此 cuFile 改为调度两个 8 MiB 片段。KvikIO 必须使用至少 16 MiB 的任务大小,cuFile 才能完整收到该请求。
NVIDIA CUDA-X for data science 中的 KvikIO
KvikIO 是 NVIDIA CUDA-X 数据科学库(原 RAPIDS)的一部分。其开发与最初为 NVIDIA cuDF GPU DataFrame 库构建的 GDS 集成密切相关,在该库中,并行 cuFile 读取加速了 Parquet 和 ORC 数据摄取。这一设计后来被纳入 KvikIO,建立在 cuDF 最初的 GDS 数据摄取工作 之上。
此后,KvikIO 已与 GDS 一起用于 cuCIM 数字病理工作流程 和 用于科学图像分析的 cuPhoton xDataReader,而相关的 GPU 加速 Presto 工作 则展示了 GDS 在数据分析工作负载中的优势。这些示例共同展示了 KvikIO 作为面向应用的 I/O 层,在 GDS 提供的存储加速之上所发挥的更广泛作用。
开始使用 NVIDIA KvikIO
本教程演示了如何将数据读入 GPU 内存,并使用三级 GDS cuFile 统计信息来区分加速的 nvidia-fs 路径与 CPU 暂存的兼容路径。这些路径决策对于诸如 cuDF 等使用 KvikIO 执行许多 I/O 操作的流行库 而言至关重要。
关键要点是 KvikIO 和 cuFile 会做出各自独立的决策。KvikIO 选择是否调用 cuFile,而 cuFile 决定最终的传输路径和执行策略。理解这些层次使应用程序能够了解 I/O 所走的路径,并调整对其工作负载至关重要的设置。
准备好开始了吗?在启用了 GDS 的系统上运行本文中介绍的 KvikIO Python 示例。如需更多示例,请浏览 MagnumIO GDS 示例目录 中的 C++ 和 Python KvikIO 代码。使用 gds_stats 检查读取是否出现在 nvfs 或 posix 下,然后将相同的验证方法应用于您自己的 KvikIO 工作负载。