返回 文章 学习 CMS 文章

OpenAI 与微软内部文件承认:AI 抓取正在为网络开启“末日循环”

解封法庭文件揭示:OpenAI 和微软内部深知 AI 抓取正在制造一个损害网络与自身产品的“末日循环”。

OpenAI微软AI 版权末日循环
成长分 / 100 68 综合收获、行动、留存与影响

OpenAI 与微软内部文件承认:AI 抓取正在为网络开启“末日循环”
为什么值得读首次通过解封法庭文件看到 OpenAI 和微软内部对 AI 抓取行为的自我认知与警告。

理解 AI 摘要如何冲击出版商推荐流量,以及“Google Zero”为何成为现实。

关键洞察
  1. 微软内部文件承认 AI 内容战略已开启“末日循环”,终端产品威胁其关键供应商的经济基础。
  2. 微软高管布伦特·赫克特将数据采集称为“人类历史上最大的劳动盗窃”,并称合理使用辩护是对该理念的嘲弄。
  3. 萨提亚·纳德拉承认聊天机器人已基本取代搜索,消除了直接前往信息源头获取信息的需求。
转成行动

深入阅读

正文与原文对照

原文保真覆盖:全文原文字符:6786

最近在纽约时报诉 OpenAI 和微软一案中被解封的法庭文件相当不利于这两家公司。公司自己的文档就警告说,它们正在开启一个会损害网络的“末日循环”(doom loop),把为训练模型而抓取数据的行为称为“人类历史上最大规模的劳动盗窃”,并称这让“合理使用这一理念彻底沦为笑话”。

文件中许多最抢眼的引语都出自微软应用科学总监 Brent Hecht。不过,微软已试图与 Hecht 的说法划清界限。微软发言人 Alex Haurek 告诉 The Verge:“这些评论反映的是一名员工的个人观点,不是法律分析,也不代表公司的立场。”

在另一份法庭文件中,微软 AI 数据战略与运营总经理 Jordan Usdan 将 Hecht 的角色描述为对立面。他说,Hecht“对 AI 数据生态应如何运作持有不同的、学术性的、面向未来的看法,微软雇用他正是为了带来不对称的、前瞻性的、学术性的视角……他也不是就其关于 AI 对内容创作者潜在影响的理论观点而特别代表微软发言的人。”

但不管微软愿不愿意认领这些评论,有一点很清楚:这一切已经成真。Google Zero 是真的!AI 正在吞噬网络!

纽约时报的这份文件中还有许多出自各色人物的惊人表述,其中包括 Satya Nadella、Sam Altman 以及其他 OpenAI 员工。以下是这份 92 页文件中的一些亮点。

“惊人的盗窃”
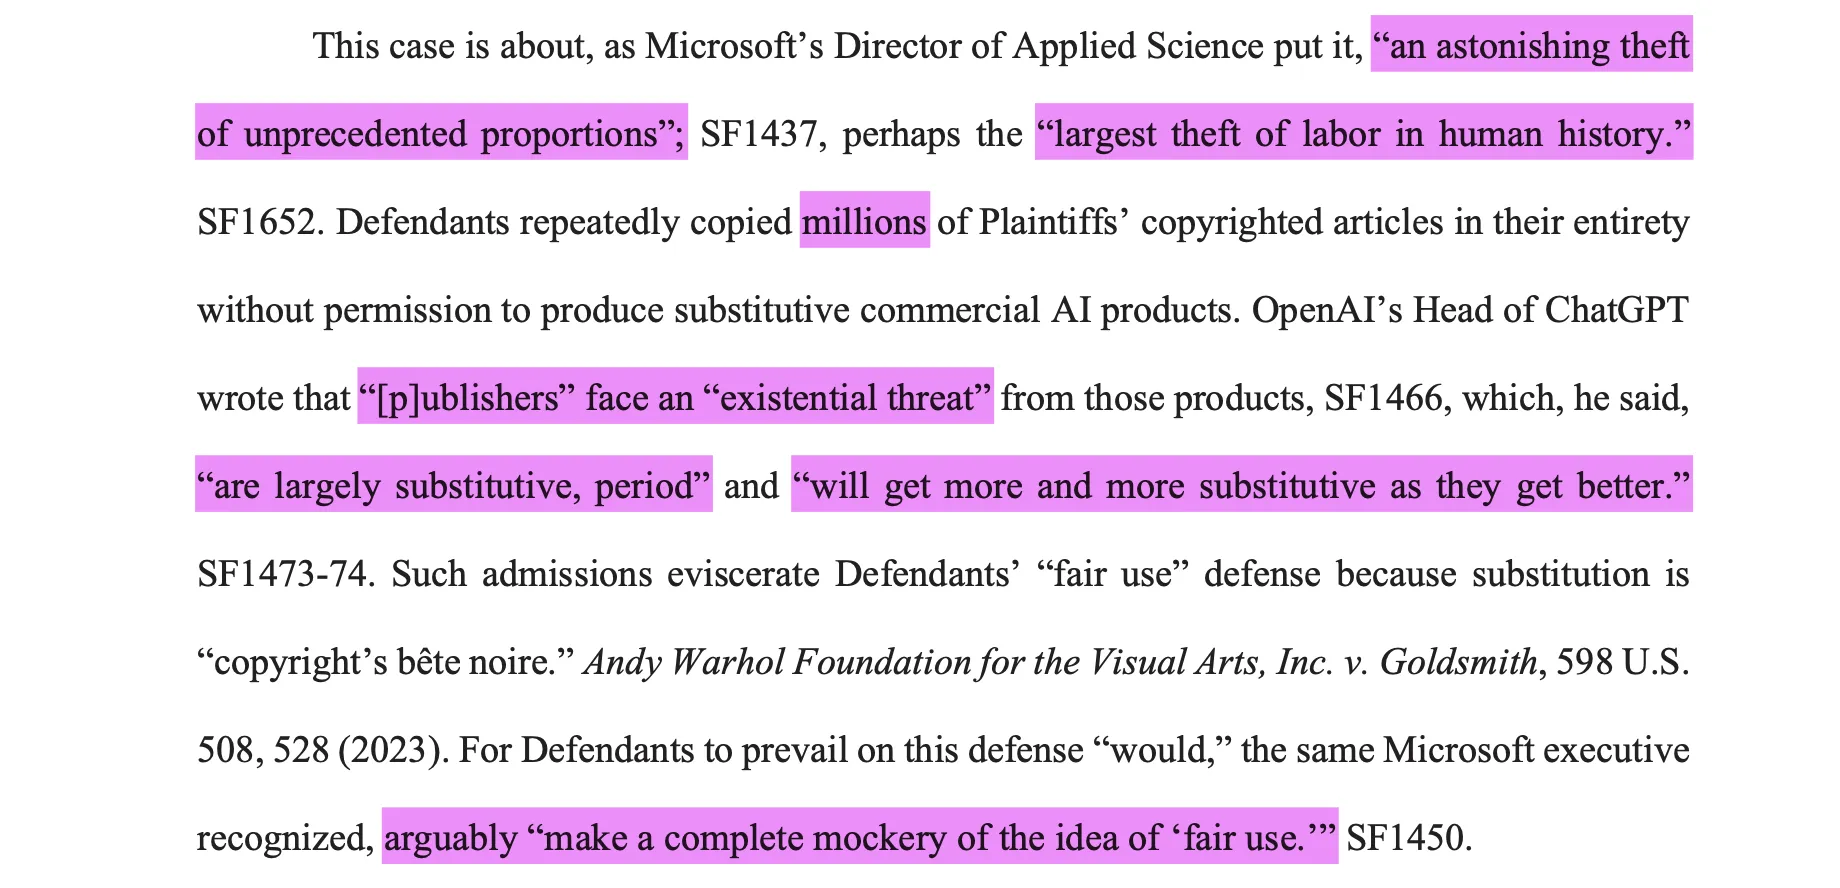
本案涉及的,正如微软应用科学总监 [Brent Hecht] 所说,是“一场规模空前的惊人盗窃”;SF1437,也许是“人类历史上最大规模的劳动盗窃”。SF1652。被告未经许可,反复整篇复制原告数以百万计的受版权保护文章,用来制造具有替代性的商业 AI 产品。OpenAI 的 ChatGPT 负责人写道,“出版商”面临来自这些产品的“生存威胁”,SF1466,他说这些产品“在很大程度上就是替代品,没有例外”,并且“随着变得越来越好,替代性只会越来越强”。SF1473-74。此类承认彻底瓦解了被告的“合理使用”抗辩,因为替代正是“版权法的心腹大患”。Andy Warhol Foundation for the Visual Arts, Inc. v. Goldsmith, 598 U.S. 508, 528 (2023)。同一位微软高管也认识到,若被告在这一抗辩上获胜,则可以说“将使‘合理使用’这一理念彻底沦为笑话”。SF1450。

引言部分引用了 Hecht 和 OpenAI 的 ChatGPT 负责人(据推测是 Nick Turley)的话,似乎表明这些公司明知自己对纽约时报这样的出版商构成了“生存威胁”。Hecht 把 ChatGPT 和 Copilot 的数据收割称为“人类历史上最大规模的劳动盗窃”,并说微软的辩护“让‘合理使用’这一理念彻底沦为笑话”。

这是一个“末日循环”
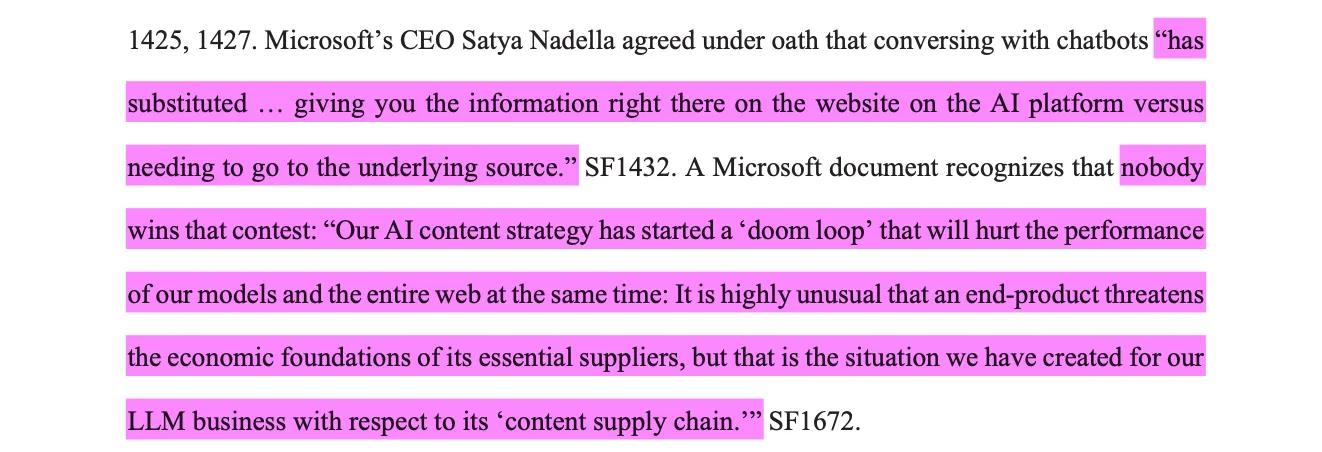
微软 CEO Satya Nadella 在宣誓后同意,与聊天机器人对话已经“取代了……直接在 AI 平台上给你信息,而不是让你去访问底层来源网站”。SF1432。微软的一份文件认识到,这场较量没有赢家:“我们的 AI 内容战略已经开启了一个‘末日循环’,它将同时损害我们模型的表现和整个网络:最终产品威胁到其关键供应商的经济基础,这种情况极为罕见,但我们的 LLM 业务相对于其‘内容供应链’恰恰造成了这样的局面。”

Satya Nadella 承认,聊天机器人基本上已经取代了搜索,让人不再需要直接去信息来源。但也许更不利的是微软的一份内部文件,其中写道:“我们的 AI 内容战略已经开启了一个‘末日循环’,它将同时损害我们模型的表现和整个网络:最终产品威胁到其关键供应商的经济基础,这种情况极为罕见,但我们的 LLM 业务相对于其‘内容供应链’恰恰造成了这样的局面。”

那甚至不是一个真实的数字
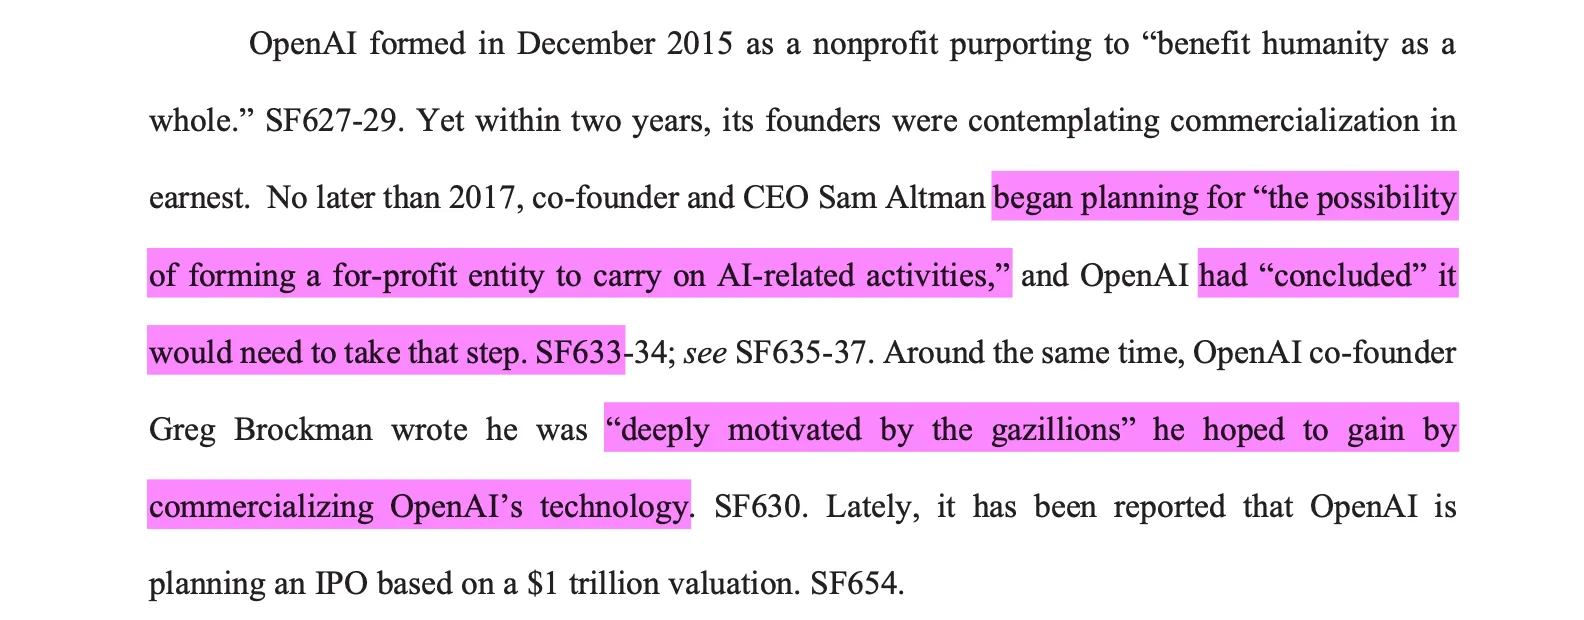
大约在同一时期,OpenAI 联合创始人 Greg Brockman 写道,他“深受”自己希望通过 OpenAI 技术商业化获得的“海量财富(gazillions)”所“激励”。SF630。最近有报道称,OpenAI 正计划以 1 万亿美元估值上市。

别被 OpenAI 或微软声称的利他意图所蒙蔽。OpenAI 联合创始人 Greg Brockman 更感兴趣的是,他有可能通过商业 AI 赚到的“海量”美元。

付费墙算什么
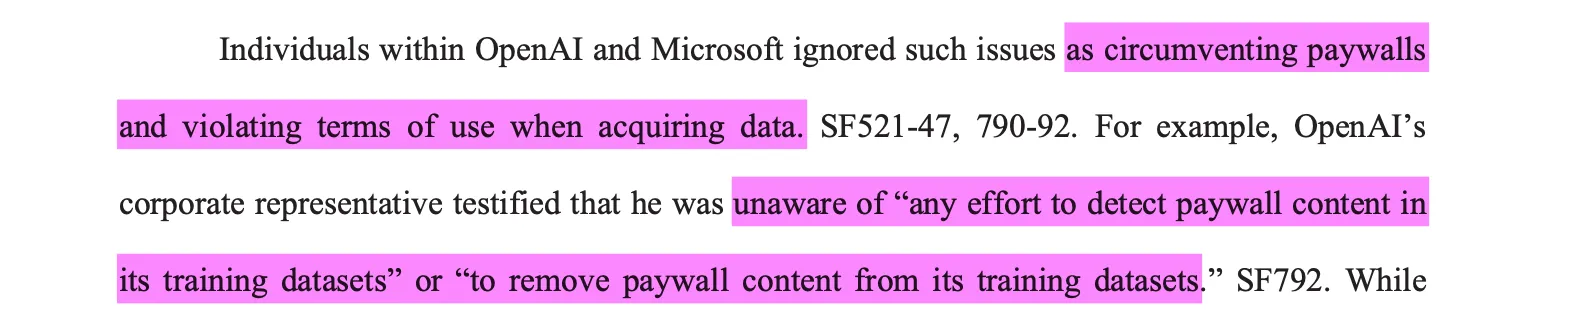
OpenAI 和微软内部的个别人员在获取数据时,无视了规避付费墙和违反使用条款等问题。SF521-47, 790-92。例如,OpenAI 的公司代表作证说,他不知道有“任何检测其训练数据集中付费墙内容的努力”,也不知道有“从其训练数据集中移除付费墙内容”的努力。

尽管 Nadella 后来被引述说“任何设有付费墙的内容都应该获得授权”,但一名 OpenAI 代表承认,他“不知道”有任何检测或移除训练数据中付费墙内容的努力。

“极其擅长复读”
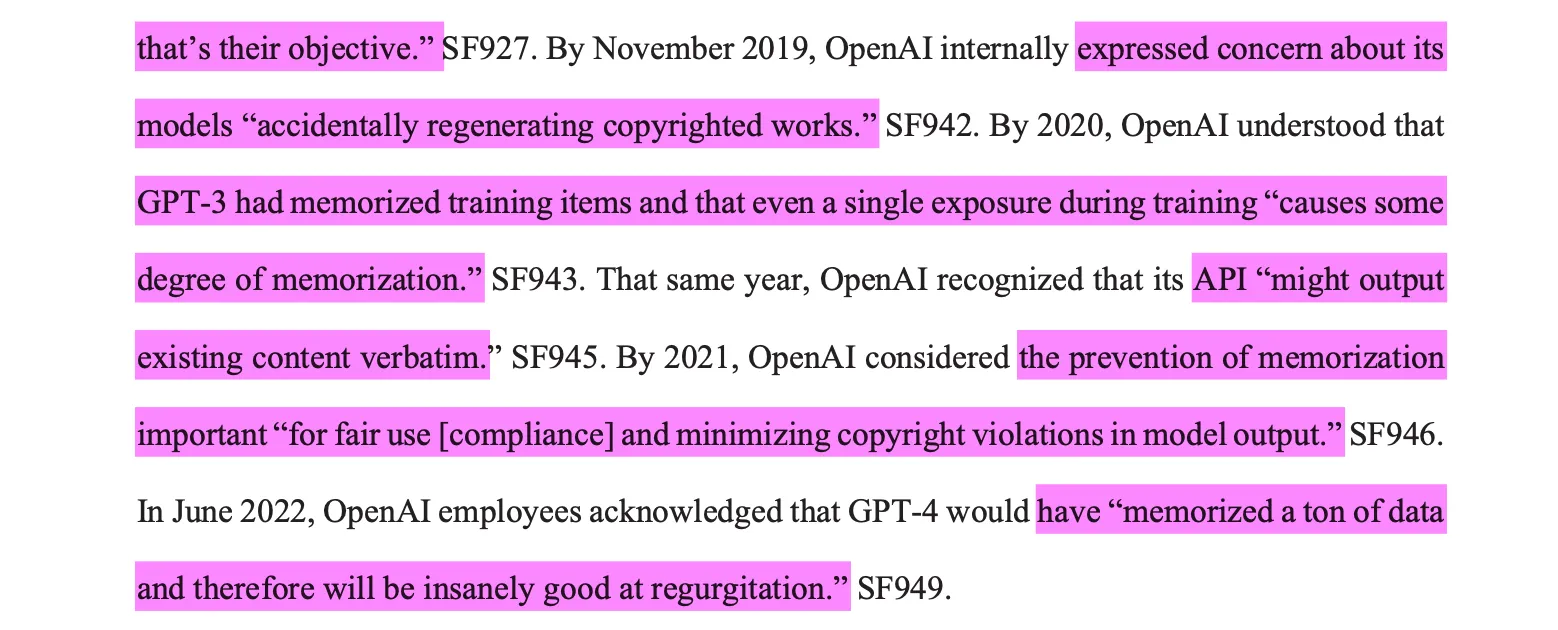
同一年,OpenAI 认识到其 API“可能会逐字输出现有内容”。SF945。到 2021 年,OpenAI 认为防止记忆对于“[合规的]合理使用以及尽量减少模型输出中的版权侵权”很重要。SF946。2022 年 6 月,OpenAI 员工承认 GPT-4 会“记住大量数据,因此将极其擅长复读”。

在内部,OpenAI 似乎十分清楚 ChatGPT 倾向于“逐字”照搬受版权保护的材料。尽管承认“防止记忆”对“尽量减少版权侵权”很重要,员工们仍承认 GPT-4“记住了大量数据,因此将极其擅长复读”。

文件随后列举了若干例子:ChatGPT 在回应查询时,直接输出了来自Times、Mercury News、The Denver Post、LifeHacker 和 Eurogamer 文章的大段文字。

“‘吸走’他们所有的作品”
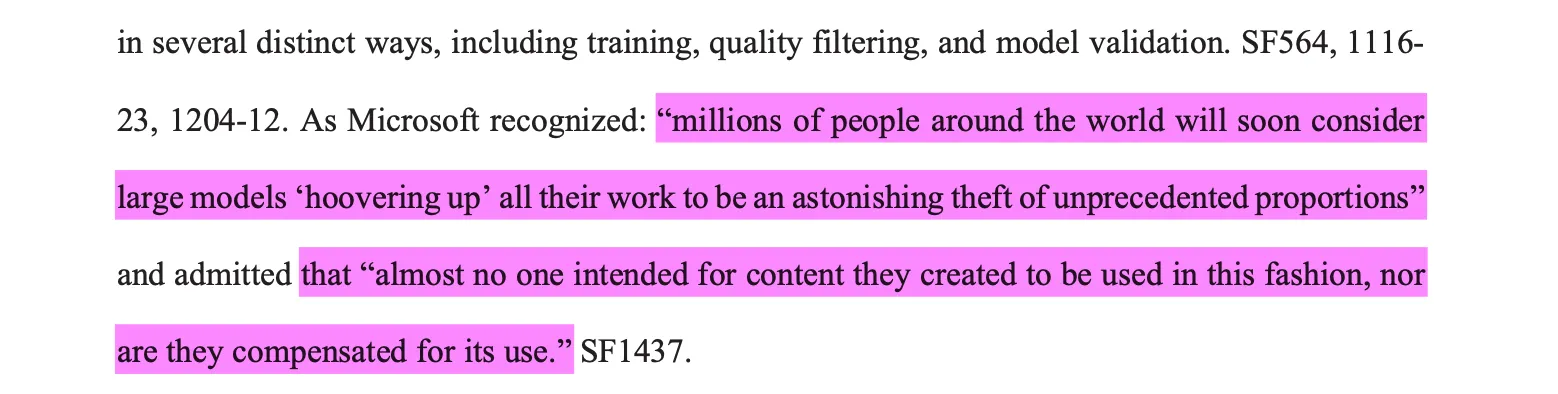
正如微软所认识到的:“全世界数百万人很快会认为,大模型‘吸走’他们所有的作品是一场规模空前的惊人盗窃”,并承认“几乎没有人打算让自己创作的内容以这种方式被使用,他们也没有因其使用而获得补偿”。

微软清楚自己对互联网的全盘抓取会被如何看待,并承认“几乎没有人打算让他们 [原文如此] 创作的内容以这种方式被使用,他们也没有因其使用而获得补偿”。

“对人类劳动的替代”
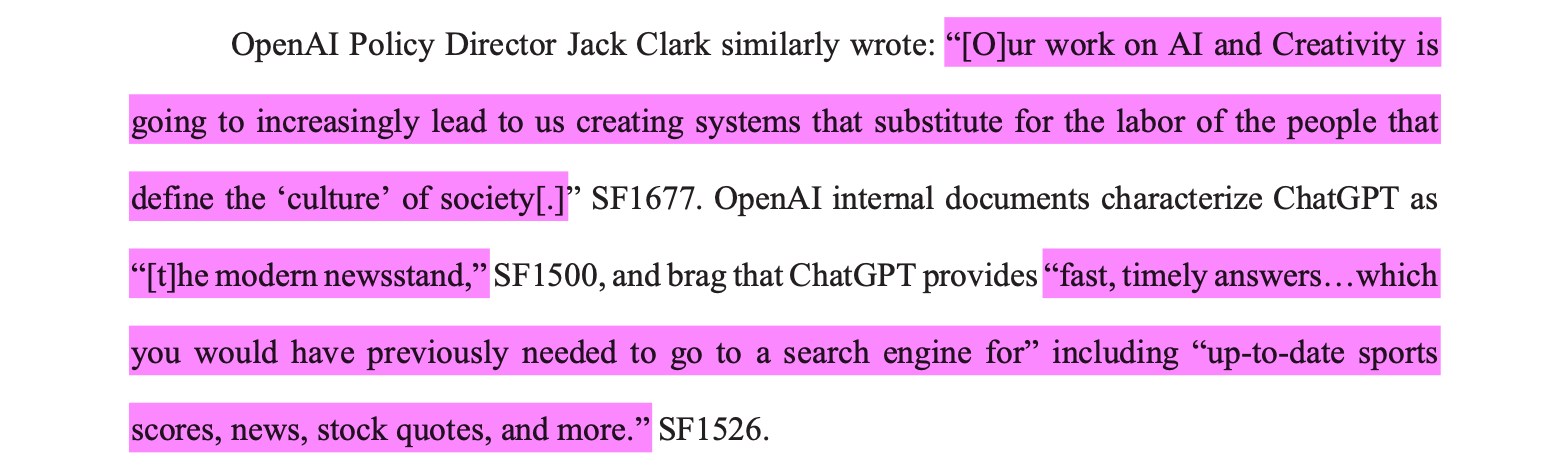
OpenAI 政策总监 Jack Clark 同样写道:“[我]们在 AI 与创造力方面的工作,将越来越多地导致我们创造出替代那些定义社会‘文化’的人的劳动的系统[。]”SF1677。OpenAI 的内部文件把 ChatGPT 描述为“[现]代报摊”,SF1500,并夸耀 ChatGPT 提供“快速、及时的答案……这些在以前你需要去搜索引擎才能得到”,包括“最新的体育比分、新闻、股票报价等等”。

OpenAI 政策总监 Jack Clark 早已看到了大势所趋,他说公司正在“创造替代那些定义社会‘文化’的人的劳动的系统”。内部文件把 ChatGPT 描述为“现代报摊”。OpenAI 的 Nick Turley 后来也被引述说,一旦你从它的聊天机器人那里得到了答案,就“没有什么好理由再去点击”来源链接。

摧毁自己的供应链
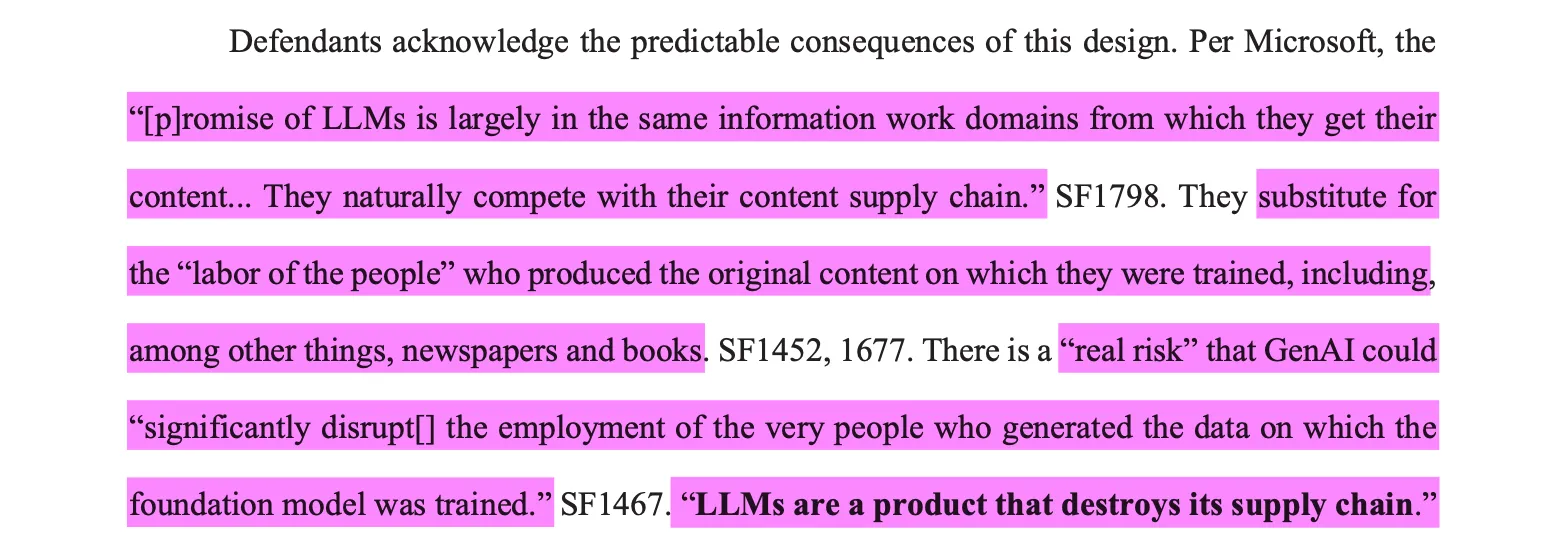
被告承认这一设计会带来可预见的后果。据微软称,“LLM 的前景在很大程度上存在于它们获取内容的同一批信息工作领域……它们天然地与自己的内容供应链竞争。”SF1798。它们替代了那些创作原始内容(包括报纸和书籍等)的“人的劳动”,而它们正是用这些内容训练出来的。SF1452, 1677。生成式 AI 存在“真实的风险”,可能“严重扰乱那些生成了基础模型训练数据的人的就业”。SF1467。“LLM 是一种摧毁自身供应链的产品。”

微软被引述承认,“LLM 是一种摧毁自身供应链的产品”,因为在许多情况下,它替代了自己的训练数据。

OpenAI 知道自己正在扼杀引荐流量
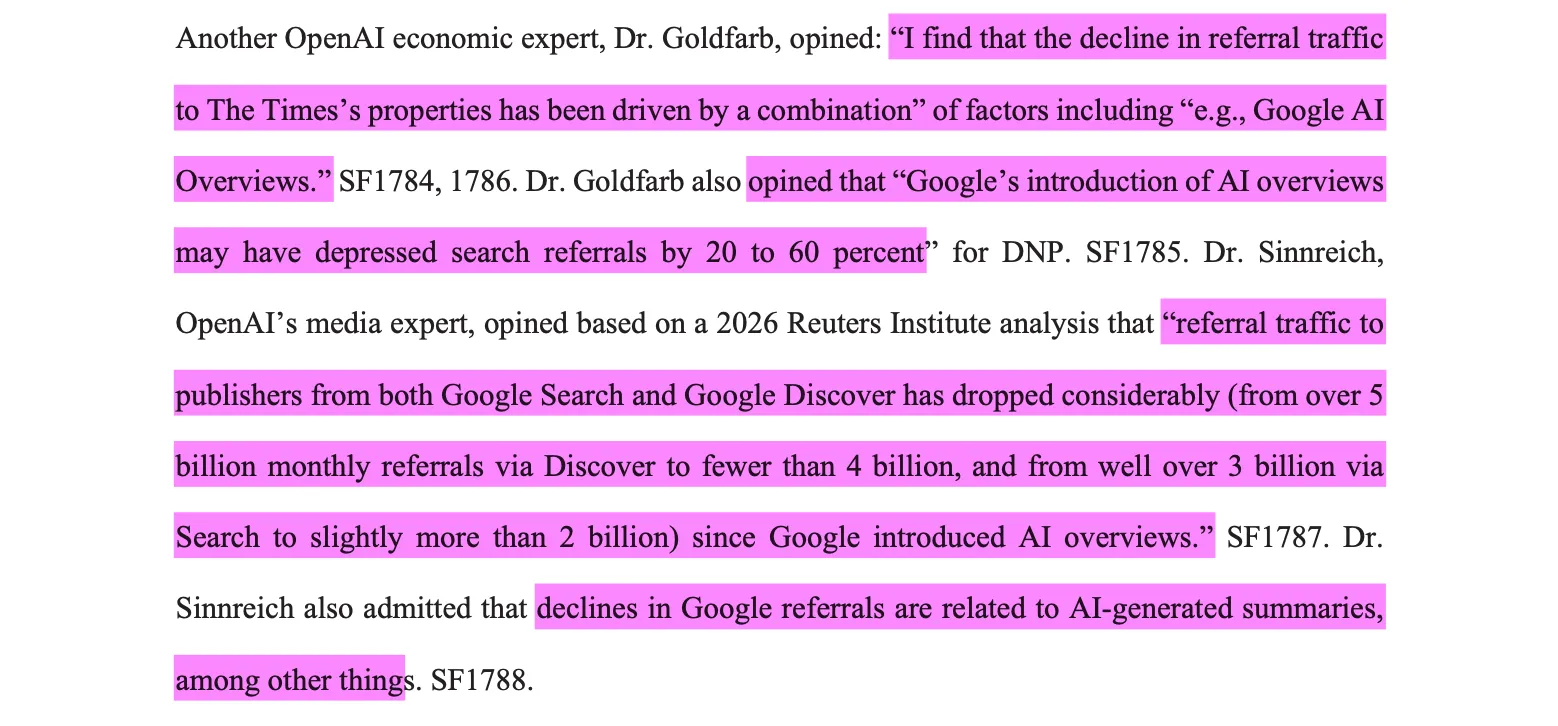
OpenAI 的另一位经济学专家 Goldfarb 博士认为:“我发现,The Times 旗下网站引荐流量的下降,是多种因素共同作用的结果”,其中包括“例如 Google AI Overviews”。SF1784, 1786。Goldfarb 博士还认为,“Google 推出 AI 概览,可能使 DNP 的搜索引荐减少了 20% 到 60%”。SF1785。OpenAI 的媒体专家 Sinnreich 博士基于路透研究所 2026 年的一项分析认为,“自 Google 推出 AI 概览以来,来自 Google 搜索和 Google Discover 的出版商引荐流量已大幅下降(Discover 每月引荐量从 50 多亿降至不足 40 亿,搜索从远超 30 亿降至略高于 20 亿)”。SF1787。Sinnreich 博士还承认,Google 引荐量的下降与 AI 生成的摘要等因素有关。

OpenAI 自己的媒体和经济学专家,把Times这类网站引荐流量的下降直接归因于 Google AI Overviews 之类的 AI 摘要。他们推测,搜索引荐量可能下降多达 60%。

微软发言人 Haurek 提醒称:“Satya 的证词与微软在本案中的立场完全一致。他谈的是广泛的原则,以及人们查找和获取信息方式正在发生的变化。这些观察不应与本案法院面前的版权问题的结论混为一谈,微软已在其文件中对这些问题作出回应。”

但根据这份新近解封的文件,似乎相当清楚:微软和 OpenAI 都知道自己将对出版业、对其雇用的“数百万人”造成无法挽回的伤害,进而损害自己的产品,却依然为了追逐“海量”美元一路向前——哪管什么末日循环。