今天,我们宣布 Together GPU Clusters 的抢占式计算(preemptible compute)进入公开预览,所有区域的 Kubernetes 集群均可使用。抢占式节点为团队提供了一种成本更低的方式,用来运行能容忍中断的工作——短期实验、推理突发流量、批处理作业——而且运行在他们已在使用的同一套 GPU 基础设施上,按亚小时计费,价格固定为按需价格的 50%。从今天起,你可以为新建或已有的集群添加抢占式算力。
▶ https://together-website.b-cdn.net/video/Preemptible%20compute%20(1).mp4
抢占式计算如何运作
抢占式计算为 Together GPU Clusters 增加了第二种计算类型。标准节点同步交付,绝不会被抢占。抢占式节点使用同样的 NVIDIA 加速计算,取自未使用的闲置容量,当这些容量在别处需要时,可能被收回。
抢占式节点按需价格的固定 50% 计费。价格保持不变,不会随现货市场波动。
当节点被收回时,集群会遵循五分钟排空(最长 5 分钟)流程:
- T+0——节点被隔离(cordon),触发
TogetherPreemptedKubernetes 事件,你的 Pod 收到 SIGTERM。 - T+0 至 T+5:00——你的工作负载最多有五分钟(
terminationGracePeriodSeconds)的时间保存检查点并退出。 - T+5:00——节点被移除。
节点被移除后,集群仍保留其抢占式目标,并在有容量可用时自动补充,向该目标靠拢。你无需另行申请替换容量。
计费按亚小时进行,每一到两分钟计量一次用量。运行 12 分钟的节点,大约按 12 分钟计费。
抢占式节点并不是一种独立的集群类型。它们加入你现有的集群,并带有 together.ai/compute-class=preemptible 标签,这样可中断的 worker 运行在折扣算力上,而协调器、登录 Pod 和在线服务副本则留在标准节点上。
抢占式计算适合哪些场景
五分钟的回收流程使得恢复行为成为决定性因素。能够恢复、重试或重新排队的工作可以使用抢占式容量,而关键组件应保留在标准节点上。
短期实验。当工作可以从检查点恢复、或在 worker 消失后重试时,消融实验、配置扫描、快速微调、评估、蒸馏和批量推理都是很合适的候选。Ray Train 和 PyTorch Lightning 等框架无需干预即可从最新检查点恢复。作为参考,GLM5.3 Flash(321B 参数模型)的完整权重检查点大约为 3.5TB,即便性能下降,写入并行文件系统也只需 22 秒到 4 分钟,在五分钟的排空窗口内仍留有余量。
临时突发流量。当批处理或内部推理需求激增时,可以添加更便宜的抢占式节点来承接突发流量和非关键工作负载,而不必按峰值持有标准容量,也不必冒着突发时标准算力不可用的风险。被中断的请求会重新排队;面向用户的副本则保留在标准节点上。
共同点是:工作被分块、有检查点或可重试。没有检查点的多日运行,以及没有后备方案的严格 SLO 在线服务,都不适合。
Together 有很强的内部自用(dogfooding)文化,Together 内部的多项研究、开发/测试和非关键生产工作负载,都基于我们的抢占式计算 GPU 集群,使我们得以在各产品团队之间利用闲置容量。
启用之前
- 把抢占式节点当作临时资源。预览期间没有最短节点存续时间,因此请频繁保存检查点,并做好容量随时消失的准备。
- 把关键组件留在标准节点上。协调器、登录 Pod 和面向用户的副本应属于有保障的容量——使用
compute-class标签来强制落实。 - 利用排空窗口。将
terminationGracePeriodSeconds设为最多 300 秒,在 Pod 收到 SIGTERM 时保存检查点,并在节点被移除之前退出。 - 集群至少需要一个标准节点,且节点不能在计算类型之间就地转换。
如何使用
在工作负载为抢占做好准备之后,设置分为两部分:设置抢占式目标,并将符合条件的工作调度到带标签的节点上。
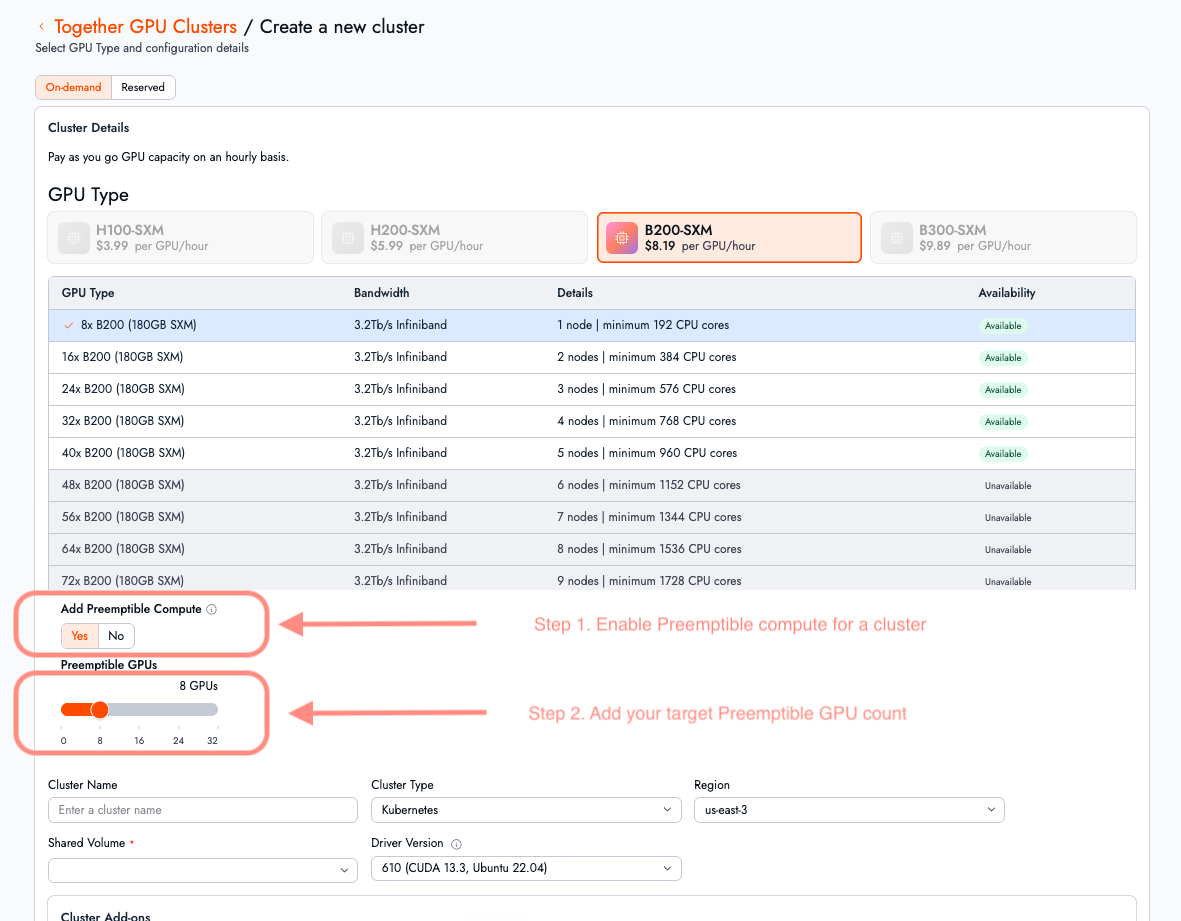
你可以在创建集群时,或在已运行的集群上,通过 Together Cloud 控制台、CLI 或 API 设置目标。API 会同时报告请求的目标 desired_preemptible_gpus 和当前在线的容量 allocated_preemptible_gpus。由于抢占式节点取自未使用的容量,在容量紧张时,已分配的容量可能低于期望的目标。
在新集群上
选择标准节点数量,然后在其基础上添加抢占式目标。
tg beta clusters create \
  --name my-cluster --region us-central-2 --gpu-type RTX_6000_PCI \
  --cluster-type KUBERNETES --num-gpus 8 --billing-type ON_DEMAND \
  --num-preemptible-gpus 8 \
  --project-id <proj_id>
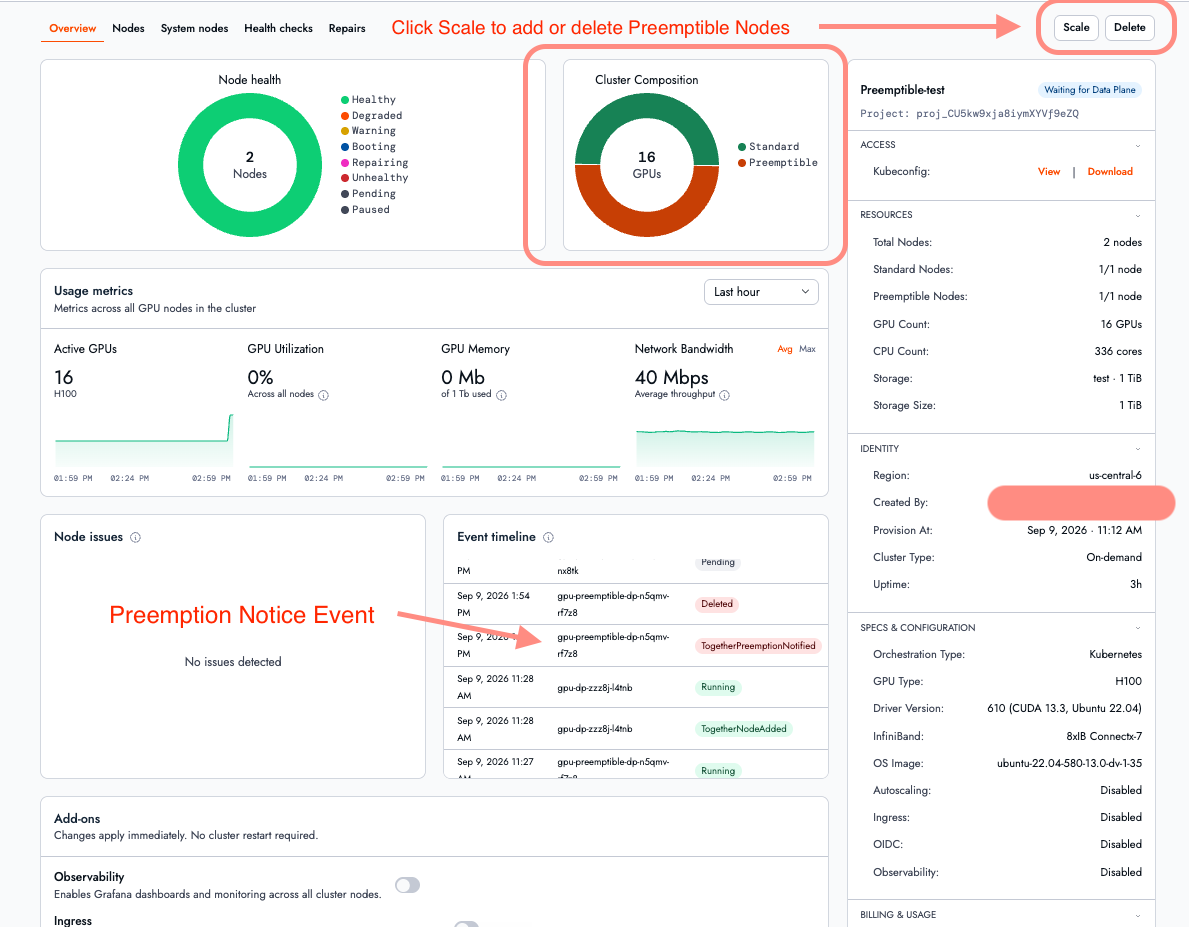
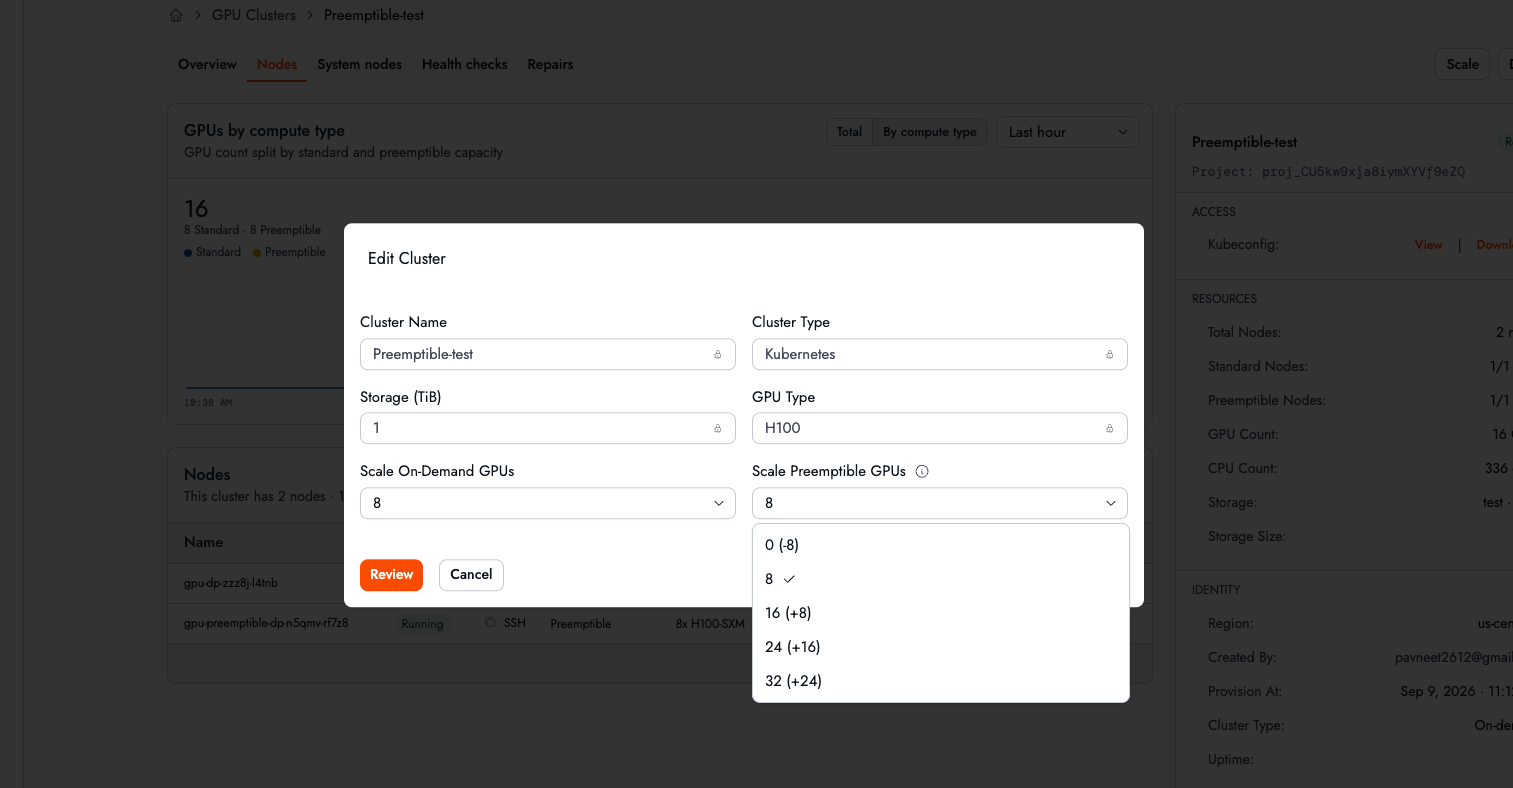
在已有集群上
需要额外的 worker 容量时上调抢占式目标,工作完成后再调低。集群全程保持运行。
tg beta clusters update <cluster-id> --num-preemptible-gpus 16
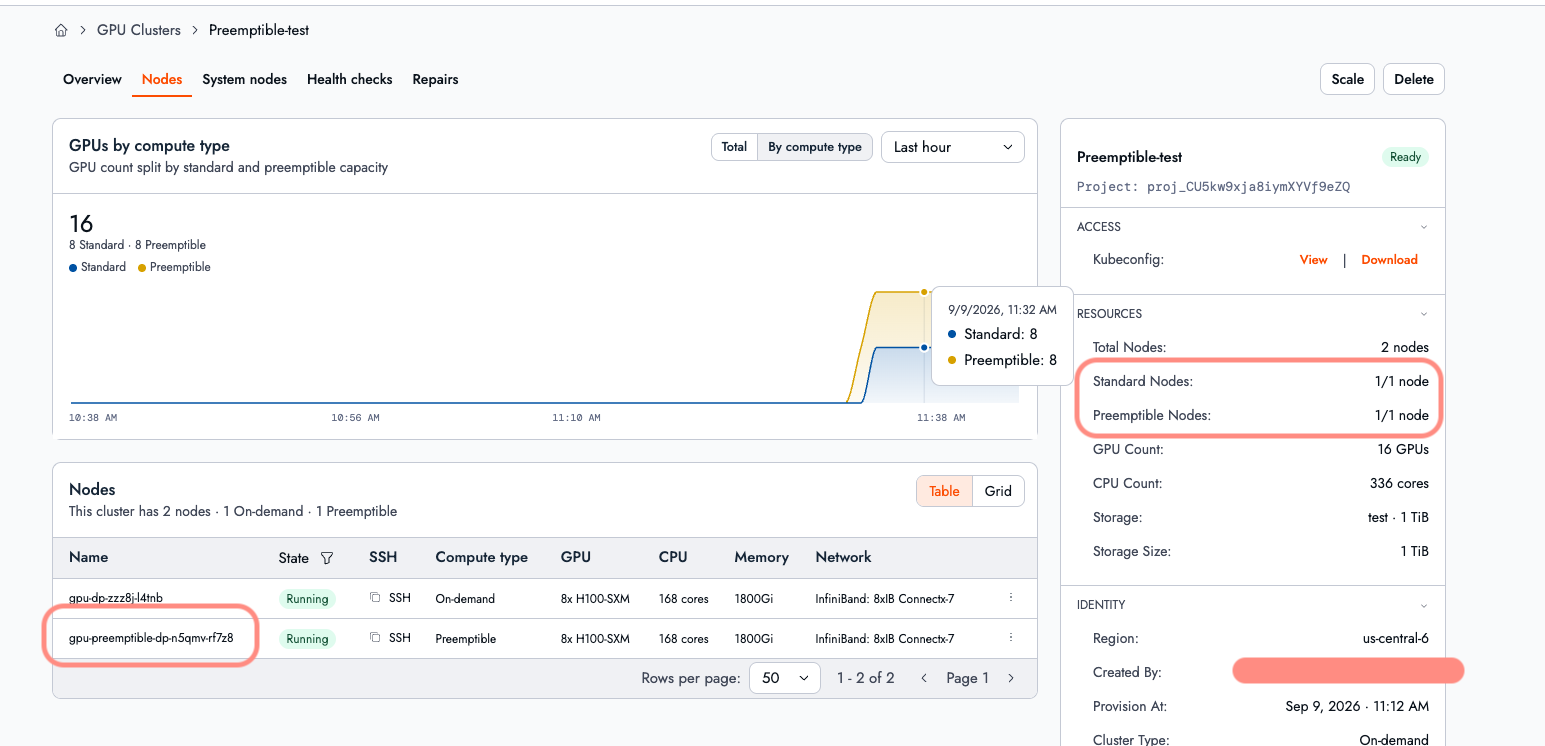
在抢占式节点上调度工作
显式指定抢占式节点:
nodeSelector:
  together.ai/compute-class: preemptible
抢占通知会以 SIGTERM 的形式发送给 Pod,同时以 Kubernetes 事件(reason=TogetherPreempted)的形式出现在控制台的事件时间线中,也可通过 Together API 的 node_lifecycle_events 获取——处理模式详见文档。
抢占式计算现已在 Kubernetes 集群上进入公开预览。接下来计划支持 Slurm、更多区域,以及计算类型之间的就地转换。
→ 创建集群
→ 阅读文档