随着分布式 AI 训练规模扩大,硬件和软件依赖方面的故障日益干扰训练进度,因此快速、可靠的恢复变得至关重要。一个停滞的训练 rank 可能触发 NVIDIA Collective Communications Library(NCCL)超时,一个 GPU 节点可能停止响应调度器,或者一个掉队者(straggler)可能拖慢整个作业。每次中断单独来看都是可管理的,但累积影响和恢复开销决定了系统将实际耗时(wall-clock time)转化为有效训练进展或 goodput 的效率。
当手动恢复需要覆盖集群中所有训练作业、全天候、大规模进行时,它就变得不可持续。每次中断都需要日志分析、故障隔离以及从保存的检查点重启,而受影响的 GPU 在恢复期间保持空闲。随着训练作业数量和规模增长,重叠的故障增加了工程负担和浪费的 GPU 小时。如果没有持续覆盖,这些损失会不断累积,增加整体计算成本并延长训练时间。
NVIDIA Recovery 是 NVIDIA DSX OS(包含 NVIDIA DSX AI Factory Platform 的模块化软件组合)的一部分,是一个开源的工作负载级服务,可全天候自动恢复集群中的训练作业。它利用应用日志、GPU 指标和调度器信号检测中断,使用故障归因来识别相关资源,并协调隔离以及在健康容量上从检查点重启。通过在工作负载之间自动化这一恢复循环,它能够处理并发中断、减少人工干预,并帮助维持训练 goodput。本文介绍恢复循环的工作原理、NVIDIA Recovery 如何与 Slurm 集成,以及如何在你自己的集群上部署它。
工作负载恢复是 AI 工厂的一个独立关注点
我们之前的 NVIDIA DGX Cloud 韧性文章、GTC 演讲 和 NVIDIA Mission Control 2.5 文章 描述了保持训练高效的分层方法。NVIDIA Recovery 基于该架构,将基础设施修复与工作负载恢复连接起来。
故障修复自动化(break-fix automation)识别故障节点、将其从服务中移除,并将硬件路由以进行修复。诸如 NVRx 之类的框架级库在单个训练作业内提供恢复、挂起检测和掉队者缓解,但每个用户必须为自己的工作负载配置和管理这些能力。诸如 Slurm 之类的集群工作负载管理器负责资源分配、排队和容器执行。
工作负载恢复是一个独特的协调问题:恢复有效的训练需要将故障归因于其原因,决定受影响作业是否应重启以及在哪里重启,并在共享基础设施的工作负载之间一致地采取行动。解决这个问题需要一个集群级控制循环,将基础设施修复、框架级恢复和集群工作负载管理集成在一起,并具备跟踪恢复延迟、恢复成功率和恢复有效训练所需时间的运维指标。
多级 NVIDIA 健康与韧性栈
如下图 1 所示,NVIDIA Recovery 在 DSX OS Stack 中提供专用的工作负载恢复层。节点健康监控和隔离依赖于集群的编排和工作负载管理栈。Kubernetes 部署使用 NVSentinel 监控 GPU 健康指标和 XID 事件,并自动封锁(cordon)和排空(drain)故障节点。许多 Slurm 站点使用自定义的 prolog 和 epilog 脚本检查节点健康。来自 Slinky 项目的 slurm-operator 在 Kubernetes 上运行 Slurm 时原生支持并注入这些相同的脚本。在单个训练作业内,NVRx 提供用于作业内恢复和挂起检测的库。NVIDIA Recovery 在集群级别跨工作负载协调恢复,与这些能力集成以管理作业重启、放置和节点排除。
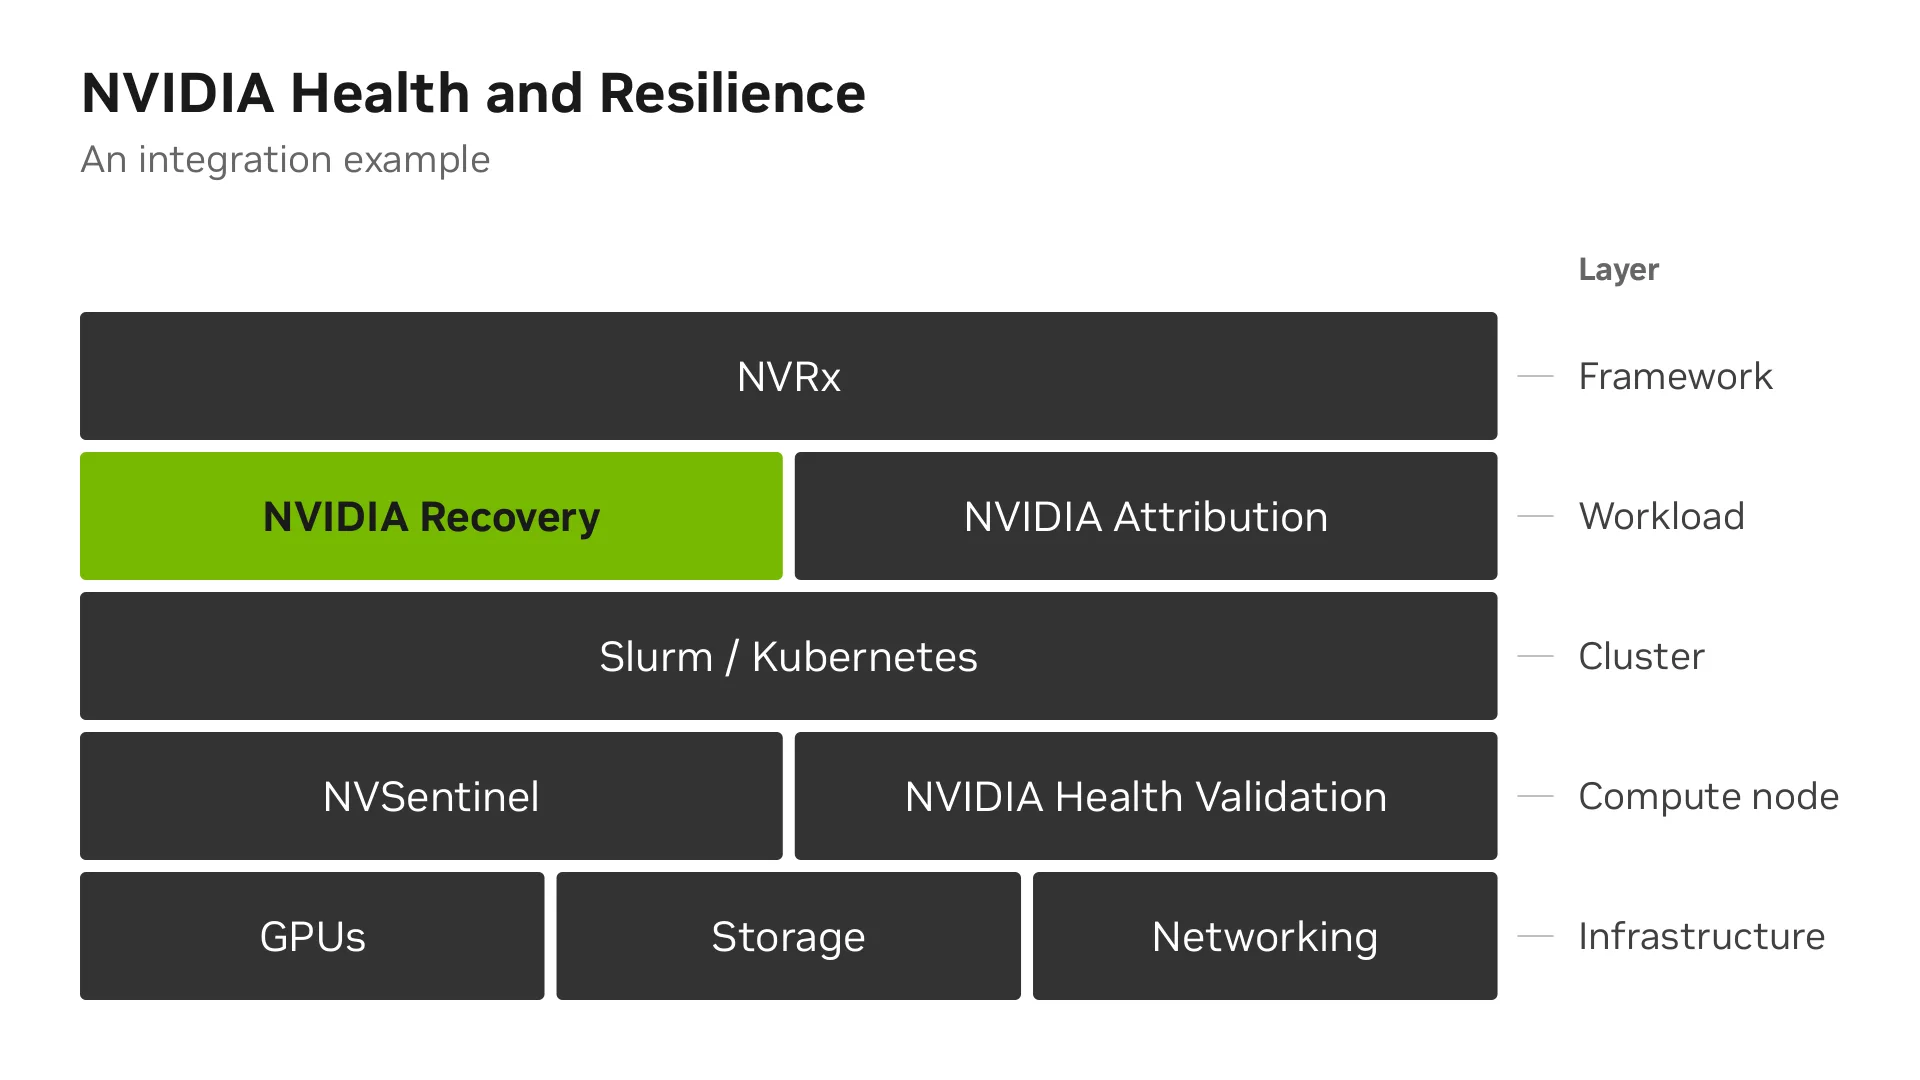
这些层独立运行,没有硬依赖,允许你采用每个模块化组件,或插入你自己的平台组件进行集成。例如,如果你的集群已经依赖 NVSentinel 或 NVIDIA Health Validation,你可以几乎或完全无需更改现有健康工作流即可集成 NVIDIA Recovery。
对于已经运行 NVRx 的环境,NVIDIA Recovery 通过管理跨工作负载生命周期和节点排除,填补了作业内重启无法触及的空白。当与 NVIDIA Attribution 配合使用时,它会收到丰富的跨层诊断结论,从而丰富持久审计跟踪。
缺口的代价
在集群规模下,罕见的单 GPU 故障会累积放大。即使每个 GPU 在某一天以 99.9% 的概率无故障运行,一个跨越 10,000 个 GPU 的作业当天不间断完成的概率也只有 0.99910,000 ≈ 0.005%。这解释了为什么在 Meta 对 24,000 个 A100 GPU 为期 11 个月的研究中,硬件故障中断的作业不到 1%,而这些作业却占 GPU 运行时间的 19%:最大、运行时间最长的作业暴露风险最高。
NVIDIA Recovery 自动恢复集群中的训练工作负载,对小型和大型分布式运行都有用。在许多较小的作业中,中断会累积,增加运维负担。在大型作业中,每次中断影响更多 GPU,放大恢复的计算成本。自动化恢复可同时应对这两项挑战。
我们的生产环境观察结果凸显了对这种高效、自动化且能跨集群工作负载扩展的恢复机制的需求:从 7 月 9 日到 10 月 9 日,NVIDIA Recovery 在一个训练集群上的监控每天覆盖近 200 个作业,记录了约 8,550 次异常检测,平均检测延迟和恢复操作延迟分别为 69 秒和 94 秒。随着中断不断累积,这种无人值守的集群级响应减少了对个别工程师和按用户恢复安排的依赖。恢复操作延迟以自动化操作结束为终点;调度和检查点恢复决定生产性训练何时恢复。
自动化恢复循环
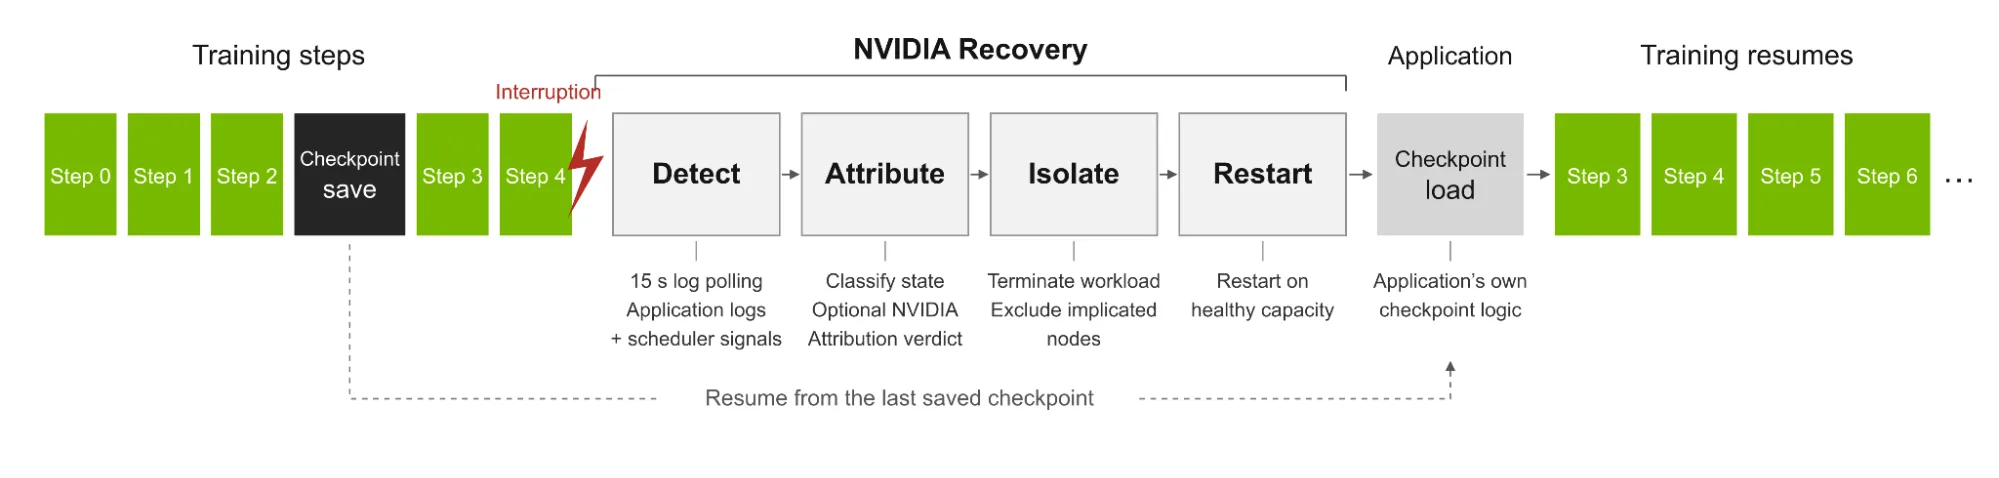
NVIDIA Recovery 协调集群训练工作负载的恢复。该循环由四个阶段组成,具体操作由中断情况和配置的策略决定:
- 检测:异常检测器结合应用日志和调度器信号来识别崩溃、挂起和掉队者。它能识别 PyTorch 和 NCCL 故障、CUDA 错误以及互连故障模式。缺少进度信号或识别到已知的通信挂起模式表明可能存在挂起;相对于近期基线的持续吞吐量下降表明可能存在掉队者。
- 归因:NVIDIA Recovery 使用检测期间收集的调度器信号和应用日志对中断进行分类,并指导恢复操作。可选集成 NVIDIA Attribution 可增加更深入的诊断,以区分硬件故障、系统软件问题和应用缺陷。这些证据为节点排除提供依据,并丰富审计追踪。运维人员也可以集成自己的归因服务,并独立采用 NVIDIA Recovery。
- 隔离:异常修复器执行恢复建议,将相关节点从后续重启尝试中排除,或在进一步重试不会产生效果时停止工作负载。它跨多次尝试跟踪相关节点,以避免重复故障。此外,安全网(看门狗服务)允许在恢复决策耗时过长或彻底失败时正常调度继续进行,防止工作负载无限期等待。
- 重启或停止:调度器集成通过 Advisor API 对 NVIDIA Recovery 的建议采取行动,以重启工作负载或停止无效果的重试。重启时,应用使用其现有的重启逻辑从最后保存的检查点恢复。如果作业在可配置的尝试次数内未能保存新检查点,则可以停止进一步重试。审计追踪记录重启和停止决策,并将分配重启、恢复的训练进度和训练完成作为不同事件进行跟踪。
NVIDIA Recovery 与工作负载调度器的集成
NVIDIA Recovery 作为控制平面服务运行,通过 HTTP 或 gRPC API 与集群的调度器集成通信。它支持 Slurm,Kubernetes 支持已在路线图中。恢复建议遵循通用的 API 契约,集群侧控制器将其转换为工作负载管理器的操作。这使 NVIDIA Recovery 独立于调度器内部实现,并避免修改应用代码。
对于 Slurm,参考 Advisor Controller 以 Helm chart 形式提供,便于部署。它支持两种模式:1)集群内模式,控制器在集群内运行;2)SSH 模式,控制平面远程连接 Slurm,无需添加集群内服务。当部署新的集群组件需要变更窗口或安全审查时,这提供了一种选择。
NVIDIA Recovery 在控制器执行操作之前记录每条恢复建议,创建预期操作的审计追踪。如果控制器在恢复期间重启,它会在继续之前检查当前调度器状态,以防止重复已完成的操作为保障。
运行方式:监控模式和审计追踪
新部署默认以监控模式启动。在此模式下,NVIDIA Recovery 发布建议并记录它本会执行的操作,但不采取任何调度器操作。审查这些建议,将决策与你自己的工程师会做的决策进行比较,并在对信噪比满意后按集群切换到操作模式。
controller:
  environment: prod
  acknowledgeSchedulerActions: false

watchdog:
  enabled: true
  mode: observe
  acknowledgeSchedulerActions: false
  environmentPattern: prod
IBM Research 在其 Slurm 集群上采用了这一路径。他们首先以监控模式运行,将建议与自己的人工恢复决策进行比较,并在验证信号后启用自主操作。Neocloud 提供商 Verda 部署在 Victoria Logs 而非 Loki 上,并为仓库合作开发了 VictoriaLogs 连接器,快速启动了 OSS 合作伙伴计划。
NVIDIA Recovery 将每个操作写入持久、可查询的审计追踪。每条记录捕获匹配的检测模式、采取的操作(终止、重新排队、释放或节点排除)、时间戳、工作负载标识符,以及返回时的 NVIDIA Attribution 判定。策略引擎操作和看门狗操作进入同一追踪,因此记录没有缺口。
Recovery Console 是运维人员仪表板。它显示跨调度器类型的实时工作负载状态,内联展示异常标记,并提供每个工作负载的每个检测事件和恢复操作的时间线。
▶ https://developer.download.nvidia.com/devblogs/NVIDIA-Recovery-Blog-Demo.mp4
视频 1. 在 Kubernetes 上使用 Slurm 的 NVIDIA Recovery 演练,从环境设置和作业配置到作业失败、自动恢复和归因
NVIDIA Recovery 可在 dsx-ai-factory/NVIDIA-Recovery GitHub 仓库中获取,采用 Apache 2.0 许可证。让第一个工作负载进入恢复流程只需三步:
- 安装 chart。NVIDIA Recovery 通过单个 Helm umbrella chart 部署。它附带一个捆绑的 MySQL 子 chart,因此你可以在本地运行快速入门,而无需配置数据库或物理 GPU。对于生产环境,请将 chart 指向托管 MySQL 服务。仓库中的运维人员部署指南涵盖了这两种路径,以及 Kubernetes、Helm 和 Slurm 的当前版本要求。
- 验证你的信号。将 chart 指向你现有的 Loki 或 Victoria Logs 端点以及 Prometheus 抓取目标,然后在第一个工作负载之前运行日志摄取配置器。它会根据 NVIDIA Recovery 契约测试你的信号,映射与默认值不同的标签名称,并在不匹配变成静默失败之前将其暴露出来。
- 让工作负载选择加入。在你的 sbatch 提交脚本中添加一条指令:
#SBATCH --comment='{"nvidia-recovery":{"environment":"prod","mode":"observe"}}'
此后,NVIDIA Recovery 通过应用程序日志和调度器信号监控工作负载。在监控模式下,它会发布恢复建议而不采取操作。在 Recovery Console 中验证这些建议后,通过在 Helm values 中将 mode 设置为 action、将 acknowledgeSchedulerActions 设置为 true 来启用自主恢复。
其他资源涵盖了其余内容:
- dsx-ai-factory/nvidia-recovery GitHub 仓库,用于获取源代码和问题跟踪器。
- 快速入门指南,无需物理 GPU 即可运行。
- 运维人员部署指南,适用于集群内和基于 SSH 的 Slurm 部署。
- 架构参考,说明控制平面如何组合在一起。
NVIDIA Attribution 是推荐的配套部署。它为 NVIDIA Recovery 提供更深入的诊断判定和更丰富的审计追踪;它是可选的,并与 NVIDIA Recovery 一同发布。
接下来是什么
此版本可恢复 Slurm 作业,包括通过 slurm-operator 在 Kubernetes 上运行的 Slurm。接下来有两项能力。针对 Slurm 作业数组的恢复为许多团队作为数组运行的超参数扫描提供与单个作业相同的保护:每个失败的任务都会自行恢复,当失败看起来是系统性的时候,恢复会停止。原生 Kubernetes 恢复从 JobSet 和 Kubeflow PyTorchJob 开始,使用开源 Workload Map 项目来支持每种工作负载类型。
除此之外,路线图涵盖了更精细的故障分类、在仪表板和 API 中更清晰地记录每个恢复决策以便你可以将其输入自己的可观测性工具,以及朝着稳定版本推进的工作。对路线图问题投票和评论,以影响哪些工作优先进行。
IBM Research 已为训练工作负载部署 NVIDIA Recovery,并正在与该团队合作完善来自这些工作负载的故障模式。Verda 是首个部署它的 NVIDIA 云合作伙伴,使用 VictoriaLogs 运行 NVIDIA Recovery,并已提交其首批拉取请求。随着更多采用者做出贡献,他们的更改会经过与 NVIDIA 自身更改相同的审查。
NVIDIA Recovery 是 DSX OS 的一部分,DSX OS 是 NVIDIA 用于 AI 工厂运营的开源软件层。它采用 Apache 2.0 许可证。
开始使用
NVIDIA Recovery 自动化了手动流程留给工程师在凌晨 3 点完成的恢复循环。克隆仓库,针对你的遥测栈运行配置器,并让一个工作负载选择加入。第一次中断将向你展示该循环端到端的样子。
- dsx-ai-factory/nvidia-recovery GitHub 仓库,用于获取源代码和问题跟踪器
- 快速入门指南,无需物理 GPU 即可运行
- 运维人员部署指南,适用于集群内和基于 SSH 的 Slurm 部署
- 架构参考,说明控制平面如何组合在一起
致谢
Abhishek Jha、Alex Kondratenko、Amy You、Andrew McHarg、Ashwin Poojary、Ashwini Awatiger、Bob Schatz、Collin Neale、Dave Yao、Deepak Narayanan、Dilpreet Singh、Divyansh Jain、Dong H. Ahn、Dorrin Poorkay、Evan Briones、Gargi Prasad、Haim Elisha、Hamzeh Doostie、Harmandeep Singh、Harri Lin、Himanshu Soni、Ian Gibbs、Jason Sewall、Kumar Anik、Maer Rodrigues de Melo、Megan Chao、Mike Houston、Orlando Gentil、Oscar Bejarano Ardila、Pavan Kumar Gondhi、Prateek Gera、Rajan Singh、Rakshit Sanadhya、Rajasi Purandare、Ripple Patel、Rick Izzo、Ruoxi Zhang、Satish Pasumarthi、Shelby Thomas、Stefania Alborghetti、Tony Wang、Vincent Pun 和 Yugal Jain 对本博文做出了贡献。