两周前,我们开放了 Phonon,这是我们的小型文本转语音模型,可在你自己的设备上运行。它不需要服务器,也不需要网络,你输入的内容始终留在你身边。
到目前为止,我们对各方的反响非常满意。那么,这就是这次发布的故事:我们为什么构建 Phonon、它能做什么、随它一同发布的演示,以及它在 Hugging Face 的 Open TTS Leaderboard 上的表现。
为什么声音应该住在你的设备上
大多数语音 AI 都住在云端:每句话都要往返服务器一次。Phonon 则运行在你自己的设备上。你的文本留在那里,语音无需网络即可工作。我们还开放了权重。Phonon 31m 采用 Apache 2.0 许可,因此你可以免费使用,甚至用于商业产品。其他模型采用 CC BY-NC 许可,因此可免费用于非商业项目。如果你要用这些模型构建商业产品,定价基于你的用户数量,而不是你生成多少语音。
让优质语音在小设备上运行一直很难。你可以把模型做小,但那样听起来效果不好。或者你可以让它听起来很好,但那样就装不下。我们同时解决了这两个问题。
我们在四月发布了 Phonon,并在接下来的六个月里与合作伙伴和早期用户一起在其基础上继续构建。他们的反馈帮助我们塑造了这次发布。模型变得更小,我们还增加了更多语言,并通过语音克隆和语音设计支持自定义语音。
Phonon 基于 Pocket TTS 谱系,因此使用流匹配(flow matching)来生成音频,这与其他 TTS 系统所用的建模技术非常不同。正是这一点让我们能把这种质量带到如此小的模型中,但它在训练模型时也带来了新的挑战。训练最初在数值上不稳定,需要若干技巧才能在全部五种语言上产出高质量结果。
我们发布了什么
Phonon 有两种尺寸,分别约为 65 MB 和 75 MB。它们共同支持英语、法语、德语、西班牙语和葡萄牙语。内置语音超过 100 种,你还可以在 Gradium Studio 中创建自己的语音。Phonon 还能处理大多数其他 TTS 系统经常出错的重要事项,比如电话号码、日期和代码。
它可以在手机、笔记本电脑、单板计算机和浏览器标签页中运行,所以你可以现在就听听看。Phonon 31m 支持英语,采用 Apache 2.0 许可,因此你可以自由地在其上构建,包括用于商业产品。Phonon 40m 以非商业许可覆盖全部五种语言。
演示与首批项目
发布时附带了来自朋友和我们自己团队的演示。在关闭 Wi-Fi 的 Apple Watch 上,Phonon 一步步指导你冲泡咖啡。在没有信号的 iPhone 上,它为你计数重复动作并鼓励你坚持下去。Autonomous 公司一款名为 Lamp 的机器人戴着一顶分院帽,并以角色口吻说话。在浏览器中,一个离线恐龙跑酷游戏变成了由 Rex 主持的广播节目。还有一个科幻游戏在玩家自己的机器上配音,以及《追忆似水年华》逐页朗读。
Hugging Face 团队构建了 Transformers 集成,因此开发者从第一天起就能在 Transformers 中使用 Phonon。
开发者们也开始在其上构建。ExecuTorch 转换让 Phonon 在浏览器中访客的 GPU 上运行,Micdrop 将它带入 Node.js 应用,而像 smallest-s2s 这样的 Spaces 也在其基础上构建。
Phonon 在头两周内下载量超过 200,000 次,并且仍在 Hugging Face 上趋势上升。
Phonon 在 Hugging Face Open TTS Leaderboard 上的表现
Open TTS Leaderboard 是 Hugging Face 一个非常新的项目,我们很喜欢它。Hugging Face Hub 上有超过 9,000 个 TTS 模型,该排行榜为开发者提供了一个地方来比较开放模型并并排试听。在 23 种语言中,模型会按可懂度(输出的词错误率)、速度(实时因子的倒数和首音频时间)以及自然度(英语用 UTMOS,韩语用 KOMOS)进行评估。固定语音和语音克隆都会被评估,后者还额外有一个说话人相似度指标。排行榜还有一个 Listen 标签页,你可以在那里方便地自行比较 TTS 输出,并为你最喜欢的投票。
在可懂度方面,Phonon 在德语和西班牙语中排名第一,在我们评估的每种语言中都进入前三,与规模最高达其 100 倍的模型并列。
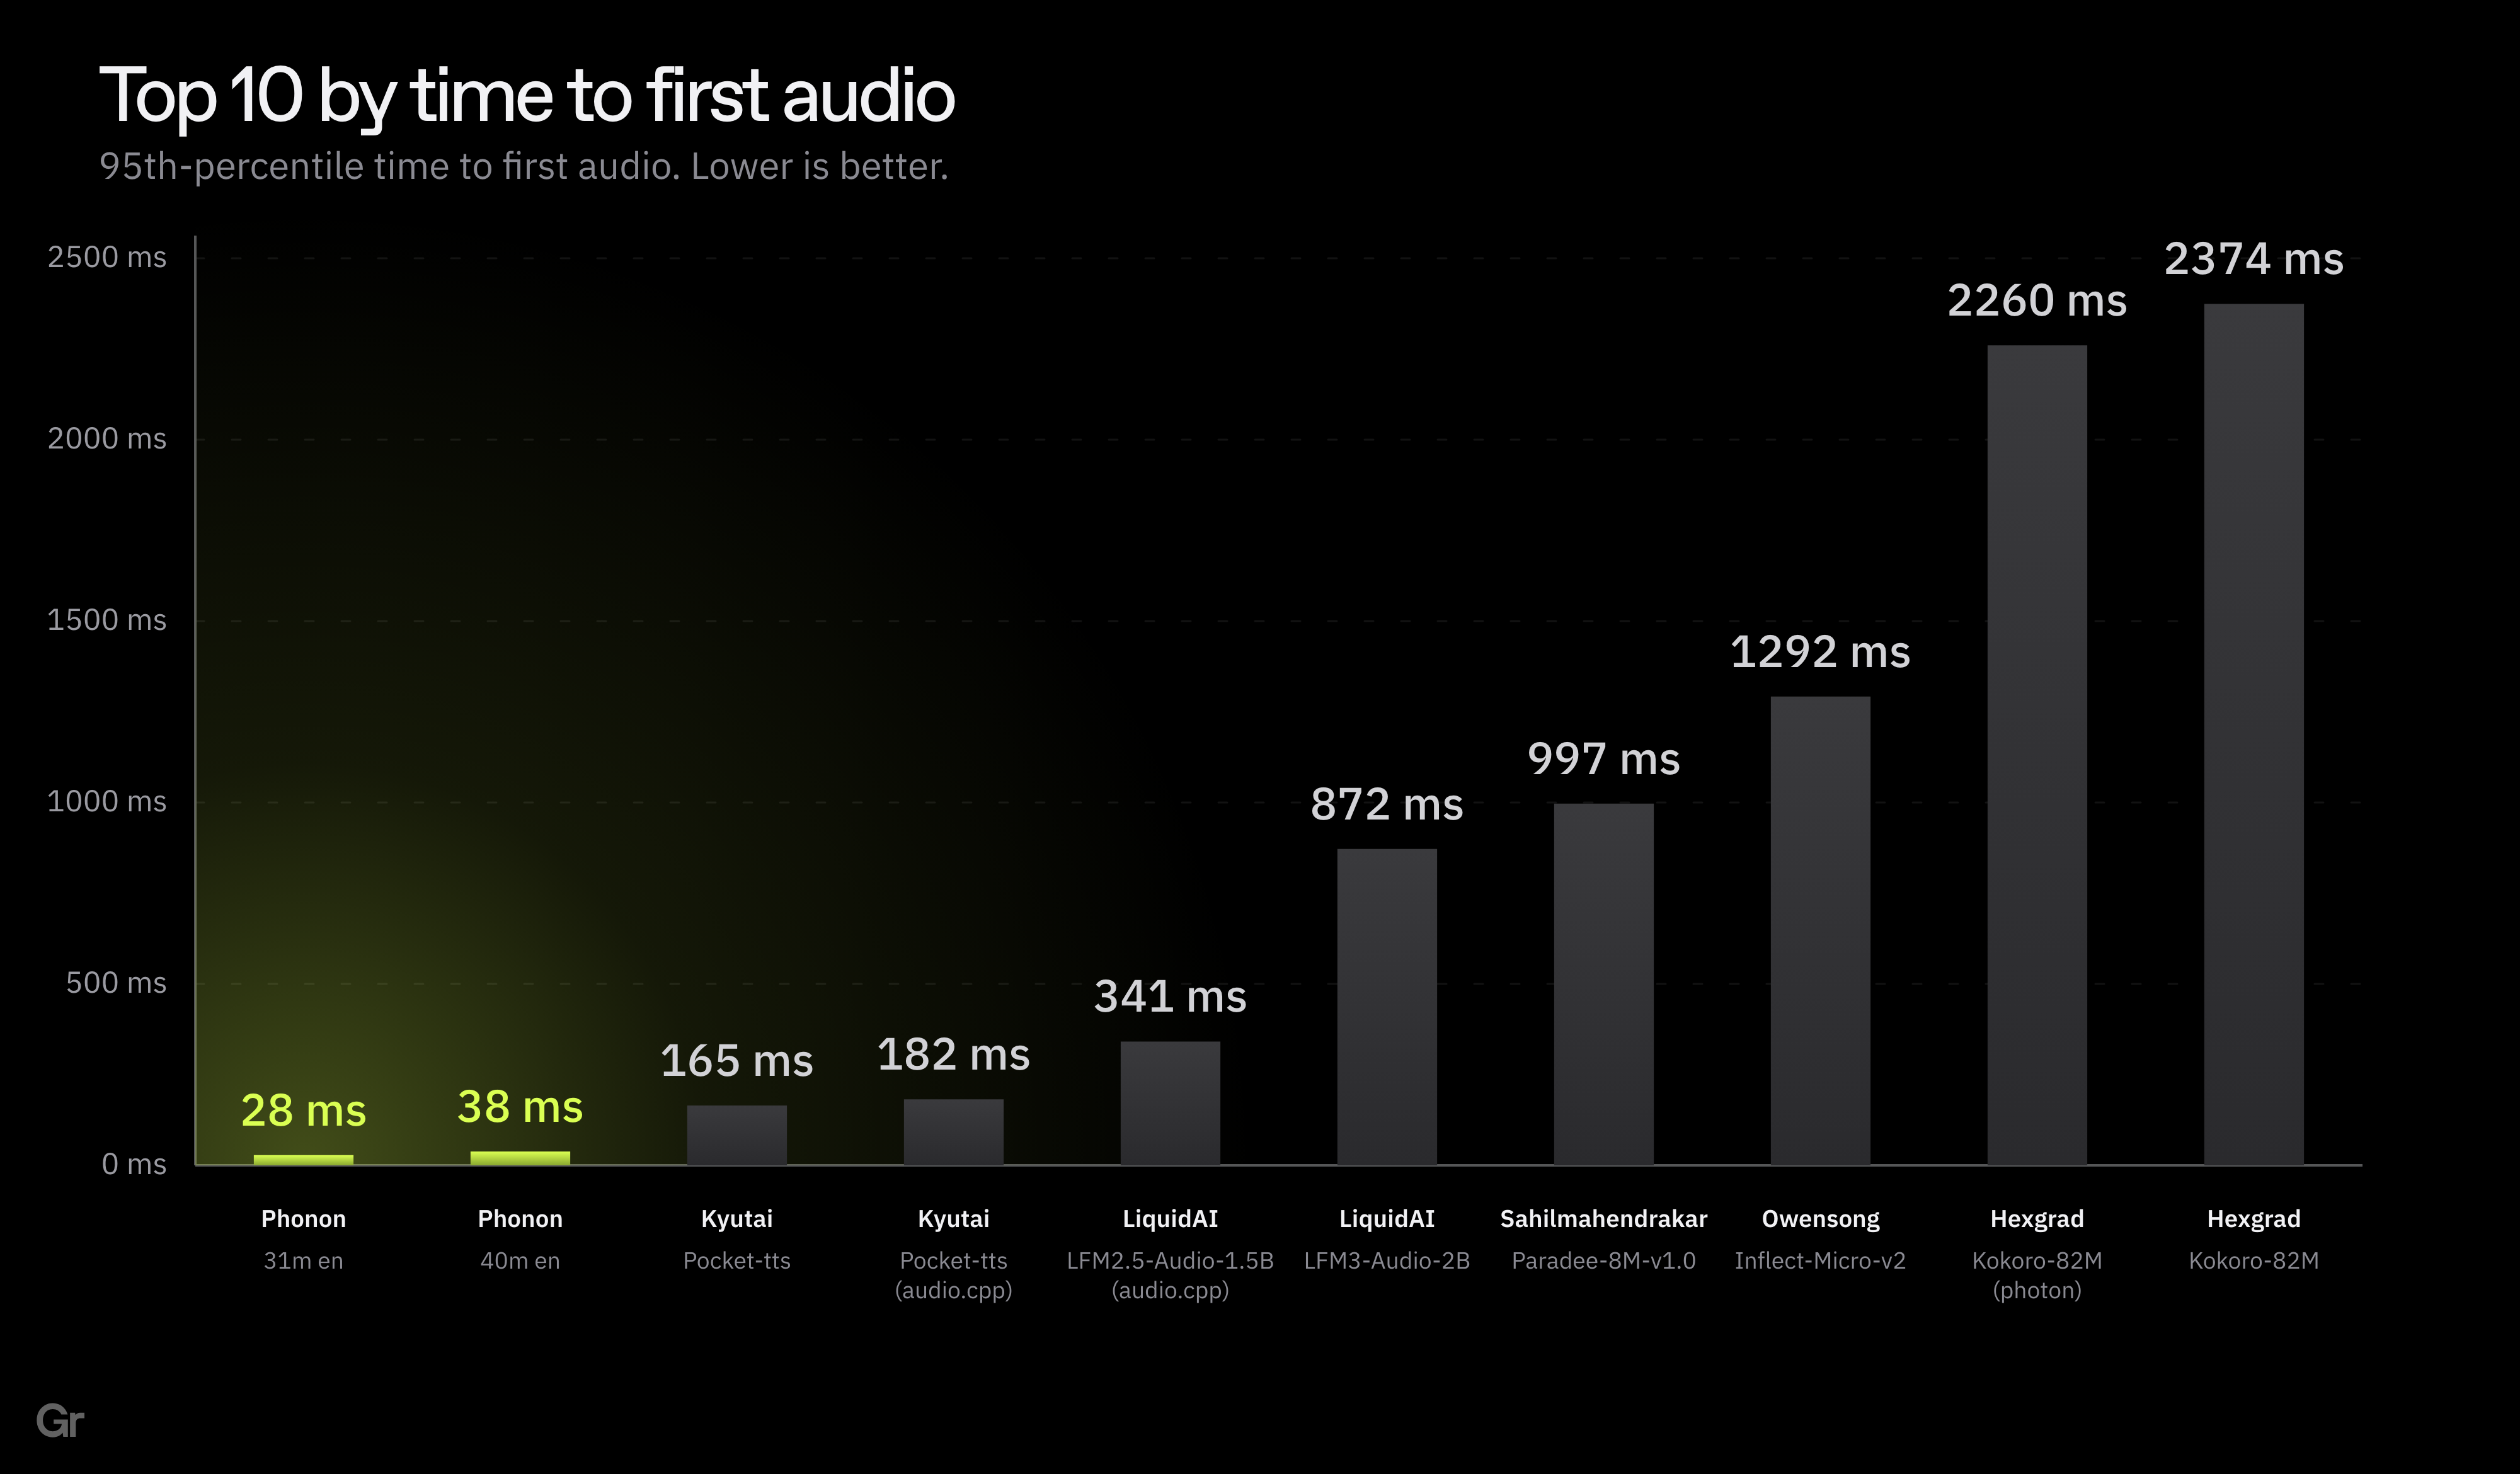
速度是我们看到 Phonon 真正闪耀的地方,这些模型在首音频时间上位居CPU 流式基准测试榜首。
推理
我们专门为 Phonon 构建了一个新的推理框架 ptts。ptts 的目标是在各种设备上获得最佳性能,因此支持 10 多种后端:CPU(Intel、Arm、WebAssembly)、GPU(CUDA、Vulkan、Metal、WebGPU)和 NPU(Apple Core ML、Snapdragon®)。
Phonon 也从 v5.21 起在 🤗 Transformers 中可用,作为其参考 PyTorch 实现。其中 ptts 在设备上运行单流,而 Transformers 面向 GPU 吞吐量:批量生成、全图 torch.compile,例如用于大规模合成语音数据集。作为原生 PyTorch,它是构建的基础,无论是将 Phonon 集成到你自己的技术栈中,还是研究模型本身。
它属于 Pocket TTS 谱系,所以我们首先将 Pocket TTS 添加到 Transformers。Phonon 作为模块化模型位于其上:约200 行代码仅描述不同之处。
Phonon 以自回归方式生成音频潜变量:每一步输出一个潜变量,并将其作为下一步的输入反馈回去,训练损失即在这些潜变量上计算。潜变量是模型的输入、输出和目标,正如文本 token 之于语言模型,因此将音频映射为潜变量的编解码器扮演了分词器的角色。Transformers 正是这样提供的:一个音频分词器,由处理器与文本分词器并列持有:
from transformers import AutoProcessor, GradiumPhononTTSForConditionalGeneration

model_id = "gradium/phonon-31m-en"
processor = AutoProcessor.from_pretrained(model_id, device_map="auto")
model = GradiumPhononTTSForConditionalGeneration.from_pretrained(model_id, device_map="auto")

print(f"{model.num_parameters():,}")  # 30,788,354
print(f"{processor.audio_tokenizer.num_parameters():,}")  # 10,305,313
声音不是一段录音,而是一个说话人潜变量张量。Phonon 从不直接用其音频分词器编码音频,该分词器仅提供解码器,声音是预先计算好的:gradium/phonon-voices。
from huggingface_hub import hf_hub_download
from safetensors.torch import load_file

path = hf_hub_download("gradium/phonon-voices", "voices/LMDIYE0Oa377Qh6Z.safetensors")
voice = load_file(path)["speaker_wavs"][0].T  # (num_frames, 512)
提示布局(声音位置、文本,然后是一个开启音频的 token)随检查点一起作为聊天模板提供,与 Transformers 中其他多模态模型一样。你编写标准对话,在声音所在位置放一个空的 audio 项,你的代码在不同检查点之间保持不变。然后处理器将声音占位符扩展为每帧一个位置,对文本进行归一化和分词,并对输入进行批处理:
conversation = [
    {"role": "user", "content": [{"type": "audio"}, {"type": "text", "text": "Hello from Phonon."}]}
]
inputs = processor.apply_chat_template(
    conversation,
    tokenize=True,
    return_dict=True,
    add_generation_prompt=True,
    processor_kwargs={"audio_prompt_latents": [voice]},
).to(model.device)
# prompt: <|audio_prompt|> × num_frames, "Hello from Phonon.", <|audio_bos|>
generate 返回潜变量,处理器将其解码为音频:
outputs = model.generate(**inputs)  # audio_latents: (batch_size, num_frames, 32)
audio = processor.decode(outputs.audio_latents, outputs.audio_latents_mask)
processor.save_audio(audio, "phonon.wav")
更多内容请参阅文档 🤗!
下一步
Phonon 可以用任何声音说话。在说话人同意的情况下,从一段短录音中克隆一个声音,或在 Gradium Studio 中用纯文本描述一个新声音。然后下载声音文件,在 Phonon 中加载,它便完全在设备上运行。
我们还与设计合作伙伴一起训练自定义 Phonon 模型。如果你的内存预算紧张,我们可以把模型做得更小。如果你需要韩语、阿拉伯语或日语,我们也可以为此训练。如果你的产品有自己的词汇,我们可以对其进行微调。联系我们,告诉我们你的需求。
感谢 Hugging Face 团队,也感谢在最初两周内试用 Phonon 的每一个人。
Phonon 是我们的首个开源发布。试用一下,告诉我们你构建了什么。