昨天是 Grok 4.7(鹈鹕)和 MiMo v2.6 Flash/Pro(更多鹈鹕)。今天 Anthropic 发布了 Claude Opus 5.5,大约一小时后,OpenAI 发布了 GPT-6 Sol 和 GPT-6 Luna。要对这些新模型形成准确的判断还需要一段时间,不过以下是我目前的印象。
GPT-6 Sol 和 Luna 的价格是对应 GPT-5.6 型号的一半 #
GPT-5.6 Luna 本来就是我构建应用时最喜欢的模型,因为它兼具出色的性能和极低的价格。不知怎么的,GPT-6 Luna 的价格又只有它的一半,而 GPT-6 Sol 相比 GPT-5.6 Sol 也有类似幅度的降价。
今天的价格格局如下:
| 模型 | 输入 | 缓存输入 | 输出 |
|---|---|---|---|
| GPT-6 Luna | $0.10/M | $0.01/M | $0.50/M |
| GPT-5.6 Luna | $0.20/M | $0.02/M | $1.20/M |
| Grok 4.7 | $2/M | $0.50/M | $6/M |
| GPT-6 Sol | $2/M | $0.20/M | $10/M |
| GPT-5.6 Terra | $2/M | $0.20/M | $12/M |
| Claude Opus 5.5 | $4/M | $0.20/M | $20/M |
| GPT-5.6 Sol | $4/M | $0.40/M | $20/M |
| Claude Fable 5.1 | $10/M | $0.25/M | $50/M |
| GPT-6 Astra | $10/M | $1/M | $50/M |
请注意,GPT-5.6 计划在 11 月涨价 25%,因此 GPT-6 的价格是这些模型促销价的一半。
(既然 GPT-5.6 Terra 与 GPT-6 Sol 定价相同,选择 Terra 的剩余理由也就烟消云散了。)
这个定价的竞争力怎么强调都不为过。Grok 4.7 当初定价为 $2/$6,不到 GPT-5.6 Sol 价格的一半,但现在在输入价格上与 GPT-6 Sol 持平,在输出价格上也已相差无几。
GPT-6 Luna 的价格为 $0.10/$0.50,是 OpenAI 发布过的最便宜的模型之一,只有弱得多的 GPT-4.1 Nano($0.10/$0.40,2025 年 4 月)和 GPT-5 Nano($0.05/$0.40,2025 年 8 月)比它更便宜。
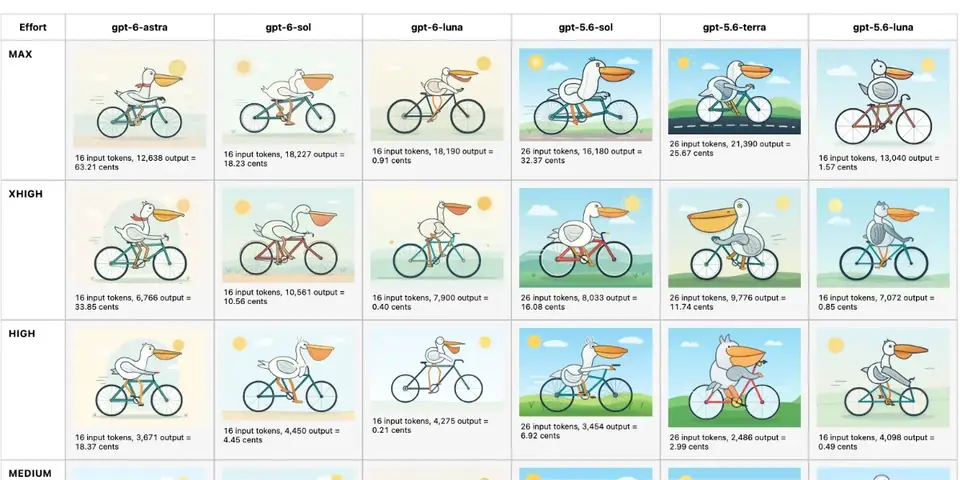
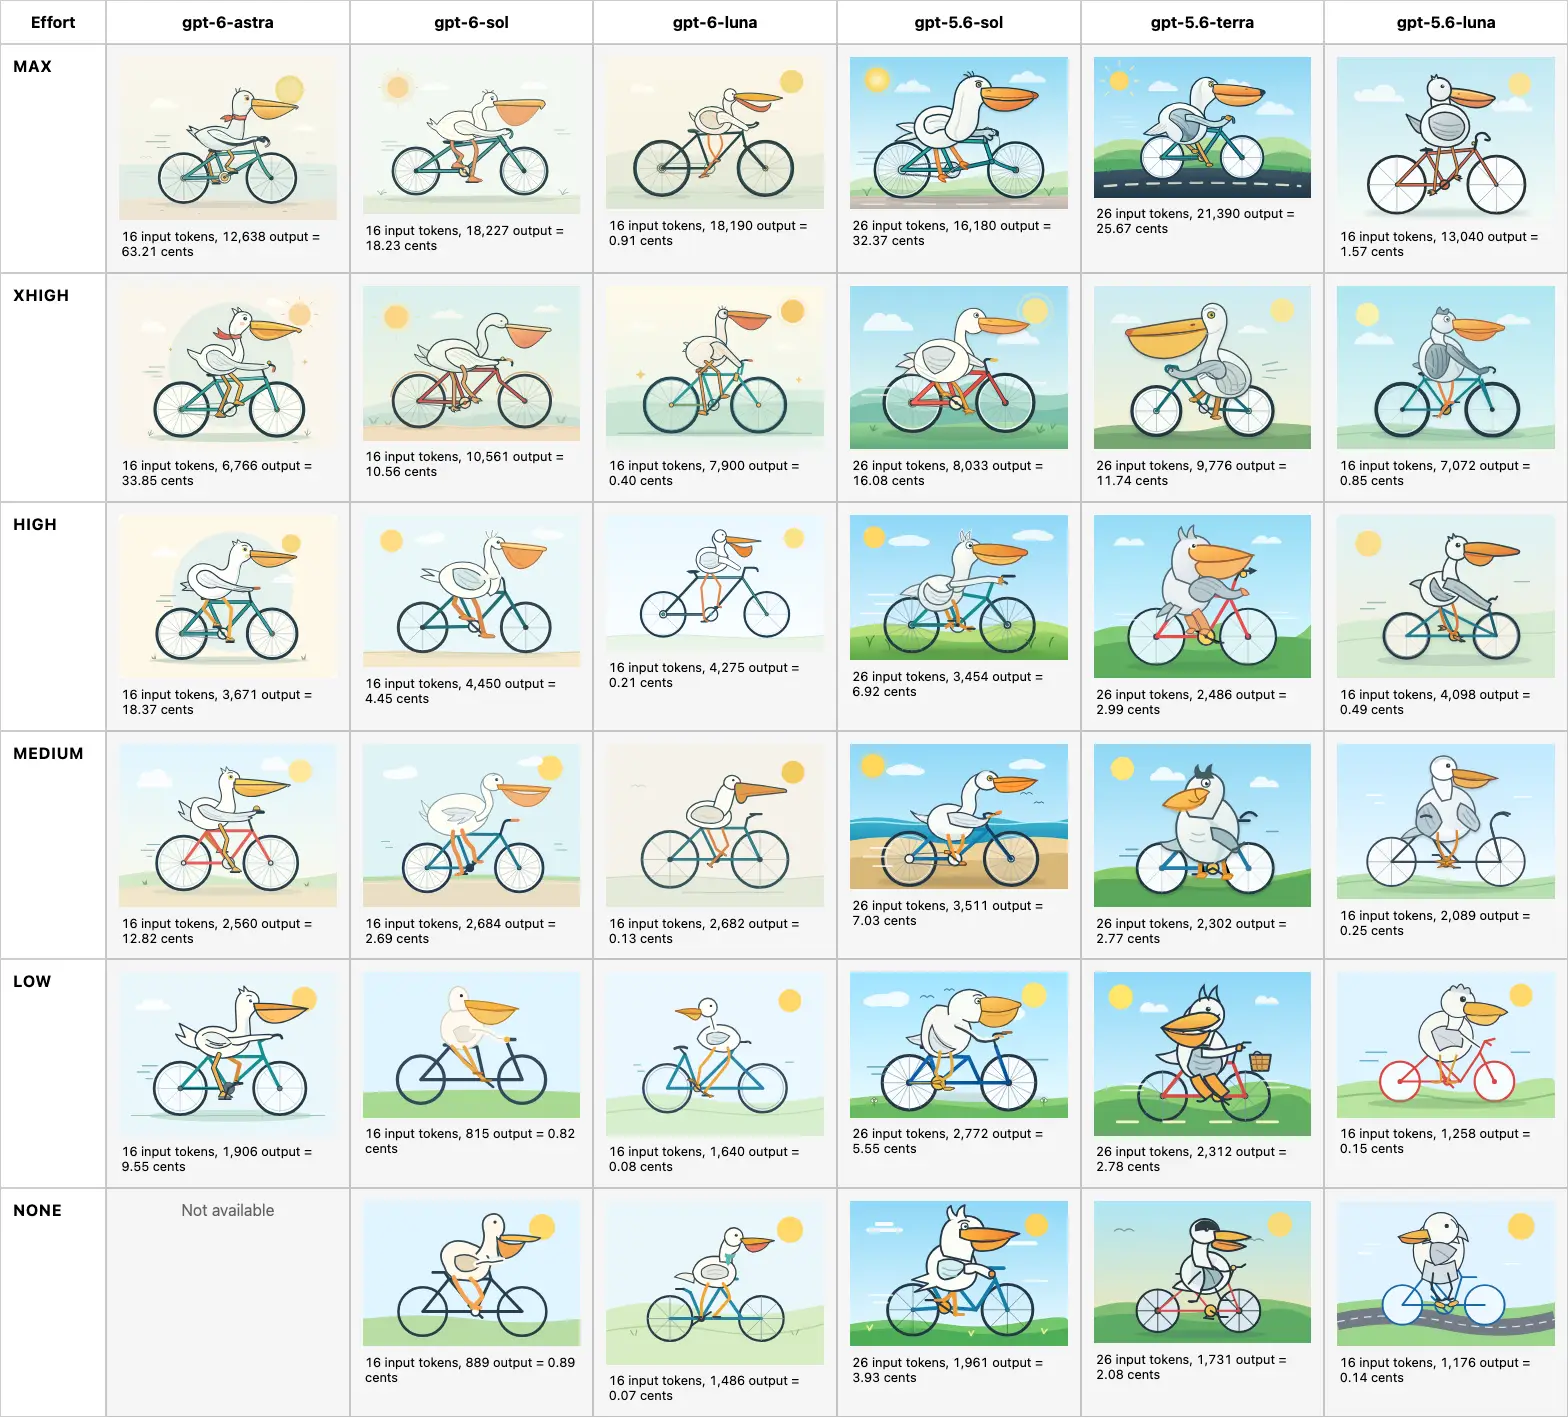
我为 GPT-6 Luna 和 GPT-6 Sol 分别渲染了鹈鹕,然后把它们连同 GPT-5.6 的鹈鹕一起放进了这张对比网格。我喜欢这张图让你一眼就能看出:5.6 系列选用了更大胆、更鲜艳的颜色,而 6 系列则柔和得多。我仍然认为,GPT-6 Astra 在 max 档位下画出了最好的鹈鹕。
Claude Opus 5.5 也降价了 #
Opus 5.5 看起来解决了人们对 Opus 在沟通风格上最大的抱怨。Thariq Shihipar 说:
Opus 5.5 是你们反馈的成果。
它表达清晰,每个 token 的价格比 Opus 5.0 更低,同时拥有 Fable 5.1 的智能,token 利用效率很高,并且在每一档思考强度下都能正常工作。
它还号称更擅长 Blender。我期待在这方面好好试一试它。
Opus 4.5、4.6、4.7、4.8 和 5 的价格都一样:输入每百万 token $5,输出每百万 $25。5.5 降价 20%,为每百万 $4 和 $20。
缓存读取的价格下降了 60%。这对较长的智能体对话意义重大,因为在这类对话中,90% 以上的输入 token 都按缓存 token 的价格处理。
Opus 5.5 的新价格与 GPT-5.6 Sol 的价格相同,但那是在 OpenAI 把 Sol 价格砍半之前。
GPT-6 Astra 和 Claude Fable 5.1 的定价都是每百万输入 $10、每百万输出 $50。目前这场价格战波及的是其下一档的模型。
Anthropic 表示 Sonnet 5.5 和 Haiku 5.5 即将推出。目前的 Haiku 4.5 定价为 $1/$5,而最新的 GPT-6 Luna 只有它的十分之一,即 $0.10/$0.50,不知道 Haiku 能否在低端市场重新夺回价格竞争力,这会很有意思。
Claude Opus 5.5 在 max 档位下想得太多,以致崩溃 #
在我的“生成一幅鹈鹕骑自行车的 SVG”测试中,这是头一回:Claude Opus 5.5 在“max”思考档位下没能返回任何结果!
它一开始称这是“一个经典的测试请求”,然后对自己正在做的事情想得非常非常用力:
这是一个经典的测试请求,所以我想规划出一只构图良好的鹈鹕,带着它标志性的喙和下颌囊,骑在一辆有合适的车轮、车架和踏板的自行车上,背景是简单的天空和地面。[...]
验证小腿长度,大约是 95.2,足够接近了。现在我在推算近侧腿从髋到膝再到踝的路径,然后勾勒踩在踏板上的脚的形状——用直线和曲线构成的路径勾出脚跟、脚尖和脚底轮廓,使其自然地贴合踏板表面,大约在 y=478-494 处。[...]
我喜欢鱼从篮子里醒目地探出来、鹈鹕盯着它的样子,这是值得保留的有趣细节。我还在确认眼睛位于喙根附近的位置符合典型的鹈鹕解剖结构,并考虑给它一个稍微更开心的表情。[...]
远侧的腿看起来确实是从车架后面穿过,所以我接着检查链环的齿,确认图层顺序——远侧的曲柄臂应该大部分被座管和链环挡住。我正在为最终的 SVG 确定宽度和高度属性以及 viewBox,以确保缩放正确,同时注意到其中没有文字,因此不需要 font-family。[...]
我看到这只鹈鹕时非常兴奋……但随后它停住了。Opus 5.5 的最大输出上限是 128,000 个 token(其他 Claude 模型也一样),而它在还在为这个 SVG 推理的时候就撞到了上限!
我又试了第二次,结果相同。这让我怀疑“max”实际上毫无用处:如果它在一个愚蠢的 SVG 提示词上都会想到崩溃,那我不敢相信它在更有意义的工作上不会同样如此。
(这两次失败各花了我 $2.56,耗时将近 20 分钟。)
Fable 5.1 在“max”档位下没有想得过多,并且给了我在 Anthropic 任何模型中见过的最好的鹈鹕。
这是 Opus 5.5 的鹈鹕,不含 5.5 max。
我还做了这张对比网格,把它们与 Opus 5、Fable 5.1 和 Sonnet 5 的鹈鹕放在一起比较:
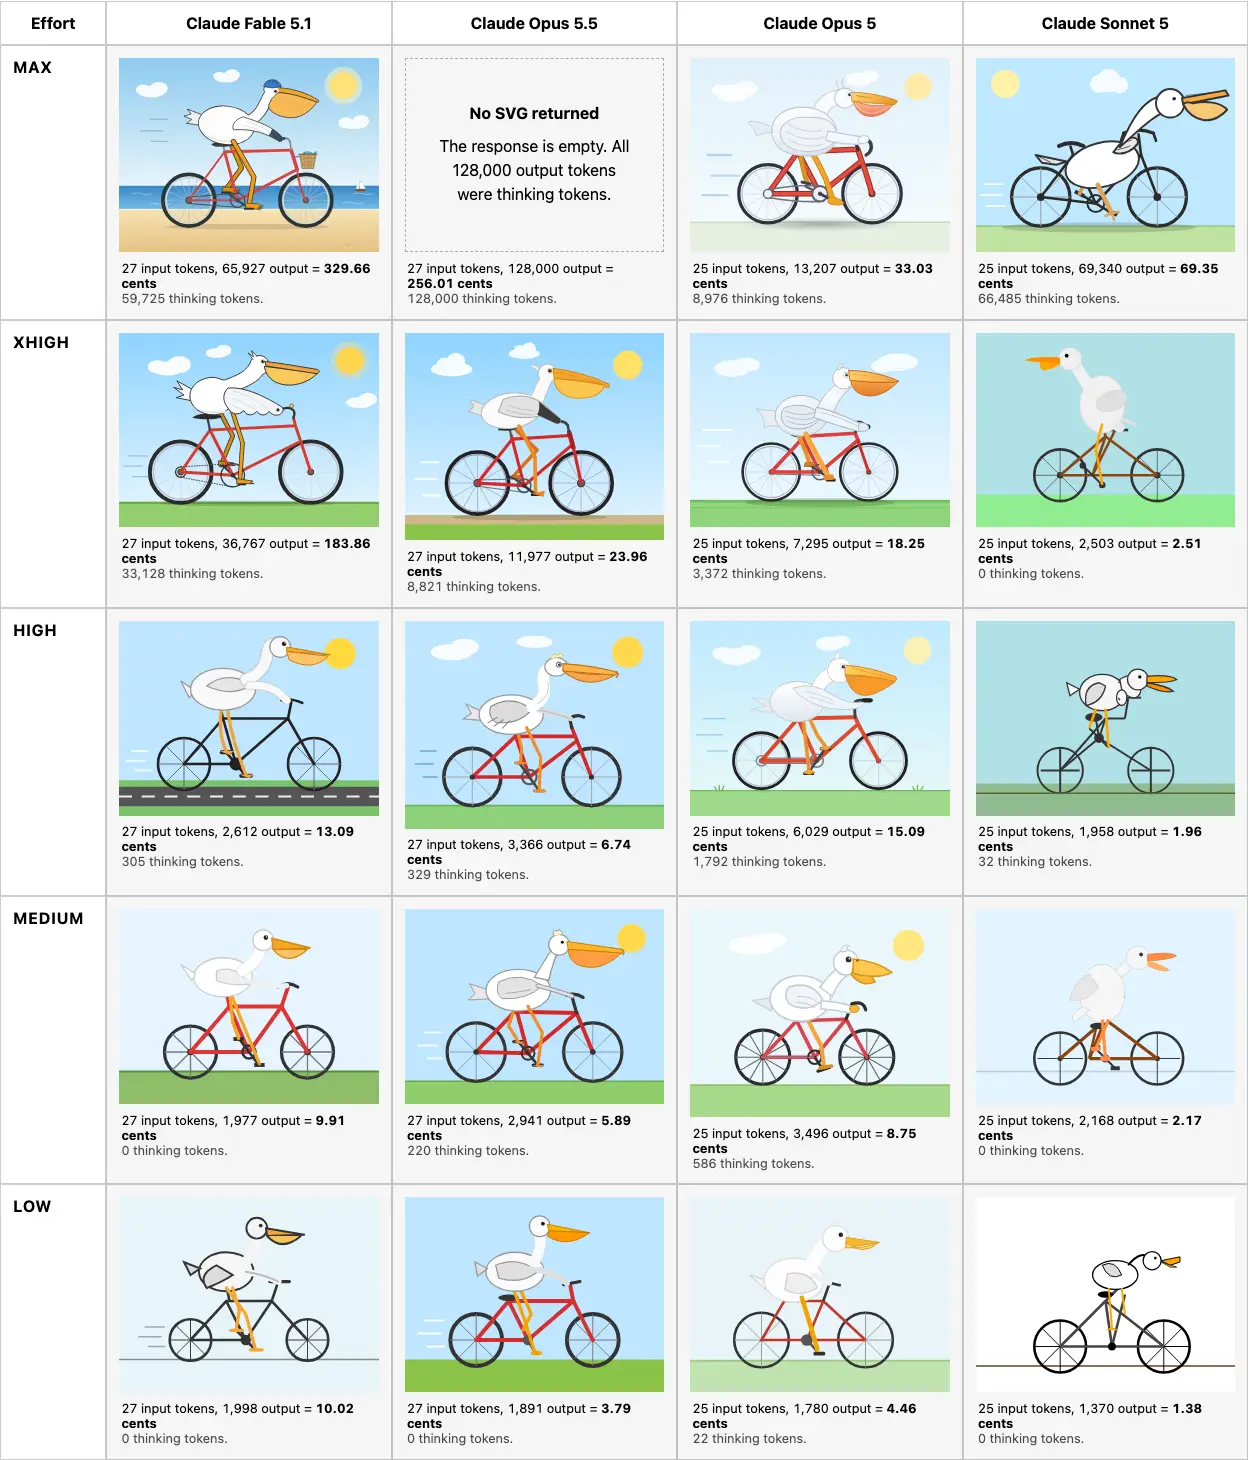
用画鹈鹕骑自行车的水平来比较不同的模型厂商,现在也许没什么意义(如果它曾经有意义的话),但我仍然发现,用它来比较同一模型家族在不同推理档位下的表现是有价值的。
我现在在 Codex 和 Claude Code 中使用 GPT-6 Sol 和 Claude Opus 5.5 作为默认模型。我已把 agent.datasette.io 上的 Datasette Agent 演示升级为使用 GPT-6 Luna,它在编写 SQL 查询以及为 Datasette Apps 构建 HTML 和 JavaScript 方面,看起来既快又胜任。