Introducing Kimi K3.1 Pro(via)Kimi K3.1 Pro 今天上线 Kimi API——它尚未开放权重,但 Moonshot 承诺“完整模型权重将于 2026 年 11 月 4 日前发布”。
他们还提供了一个“Highspeed”版本,速度快 2-3 倍,价格是两倍(输入 token 缓存命中除外,其定价相同)。
美元定价为输入每百万 token 2.00 美元、输出每百万 token 10 美元——与 GPT-6.1 Sol 相同,是 Claude Opus 5.5 价格的一半。
Moonshot 自己的基准测试显示,Kimi 大致与 Opus 5.5 和 GPT-6 Astra 持平——在少数基准测试上超过它们,在其他方面则接近。
Artificial Analysis 给 Kimi 打了 55 分——领先于 Claude Fable 5.1、GPT-6 Astra 和 Gemini 4 Argon(均为 53 分),仅次于 Claude Opus 5.5(58 分)。
这是(即将)开放权重的模型首次在前沿模型对比中取得如此高的分数。
我通过 Moonshot API 试用了它,使用的是我八月份添加到 LLM 0.32 中的 llm openai endpoint 命令:
llm openai endpoint \
  https://api.moonshot.ai/v1 \
  --key kimi \
  -m kimi-k3.1-pro \
  "Generate an SVG of a pelican riding a bicycle" \
  --responses \
  -o reasoning_effort low \
  > kimi-k3.1-pro-pelican-low.stdout.txt \
  2> kimi-k3.1-pro-pelican-low.stderr.txt
llm openai endpoint 可以对任何兼容 OpenAI 的端点运行提示词,但不会记录结果,因此需要额外的选项来保存 stdout 和 stderr(推理轨迹)。
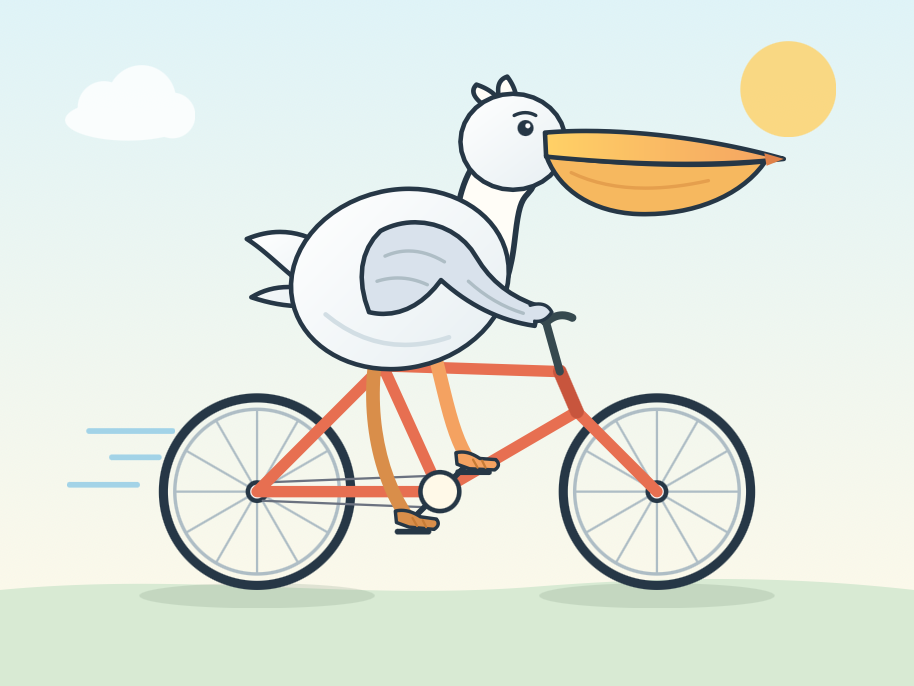
以下是我在 Kimi K3.1 Pro 支持的三个推理级别——低、中、最高——上得到的鹈鹕。这是最高级别:
作为对比,我在那三个推理级别上重新运行了针对 Kimi K3 的鹈鹕测试。