为新 GPU 硬件(如 NVIDIA Vera Rubin)配置和优化 Kubernetes 既复杂又容易出错。驱动程序、内核、运行时、网络、Operator 和调度器必须协同工作,并且设置要针对硬件和工作负载进行调优。细微的不匹配就可能导致工作负载无法运行或限制性能。
NVIDIA AI Cluster Runtime (AICR) 是 NVIDIA DSX AI Factory Platform 的一部分,它通过将调优后的配置记录在可复用的 recipe 中、为现有部署工具生成 bundle,并验证运行中的集群,简化了这项工作。它将帮助 Kubernetes 环境在第一天就为 NVIDIA Vera Rubin NVL72 计算托盘做好准备。
总体而言,NVIDIA DSX AI Factory Platform 汇集了多种技术,帮助生态系统设计、构建和运营更高效的 AI 工厂,其中包括专为支持多租户运营和扩展而构建的开源、模块化软件组件。
在云原生栈中配置新的硬件架构,需要从最底层的绑定一直到编排层进行管道式更新。对 Vera Rubin 而言,现在仍处于早期阶段。
本文介绍如果你今天运行 NVIDIA GB200 NVL72,会有哪些变化;以及在使用 NVIDIA GPU Operator 和支持 Vera Rubin 的动态资源分配(DRA)驱动程序的早期硬件访问中,已经验证了哪些内容。文章还展示了 AICR 如何将这些组件整合到一个平台团队可以复现和验证的配置中。
与 GB200 NVL72 相比有哪些变化:规划你的升级
如果你今天运行 GB200 NVL72,NVIDIA Vera Rubin NVL72 是同一 NVIDIA MGX 机架级架构的演进,现在已是第三代。但有几个用户可见的部分发生了变化。现在了解这些变化,可以让你在即将发布的版本中同步规划集群软件和配置的变更:
- GPU 驱动程序:Vera Rubin NVL72 需要新的驱动程序分支。它已使用 R615.23(主机安装的 R615.23 开源 GPU 驱动程序)进行验证。早期支持的目标是 R610,官方平台支持在 R620。AICR 的 GB200 基线是 R580.173.02。R615.23 是当前测试过的版本,并非官方 Vera Rubin 支持的已确认最低版本。
- DOCA 和 NIC 驱动程序:Vera Rubin NVL72 将 GB200 NVL72 参考设计中的 NVIDIA ConnectX-7 NIC 和 NVIDIA BlueField-3 数据处理单元(DPU)替换为 NVIDIA ConnectX-9 SuperNIC 和 NVIDIA BlueField-4 DPU。DOCA 3.3.0 是首个支持 ConnectX-9 的 GA 版本。经验证的 Vera Rubin 系统镜像附带 DOCA-OFED 3.3.0。这是测试平台版本,不是要求或建议。AICR 在此使用主机安装的 NIC 驱动程序和 DRANET 进行 Pod 分配。Network Operator 兼容性仍是单独的资格验证步骤(参见 DOCA 3.3.0 发行说明)。
- 设备拓扑:Vera Rubin NVL72 计算托盘的 NIC/GPU/直接内存访问(DMA)拓扑与 GB200 不同,因此对于远程直接内存访问(RDMA)网络和 GPUDirect Storage 等 I/O 密集型工作负载,必须检查 GPU 到 NIC 的亲和性和 NUMA 放置。两个参考托盘都包含两个 CPU 和四个 GPU,但 Vera Rubin NVL72 托盘暴露八个 ConnectX-9 PCI 设备组、共 32 个功能,而 NVIDIA DGX GB200 NVL72 计算托盘上只有四个 ConnectX-7 适配器。在 GB200 NVL72 和 Vera Rubin NVL72 托盘中,GPU 0 到 1 的 CPU NUMA 亲和性为 0;GPU 2 到 3 的亲和性为 1。GPU 到 NIC 的连接在插槽内为
NODE,跨插槽为SYS。PCI 功能数量不代表物理端口数量(参见 GB200 参考架构)。 - IMEX:与 GB200 NVL72 一样,多节点 NVIDIA NVLink 工作负载使用 IMEX。使用 DRA 管理的 IMEX 时,请停止、禁用并屏蔽主机的静态
nvidia-imex服务,以防止所有权冲突。DRA v0.5.0 新增了一个仅支持域隔离的 alpha 主机管理选项;我们的集群使用driverManaged模式。(参见发行说明) - NVIDIA 多实例 GPU(MIG)配置文件:Rubin GPU 引入了新的 MIG 配置文件。R615.23 在节点上通告这些配置文件。AICR 的 Vera Rubin recipe 使用整 GPU 分配,不配置 MIG。本次验证不涵盖 Vera Rubin 上的 MIG。
- AICR recipe:所有这些差异都编码在新的 Vera Rubin recipe 系列中,因此
aicr recipe和aicr validate反映的是经验证的组合,而不是让你自己去重新发现每一项变更(详情见后续章节)。
在 Vera Rubin NVL72 上的验证
为了端到端验证 Vera Rubin NVL72 支持,我们使用官方 GPU Operator v26.7.0 版本和官方 DRA 驱动程序 v0.5.0 版本,以及主机安装的 R615 驱动程序,在 Vera Rubin 集群上部署了 AICR 运行时 bundle。
训练和推理两种 recipe 变体现在都能端到端通过部署和一致性验证。对于训练,有一个初始性能门槛:通过 IMEX ComputeDomain 在 NVIDIA NVLink 网络上运行跨节点 NCCL all-reduce,并以总线带宽下限作为门槛。GPU Pod 运行正常,IMEX 通道被注入到跨多个节点的申领 Pod 中,如下方真实集群输出所示。
关于早期芯片现实的说明:让新芯片跑起来是一个过程。最初的几轮验证曾因某个早期 Vera Rubin 集群中的硬件/网络结构问题而暂时受阻——该问题与 GPU Operator 或 DRA 驱动程序无关——导致一个计算托盘无法加入 NVLink 网络。在重新插拔硬件后,两个节点上的所有 GPU 都加入了同一个干净的网络结构 clique。
从启动到可复现的 recipe
验证组件只是故事的一半。搭建一个可用的 Vera Rubin 集群意味着选择驱动程序模式、容器运行时接线、组件版本以及一些平台特定的设置。AICR 将这些选择记录为带版本的 recipe,因此真实 Vera Rubin 硬件上的配置是明确的、可复现的,并且可以跨集群验证。
新的 Vera Rubin recipe 系列(service: rke2;accelerator: Vera Rubin NVL72 (vr200);操作系统:Ubuntu;包含训练、推理和 NVIDIA Dynamo 推理变体)以 Preview 形式发布。这是一条早期采用者路径,在平台本身仍处于预发布阶段时,尚不具备 Supported recipe 的生产支持和生命周期认证。它固化了本次启动过程中做出的决策:
- 主机管理的驱动:Vera Rubin 系统镜像预装了 arm64 开放内核模块驱动,因此该 recipe 以
driver.enabled: false运行 GPU Operator,而容器工具链仍由 operator 管理。当官方构建发布后,该 recipe 将切换到 operator 管理的驱动。 - 带 ComputeDomains 的 DRA 驱动:为 NVL72 网络结构启用了由 IMEX 支持的 ComputeDomains,整 GPU 分配仍保留在设备插件上。
- 平台下限与特殊之处:它们被一次性固化下来,以免用户重新发现。Kubernetes >= 1.34.1——1.34 是为了 ComputeDomains/IMEX 所使用的 GA 版 resource.k8s.io/v1 DRA API,而 .1 补丁是因为 RKE2 CDI/NRI 工具链路径需要 containerd 2.1(v1.34.1+rke2r1)。Ubuntu 26.04 搭配针对 Vera 优化的 arm64 64k 页内核。还有一些更小的尖锐问题,例如提高 NFD 拓扑更新器默认的 60Mi 内存限制,该限制在多 TB 的 NVL72 工作节点上会因内存不足(OOM)而被杀死。
该 bundle 的首次部署针对的是一个这些组件从未一起验证过的平台组合——arm64、Ubuntu 26.04、64k 页内核、RKE2 和 Vera Rubin——并在数小时内从集群交接推进到健康的运行时。第二天,第二个 Vera Rubin 集群复现了该结果,而这种可重复性正是该 recipe 的意义和优势所在。
在运行中的 Vera Rubin 集群上的工作流
为使其具体化,以下是实际的 AICR 工作流,在运行中的 Vera Rubin NVL72 参考集群上使用 AICR v1.0.0 工具链执行。
1. 生成 recipe
recipe 生成是离线的:它根据 recipe 目录解析条件,只需几秒钟。
$ aicr recipe \
    --service rke2 \
    --accelerator vr200 \
    --os ubuntu \
    --intent training \
    -o recipe.yaml

[cli] building recipe from criteria: criteria=criteria(service=rke2,
accelerator=vr200, intent=training, os=ubuntu)
[cli] recipe generation completed: output=recipe.yaml components=14
componentNames=cert-manager, dra-node-labeler, dranet, gpu-operator,
k8s-ephemeral-storage-metrics, kai-scheduler, kube-prometheus-stack, nfd,
nodewright-customizations, nodewright-operator, nvidia-dra-driver-gpu,
nvsentinel, prometheus-adapter, prometheus-operator-crds
overlays=5
解析后的 recipe 将五个 overlay 分层为 14 个组件。除了 GPU Operator(主机管理的驱动模式)和 DRA 驱动(启用 ComputeDomains)之外,它还启动了与该平台最相关的两个部分:DraNet,即为 pod 分配 ConnectX-9 设备的 DRA 网络驱动(通过 ConnectX-9 的 RDMA 数据路径性能不属于本次验证范围),以及通过 NodeWright 调优应用的独占 RDMA netns 模式。每个 pod 只能看到自己的主机通道适配器(HCA)。
AICR 还汇集了 NVIDIA DSX AI Factory Platform 的组件:NodeWright 通过其原生 vr200/rke2 配置文件应用节点调优,KAI Scheduler 提供工作负载调度,NVSentinel 监控运行时健康。Node Feature Discovery(NFD)和 Prometheus 栈完善了该 recipe,组件版本固定为在 Vera Rubin 硬件上验证过的配置。
2. 渲染部署 bundle
该 bundle 是一组有序的、按组件划分的 Helm chart,配有一个部署脚本:
$ aicr bundle -r recipe.yaml -o ./bundle
Files generated: 61

$ ls bundle
001-cert-manager               008-gpu-operator                 checksums.txt
002-dranet                     009-k8s-ephemeral-storage-...    deploy.sh
003-nfd                        010-kai-scheduler                README.md
004-nodewright-operator        011-nvidia-dra-driver-gpu        recipe.yaml
005-nodewright-customizations  012-nvsentinel
006-prometheus-operator-crds   013-prometheus-adapter
007-kube-prometheus-stack
3. 快照并验证
AICR 捕获集群的实际状态,对照该状态检查 recipe 的就绪约束,然后作为集群内作业运行其验证检查:
$ aicr snapshot --output snapshot.yaml
$ aicr validate -r recipe.yaml -s snapshot.yaml --phase deployment
[cli] readiness constraint passed: name=OS.release.VERSION_ID
expected=26.04 actual=26.04
[cli] readiness constraint passed: name=OS.sysctl./proc/sys/kernel/osrelease
expected=>= 7.0 actual=7.0.0-2008-nvidia-bos-64k
[cli] phase completed: phase=deployment status=passed validators=4 passed=4
$ aicr validate -r recipe.yaml -s snapshot.yaml --phase conformance
[cli] phase completed: phase=conformance status=passed validators=8 passed=8


$ aicr validate -r recipe.yaml -s snapshot.yaml --phase performance
[cli] phase completed: phase=performance status=passed validators=1 passed=1
性能阶段作为集群内作业运行 NVIDIA Collective Communications Library(NCCL)all-reduce 门禁:通过 IMEX ComputeDomain 在 NVLink 网络结构上进行跨节点 all-reduce,并对照 recipe 的总线带宽下限进行检查。rke2/vr200 组合已注册在验证器的适用性矩阵中,其运行时以嵌入式模板形式提供,因此验证器会自行配置 ComputeDomain 和 IMEX ResourceClaimTemplate——无需 operator 前置条件,也无需 recipe 提供的运行时。它从标准的 v1.0.0 版本运行。
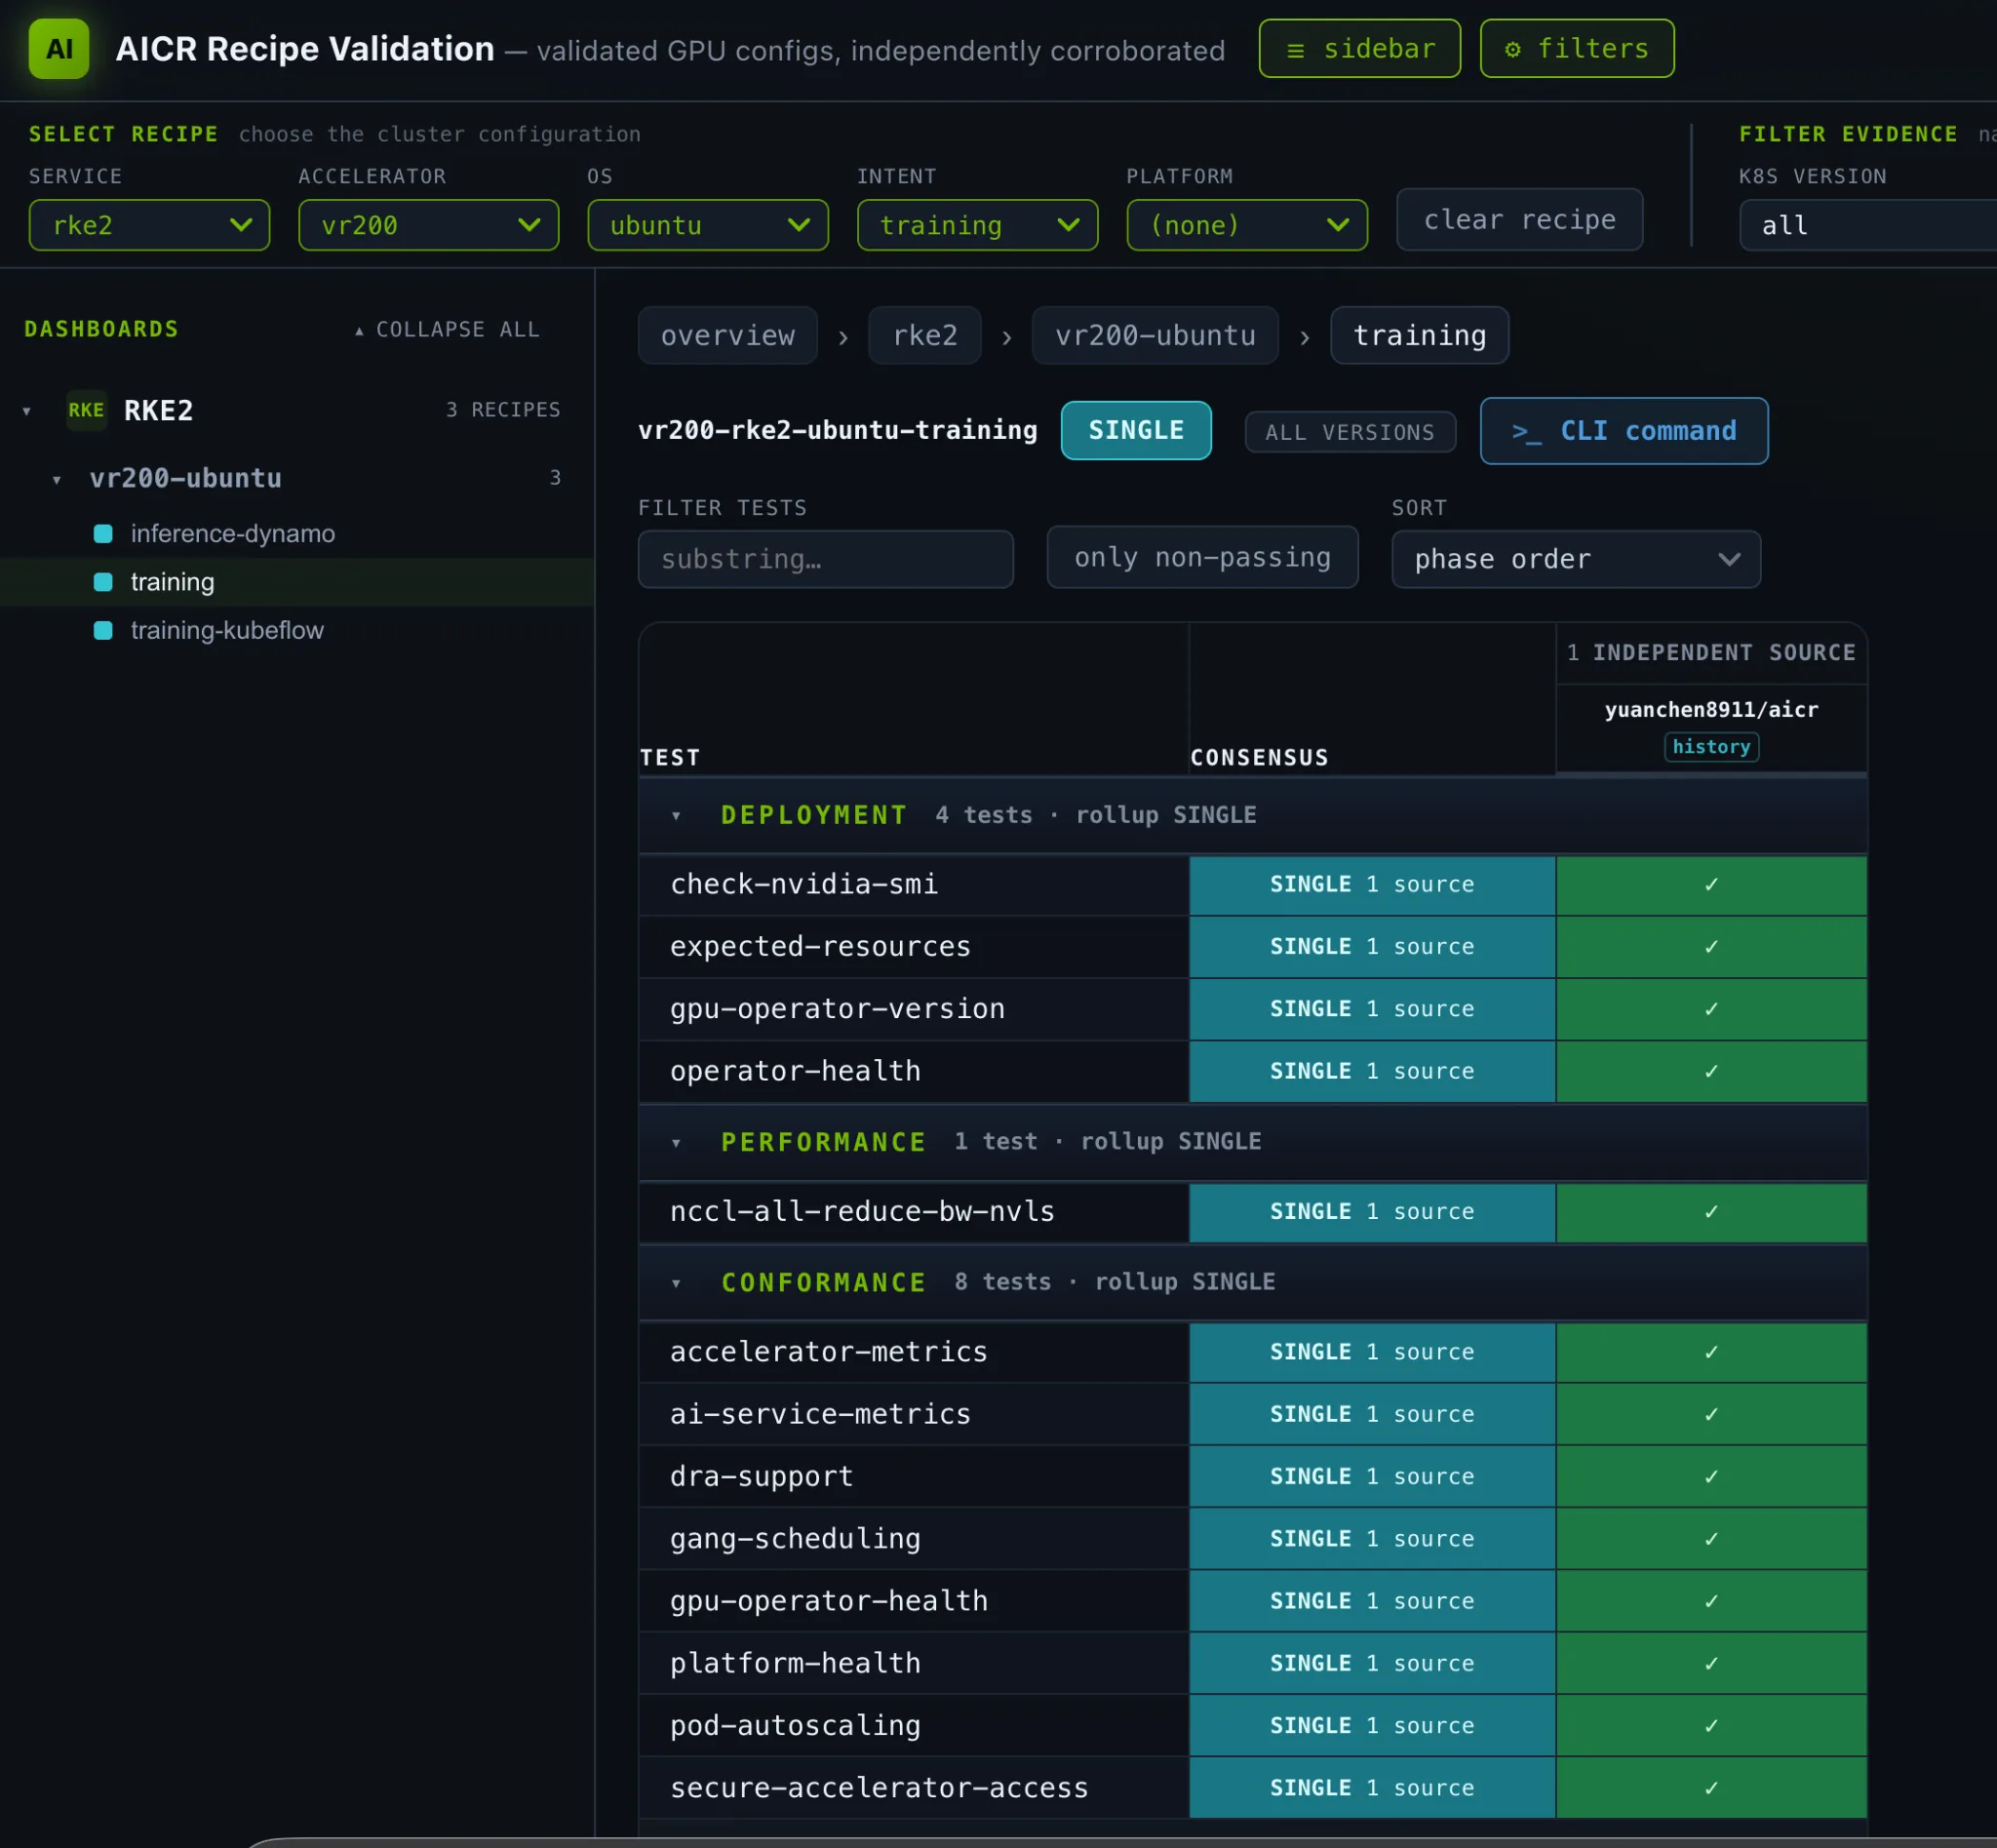
完整矩阵现已通过。
表 1. Vera Rubin NVL72 训练 recipe 的 AICR 验证结果:所有部署、一致性和性能检查均通过,包括在 Vera Rubin 芯片上的首个跨节点 NCCL all-reduce 性能门禁
| 阶段 | 检查 | 结果 | 处置 |
|---|---|---|---|
| 部署 | operator-health | 通过 | 所有组件健康。 |
| 部署 | gpu-operator-version | 通过 | 版本门禁已满足。 |
| 部署 | expected-resources | 通过 | 所有预期的 Kubernetes 资源均存在且健康。 |
| 部署 | check-nvidia-smi | 通过 | 所有节点上的 nvidia-smi 健康 |
| 一致性 | platform-health | 通过 | 所有平台检查通过。 |
| 一致性 | gpu-operator-health | 通过 | 所有 operator 组件健康。 |
| 一致性 | accelerator-metrics | 通过 | DCGM 指标路径已端到端验证,所有 GPU 均在上报。 |
| 一致性 | ai-service-metrics | 通过 | 自定义指标 API 正在提供服务。 |
| 一致性 | dra-support | 通过 | DRA/ComputeDomain 支持。 |
| 一致性 | gang-scheduling | 通过 | KAI gang-scheduling。 |
| 一致性 | pod-autoscaling | 通过 | External-metrics API 加上 HPA 扩容(1->3)和缩容(3->1)。 |
| 一致性 | secure-accelerator-access | 通过 | Device-plugin 模式(无 gpu.nvidia.com DeviceClass) |
| 性能 | nccl-all-reduce-bw-nvls | 通过 | 首次通过多节点 NVLink(IMEX ComputeDomain)在两个计算托盘之间完成跨节点 NCCL all-reduce:在 16 GiB 下总线带宽为 744.71 GB/s。 |
推理变体(Dynamo 平台、推理网关、gang-scheduling、DCGM 指标)在完全相同的集群上通过了相同的部署和一致性矩阵。
该次运行中有两个产物值得展示。首先,预发布驱动上的 nvidia-smi 横幅正是首次接触时触发验证器报错的那处确切变更。这是早期芯片带来小意外的一个好例子。该修复(NVIDIA/aicr#1748)已合并,并已在 NVIDIA Vera Rubin 硬件上验证。
$ nvidia-smi | head -3
+--------------------------------------------------------------------+
| NVIDIA-SMI 615.23    KMD Version: 615.23   CUDA UMD Version: 13.4  |
+--------------------------------------------------------------------+
其次,实时 GPU 遥测通过标准 DCGM exporter 路径传输。请注意占位的产品名称,一旦在接近正式发布时分配了 PCI ID,该名称就会确定:
DCGM_FI_DEV_SM_CLOCK{gpu="0",modelName="NVIDIA Graphics Device",
    DCGM_FI_DRIVER_VERSION="615.23"} 120
4. 跨节点 ComputeDomain 测试
最后,端到端地看 DRA/IMEX 路径:一个两节点 ComputeDomain,其 IMEX 通道由每个计算托盘上的 pod 申领。在使用主机托管 IMEX 的镜像上有一个前提条件:必须禁用并屏蔽主机上的静态 nvidia-imex 服务,因为主机托管 IMEX 与 DRA 托管的 ComputeDomain 互斥(DRA driver v0.5.0 增加了主机托管选项)。
GPU Operator v26.7.0+ 注意事项:该 chart 自带一份更严格的 resource.nvidia.com_computedomains.yaml 自定义资源定义(CRD)副本,其中要求 numNodes 且没有默认值(DRA driver chart 的副本则没有此要求)。这只在全新集群安装时才有影响——Helm 不会覆盖已安装的 CRD,因此升级 gpu-operator 的现有集群不受影响。如果你要搭建新集群,请在 ComputeDomain 清单中显式设置 numNodes,例如 spec: {numNodes: 2, …}。
$ kubectl apply -f cd-2node-test.yaml
computedomain.resource.nvidia.com/cd-2node-test created
pod/cd-test-c01 created
pod/cd-test-c02 created

$ kubectl get computedomain,resourceclaims,pods -n cd-test
NAME            STATUS   NODES
cd-2node-test   Ready    vr-...-c01,vr-...-c02

NAME                             STATE                AGE
cd-test-c01-imex-channel-k9j2d   allocated,reserved   32s
cd-test-c02-imex-channel-l6tl2   allocated,reserved   30s

NAME          READY   STATUS    NODE
cd-test-c01   1/1     Running   vr-...-c01
cd-test-c02   1/1     Running   vr-...-c02

$ kubectl logs cd-test-c01 -n cd-test   # identical output on c02
crw-rw-rw- 1 root root 505, 0 channel0  # /dev/nvidia-caps-imex-channels
从 apply 到两个 pod 运行起来——每个计算托盘一个,各自注入 IMEX 通道,且 IMEX 守护进程加入同一个域——大约需要 12 秒。训练 recipe 的 NCCL 性能门禁现在在真实工作负载流量下驱动的正是同一条 ComputeDomain 路径:通道注入已在上文得到验证,而 fabric 带宽则在性能阶段得到验证。
整个序列(recipe、bundle、snapshot,以及部署和一致性验证阶段)针对在线集群大约五分钟完成。性能阶段还会加上 NCCL 作业本身的运行时间。
验证证据与反馈闭环
这些结果以 AICR 在 NVL72 参考环境中的部署、一致性和性能验证为基础,并辅以成功的端到端 ComputeDomain 测试。各项检查的详细信息已编入上文的验证矩阵。
同样重要的是当前已验证边界所处的位置。训练 recipe 现在带有一个跨节点 NCCL 性能门禁:这是在 Vera Rubin 芯片上的首次性能验证,在真实 all-reduce 流量下检验了上文所示的同一条 IMEX ComputeDomain 路径。
推理服务性能目前仍然推迟。vLLM 在 v0.27.0 中合并了对 Rubin(sm_107a)的支持,但 SM107 内核路径在构建时受 NVIDIA CUDA >= 13.4 限制——而 vLLM 自己发布的镜像直到 v0.28.0 仍基于 CUDA 13.0.3 构建。因此,即使是最新的 vLLM 发布镜像也只带有调度代码,而没有编译好的内核。ai-dynamo 的最新版本(v1.4.2)固定使用 vllm-openai v0.26.0,该版本完全早于这段代码;其未发布的 main 分支固定使用 v0.28.0,而该版本并非基于 13.4 构建。VR200 的推理性能下限需要一个已发布、基于 CUDA >= 13.4 构建、并在真实硬件上验证过的运行时镜像——要越过 JIT 编译崩溃,而不仅仅是越过版本检查。
Vera Rubin recipe 的签名验证证据是公开的:训练(三个阶段,包括 NCCL 性能门禁)和推理(部署和一致性)。由于这些 recipe 处于 Preview 阶段且仍在变动,请将已发布的证据视为其采集时所对应坐标的历史记录,而不是对当前 recipe 内容的证明。对今天的 recipe 做摘要校验会报告不匹配。
这次 bring-up 也是双向奏效的。在 Vera Rubin 上运行 AICR 验证时,发现 go-nvlib 包中有一个未映射的 Rubin 架构值,导致 DRA driver 的 kubelet 插件反复崩溃重启。由于架构支持首先进入 go-nvml;再流入 go-nvlib;并从那里进入 GPU Operator、Kubernetes Device Plugin、MIG Manager 和 DRA 插件,该修复在整个技术栈中一致地传播。从第一份崩溃报告到在 Vera Rubin 硬件上获得验证过的构建,大约用了三天。该修复(go-nvlib 0.11.0 → 0.12.0)已在官方 DRA driver v0.5.0 版本中发布,因此 Vera Rubin recipe 固定使用正式标签——无需 staging 构建。
验证还发现,主机托管的 IMEX 守护进程与 DRA 托管的 ComputeDomain 目前无法共享同一节点,这一反馈促成了 DRA driver v0.5.0 中发布的主机托管 IMEX 选项。
Vera Rubin recipe 已在开源 NVIDIA/aicr 仓库的 v1.0.0 中发布,该版本在公共目录中注册了 rke2 服务和 vr200 加速器。
开始使用
使用 AICR 公共目录中的预览 recipe,在 Vera Rubin 上开始使用 AICR。
生成经过验证的配置只需一条命令:
aicr recipe --service rke2 --accelerator vr200 --os ubuntu --intent training
对于上文所述的 Dynamo 推理变体,以下命令可生成该 recipe:
aicr recipe --service rke2 --accelerator vr200 --os ubuntu --intent inference --platform dynamo
你可以在 GitHub 上跟进进展、审阅代码或提交 issue: