作者 Prithvi Rajasekaran,我们 Labs 团队成员。
过去几个月,我一直在研究两个相互关联的问题:让 Claude 产出高质量的前端设计,以及让它在无需人工干预的情况下构建完整的应用。这项工作源于我们早先在前端设计技能和长时间运行的编码智能体 harness 上的尝试,我和同事们通过提示词工程和 harness 设计,让 Claude 的表现远高于基线,但两者最终都遇到了天花板。
为了突破瓶颈,我寻找能同时适用于两个截然不同领域的全新 AI 工程方法:一个由主观品味决定,另一个由可验证的正确性和可用性决定。受生成对抗网络(GAN)启发,我设计了一个包含生成器和评估器智能体的多智能体结构。要构建一个能可靠且有品味地给输出打分的评估器,首先要制定一套标准,把“这个设计好不好?”这类主观判断转化为具体、可打分的条目。
随后,我把这些技术应用到长时间运行的自主编码上,并沿用了先前 harness 工作中的两条经验:把构建过程分解为易于处理的小块,以及用结构化制品在会话之间交接上下文。最终成果是一个三智能体架构,包含规划器、生成器和评估器,能在长达数小时的自主编码会话中产出丰富的全栈应用。
为什么朴素的实现行不通
我们此前已经表明,harness 设计对长时间运行的智能体编码效果有重大影响。在早先的实验中,我们用一个初始化智能体把产品规格分解为任务清单,再由一个编码智能体每次实现一个功能,并在交接时传递制品以跨会话延续上下文。更广泛的开发者社区也得出了类似的见解,例如“Ralph Wiggum”方法,利用钩子(hook)或脚本让智能体保持持续迭代循环。
但有些问题依然顽固。对于较复杂的任务,智能体仍然容易随着时间推移而失控。在拆解这一问题时,我们观察到智能体执行这类任务时有两种常见的失败模式。
第一,随着上下文窗口被填满,模型在冗长的任务中往往会失去连贯性(参见我们关于上下文工程的文章)。有些模型还表现出“上下文焦虑”,即当它们接近自认为的上下文上限时,会过早地开始收尾。上下文重置(context reset)可以同时解决这两个问题:完全清空上下文窗口并启动一个全新的智能体,同时配合结构化的交接,传递上一个智能体的状态和后续步骤。
这与压缩(compaction)不同,后者是把对话中较早的部分就地总结,使同一个智能体能在缩短后的历史上继续工作。压缩虽然保持了连续性,却不能给智能体一块干净的白板,因此上下文焦虑仍可能持续。重置提供了干净的白板,代价是交接制品必须包含足够的状态,让下一个智能体能顺利接手工作。在我们早先的测试中,我们发现 Claude Sonnet 4.5 的上下文焦虑相当强烈,仅靠压缩不足以让它在长任务上表现出色,因此上下文重置成了 harness 设计中不可或缺的一环。这解决了核心问题,但会给每次 harness 运行增加编排复杂度、token 开销和延迟。
第二个问题是我们此前没有处理过的自我评估。当被要求评估自己产出的工作时,智能体往往会自信地夸赞这份工作,即使在人类观察者看来,质量明显平庸。这个问题在设计这类主观任务上尤为突出,因为没有类似可验证软件测试的二元检查。布局是显得精致还是平庸,属于主观判断,而智能体在给自己的工作打分时总是倾向于偏高。
不过,即使是有可验证结果的任务,智能体有时也会表现出糟糕的判断力,妨碍它完成任务。把干活的智能体和评判的智能体分开,被证明是解决这一问题的有力杠杆。这种分离本身并不会立刻消除宽松倾向;评估器仍然是 LLM,倾向于对 LLM 生成的输出宽容。但事实证明,把独立的评估器调教得持怀疑态度,要比让生成器对自己的工作持批判态度容易得多;一旦有了这种外部反馈,生成器就有了可以对照迭代的具体依据。
前端设计:让主观质量可以打分
我从前端设计入手做实验,因为自我评估的问题在这里最为明显。在没有任何干预的情况下,Claude 通常倾向于采用安全、可预测的布局,这些布局技术上可用,但视觉上平淡无奇。
有两点见解塑造了我为前端设计构建的 harness。第一,虽然美学无法完全归结为一个分数,个人品味也总会不同,但可以用编码了设计原则和偏好的评分标准来提升它。“这个设计美吗?”很难始终如一地回答,而“它是否遵循了我们对好设计的原则?”则给了 Claude 可以对照打分的具体依据。第二,通过把前端生成与前端评分分开,我们可以建立一个反馈循环,推动生成器走向更强的输出。
基于这些考虑,我写了四条评分标准,并在提示词中同时提供给生成器和评估器智能体:
- 设计质量:设计给人的感觉是一个连贯的整体,还是零散部件的堆砌?出色的作品意味着色彩、字体、布局、图像和其他细节结合在一起,营造出独特的氛围和个性。
- 原创性:有没有迹象表明做出了定制化的决策,还是只是模板布局、库默认样式和 AI 生成的套路?人类设计师应当能看出刻意的创意选择。未经修改的现成组件,或者白色卡片上叠紫色渐变这类 AI 生成的典型痕迹,在这一项上不合格。
- 工艺:技术执行层面:字体层级、间距一致性、色彩和谐、对比度。这是对基本功的检查,而不是对创意的检查。大多数合理的实现默认就能做好;不合格则意味着基础不牢。
- 功能性:独立于美学之外的可用性。用户能否理解界面的作用、找到主要操作,并且无需猜测就能完成任务?
我强调设计质量和原创性,胜过工艺和功能性。Claude 在工艺和功能性上默认就得分不错,因为所需的技术能力对模型来说往往是水到渠成的。但在设计和原创性上,Claude 产出的东西往往最多只能算平淡。这些标准明确惩罚高度通用的“AI 垃圾(AI slop)”套路,并通过给设计和原创性更高的权重,促使模型在美学上更敢于冒险。
我用带有详细分数拆解的少样本(few-shot)示例来校准评估器。这确保了评估器的判断与我的偏好一致,并减少了跨迭代的分数漂移。
我基于 Claude Agent SDK 构建了这个循环,使编排保持简单。生成器智能体首先根据用户提示词创建 HTML/CSS/JS 前端。我给评估器配备了 Playwright MCP,使它可以直接与运行中的页面交互,然后对每条标准打分并写出详细评语。实际运行中,评估器会自行浏览页面,截图并仔细研究实现,然后给出评估。这些反馈会回流给生成器,作为下一轮迭代的输入。每次生成我会运行 5 到 15 轮迭代,每一轮通常都会随着生成器对评估器评语的回应,把它推向更具特色的方向。由于评估器是主动浏览页面,而不是给静态截图打分,每个周期都要耗费实际的时钟时间。完整运行最长可达四小时。我还要求生成器在每次评估之后做一个策略性决定:如果分数趋势良好,就继续打磨当前方向;如果这条路走不通,就转向完全不同的美学风格。
在多次运行中,评估器的评估结果随迭代不断改善,随后趋于平稳,但仍有提升空间。有些生成结果是渐进式打磨,另一些则在迭代之间出现了美学上的急转弯。
评判标准的措辞以我没有完全预料到的方式引导了生成器。像“最好的设计具有博物馆级品质”这样的表述,会把设计推向某种特定的视觉趋同,说明与标准相关联的提示词直接塑造了产出的气质。
虽然分数总体上随迭代提升,但这一趋势并不总是干净的线性。后期的实现整体上往往更好,但我经常遇到更喜欢中间某一轮而不是最后一轮的情况。实现的复杂度也倾向于逐轮上升,生成器会为回应评估器的反馈而尝试更有野心的方案。即便是第一轮,产出也明显优于完全不加提示的基线,这说明在任何评估器反馈促成进一步打磨之前,这些标准及其相关措辞本身就已经把模型从通用的默认风格中引开了。
有一个值得一提的例子:我让模型为一家荷兰艺术博物馆制作网站。到第九轮时,它已经为一家虚构的博物馆做出了一个干净的深色主题落地页。页面视觉上很精致,但基本在我的预期之内。然后在第十轮,它彻底放弃了这条思路,把网站重新构想为一种空间体验:用 CSS 透视渲染出带棋盘格地板的 3D 房间,艺术品以自由的位置挂在墙上,并用门洞在各个展厅之间导航,而不是滚动或点击。这种创造性的跳跃,是我之前在单次生成中从未见过的。
▶ https://cdn.sanity.io/files/4zrzovbb/website/9877febd34432f7f582aecd0023b951223605c6a.mp4
扩展到全栈编码
有了这些发现,我把这种受 GAN 启发的模式应用到全栈开发中。生成器-评估器循环与软件开发生命周期天然契合,代码评审和 QA 在其中扮演的结构性角色,与设计评估器相同。
架构
在我们早先的长时间运行框架中,我们用一个初始化智能体、一个每次只做一个功能的编码智能体,以及会话之间的上下文重置,解决了多会话编码的连贯性问题。上下文重置是关键的突破口:该框架使用的是 Sonnet 4.5,它表现出前面提到的“上下文焦虑”倾向。打造一个能跨上下文重置良好运行的框架,是让模型保持在任务上的关键。Opus 4.5 基本自行消除了这种行为,因此我得以在这个框架中完全去掉上下文重置。各智能体在整个构建过程中作为一个连续会话运行,由 Claude Agent SDK 的自动压缩来应对沿途不断增长的上下文。
在这项工作中,我在原始框架的基础上搭建了一个三智能体系统,每个智能体针对我在之前运行中观察到的一个具体缺口。该系统包含以下几个智能体角色:
规划器(Planner):我们之前的长时间运行框架要求用户预先提供详细的规格说明。我想把这一步自动化,于是创建了一个规划器智能体,它接收一段 1 到 4 句话的简单提示,并将其扩展为完整的产品规格。我要求它在范围上要有野心,并专注于产品背景和高层技术设计,而不是具体的技术实现细节。强调这一点,是出于一种担忧:如果规划器试图预先给出细粒度的技术细节却出了错,规格中的错误就会层层传导到下游实现。更聪明的做法似乎是约束各智能体要交付的成果,让它们在工作中自行找到路径。我还要求规划器寻找机会,把 AI 功能融入产品规格。(示例见文末附录。)
生成器(Generator):早先框架中一次做一个功能的方法,在范围管理上效果很好。我在这里采用了类似的模式,指示生成器以冲刺(sprint)的方式工作,每次从规格中取一个功能。每个冲刺都用 React、Vite、FastAPI 和 SQLite(后来换成 PostgreSQL)技术栈来实现应用,并要求生成器在每个冲刺结束时先自我评估,再交接给 QA。它还可以使用 git 做版本控制。
评估器(Evaluator):早先框架产出的应用往往看起来令人印象深刻,但真正用起来仍有实打实的 bug。为了发现这些问题,评估器使用 Playwright MCP,像用户一样在运行中的应用里点击操作,测试 UI 功能、API 端点和数据库状态。随后它依据所发现的 bug,以及一组仿照前端实验设计、此处调整为涵盖产品深度、功能性、视觉设计和代码质量的标准,对每个冲刺打分。每条标准都有硬性阈值,只要有一条低于阈值,该冲刺就算失败,生成器会收到关于哪里出了问题的详细反馈。
在每个冲刺开始前,生成器和评估器会协商一份冲刺合约:在写任何代码之前,就这一块工作“完成”应是什么样子达成一致。这样做是因为产品规格有意保持在高层,我希望有一个步骤来弥合用户故事与可测试实现之间的差距。生成器提出它将构建什么以及如何验证成功,评估器审查该提案,确保生成器在做正确的事。两者反复迭代,直到达成一致。
沟通通过文件完成:一个智能体写下一个文件,另一个智能体读取它,并在该文件内或通过新文件作出回应,再由前一个智能体读取。随后,生成器依据达成一致的合约进行构建,再把工作交给 QA。这使得工作忠实于规格,又不会过早地过度规定实现细节。
运行框架
这个框架的第一版使用的是 Claude Opus 4.5,我用用户提示同时运行完整框架和单智能体系统,以作对比。选用 Opus 4.5,是因为在我开始这些实验时,它是我们最好的编码模型。
我写了下面这条提示,用来生成一个复古电子游戏制作器:
创建一个 2D 复古游戏制作器,功能包括关卡编辑器、精灵编辑器、实体行为,以及可玩的测试模式。
下表列出了框架类型、运行时长和总成本。
| 框架 | 时长 | 成本 |
|---|---|---|
| 单智能体 | 20 分钟 | $9 |
| 完整框架 | 6 小时 | $200 |
完整框架的成本超过 20 倍,但产出质量的差异一眼就能看出来。
我期待的是这样一个界面:我可以构建关卡及其组成部分(精灵、实体、图块布局),然后点击播放,真正玩这个关卡。我先打开了单智能体运行的产出,最初的应用看起来符合这些预期。
然而,随着点击深入,问题开始浮现。布局浪费空间,固定高度的面板让大部分视口空着。工作流程很死板。想要填充一个关卡时,系统提示我先创建精灵和实体,但界面上没有任何东西引导我遵循这个顺序。更关键的是,游戏本身是坏的。我的实体出现在屏幕上,却对输入毫无反应。深入代码后发现,实体定义与游戏运行时之间的连接是断的,而且表面上看不出问题出在哪里。
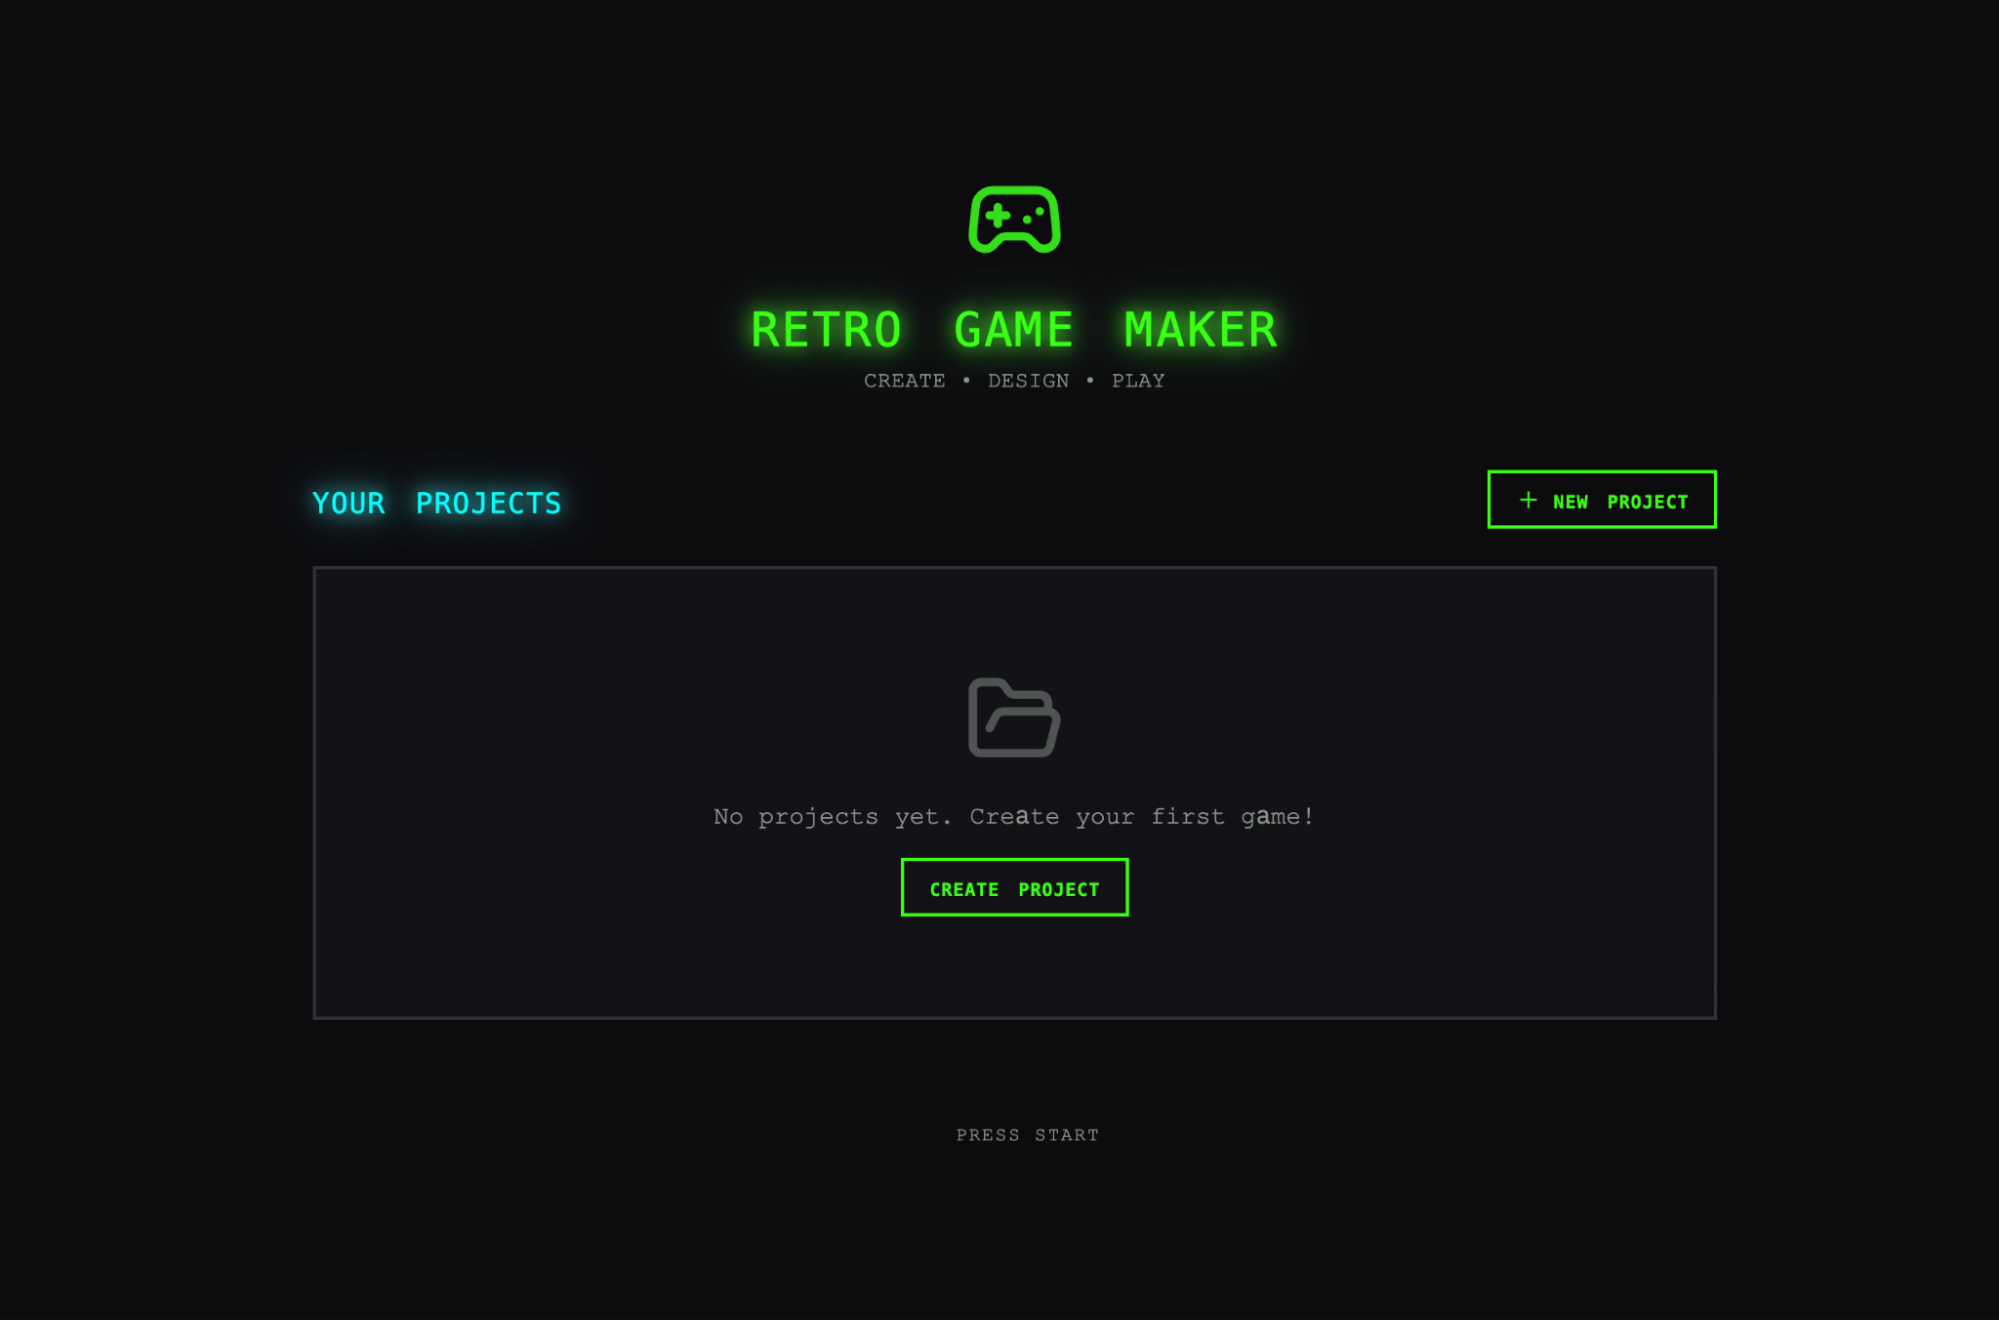
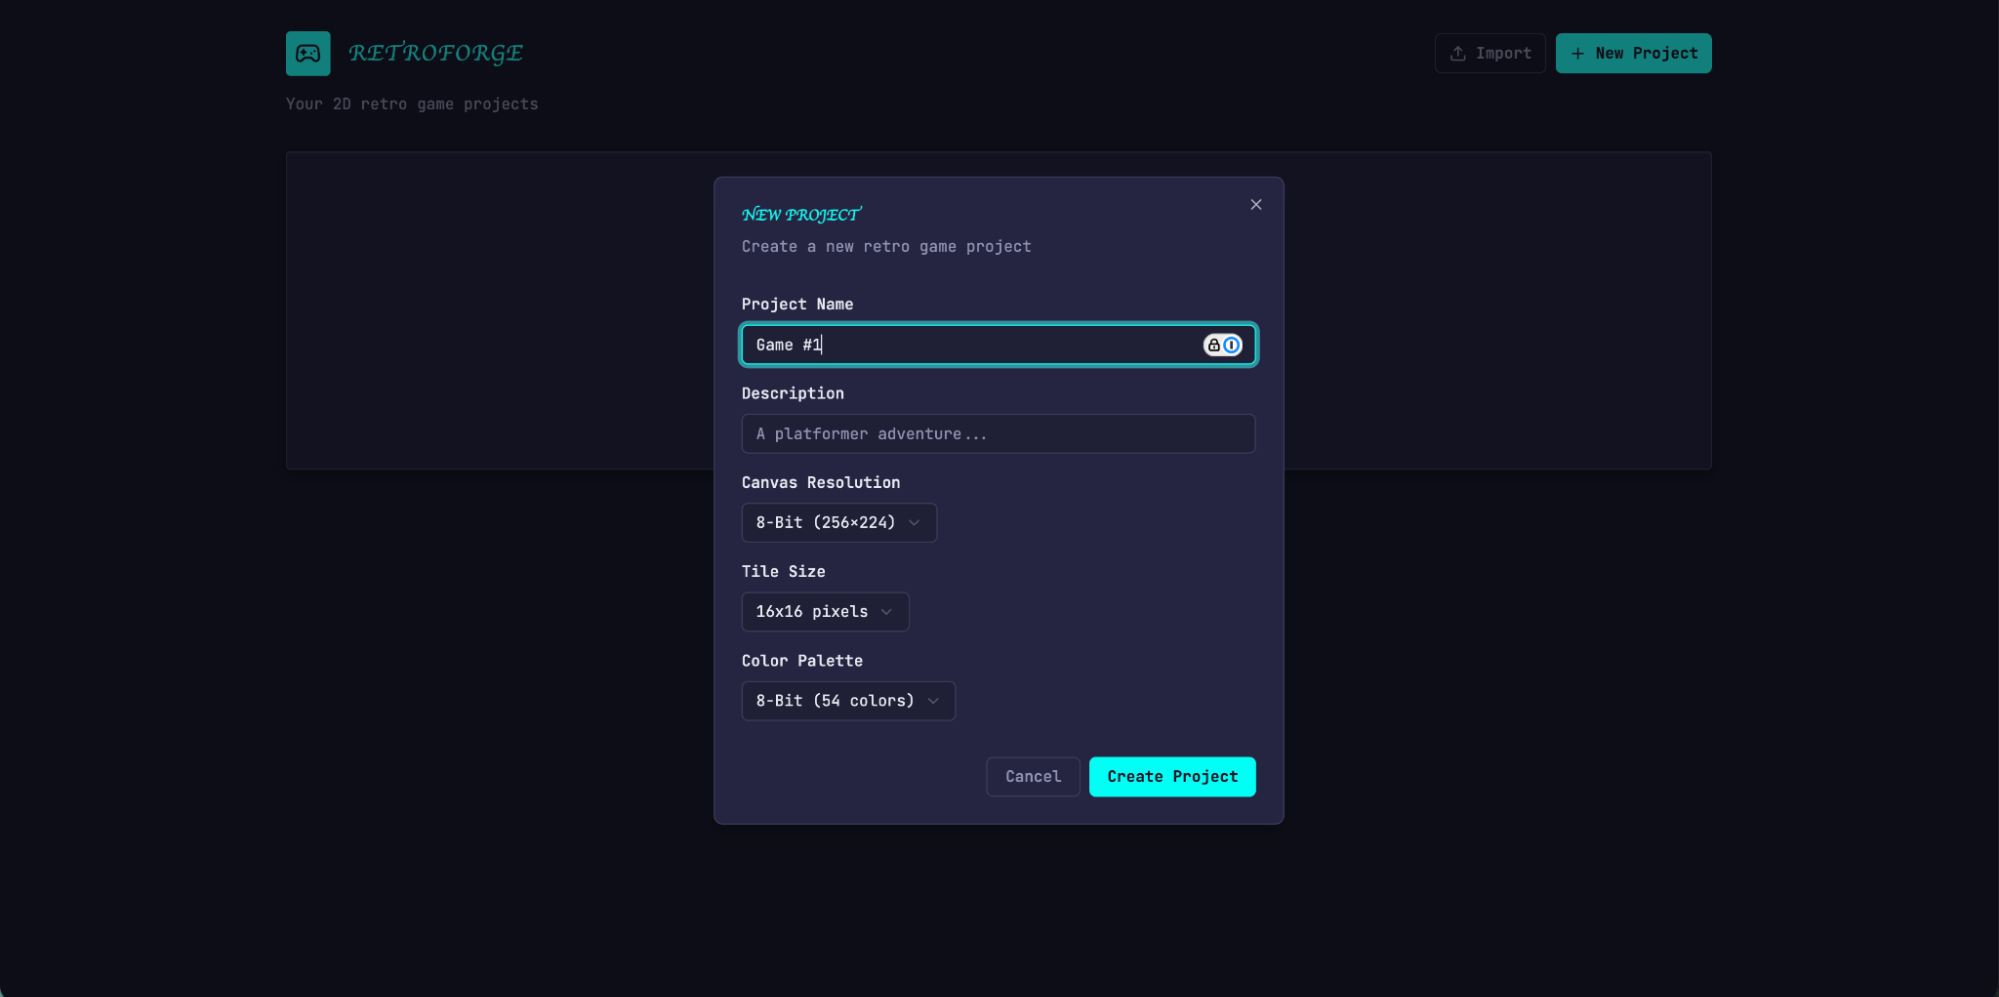
评估完单智能体的运行后,我转向完整框架的运行。这次运行从同一条一句话提示开始,但规划器这一步把提示扩展成了一份横跨十个冲刺、包含 16 项功能的规格。这远远超出了单智能体运行所尝试的范围。除了核心编辑器和播放模式,规格还要求精灵动画系统、行为模板、音效和音乐、AI 辅助的精灵生成器和关卡设计器,以及带可分享链接的游戏导出。我让规划器使用了我们的前端设计技能,它读取后据此为应用创建了视觉设计语言,作为规格的一部分。每个冲刺中,生成器和评估器都会协商一份合约,定义该冲刺的具体实现细节,以及用于验证完成情况的可测试行为。
这个应用立刻就比单智能体的版本显得更精致、更流畅。画布占满整个视口,面板尺寸合理,界面具有一致的视觉识别,并且贴合规格中的设计方向。单智能体运行中的一些笨拙之处确实依然存在:工作流程仍然没有说明应当先构建精灵和实体,再去填充关卡,我只能自己摸索出来。这更像是基础模型在产品直觉上的缺口,而不是这个框架本来要解决的问题,不过它确实指出了一个地方:在框架内部进行有针对性的迭代,可能有助于进一步提升产出质量。
随着在各个编辑器中深入操作,新一轮运行相对单智能体的优势变得更加明显。精灵编辑器更丰富、功能更完整,工具面板更清爽,取色器更好用,缩放控件也更易用。
由于我要求规划器把 AI 功能融入规格,这个应用还内置了 Claude 集成,让我可以通过提示来生成游戏的各个部分。这大大加快了工作流程。
最大的差异出现在播放模式。我真的可以移动我的实体并玩游戏了。物理效果有些粗糙:我的角色跳上平台后却与平台发生了重叠,直觉上感觉不对,但核心功能能用,而这是单智能体运行没有做到的。四处移动一阵之后,我确实碰到了 AI 构建游戏关卡时的一些局限。有一面很大的墙我跳不过去,结果被卡住了。这说明还有一些常识层面的改进和边界情况,是这个框架可以处理以进一步完善应用的。
翻阅日志可以清楚看到,评估器让实现始终与规格保持一致。每个冲刺,它都会逐条走查冲刺合约中的测试标准,并通过 Playwright 操作运行中的应用,对任何偏离预期行为的地方提交 bug。合约相当细致,仅第 3 个冲刺就有 27 条涉及关卡编辑器的标准,而评估器的发现足够具体,无需额外调查即可据此行动。下表列出了评估器发现的几个问题示例:
| 合约标准 | 评估器的发现 |
|---|---|
| 矩形填充工具允许通过点击拖动,用选定图块填充一个矩形区域 | 失败——该工具只在拖动的起点和终点放置图块,而不是填充整个区域。fillRectangle 函数存在,但没有在 mouseUp 时被正确触发。 |
| 用户可以选中并删除已放置的实体出生点 | 失败——位于 LevelEditor.tsx:892 的 Delete 键处理函数要求 selection 和 selectedEntityId都已设置,但点击实体只会设置 selectedEntityId。条件应为 selection || (selectedEntityId && activeLayer === 'entity')。 |
| 用户可以通过 API 重新排序动画帧 | 失败——PUT /frames/reorder 路由定义在 /{frame_id} 路由之后。FastAPI 把 'reorder' 当作整数类型的 frame_id 去匹配,并返回 422:“unable to parse string as an integer.” |
要让评估器达到这个水平,是下了功夫的。开箱即用的 Claude 是个糟糕的 QA 智能体。在早期运行中,我看到它发现了真实存在的问题,却又自己说服自己这些问题不大,最后还是批准了工作。它还倾向于做表面化的测试,而不去探查边界情况,因此较为隐蔽的 bug 常常漏网。调优的循环是:阅读评估器的日志,找出它的判断与我的判断不一致的例子,然后更新 QA 的提示词来解决这些问题。这样的开发循环走了好几轮,评估器的打分方式才让我觉得合理。即便如此,框架的产出仍然暴露了模型 QA 能力的极限:细小的布局问题、某些地方不够直观的交互,以及藏在更深层嵌套功能里、评估器没有充分检验到的未发现 bug。显然还有更多验证上的空间,可以通过进一步调优来获取。但与单智能体运行中应用的核心功能根本无法使用相比,提升是显而易见的。
迭代框架
第一批框架结果令人鼓舞,但它也很臃肿、缓慢而且昂贵。合乎逻辑的下一步,是想办法在不降低表现的前提下简化框架。这一做法一部分出于常识,一部分源于一条更普遍的原则:框架中的每个组件,都编码了一个关于模型自己做不到什么的假设,这些假设值得做压力测试,一方面因为它们可能本来就不对,另一方面因为随着模型进步,它们可能很快过时。我们的博文《构建高效智能体》把这一思想概括为“找到尽可能简单的方案,只在需要时才增加复杂度”,对任何维护智能体框架的人来说,这都是一个反复出现的模式。
我的第一次简化尝试是大幅度削减框架,并尝试了一些富有创意的新想法,但没能复现原版的表现。同时也变得很难判断框架设计中哪些部分真正起承重作用,又是以何种方式起作用。基于这次经验,我转向了更有条理的方法:每次移除一个组件,并检查它对最终结果的影响。
就在我进行这些迭代循环的过程中,我们发布了 Opus 4.6,这进一步促使我降低框架的复杂度。我们有充分的理由预期,4.6 需要的脚手架会比 4.5 少。来自我们的发布博文:“[Opus 4.6] 规划更加周密,能更长时间地持续执行智能体任务,在更大的代码库中运行更可靠,并且具备更好的代码评审和调试能力,能够发现自己的错误。”它在长上下文检索方面也有大幅改进。这些都是该框架原本为补足而构建的能力。
移除冲刺结构
我首先完全移除了冲刺结构。冲刺结构曾帮助把工作分解成块,让模型能够连贯地工作。鉴于 Opus 4.6 的改进,我们有充分理由相信,模型无需这种分解也能原生胜任这项工作。
我保留了规划器和评估器,因为两者仍然各自带来明显价值。没有规划器,生成器会把范围定得过小:拿到原始提示后,它会不先为工作写规格就直接开始构建,最终做出的应用功能不如有规划器时丰富。
去掉冲刺结构后,我把评估器改为在运行结束时只做一次评估,而不再按冲刺打分。由于模型能力强了很多,评估器对某些运行而言的承重程度也随之改变,其作用取决于任务相对于模型自身可靠能力的位置。在 4.5 上,这条边界很近:我们的构建任务处于生成器单独能做好的极限边缘,评估器在整个构建过程中都抓出了有意义的问题。在 4.6 上,模型的原始能力提升了,边界因此向外移动。过去需要评估器把关才能连贯实现的任务,现在往往在生成器自己就能处理好的范围之内,对于这个边界之内的任务,评估器就成了不必要的开销。但对于构建中仍处于生成器能力边缘的那些部分,评估器依然带来了实实在在的提升。
实际的含义是,评估器并不是一个固定的“要或不要”的决定。当任务超出当前模型单独可靠完成的范围时,它才值得付出这笔成本。
在简化结构的同时,我还增加了提示词,以改进框架将 AI 功能构建进每个应用的方式,具体来说,是让生成器构建一个真正的智能体,能够通过工具驱动应用自身的功能。这需要真正的迭代,因为相关知识足够新,Claude 的训练数据对其覆盖得很薄。但经过足够的调优,生成器已经能够正确地构建智能体了。
更新后框架的结果
为了检验更新后的框架,我用下面这条提示来生成一个数字音频工作站(DAW),也就是用于作曲、录音和混音的音乐制作程序:
使用 Web Audio API,在浏览器中构建一个功能齐全的 DAW。
这次运行依然漫长而昂贵,耗时约 4 小时,词元成本为 124 美元。
大部分时间花在了构建者身上,它在没有 Opus 4.5 所需的冲刺分解的情况下,连贯运行了两个多小时。
| 智能体与阶段 | 时长 | 成本 |
|---|---|---|
| 规划器 | 4.7 分钟 | $0.46 |
| 构建(第 1 轮) | 2 小时 7 分钟 | $71.08 |
| QA(第 1 轮) | 8.8 分钟 | $3.24 |
| 构建(第 2 轮) | 1 小时 2 分钟 | $36.89 |
| QA(第 2 轮) | 6.8 分钟 | $3.09 |
| 构建(第 3 轮) | 10.9 分钟 | $5.88 |
| QA(第 3 轮) | 9.6 分钟 | $4.06 |
| V2 框架合计 | 3 小时 50 分钟 | $124.70 |
和之前的框架一样,规划器把一句话提示扩展成了完整的规格。从日志中可以看到,生成器模型在规划应用和智能体设计、接入智能体,以及在交接给 QA 之前进行测试方面做得很好。
话虽如此,QA 智能体仍然发现了真实的缺口。在第一轮反馈中,它指出:
这是一个很强的应用,设计还原度极佳,AI 智能体扎实,后端也不错。主要的失败点在于功能完整性:虽然应用看起来令人印象深刻,AI 集成也运作良好,但若干核心 DAW 功能只是展示性的,缺少可交互的深度:片段无法在时间轴上拖动或移动,没有乐器 UI 面板(合成器旋钮、鼓垫),也没有可视化的效果器编辑器(EQ 曲线、压缩器电平表)。这些不是边界情况,而是让 DAW 真正可用的核心交互,规格中也明确要求了它们。
在第二轮反馈中,它再次发现了若干功能缺口:
剩余缺口:
- 音频录制仍然只是桩实现(按钮能切换,但没有麦克风采集)
- 未实现通过拖动边缘调整片段大小以及片段分割
- 效果器的可视化是数值滑块,而非图形化(没有 EQ 曲线)
当放任生成器自行其是时,它仍然容易遗漏细节或只做桩功能,而 QA 在抓出这些最后一公里的问题、交由生成器修复方面仍然有价值。
根据这条提示,我期待的是这样一个程序:我可以创作旋律、和声和鼓点,把它们编排成一首歌,并在过程中得到内置智能体的帮助。下面的视频展示了结果。
▶ https://cdn.sanity.io/files/4zrzovbb/website/555910f9adb3938734940224e7a6f4c7cbbbd8f2.mp4
这个应用离专业的音乐制作程序还差得很远,智能体的作曲能力显然也有很大的提升空间。此外,Claude 实际上听不到声音,这使得 QA 反馈循环在音乐品味方面的效果打了折扣。
但最终的应用具备了一个可用的音乐制作程序的所有核心部分:在浏览器中运行的可用编排视图、调音台和走带控制。除此之外,我完全通过提示就拼出了一小段歌曲:智能体设定了速度和调性,写下旋律,构建了鼓轨,调整了调音台电平,并加入了混响。作曲的核心基本要素都已具备,智能体也能自主驱动它们,使用工具从头到尾完成一个简单的制作。你也许会说它还不够“音准完美”,但它正在接近。
接下来会怎样
随着模型持续进步,我们大致可以预期它们能够工作更长时间,处理更复杂的任务。在某些情况下,这意味着围绕模型的脚手架会随时间变得不那么重要,开发者可以等待下一个模型,看某些问题自行解决。另一方面,模型越好,就越有空间去开发那些能完成超出模型基线能力的复杂任务的框架。
考虑到这一点,这项工作中有几条经验值得带走。针对你所构建的模型做实验、在真实问题上阅读它的执行轨迹、并调优其表现以达成期望的结果,始终是好的实践。在处理更复杂的任务时,有时可以通过分解任务、为问题的每个方面应用专门的智能体来获得提升空间。而当新模型发布时,通常也应重新审视框架,剥离那些不再对性能起承重作用的部分,并加入新的部分,以实现过去可能无法做到的更强能力。
通过这项工作,我的信念是:有意思的框架组合的空间,并不会随着模型进步而缩小。相反,它会移动,而 AI 工程师有意思的工作,就是不断找到下一个新颖的组合。
致谢
特别感谢 Mike Krieger、Michael Agaby、Justin Young、Jeremy Hadfield、David Hershey、Julius Tarng、Xiaoyi Zhang、Barry Zhang、Orowa Sidker、Michael Tingley、Ibrahim Madha、Martina Long 和 Canyon Robbins 对这项工作的贡献。
同时感谢 Jake Eaton、Alyssa Leonard 和 Stef Sequeira 在文章成形过程中提供的帮助。
附录
由规划器智能体生成的示例计划。
RetroForge - 2D Retro Game Maker

Overview
RetroForge is a web-based creative studio for designing and building 2D retro-style video games. It combines the nostalgic charm of classic 8-bit and 16-bit game aesthetics with modern, intuitive editing tools—enabling anyone from hobbyist creators to indie developers to bring their game ideas to life without writing traditional code.

The platform provides four integrated creative modules: a tile-based Level Editor for designing game worlds, a pixel-art Sprite Editor for crafting visual assets, a visual Entity Behavior system for defining game logic, and an instant Playable Test Mode for real-time gameplay testing. By weaving AI assistance throughout (powered by Claude), RetroForge accelerates the creative process—helping users generate sprites, design levels, and configure behaviors through natural language interaction.

RetroForge targets creators who love retro gaming aesthetics but want modern conveniences. Whether recreating the platformers, RPGs, or action games of their childhood, or inventing entirely new experiences within retro constraints, users can prototype rapidly, iterate visually, and share their creations with others.

Features
1. Project Dashboard & Management
The Project Dashboard is the home base for all creative work in RetroForge. Users need a clear, organized way to manage their game projects—creating new ones, returning to works-in-progress, and understanding what each project contains at a glance.

User Stories: As a user, I want to:

- Create a new game project with a name and description, so that I can begin designing my game
- See all my existing projects displayed as visual cards showing the project name, last modified date, and a thumbnail preview, so that I can quickly find and continue my work
- Open any project to enter the full game editor workspace, so that I can work on my game
- Delete projects I no longer need, with a confirmation dialog to prevent accidents, so that I can keep my workspace organized
- Duplicate an existing project as a starting point for a new game, so that I can reuse my previous work

Project Data Model: Each project contains:

Project metadata (name, description, created/modified timestamps)
Canvas settings (resolution: e.g., 256x224, 320x240, or 160x144)
Tile size configuration (8x8, 16x16, or 32x32 pixels)
Color palette selection
All associated sprites, tilesets, levels, and entity definitions

...