Voxtral 3
思考中
摘要
Voxtral 3 推出了前沿的语音智能体 SDK 和最先进的语音模型,专为跨 50 多种语言的实时、多步骤对话而设计。它结合了准确的转录、具备情感适应能力的自然语音合成,以及深度工具集成,实现无缝的工作流自动化。可通过 Mistral 的欧盟托管 API 或自部署方式使用,在确保数据主权的同时,为联络中心、虚拟助手和免提副驾驶提供低延迟、类人的交互体验。
语音转录和语音生成已经取得了长足进步,但构建能够倾听、推理、交互并处理复杂工作流的端到端语音智能体仍然困难重重。
一个可靠的语音智能体需要同时做好四件事:
- 准确倾听,跨越语言、口音、说话人和打断,
- 深入推理用户在特定语境下的真实意图,
- 自然表达,带有情感和表现力,以及
- 采取行动,通过互联系统完成多步骤操作。
让这四者实时可靠地协同工作仍然是一项挑战。
为此,我们推出 Voxtral 3:一个全新的最先进 语音转文本 和 文本转语音 模型系列,以及一个语音智能体 SDK,将倾听、思考、工具调用和说话整合到单一的实时流式管道中。
Voxtral 3 旨在打造自然的对话体验,从联络中心智能体和服务台,到虚拟助手和免提副驾驶。凭借对数十种语言的支持、富有表现力的语音、复杂推理,以及与自有工具和数据的深度集成,使用 Voxtral 构建的智能体能够解读细微意图、对复杂请求进行推理,并在互联系统中执行多步骤操作。
与其他 Mistral 模型一样,Voxtral 3 系列专为主权部署而设计。即日起可通过 Mistral 的欧盟托管 API 使用,也可在自有基础设施上自部署,让组织能够控制音频的处理位置、数据的处理方式以及对话是否保留。
▶ https://www.youtube.com/watch?v=xFhyfPC-VzI
亮点
- 跨 50 多种语言的准确转录。语音转文本模型 Voxtral Small Transcribe 3 在多语言转录方面处于最先进水平,能够识别谁说了什么(说话人分离),使用关键短语提高准确率(上下文偏置)。它能检测某人何时说完话,使智能体能够即时响应(轮次结束检测)。
- 适应对话的自然语音。文本转语音模型 Voxtral Mini TTS 3 引入了新语音,可根据对话上下文调整情感、语速和强调,支持 35 种以上语言和 50 种以上方言。
- 以语音指令实现类人智能。全新的语音智能体 SDK 将倾听、推理、工具调用和说话整合为实时体验。智能体可以在电话或网络的实时对话中检索信息、与业务系统交互并完成任务。
- Pro Voice 实现精准的语音适配。对于基础语音克隆无法满足的专业用例,Voxtral 的 Pro Voice 适配仅需 30 分钟音频,即可跨语言再现说话人独特的个性、情感范围和说话风格。
- 你的语音 AI,运行在你的基础设施上。使用 Mistral 的欧盟托管 API,或在自有基础设施上部署 Voxtral 3。将敏感对话保留在你的环境中,并控制是否保留任何音频。
它能听懂 50 多种语言,准确率处于最先进水平。
Voxtral Transcribe 3 在转录、说话人分离(谁在何时说话)和上下文偏置能力方面代表了一个重要里程碑。支持的语言列表扩展至 50 种,包括 24 种欧盟官方语言以及许多低资源的亚洲和印度语言。
Small 版本在说话人分离和多语言转录方面取得了最先进的结果,包括英语、法语和西班牙语。它优于 Whisper、Scribe v2 和 Gemini 3.5 Transcribe。Mini 版本 为 4B 参数,能够以每分钟 0.0035 美元的价格实现快速准确的转录。
两个模型都支持上下文偏置,可以给定关键术语和自由文本以偏置转录并提高技术术语的召回率。这使得它们无需微调即可在具有领域特定词汇的生产环境中使用。
FLEURS 45 强制 vs 推断
词错误率——越低越好
- 强制
- 推断
在 FLEURS 基准测试中所有七个模型均支持的 45 种语言交集上的宏平均 WER。除日语、韩语、泰语和中文使用 CER 外,所有语言均使用 WER。越低越好。
强制 = 指定语言;推断 = 自动检测语言。语言:AR、BN、BG、CA、ZH、CS、DA、NL、EN、ET、FI、FR、DE、EL、GU、HI、HU、IS、ID、IT、JA、KN、KO、LV、LT、MK、MS、ML、MR、NO、FA、PL、PT、RO、RU、SK、SL、ES、SV、FIL、TE、TH、TR、UK、VI
说话人分离
拼接最小排列 WER——越低越好
在公开说话人分离基准测试上的宏平均拼接最小排列 WER(cpWER):AMI-IHM、AMI-SDM、Switchboard、Switchboard CallHome、AISHELL-4。为最大程度兼容 API 基线,我们使用 AMI 和 AISHELL 的 30 分钟版本。越低越好。
说话人分离基准测试,拼接最小排列词错误率(cpWER)。
关键短语召回率
有和没有上下文提示——越高越好
- 无上下文
- 有上下文
Voxtral Small Transcribe 3 以品牌色高亮显示。Earnings 22 基准测试上的关键短语召回率。上下文偏置包含关键术语和随机采样的干扰项数量,范围从 0 到 100。柱状图为叠加的绝对值——外柱为有上下文时的召回率,内柱为无上下文时的召回率;可见色带为上下文提示带来的提升。越高越好。
关键短语召回率基准测试。上下文 = 提供给模型的领域特定词汇和说话人姓名。
Artificial Analysis 基准测试
词错误率——越低越好
Artificial Analysis WER 指数,为 VoxPopuli、Earnings-22 和 AgentTalk 上的加权平均值。
越低越好。
▶ https://www.youtube.com/watch?v=7a65lAUvAxQ
▶ https://www.youtube.com/watch?v=hHIs0pc-RVQ
Voxtral Realtime Transcribe 3 是专为智能体用例构建的实时转录模型。它在超过 35 种语言中实现低于 500ms 延迟的高质量转录,包括说话人分离和上下文偏置。
FLEURS 35
实时转录词错误率——越低越好
FLEURS 基准测试中 35 种语言的宏平均 WER。除日语、韩语和中文使用 CER 外,所有语言均使用 WER。越低越好。*Voxtral Mini Transcribe 3 是离线基线。其余模型为实时模型。
语言:AR、BN、BG、CA、CS、NL、EN、ET、FI、FR、DE、EL、GU、HI、ID、IT、JA、KN、KO、LV、MK、MS、ML、MR、NO、FA、PL、PT、RO、RU、SK、ES、FIL、TE、TR
原生支持轮次结束预测,结合声学和语义信息来准确预测用户何时说完话。这使低延迟语音智能体应用成为可能,同时最大限度地降低用户过早被打断时的误截断率。
它以恰当的情感,用您或您客户品牌自己的声音和当地方言作答。
Voxtral Mini TTS 3.0 提供批处理和实时两种模式,在 35 种以上语言和 50 种以上方言中实现最先进的表现力和指令遵循能力。Voxtral Speech 3 每 100 万字符收费 13 美元,运行成本低于 OpenAI TTS-1、Deepgram、ElevenLabs Flash 和 Gemini Flash 的同类模型。
该语音模型能隐式地更好地理解上下文的语义含义,在多样化的情感和语言中生成自然的语音。新增和改进的功能包括从 30 分钟以上采样音频进行声音克隆、自定义提示指令遵循(IF)、上下文 TTS 以及词汇库,所有这些都服务于部署中语音可靠性的目标。显式 IF 的变量包括 emotion、pacing 和 emphasis。
提示
让我们在这里结束争论:是 GIF。
默认
▶ https://mistral.ai/cms-media/api/media/file/audio_(20).wav
非标准音素提示:dʒ ɪ f
▶ https://mistral.ai/cms-media/api/media/file/audio_(21).wav
提示
等等……这不可能。这幅画来自兰斯?那么……这就是我祖母找了五十年的那幅!
默认
▶ https://mistral.ai/cms-media/api/media/file/audio_(8).wav
非标准音素提示:ʁ e i m s
▶ https://mistral.ai/cms-media/api/media/file/audio_(9).wav
提示
我们的新助手名为 Quivello。
默认
▶ https://mistral.ai/cms-media/api/media/file/quivelo.wav
非标准音素提示:tʃ i v ɛ l l o
▶ https://mistral.ai/cms-media/api/media/file/chievelo.wav
提示
你好!我是 Xyra,你的私人助理。
默认
▶ https://mistral.ai/cms-media/api/media/file/ger-2.wav
非标准音素提示:z aɪ ɹ ə
▶ https://mistral.ai/cms-media/api/media/file/ger-1.wav
所有听起来自然的语音都依赖于情感,情感决定了其韵律、节奏、语速、重音和过渡。Voxtral TTS 原生地解读提示文本的上下文以确定情感和声音风格,使模型在无需额外指令或语音提示的情况下,天然更擅长生成自然的语音。
Voice Code Bench:每美元质量
由 BeSimple AI 制作的 Voice Code Bench 专注于企业客户支持中与数字和独特名称相关的失败状态。
- 其他 TTS
- Mistral
越靠左上越好。
Voice Code Bench(BeSimple AI):300 条英文提示,每个系统 2 个声音(女声和男声);评判模型 gemini-3.8-flash;价格来自供应商定价页面;生成于 2026-10-20。
发音控制:每美元质量
目标词按其音素按预期发音的片段占比
- Mistral
- 其他 TTS
内部评估。越靠左上越好。没有文档化发音控制的系统列在数据中,但不绘制。
300 个英文句子,每个句子包含一个罕见或生造词(150 个简单,150 个困难),每个系统 2 个声音;评判模型 gemini-3.8-flash 听取带有该词预期 IPA 的片段;价格来自供应商定价页面;生成于 2026-10-20。
多语言:每美元质量
11 种语言的平均评判分数,每种语言和系统 1 个母语声音
- 其他 TTS
- Mistral
内部评估。越靠左上越好。覆盖少于 11 种语言的系统列在数据中,但不绘制。
377 条为发布选定的提示,11 种语言,各语言平均评判分数的未加权平均值,1 到 5 分制;评判模型 gemini-3.8-flash;价格来自供应商定价页面;生成于 2026-10-20。
表现力英语:每美元质量
one_eval 上的平均评判分数,237 条为发布选定的提示
- 其他 TTS
- Mistral
内部评估。越靠左上越好。
表现力英语(one_eval):237 条为发布选定的提示,每个系统 2 个声音(Voxtral TTS:Sarah 和 James),1 到 5 分制;评判模型 gemini-3.8-flash;价格来自供应商定价页面;生成于 2026-10-20。
展示 Voxtral 在表现力、数字和独特名称方面的爬山式改进。
提示
感谢您致电 Mistral!我了解到您在登录 AI Studio 时遇到困难。我可以确认您的电子邮件地址吗?我这里显示的是 elena.vance82@yahoo.com,对吗?
Voxtral 1
▶ https://mistral.ai/cms-media/api/media/file/Voxtral%201%20-%20Customer%20Support.wav
Voxtral 3
▶ https://mistral.ai/cms-media/api/media/file/Voxtral%203%20-%20Customer%20Support.wav
提示
天哪,真快,我已经为您即将到来的旅行找到了一个航班。10 月 10 日 21:00 出发、10 月 25 日 22:00 返回的阿联酋航空航班,价格 1881 英镑,怎么样?您说一声,我现在就订一个靠窗座位。
Voxtral 1
▶ https://mistral.ai/cms-media/api/media/file/Voxtral%201%20-%20personal%20ai%20agent.wav
Voxtral 3
▶ https://mistral.ai/cms-media/api/media/file/Voxtral%203%20-%20personal%20ai%20agent.wav
提示
哇,我真不敢相信你怀孕了!这太令人兴奋了,恭喜你 Corina,我真为你高兴!
Voxtral 1
▶ https://mistral.ai/cms-media/api/media/file/Voxtral%201%20-%20EQ%20Excited.wav
Voxtral 3
▶ https://mistral.ai/cms-media/api/media/file/Voxtral%203%20-%20EQ%20Excited.wav
提示
你说我的护照这周办不下来是什么意思——我已经跟你说过好几次我需要去巴黎出差了。这太荒唐了。我简直无法形容这件事有多令人愤怒。
Voxtral 1
▶ https://mistral.ai/cms-media/api/media/file/Voxtral%201%20-%20Angry%20EQ.wav
Voxtral 3
▶ https://mistral.ai/cms-media/api/media/file/Voxtral%203%20-%20Angry%20EQ.wav
▶ https://www.youtube.com/watch?v=y7Dtkjz3MZM
▶ https://www.youtube.com/watch?v=1czHOKcAtfY
语音在 35 种语言和 50 多种方言中听起来都很地道。
Voxtral TTS 支持超过 35 种语言及地区方言。我们的多语言评测遵循方言在发音、正式与非正式语体、拼写、冗长度以及地区惯例(时间、日期、温度、地址、货币)上的差异。
Voxtral 3 多语言库
语音预设提供 18 种语言:阿拉伯语(阿联酋、现代标准)、巴西(葡萄牙语)、加泰罗尼亚语、中文(普通话)、荷兰语、英语(美式、英式)、法语(法国)、德语、希腊语、印地语、意大利语、韩语、挪威语、俄语、西班牙语(西班牙)和越南语。
语音智能体掌控整个对话。
Voxtral 3 推出基于 LiveKit 构建的语音智能体 SDK,将语音输入、推理和语音输出作为一条流式流水线运行。Voxtral Mini Transcribe Realtime 3 负责聆听并检测来电者何时说完,通用模型——例如 Mistral Small——进行推理并调用工具,Voxtral Speech 3 则以截至目前对话的语气作出回复。没有任何阶段需要等待前一阶段,因此每一轮都能在一秒内完成,并且当来电者插话时智能体会停止说话。
通话期间,智能体可以利用函数调用、网络搜索以及对自有系统的检索,验证来电者身份、查询账单或预约。它通过 SIP 接听和拨打电话,通过 WebRTC 在浏览器和应用中运行,并可连接你已在使用的电话、IVR 和联络中心软件。
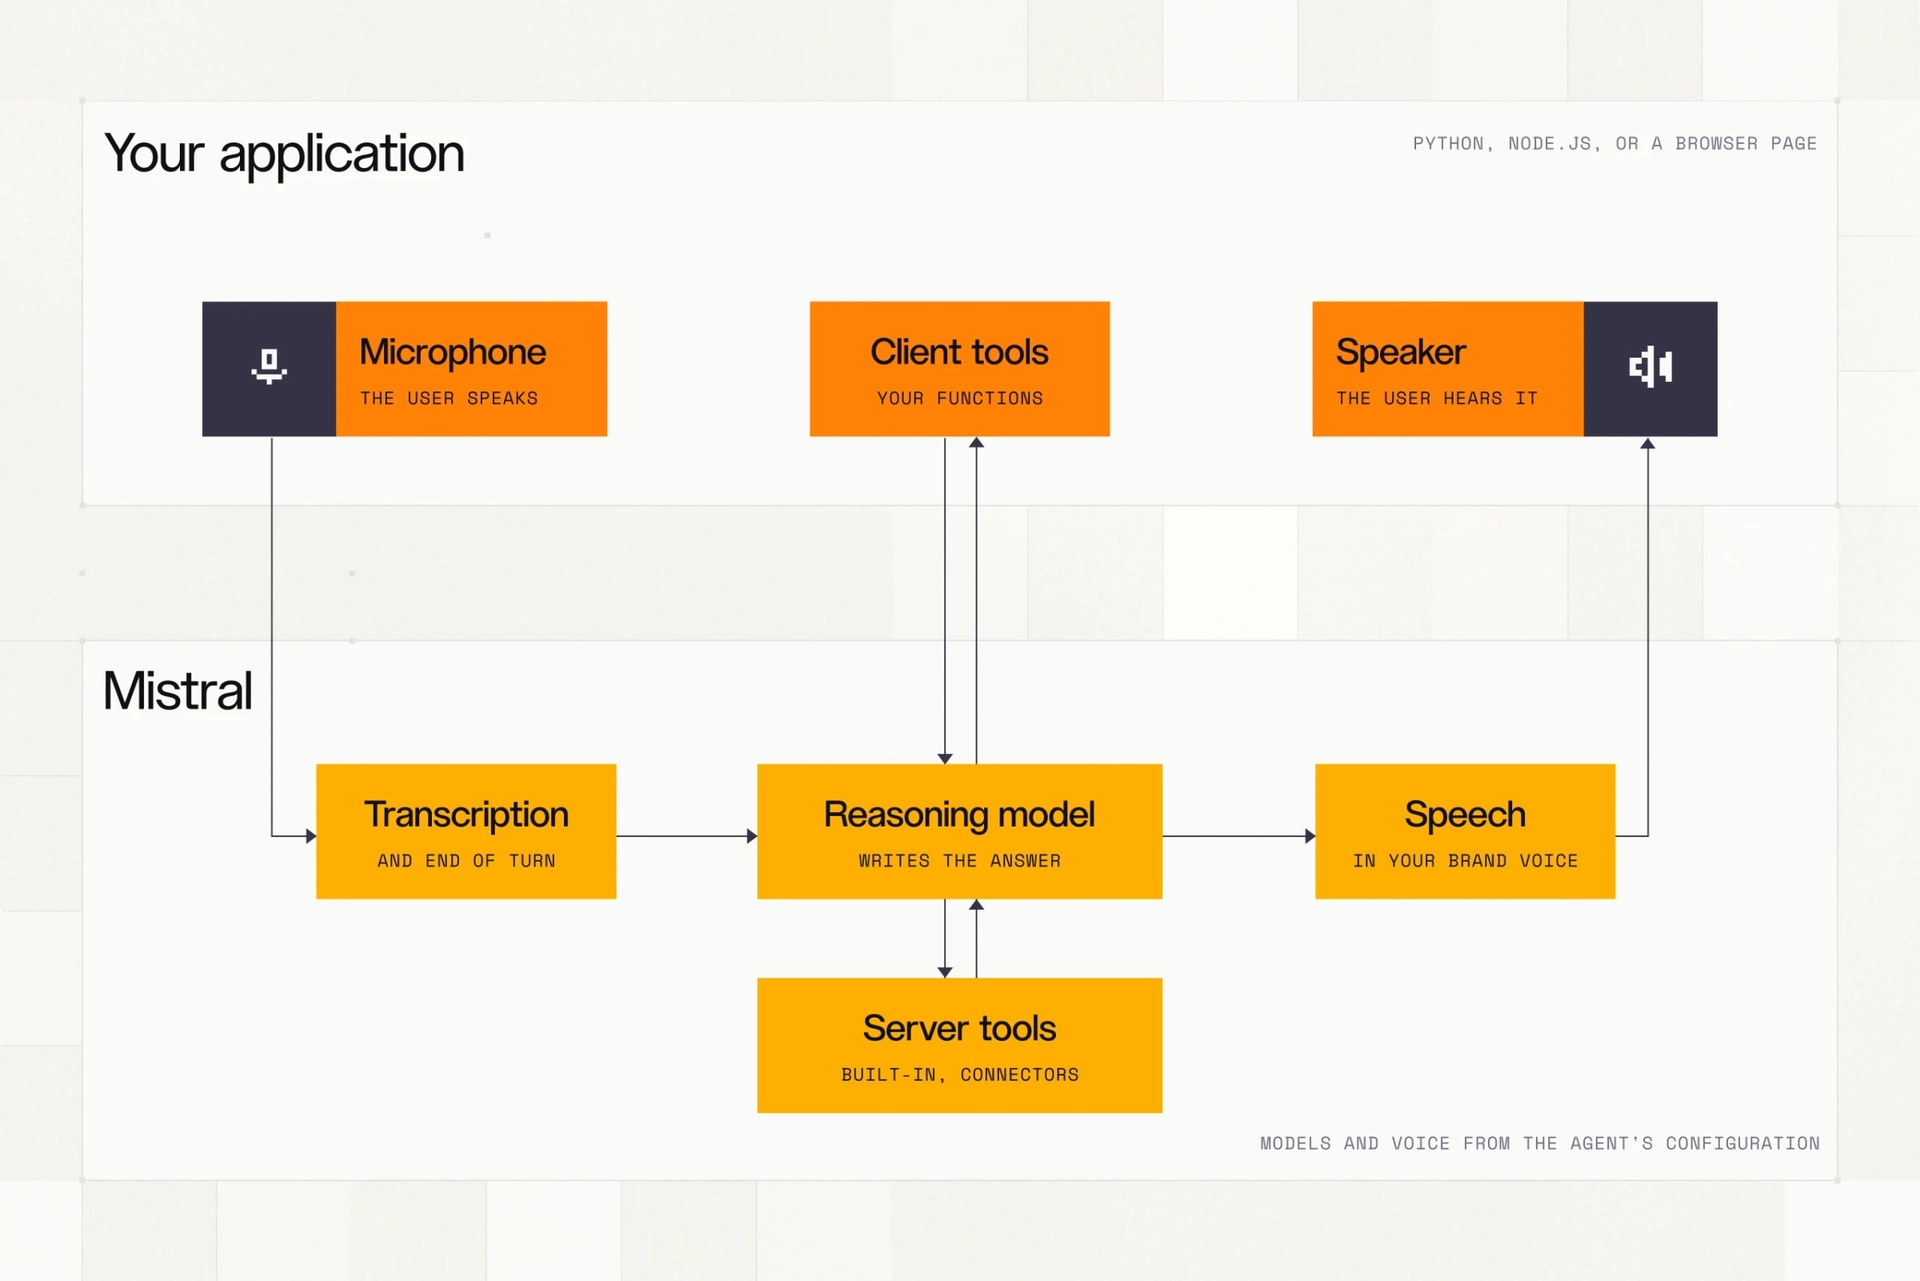
每个阶段都是独立的模型,因此你可以更换 LLM、语音或语言而无需重写智能体,并可在欧洲的 Mistral API 或你自己的基础设施上运行整套技术栈。
开始使用。
Voxtral 3 现已通过 Mistral API 提供,托管于我们的欧洲、美国和全球端点。
你可以在 Studio 演练场中测试语音智能体、音频转录、语音生成和语音克隆。
| 模型 | 价格 |
|---|---|
| Voxtral Mini Transcribe 3(批处理) | $0.0035/分钟 |
| Voxtral Mini Transcribe Realtime 3 | $0.008/分钟 |
| Voxtral Small Transcribe 3 | $0.0040/分钟 |
| Voxtral Speech 3(批处理与实时,同一 API) | $13/100 万字符 |
| 使用 Mistral Small 4 进行推理的语音智能体 API | 0.04$/分钟 |
| 使用任何其他推理模型的语音智能体 API | 0.08$/分钟 |
要在本地或私有云中运行整套技术栈,请联系我们的团队。
Voxtral Small Transcribe 3
新
准确率最高的语音转录模型。最先进的多语言转录与说话人分离,支持 50 多种语言和上下文偏置。
转录
音频
$0.004
/分钟
Voxtral Mini Transcribe 3
新
高效、低延迟的语音转录模型。支持 50 多种语言的多语言转录、说话人分离和上下文偏置。
转录
音频(批处理)
$0.0035
/分钟
Voxtral Mini Transcribe Realtime 3
专为智能体用例构建的实时转录模型,在 40 多种语言中提供低于 500 毫秒延迟的高质量转录。
转录
音频
$0.008
/分钟
Voxtral Speech 3
在 35 多种语言和 50 多种方言中具备最先进的表现力和指令遵循能力
语音
输入
$13
/100 万字符