机器学习模型通过人类标注的示例来学习识别我们周围的世界。这一过程背后的假设是:标注者在开始之前,心中对该类别已有清晰且稳定的定义。当在客观类别(如停车标志或金毛寻回犬)上训练模型时,这一假设成立得很好,因为这些类别的边界清晰且被普遍认可。然而在实践中,现实世界的应用往往需要视觉系统去应对人类经验中主观的"灰色地带"。例如,考虑训练一个视觉分类器来识别"健康食品"、筛选"鼓舞人心的艺术作品",或协助内容审核。在这些领域中,类别边界可能并非普遍或静态的,因为它们会随文化背景、个人理念或不断演变的运营政策而变化。此外,人们很少一开始就对主观概念有完整的规格说明,即便在自己头脑中也是如此。相反,他们从对某个概念的直觉性想法出发,只有在遇到现实世界的示例时,才会发现该概念真正的边界、例外和细微差别。传统的训练工作流并未考虑这种概念演化,迫使用户即便在自己的心智模型仍在变化时,也要向 AI 系统提供僵化的标签。
为弥合这一差距,我们引入了敏捷审议(Agile Deliberation),这是一个将主观 AI 分类器的创建视为迭代式对话的框架。敏捷审议不要求人类充当静态的数据标注者,而是将 AI 系统转变为协作伙伴,帮助用户"审议"并厘清自己的定义。通过首先解决人类的模糊性,该框架系统地构建更有效、更稳健且更对齐的 AI 系统。为支持更广泛的研究社区,我们还在GitHub 上开源了底层代码和算法。
这项工作的一大关键区别在于其对实时用户体验的关注。由于标准的静态 AI 基准测试无法捕捉主观概念,我们绕过了模拟测试,在 18 场与人类参与者进行的、每场 1.5 小时的实时会话中评估了敏捷审议。这使我们能够直接观察并测量当一个人与智能系统配对时,其意图如何动态演化。我们发现,敏捷审议通过对边界图像的直接反馈取代手动提示工程,大幅减少了用户的疲劳和焦虑,从而产生了更一致、性能更高的 AI 模型,其表现优于标准基线。
工作原理:审议的两个阶段
敏捷审议将定义主观概念的复杂任务拆分为两个结构化阶段:概念界定和概念迭代。这两个阶段共同将模糊的想法转化为 AI 模型高度精确的指令蓝图。
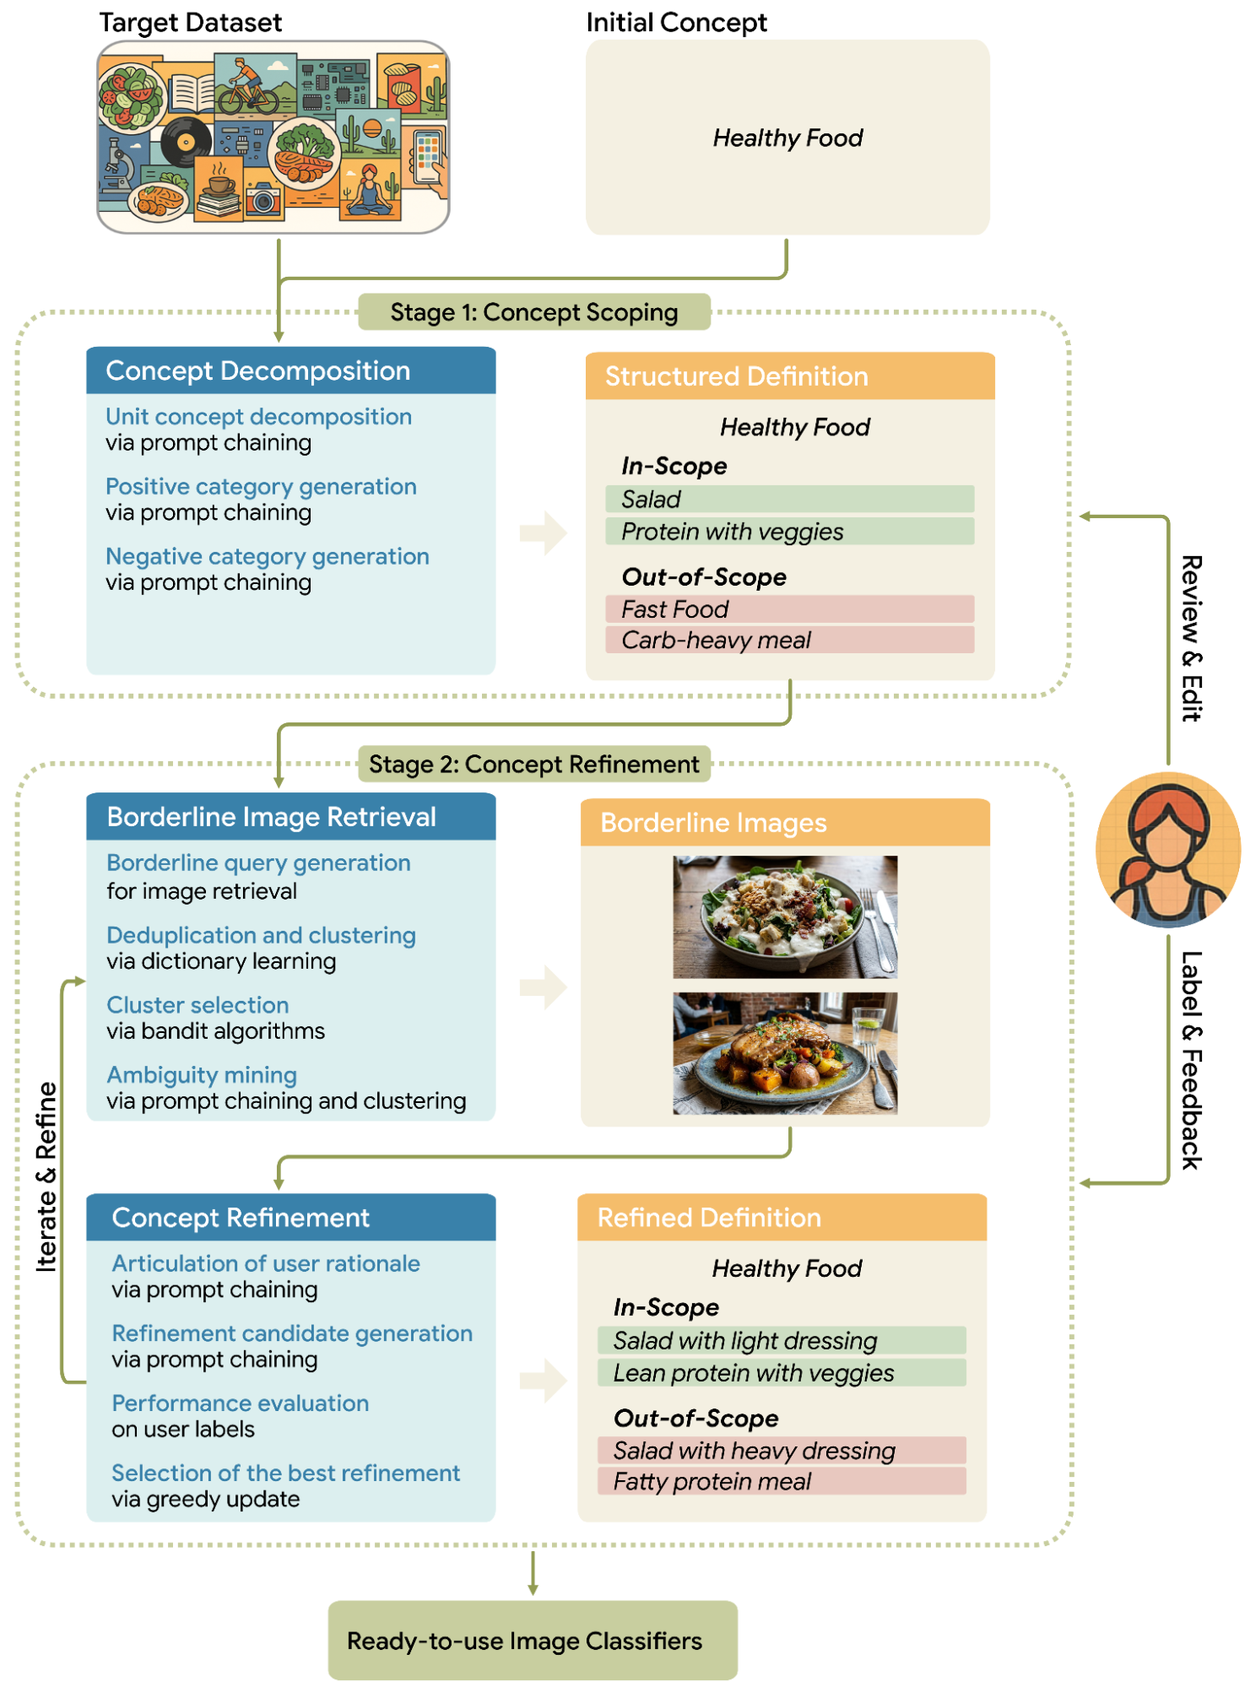
阶段 1:概念界定
当面对"健康食品"这样宽泛的主题时,人类的直觉自然难以预先列出每一条规则。在概念界定阶段,系统引导用户将其总体概念分解为结构化的子概念层级和明确的排除项。
例如,用户不必只使用一个宽泛的标签,而可以将"健康食品"分解为"沙拉"、"谷物碗"和"瘦肉蛋白"等正例子类别。同时,他们可以定义明确的排除项,如"加工食品"或"生的、未加工的食材"。这创建了一个初始的结构化基线,为模型的理解奠定基础。
阶段 2:概念迭代
在初始结构建立之后,框架从静态规划转向主动测试。传统机器学习假设人类标注者是一个"神谕",心中已有一套完整定义的规则。敏捷审议颠覆了这一前提,转而聚焦于协作式细化。
这一阶段从主动学习中汲取灵感,后者传统上用于检索信息量大的数据点,以最大化机器的训练效率。然而,与主动学习中纯粹为最小化机器不确定性而选择示例不同,敏捷审议使用视觉语言模型(VLM)来主动挖掘并呈现语义上处于边界的图像,以挑战当前基于文本的定义。
例如,系统可能呈现一张水果冰沙的图像来挑战"健康饮食"概念,迫使用户做出决定:这是健康饮品,因为它含有生水果?还是因含糖量高而属于被排除的加工食品?
面对这些模糊的边缘案例,会促使用户反思自己隐藏的假设,厘清其真实意图,并相应地更新策略规则。随后,这些人类反馈被直接送入自动提示优化循环,确保 VLM 的分类边界与用户细化的定义同步变化。
实验
评估主观视觉分类器面临一个根本性挑战:不存在静态、客观的真值可供衡量性能,因此,在预标注数据集上进行离线评估无法衡量该框架在审议过程中随着个人对概念的心智模型变化而适应的程度。
为了捕捉这一动态过程,我们构建了一个功能原型,并通过一项实时用户研究对其进行了评估。我们开展了 18 场实时用户会话,每场持续 1.5 小时,参与者在其中以随机顺序与我们的系统及替代基线进行交互,以防止学习偏差。
我们选择了两个复杂且高度主观的领域来测试这些系统的极限:
- 健康食品:在这一领域中,个人健康理念、饮食限制和文化背景可能产生高度多样、主观的观点。
- 付费诱导(Pay-to-Play):一项真实世界的内容审核挑战,需要捕捉专家级的细微差别和特定上下文。这涉及识别在线娱乐或游戏领域中承诺误导性财务或数字奖励的标题党图片。
我们将敏捷审议(Agile Deliberation)与三种常见且不同的范式进行了对比评估:
- 零样本分类器:标准的“一次完成”方法。用户编写初始提示,但无法查看边缘案例,也无法在模型误解边界时进行调整。
- 建模协作者:一种自动化的自上而下方法,由 AI 智能体尝试自行分解概念。虽然它能自动生成标准,但将用户排除在循环之外,导致无法引导或纠正其逻辑。
- 手动审议:繁琐、费力的现状流程,用户在电子表格中检查数据,猜测搜索查询以发现异常,并手动重写原始提示。
结果
实时用户会话表明,敏捷审议能产生性能更高的分类器模型,同时大幅改善用户体验。
提升一致性与性能
我们发现,经历结构化审议过程的研究参与者在随时间推移中表现出显著更高的标注一致性。通过尽早解决边界模糊问题,他们构建的分类器大幅优于所有标准基线。这些性能提升在最具挑战性的主观图像上最为显著——这正是传统分类器通常失败的领域,因为它们依赖默认的、通用的 AI 假设,而非用户明确、细致的意图。
消除盲点
专家参与者报告称,该系统充当了有效的诊断工具。通过有意呈现令人困惑的边界图像,AI 系统帮助他们发现了初始定义中的“盲点”——揭示了他们在面对模糊的真实世界示例之前未曾预料到的场景。
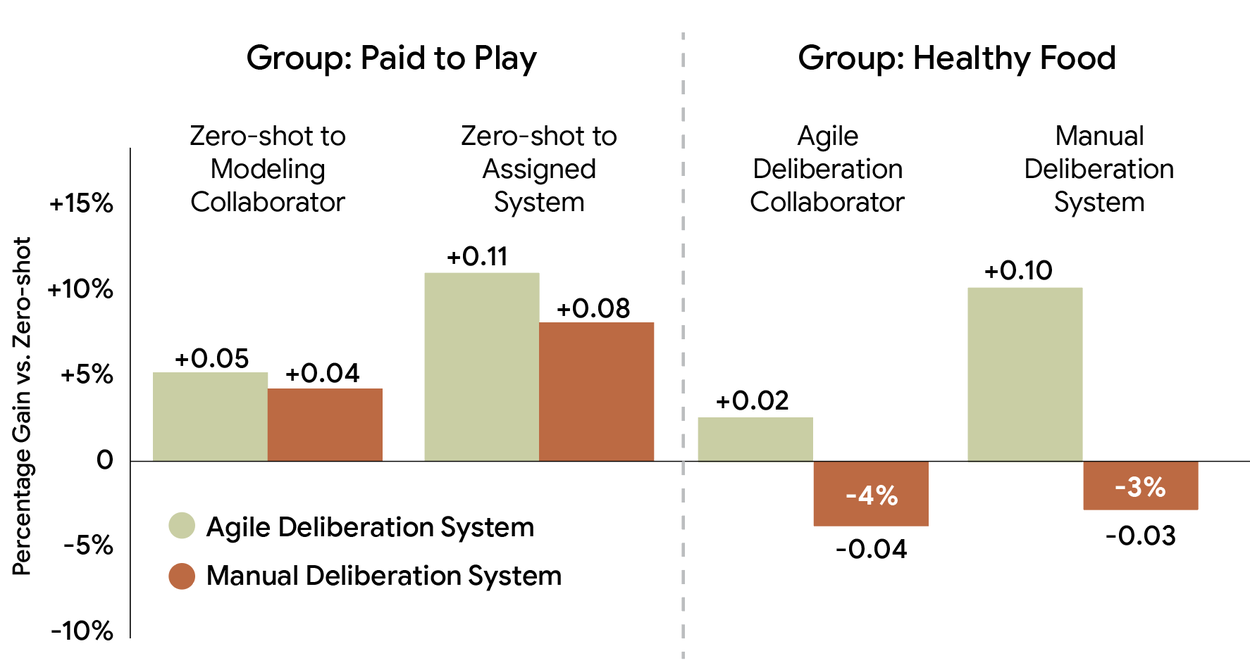 各任务中的分类器性能增益**。* 在“付费诱导”和“健康食品”两个评估组中,敏捷审议框架相对于零样本基线均产生了一致的性能增益,而手动审议方法往往无法提升甚至降低分类器准确率。*
缓解认知疲劳
我们实时研究的一个关键发现是手动提示工程带来的认知负担。我们的研究表明,用户在手动概念审议过程中尝试预测可能发现边缘案例的搜索词时,经历了明显的认知疲劳。此外,他们报告称持续感到焦虑,担心手动调整文本提示以修复一个错误可能会无意中降低分类器其他已修复部分的性能。
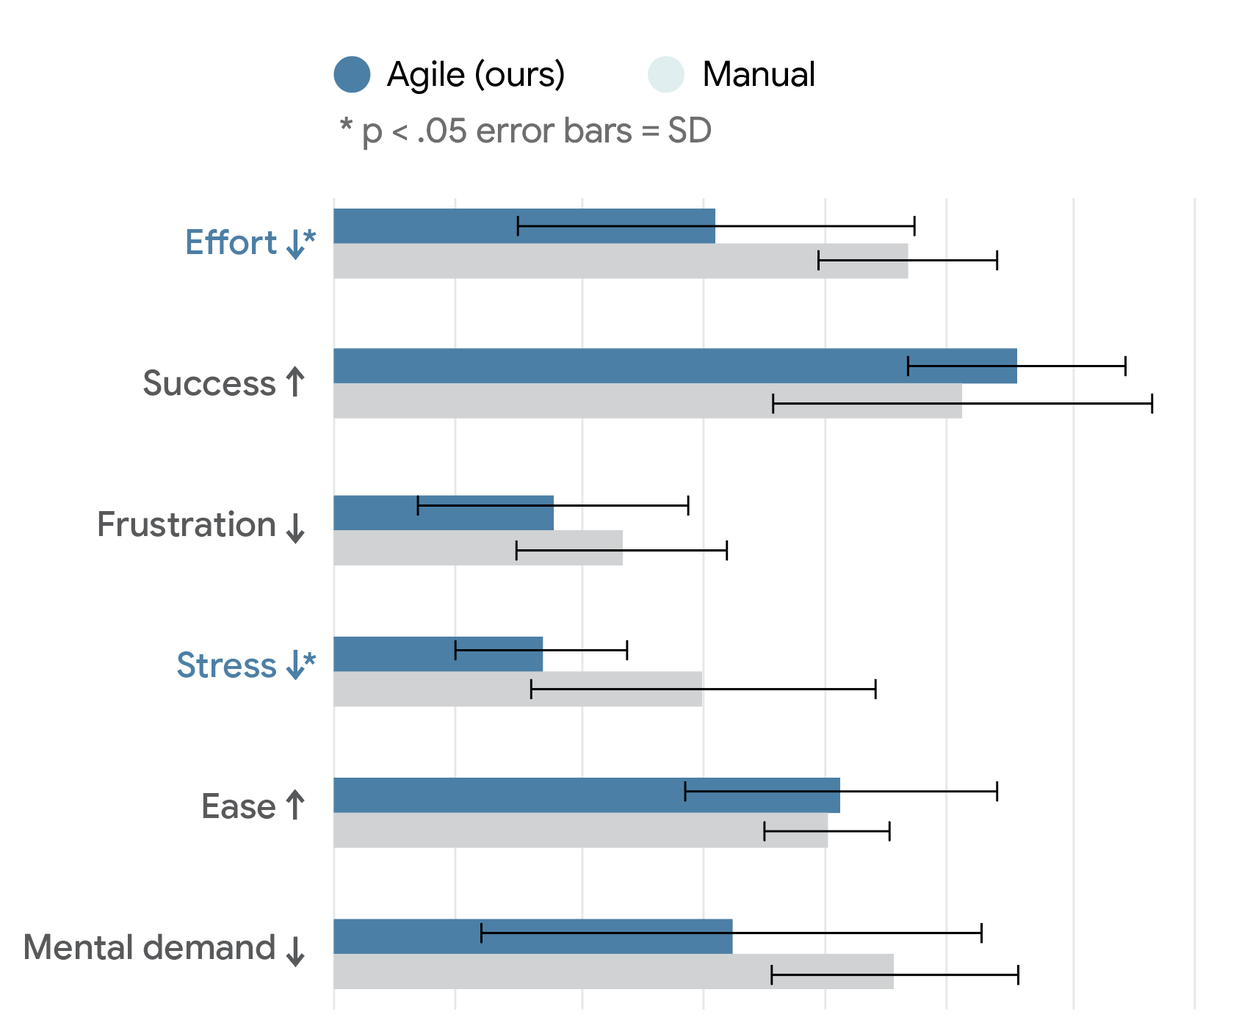 用户体验与认知负荷指标**。* 与传统手动提示工程相比,使用敏捷审议的参与者报告所需努力和压力在统计上显著降低,同时心理需求更低,感知成功度和易用性更高。*
敏捷审议通过承担繁重的计算工作来解决这一摩擦。用户无需成为提示工程师;他们只需查看精心策划的边界图像画廊并提供自然反馈。系统无缝吸收其意图并自动更新底层模型。
因此,使用敏捷审议的参与者报告感到压力显著更小、挫败感更少、精神消耗更低,每位参与者都表示偏好敏捷审议而非手动方法。
结论
最终,敏捷审议将人在回路机器学习范式从单向通道——AI 系统仅从人类标签中学习——转变为双向协作,人类与 AI 共同细化概念。
随着机器学习系统越来越多地部署来处理复杂的真实世界社会任务,确保其边界反映细致的主观概念至关重要。无论是赋能信任与安全团队构建更安全的内容审核过滤器,帮助策展人塑造数字收藏,还是协助科学家对复杂视觉数据进行分类,敏捷审议都为人类与 AI 的对齐提供了基础。
要了解更多关于底层主动学习技术以及我们的范围界定和聚类算法的技术实现,请阅读我们的论文并查看 GitHub 上的开源实现。要开始使用,请参阅我们的交互式 Colab/Jupyter 演示,逐步了解本文介绍的“健康食品”示例。在此基础上,您可以将其适配到您是领域专家的任何领域(例如,标记误导性标题党),或使用它围绕您自己的主观品味和标准构建个性化分类器(例如,策划“鼓舞人心的艺术作品”)。
致谢
我们要感谢我们的合作者——Wei Qiao、Thomas Denby、Krishnamurthy Viswanathan、Enming Luo、Chun-Ta Lu、Tushar Dogra、Ranjay Krishna 和 Ariel Fuxman——感谢他们为这项工作和随附论文提供的宝贵见解与贡献。这项研究得以实现,离不开 Google Research 与 Google Ads 之间的紧密合作。