如果你曾尝试在 TPU 上运行 PyTorch,你可能已将代码移植到 torch_xla,或者最终不得不学习 JAX。借助 TorchTPU 这一原生 PyTorch 后端,TPU 现在只是另一个设备。它为 Hugging Face 生态系统带来了对 TPU 的原生支持。Transformers、Diffusers 和 Kernels 可在 TPU 上原生运行。从 Hub 选择一个模型,将其发送到 "tpu",就完成了。
等等,什么是 TPU?🤔
TPU 代表 张量处理单元(Tensor Processing Unit)。TPU 是谷歌自家的 AI 加速器。它们是专为一项任务构建的芯片:神经网络大部分时间都在进行的矩阵数学运算。谷歌设计它们已有大约十年,并用它们来训练和提供自己的模型,包括 Gemini。
TPU 可在 Google Cloud 上使用,从单个芯片到数千个芯片的 pod 不等。当你需要大量计算时,无论是训练还是大规模服务,它们都能大放异彩。
问题一直在于软件。TPU 技术栈是围绕 TensorFlow 和 JAX 发展起来的,PyTorch 用户不得不付出更多努力才能进入。
旧方法
到目前为止,在 TPU 上运行 PyTorch 意味着要通过 PyTorch/XLA(torch_xla)。它能工作,但有其怪癖。张量是惰性的(张量,不是你),所以你的代码并不总是按你预期的时间运行。小的改动可能触发图重新编译,调试也很难推理。
为了让生活更轻松,我们构建了 Optimum TPU。它为 Hugging Face 模型在 TPU 上提供了推理和训练支持。现在 TorchTPU 带来了原生支持,使用 Transformers 和 Diffusers 运行 Hugging Face 模型不再需要 Optimum TPU。
TorchTPU 登场 🚀
TorchTPU 将 TPU 作为新的后端添加到 PyTorch。你编写常规的 PyTorch 代码。它附带为 TPU 调优的 Pallas 内核、对分布式训练的支持,以及当你想要更高速度时的 torch.compile 集成。在 TPU VM 上安装它只需一条命令:
pip install torch-tpu --extra-index-url https://download.pytorch.org/whl/cpu
额外的索引为你提供 torch 的 CPU 构建。没有它,pip 会拉取大得多的 CUDA 构建,而你在 TPU 上并不需要。
你最喜欢的库,现在在 TPU 上
Transformers
Transformers v5 围绕一个理念构建:成为模型定义的真相来源,以便它们可以在任何地方运行。“任何地方”现在包括 TPU。要在 TPU 上加载模型,传递 device_map="tpu"。就这样。
from transformers import AutoModelForCausalLM, AutoTokenizer

model_id = "Qwen/Qwen3.5-9B"
model = AutoModelForCausalLM.from_pretrained(
    model_id,
    device_map="tpu", # will load model directly on the TPU
)
tokenizer = AutoTokenizer.from_pretrained(model_id)
inputs = tokenizer("The future of AI is", return_tensors="pt").to("tpu")
out = model.generate(**inputs, max_new_tokens=64)
print(tokenizer.decode(out[0], skip_special_tokens=True))
模型默认以 eager 模式运行。你也可以使用 torch.compile 以获得更好的性能,或在分布式设置中运行。
图像?视频?Diffusers 在 TPU 上绘制它们 🎨
TPU 现在是 Diffusers 中的一等设备。对于原型设计或调试,eager 模式只需要 pipe.to("tpu")。对于部署,编译模式增加一次 compile 调用。你的管道和代码保持不变,也没有需要维护的 TPU 分支。
import torch
from diffusers import StableDiffusion3Pipeline

pipe = StableDiffusion3Pipeline.from_pretrained(
    "stabilityai/stable-diffusion-3.5-medium", dtype=torch.bfloat16
)
pipe.to("tpu")  # eager mode: that's the whole change
# optional: compiled mode
pipe.transformer.compile(backend="tpu", fullgraph=True, dynamic=False)

image = pipe("a corgi astronaut planting a flag on a pizza moon").images[0]
第一次调用会编译,之后每次使用相同图像大小的调用都会重用该图。
模型太大,一个芯片放不下?向 from_pretrained 传递一个 TensorParallelConfig,transformer 在加载时会在芯片间分片,因此完整模型永远不必放在一个地方。许多流行的管道开箱即用支持它,不支持的只需一个 tp_plan 即可。 Diffusers TPU 指南 有完整的配方。
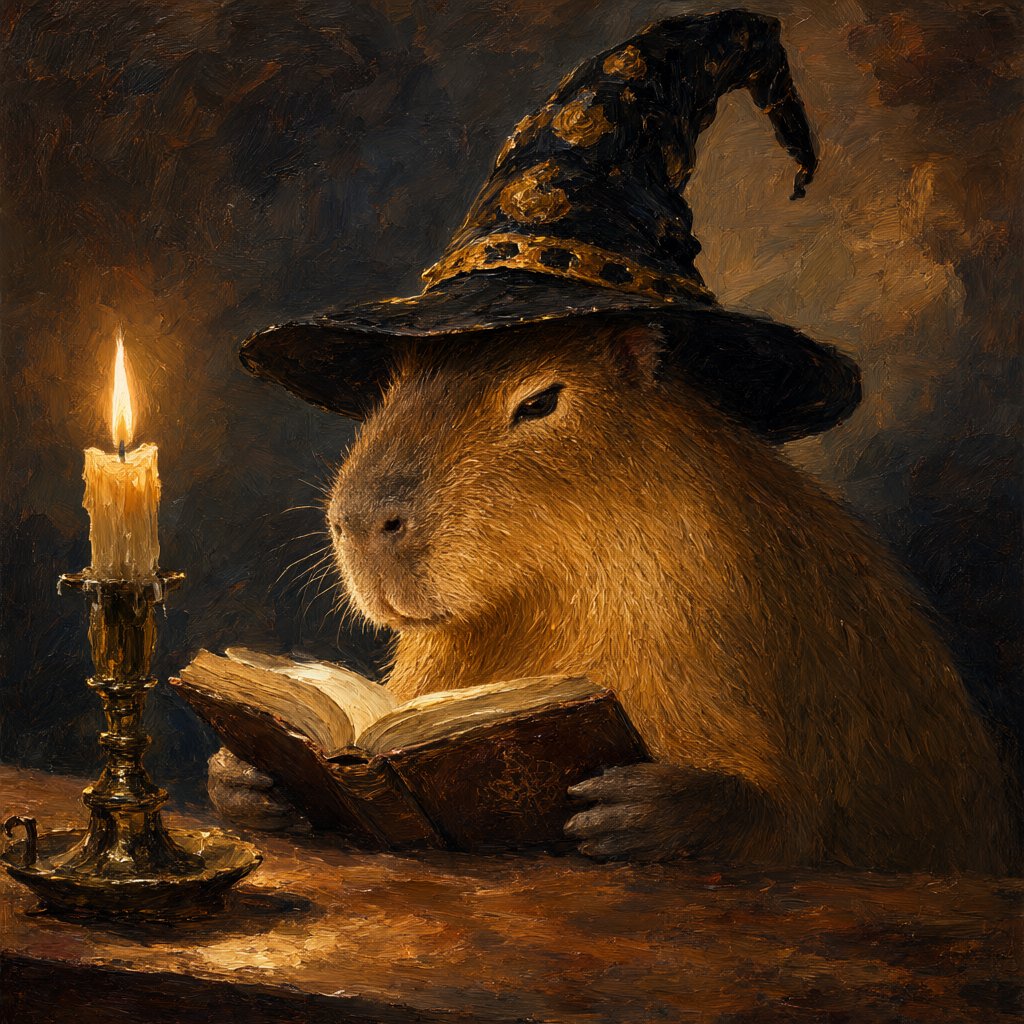
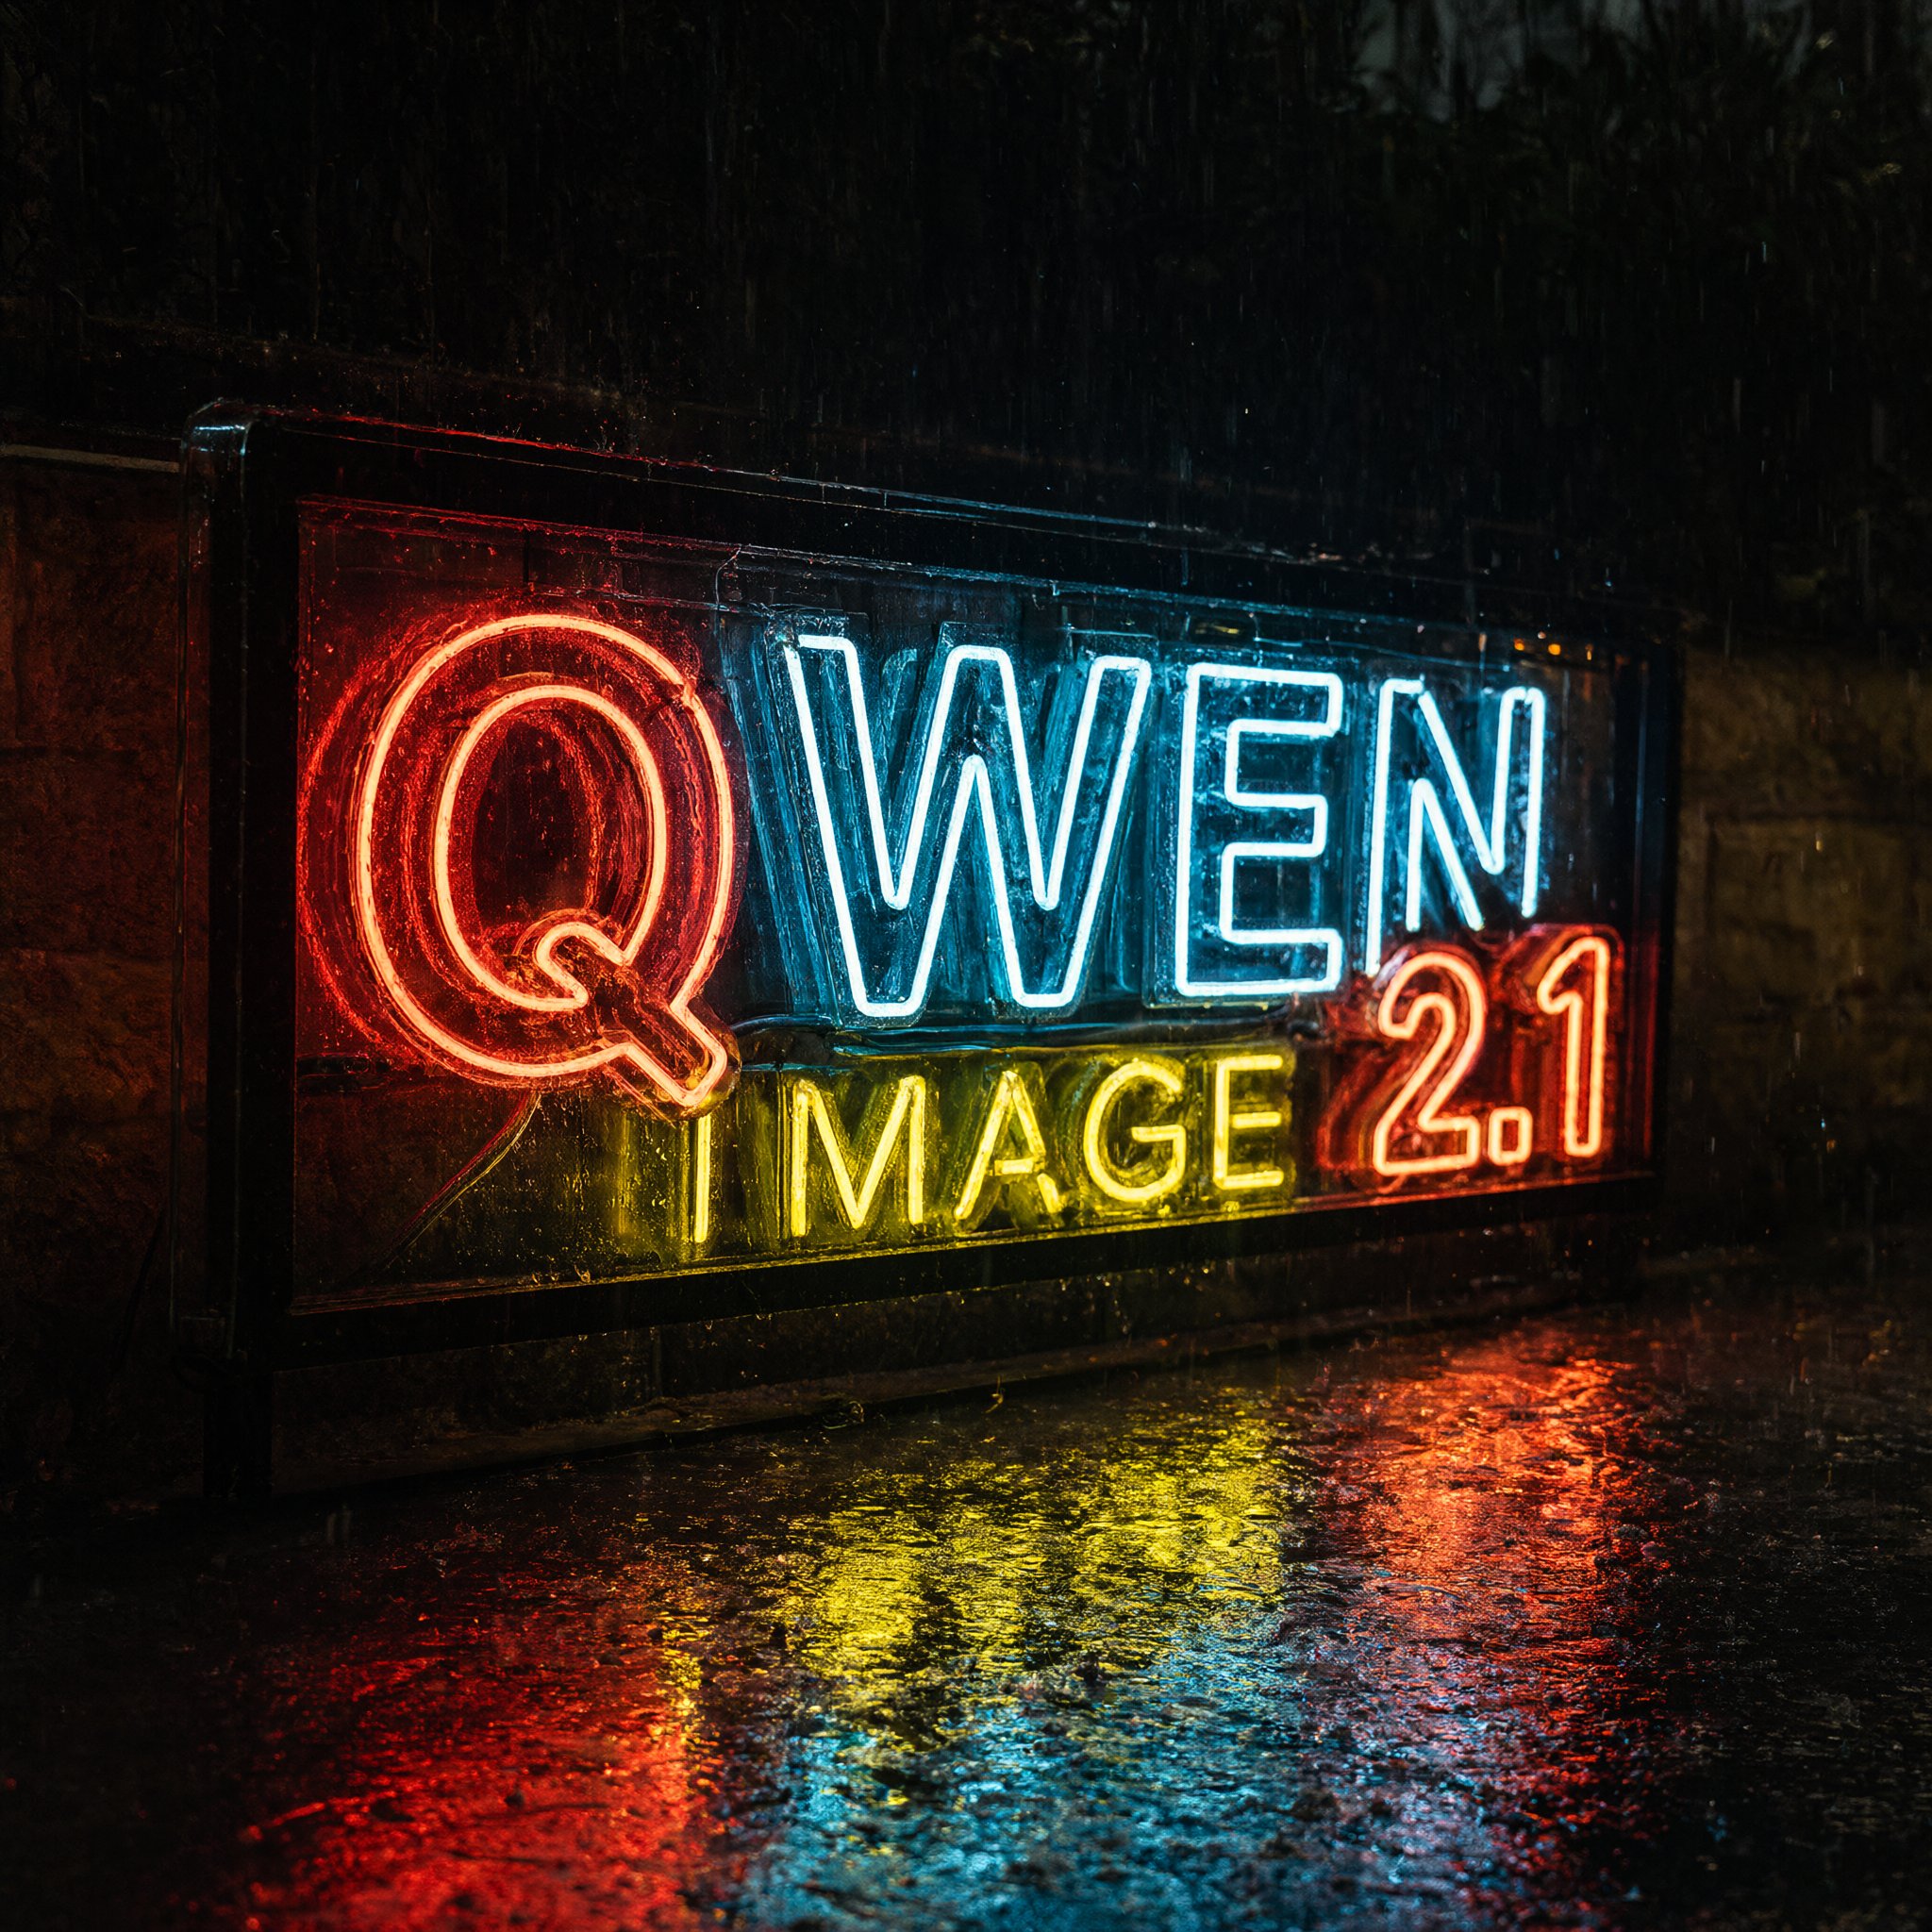
以下是在 Cloud TPU v6e-4 上运行的一些示例:
TP=4(每个模型拆分到四个芯片上) · bf16 · 批次 1
MiniMax-H3(视频 + 音频)
“图片中毛茸茸的 Hugging Face 吉祥物,一个圆圆的黄色笑脸,脸颊红润,两只小手张开,站在古希腊三列桨战船的船头 […] 海浪拍打的声音、木材吱吱作响、索具中的风声、远处的海鸥,以及低沉史诗般的管弦乐渐强。” · 1344×768,5.2 秒,49 步 · 编译 188 秒,eager 262 秒
“一只戴着巫师帽的水豚,在烛光下读书,油画” · 1024×1024,40 步 · 编译 3.5 秒,eager 8.0 秒
“一个霓虹灯招牌,上面写着‘QWEN IMAGE 2.1’,雨夜,潮湿路面上的倒影” · 2048×2048,40 步
Kernels
Kernels Hub 有即用型 TPU 内核。使用 Kernels 库加载一个,为你的模型提速。
TPU 内核用 Pallas 编写,它让你对硬件进行低级控制。你也可以从 Tokamax 库引入内核。以下是一个来自 Tokamax 的 ragged-dot 内核,插入到混合专家模型中:
from kernels import get_kernel
from transformers import AutoModelForCausalLM
from transformers.integrations.moe import ALL_EXPERTS_FUNCTIONS

repo_id = "tengomucho/ragged-dot-tpu"
kernel = get_kernel(repo_id, version=1, trust_remote_code=[repo_id])
ALL_EXPERTS_FUNCTIONS.register("tokamax_ragged_dot", kernel.experts_forward)
model = AutoModelForCausalLM.from_pretrained(
    "Qwen/Qwen3-30B-A3B-Instruct-2507",
    experts_implementation="tokamax_ragged_dot",
)
批次越大,收益越大。在批次大小为 64 时,Qwen3-30B-A3B 上的解码速度快 21.5 倍,Gemma 4 26B-A4B 上快 12.8 倍。
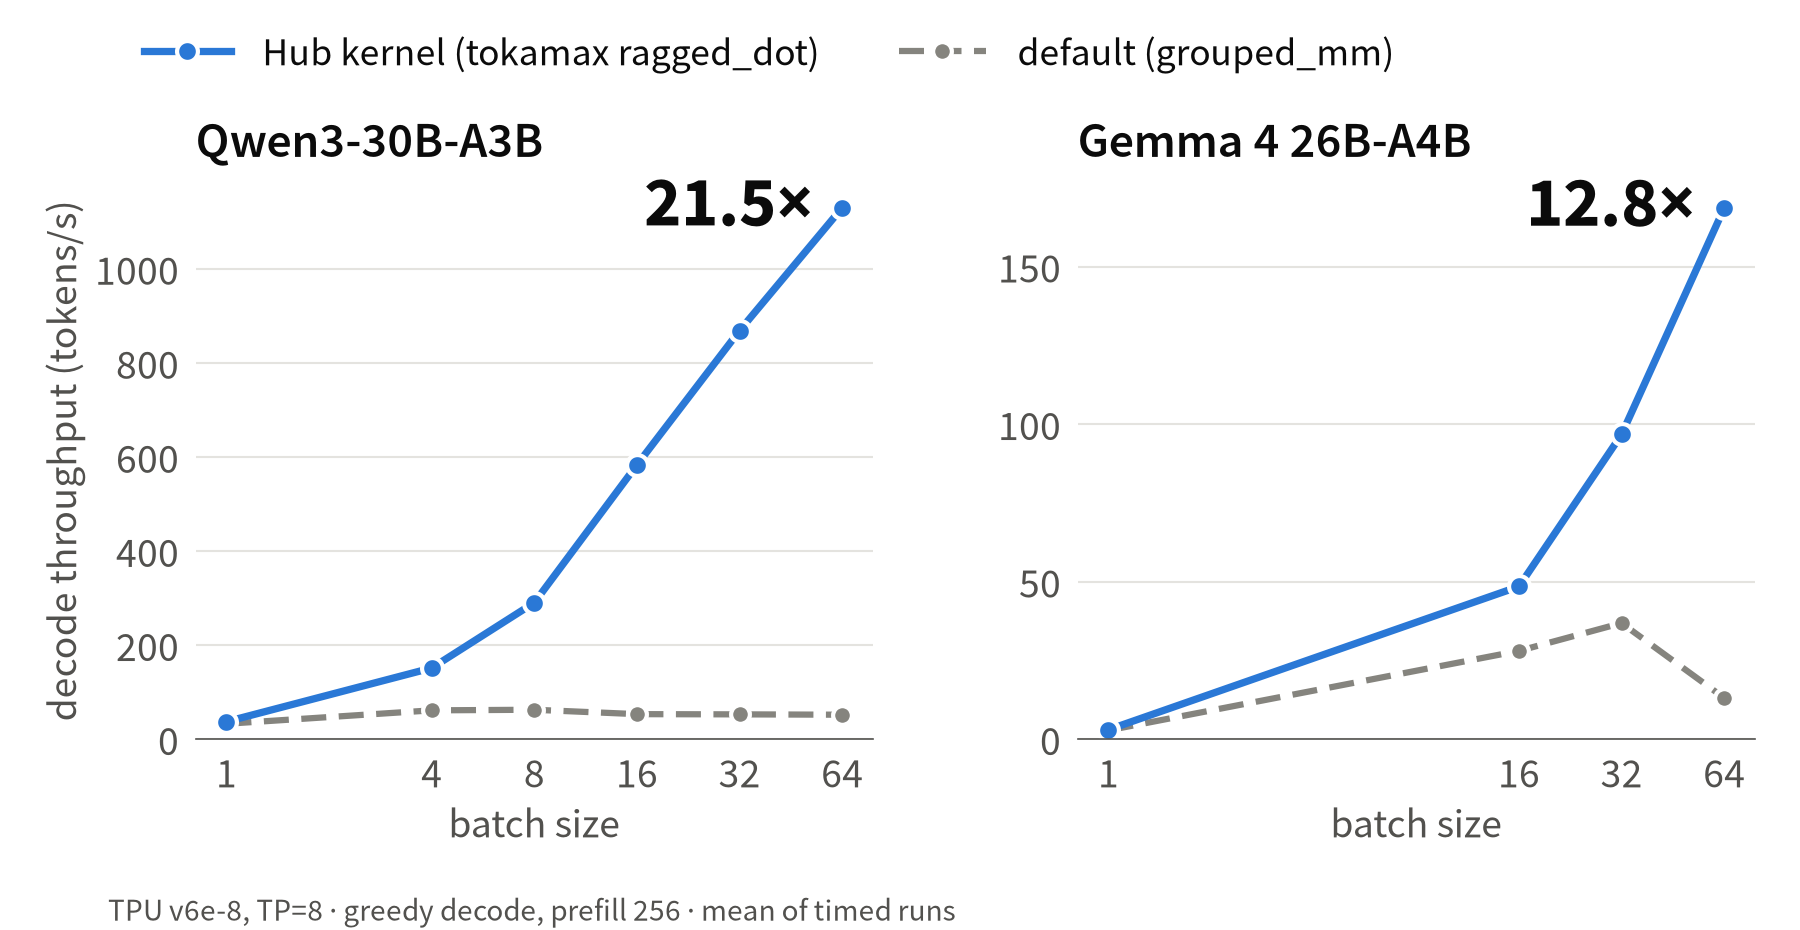
在 TPU v6e-8 上的解码吞吐量,Hub 内核与默认实现对比。
我们测试,所以你不用 🧪
我们通过运行库测试套件不断改进 transformers 中的 TPU 支持。我们正在努力添加 TPU 上的夜间 CI,并在 (transformers 仪表板)[https://huggingface.co/spaces/transformers-community/transformers-ci-dashboard] 中提供结果。
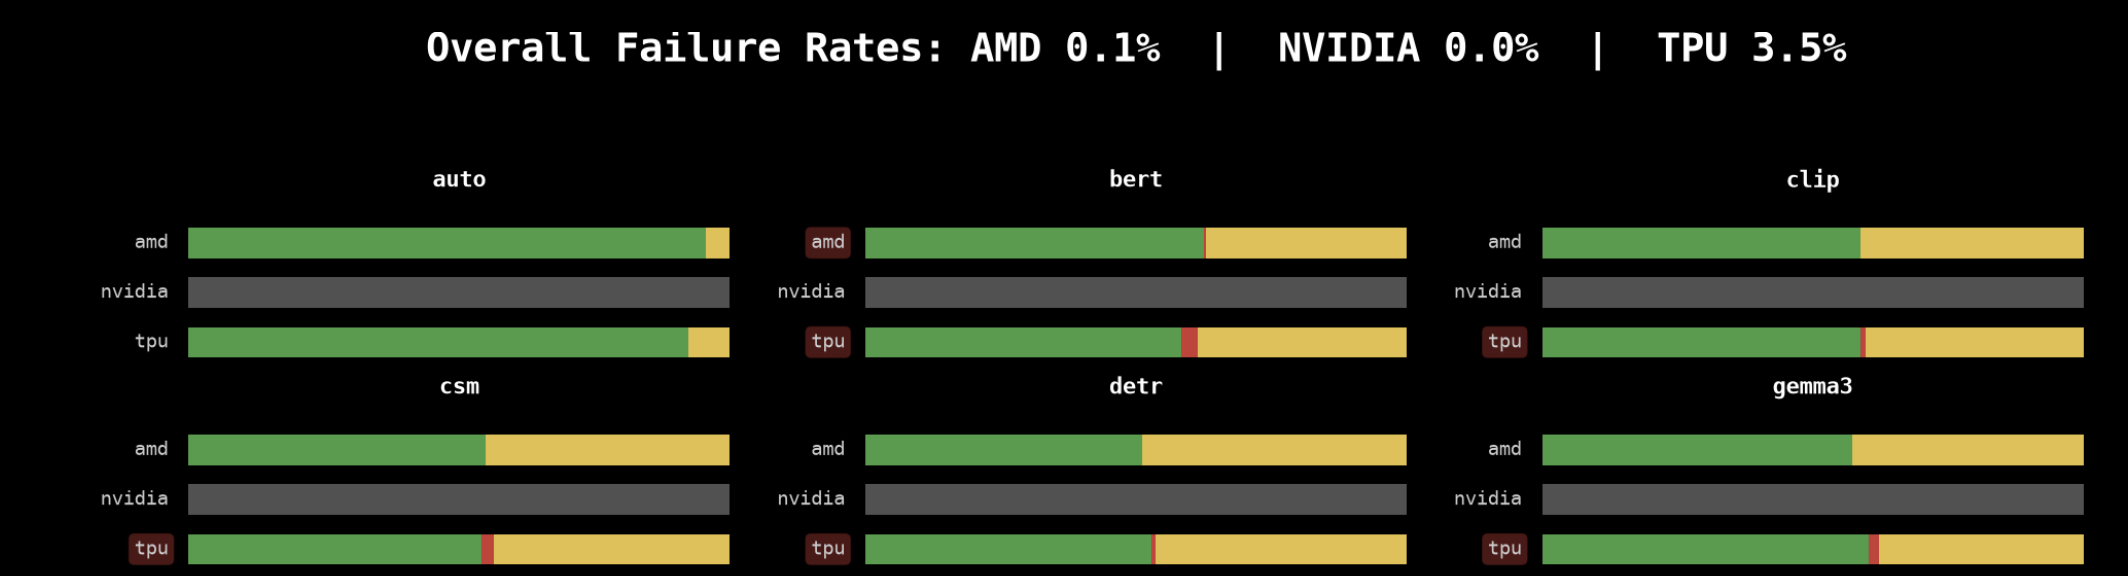
Transformers CI 仪表板,TPU 结果与其他加速器并列。工作正在进行中!
并非全部通过,我们对此表示接受。在 TPU 上运行的测试中,96.5% 通过。我们发现的每个失败都会变成一个小型复现脚本和 TorchTPU 仓库上的一个问题。到目前为止,我们已报告 34 个问题,其中 19 个已修复。在 TPU 上运行还发现了 Transformers 本身的一些错误,例如在 StaticCache 和 Qwen3 张量并行计划中。我们在上游修复了这些。
如果 TPU 上出现问题,我们希望在你之前发现。
开始使用
TPU 不再是 PyTorch 用户的支线任务。安装 TorchTPU,从 Hub 获取模型,并将其发送到 "tpu"。
我们迫不及待想看到你构建的作品 🤗。如果遇到问题,请提交 issue 并告诉我们。