CWE-bench 旨在测试前沿网络能力的极限。在 Collinear AI 持续拓展边界的努力中,CWE-bench v2 公开了包含 100 个任务的公开集合,任何人都可以运行并在其上评估自己的模型。设置与之前相同。智能体获得一个真实开源仓库的检出副本和一段简短指令,目标是在不破坏现有功能的前提下发现并修复一个安全弱点。评分完全程序化,因此结果是确定性的,任何人都可以无额外成本地复现。我们所有的程序化检查都在 LLM 评审小组的帮助下进行了整理,使其朝着难度与公平性的方向调整。我们还维护了一个留出集,以便持续跟踪模型从未见过的任务上的进展。要在留出集上评估你的模型,请联系 cyber@collinear.ai。
我们的目标是做到穷尽。防御者必须预判攻击者可能进入的方式,并且每一次都要做对。这 100 个任务覆盖 91 种不同的 CWE,横跨广泛的漏洞类别。在这里表现良好的模型必须理解潜在攻击者可以利用的多个弱点面。仅仅识别熟悉的模式是不够的。
作为我们持续改进质量的细致努力的一部分,我们对每个任务都检查了以下问题是否成立:
- 指令读起来是否像一条真实的指令,而不是评估设置?
- 每一个被评分的行为是否都能从指令中推断出来?
- 验证器检查的是正确行为,而不是某一种修复的特定结构?
- 起始代码是否失败,而参考修复是否通过?
- 原始功能在新的修复下是否仍然正常工作?
- 验证器是否会让记忆化的解法(例如已知的上游补丁)失败?
每个任务也都经过了人工审查。开源该集合是同一项改进质量努力的一部分。我们欢迎对任何任务提出反馈,也欢迎向公开集合贡献。
结果
结果在 Hub 上的两个地方进行跟踪。CWE-bench 数据集页面上的排行榜覆盖开放权重模型,并会自动更新:实验室和社区通过在模型仓库上提交包含结果文件的 PR 来添加结果(方法)。如需完整对比,包括 Gemini、Claude 和 GPT 等仅 API 模型,请参见 CWE-bench 排行榜 Space,新模型通过在该 Space 上提交 PR 来添加。
开放权重模型,来自数据集页面:
所有已评估模型,包括仅 API 模型:
▶ https://collinear-ai-cwe-bench-leaderboard.static.hf.space
在评估的 11 个模型中,Gemini 4 Argon 以 67.8% 的 pass@1 和 81.0% 的 pass@4 领先,略高于 Claude Opus 5.5(67.3% pass@1,78.0% pass@4)。有 95 个任务被至少一个模型解决,这表明这些任务确实可解。然而,即便是领先者在每次尝试中也会在该集合上失败 19%,因此长尾远未解决。公开集合、评分器和测试框架都是开放的。运行你的模型,并告诉我们它处于什么位置。
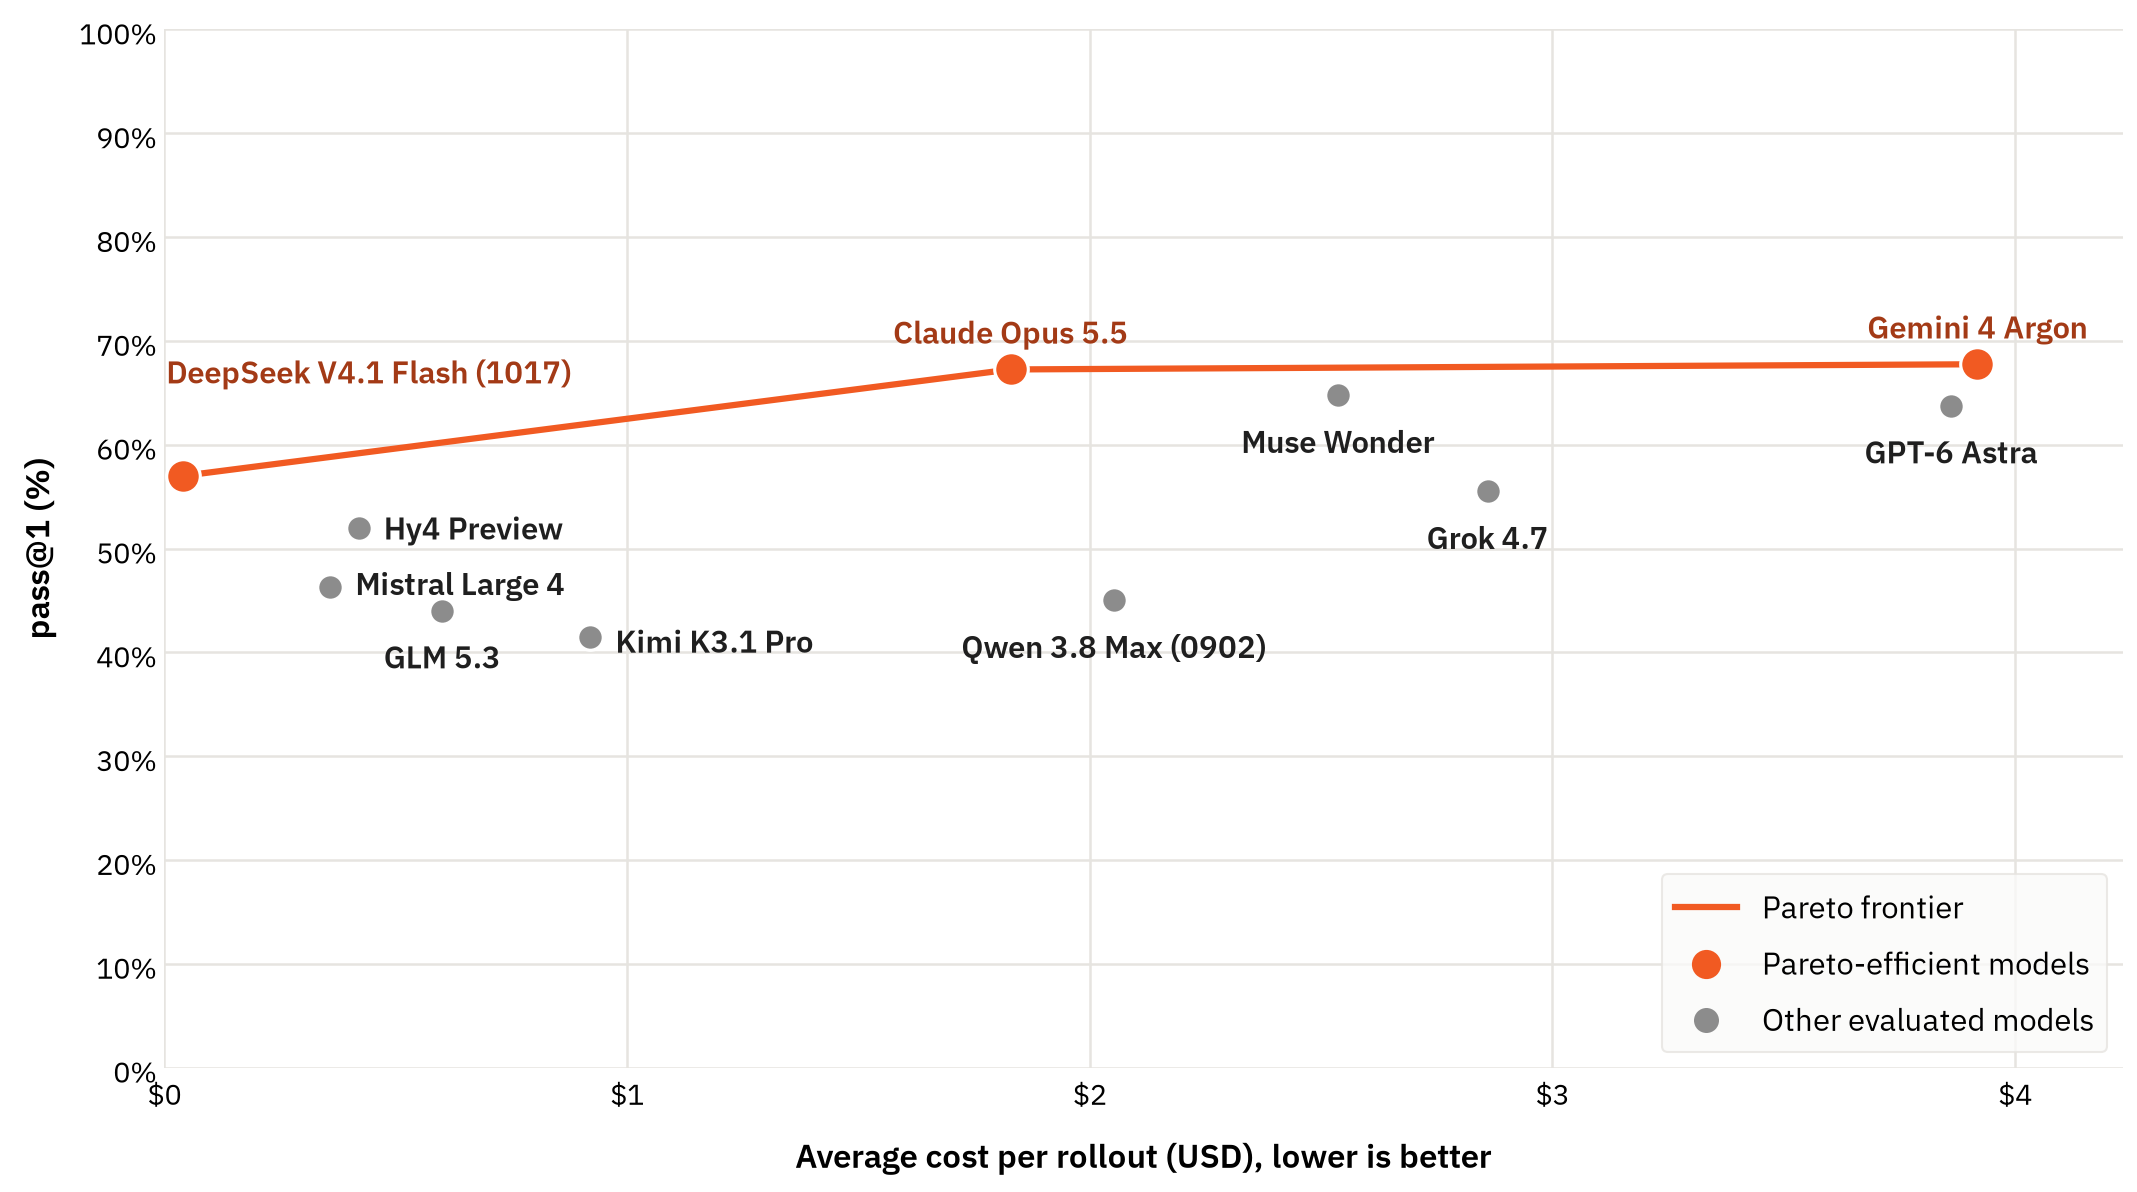
在成本方面,DeepSeek V4.1 Flash(1017)、Claude Opus 5.5 和 Gemini 4 Argon 构成帕累托前沿:DeepSeek 以每次 rollout 0.04 美元达到 57.0% pass@1,Opus 以 1.83 美元增加十个点,Gemini 以 3.92 美元略微领先。
从 Hub 运行
每个任务都是一个自包含的 Harbor 任务(一个 Docker 化环境、一条指令和一个确定性验证器),数据集附带一个 registry.json。因此 Harbor 可以直接从 Hugging Face 仓库运行整个基准测试,无需你自己克隆任何内容:
harbor run --repo "https://huggingface.co/datasets/collinear-ai/cwe-bench" -d cwe-bench@2.0 -k 4 \
  --agent <agent> --model <model> --env docker \
  --allow-agent-host <model API host>
-k 4 对每个任务运行 4 次尝试,报告分数是全部 400 次试验的平均奖励。数据集是受限的:请先在数据集页面接受其访问条件。Harbor 使用 git 获取任务,因此还需将你的 HF token 保存到 git 的凭据助手一次:
hf auth login --token $HF_TOKEN --add-to-git-credential
这些任务也被标记为 rl-environment:相同的环境和验证器可以为训练防御性智能体提供奖励,而不仅仅是用于评估它们。