通往 Linum v3 之路· 第 04 期之前:P-JiT
在上一篇博客中,我们迭代到了 P-JiT,这是一种像素空间架构,它将注意力上下文窗口减少了 4 倍,同时收敛所需的样本数减少了 11 倍。在这里,我们用 660M 个样本训练 P-JiT(计算成本仅为 2.1 万美元),作为迈向更大规模视频模型的垫脚石。
研究发布 · Apache 2.0
249 个样本 · 2B Pyramid-JiT
点击任意图片查看全分辨率及其提示词
对 Pyramid-JiT (P-JiT) 进行压力测试
对我们来说,这次 2.1 万美元的训练运行是通往下一个视频模型途中的概念验证。考虑到模型的规模,我们对结果看起来如此之好感到惊讶,因此我们想将其作为实验性发布与世界分享。
如果你之前没有关注过我们的工作,我们想退一步介绍一下自己。我们是一个 2 人研究实验室,完全从头开始训练自己的生成式视频模型。最终目标是让动画创作民主化的创意工具。你可以在这里阅读更多相关内容。
如今,生成式视频模型有两个主要缺陷:它们太慢/太贵,并且缺乏适当的控制。创造力是一个迭代过程。你制作,你调整,你变得更好。有了这双重打击,视频模型(就目前而言)对于讲故事来说实际上是无用的。
今年早些时候,当我们开始构建 Linum v3 时,主要目标是大幅降低推理的成本范围。如果我们的模型又快又便宜,那就是迈向有用创意工具的第一步(众多步骤之一)。
我们已经详细撰写了我们在这个方向上采取的步骤,但长话短说:
- 视频训练和推理的瓶颈是注意力,O(n²)。 如果我们能更积极地压缩,我们将减少注意力的上下文窗口,从而大幅削减训练和推理的成本。
- 通常,压缩由像变分自编码器这样的单独专用模型处理,但这不一定是最优的。 VAE 在可实现的压缩量上似乎有一个经验上限。还有其他方法可以获得更多压缩,但它们需要对传统 VAE 进行大量改造(例如 Minimax 的 H3 中的 2B 解码器)。更重要的是,改进 VAE 在其重建任务上的表现可能会在下游扩散模型中产生更差的生成结果。
- 如果完全摆脱 VAE,你应该能够更积极地压缩并更快地学习。 扩散模型是比 VAE 更强大的生成模型家族。我们应该能够利用它们同时进行压缩和生成。扩散模型不应使用另一个模型的潜在空间,而应学习一个为其用例专门构建的潜在空间。反过来,我们应该能够从这种压缩中榨取更多汁水。
在上一篇博客中,我们迭代到了一种新架构,我们称之为 Pyramid-JiT (P-JiT)。这是一个像素空间模型,其收敛所需的样本数比 Linum v2 少 11 倍,同时 token 减少更积极 4 倍(即,我们用过去表示 256² 图像相同数量的 token 来表示 512² 图像)。Linum v2 是一个相当标准的 Wan VAE + DiT 扩散模型。Linum v2 像大多数模型(例如 FLUX-2)一样使用了 16×16 的 token 减少。P-JiT 实现了 32×32 的 token 减少。这意味着注意力上下文窗口减少了 4 倍。
关于我们如何实现这一目标的详细信息,我们建议你看看我们之前关于 JiT-DDT 和 P-JiT 的博客。但概括来说,我们为像素空间模型找到了一种噪声调度,帮助模型更好地学习细粒度细节。而且,我们在 DiT 的主干上添加了读出层。
REPA、RAE-v2 和 Self-Flow 中的相邻工作都指向 DiT 早期块中的弱梯度。通过在像素空间中操作,我们 DiT 的每个块实际上都在预测最终图像的一个版本,因此我们可以通过预测最终图像的低分辨率版本来增强网络早期的梯度信号。这有助于加速收敛。
该架构在我们的初步实验中表现良好,但我们想看看当我们训练更长时间(即约 600M 样本而不是 50–100M 样本)时的表现。作为背景,生成式视频模型几乎总是从生成式图像模型开始。你必须先学习名词(人、地点、事物),然后才能学习动词(动作、运动)。这是通往更大模型(和视频)途中的一种压力测试。
训练方案
Pyramid-JiT (P-JiT) 架构概述
尺寸读取 512² 阶段 / 1024² 阶段 · 花 = 一个说明性目标采样时 2.18B 参数 · 紫色头仅用于训练,增加约 0.24B,训练时约 2.42B
文本和图像各自通过两个单模态“精炼器”DiT 块,然后合并成一个由 22 个相同 DiT 块组成的流。文本表示来自一个冻结的 Qwen3.5-4B 模型,我们在第 7、15 和 27 层(其三个全注意力层)读取它。我们将这些表示连接并投影到文本精炼器中。图像被分割成 32×32 的补丁,并压缩到 1024 维空间,然后被投影到图像精炼器块中。这是 3:1 的压缩率。一个带有 RGB 值的 32×32 补丁是一个 32×32×3 = 3,072 的表示,它被投影到 1024 维。
在第 5 个块处,我们有一个 2 层 PixelREPA 读出,将模型的潜在空间与 DINOv3-L 对齐。我们屏蔽隐藏状态中 20% 的 token,并将其通过一个 2 层 transformer 来预测同一图像的 DINOv3-L 特征表示。我们在第 10 和第 16 个块之后的主干上有两个线性读出头。如前所述,它们分别预测四分之一和一半分辨率的干净图像。总损失由读出处的 MSE、PixelREPA 余弦距离、最终输出头处的 MSE 以及全分辨率图像上的感知损失(LPIPS 和 P-DINO)给出。
一个 DiT 块:主干中 22 次,每个精炼器中 2 次
蓝色 = AdaLN · s 在注意力/FFN 之前缩放输入,g 门控其残差写入隐藏大小 2,944 · 23 个头 × 128 · FFN 内部宽度在主干中为 5,376,在精炼器中为 2,816
每个 DiT 块通过低秩 AdaLN 以时间步为条件,遵循 Z-Image。时间步嵌入经过一次下投影到 256 维。图像精炼器和主干共享一个下投影;文本精炼器有自己的下投影。然后每个块都有自己的上投影到一个缩放和一个门,零初始化,因此每个块开始时都是恒等映射。
如我们上一篇博客所述,我们在噪声调度上采用课程学习。在前 8000 万个样本中,我们集中在高噪声,以便模型学习基本结构。然后,在剩余训练时间内,我们扩大噪声分布,以便它学习细粒度细节。详见 附录 A。
我们从 512² 到 1024² 分几个阶段训练模型
H100-小时
512² · 01024² · 0
0
已见样本
512² · 0M1024² · 0M
0M
在固定的一组 20,480 张方形图像上,每个阶段分辨率的验证损失。在 8000 万处实时峰值到 0.157 是时间步调度扩大后的第一次评估。x 轴在 5.5 亿后变宽,以便冷却和 1024² 阶段清晰可读;条形按比例缩放。
我们在 100M 样本时开始 EMA,因此模型已经学习了结构和细节的良好表示。当我们切换到 1024² 时,我们使用新的优化器并从 512² EMA 权重恢复训练。在 1024² 时,我们将噪声尺度从 2 加倍到 4,以考虑信息的冗余(见 JiT,附录 A)。更高的噪声水平和在高分辨率下精确再现细节的需要导致整体损失更高,即使图像质量迅速提高。我们在分辨率过渡中使用 RoPE 插值。我们保持一个与 512² 对齐的固定网格,并将 1024² 补丁索引乘以 ½ 以将它们对齐到 512² 坐标轴。此外,我们在 2M 样本时开始 1024² EMA,以便在我们开始平均过程之前它已经适应了新分辨率。
对于后训练,我们使用了 有限差分流优化(FDFO) 的变体,结合 JEV-Image 和人在回路评判。
整个发布花费约 $21K 的计算
预训练
$20,348
8,139 H100-小时 × $2.50
在 512² 下 610M 样本,然后在 1024² 下 50M
后训练
$690
276 H100-小时 × $2.50
使用 JEV-Image 和人在回路评判的 FDFO
总计
$21,038
$20,348 + $690 · 8,415 H100-小时
在 64 个 H100 上预训练,包括重启,按每 H100-小时 $2.50 计价
扩散模型的后训练仍处于早期阶段
坦率地说,后训练在扩散模型中是一个非常年轻的学科,在过去几个月中我们只看到了它起作用的第一个火花。
当然,在模型和调度蒸馏方面已经有很多工作,但当涉及到提升基础模型能力的后训练(就像我们在过去 18 个月中在 LLM 的编码方面看到的那样)时,对于扩散模型来说,它还没有真正实现。
DPO 已经存在一段时间了,但往往会对特定的美学选择过度拟合。Flow-GRPO 是将 RLVR 风格框架引入扩散模型的最早阐述之一,而它去年秋天才出现。从那时起,有一些论文如 Diffusion NFT 和今年六月的 FDFO(我们认为这是迄今为止对扩散后训练的最佳阐述)。
我们认为适应这些技术的困难归结于这样一个事实:我们无法像在自回归 LLM 中那样在扩散模型中获得强大的似然估计。我们将在未来几周深入探讨这些问题以及我们完整的后训练栈。
模型局限性
此模型未使用渲染文本的图像(无信息图、PDF、书页、PowerPoint 幻灯片)进行训练,因此它无法书写文本或生成海报。正如我们在数据过滤博客中详述的那样,我们认为这些数据对我们动画工具的最终目标没有用,因此这些文本密集型数据已从我们的数据集中完全过滤掉。
这是一个小模型(2B 参数的 DiT,4B 文本编码器),因此模型在几个方面表现不佳:全身、许多实体(例如 6 辆车、人群)、多人互动和世界知识。模型有时能够正确生成这些图像。训练更大的模型(例如 7B 参数)和进一步的后训练可能会缓解这些问题。
模型失败示例
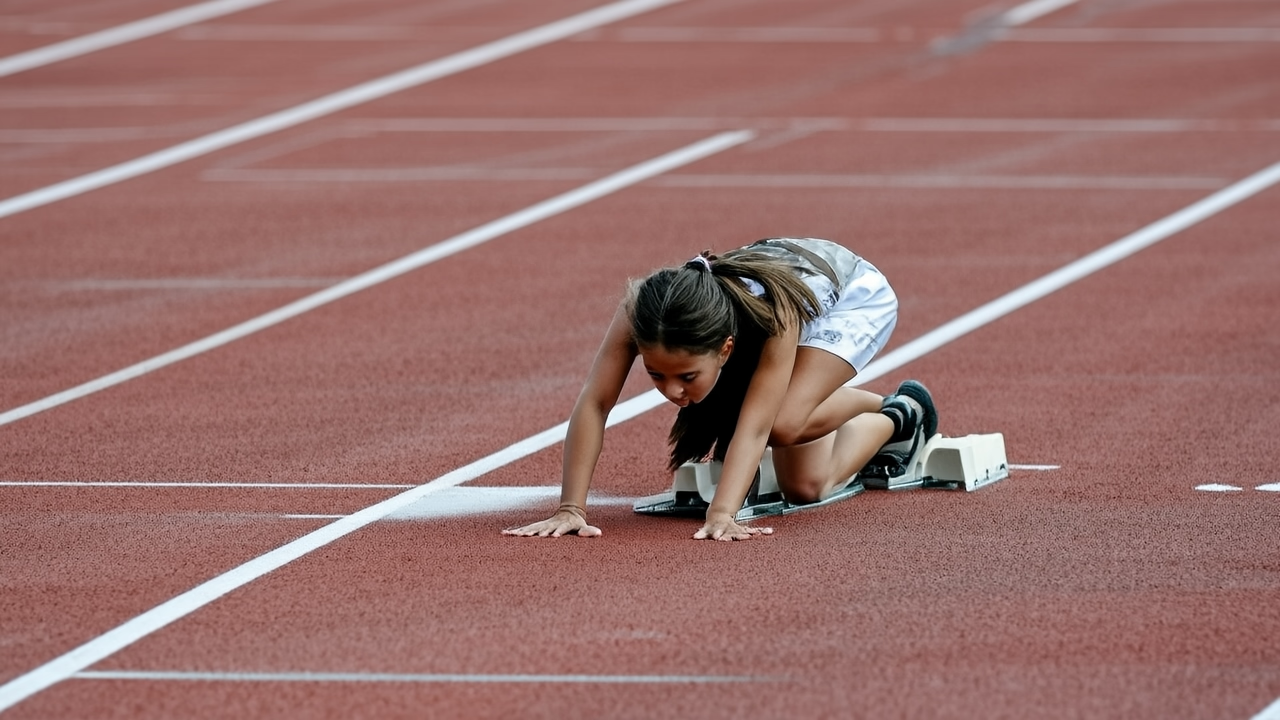
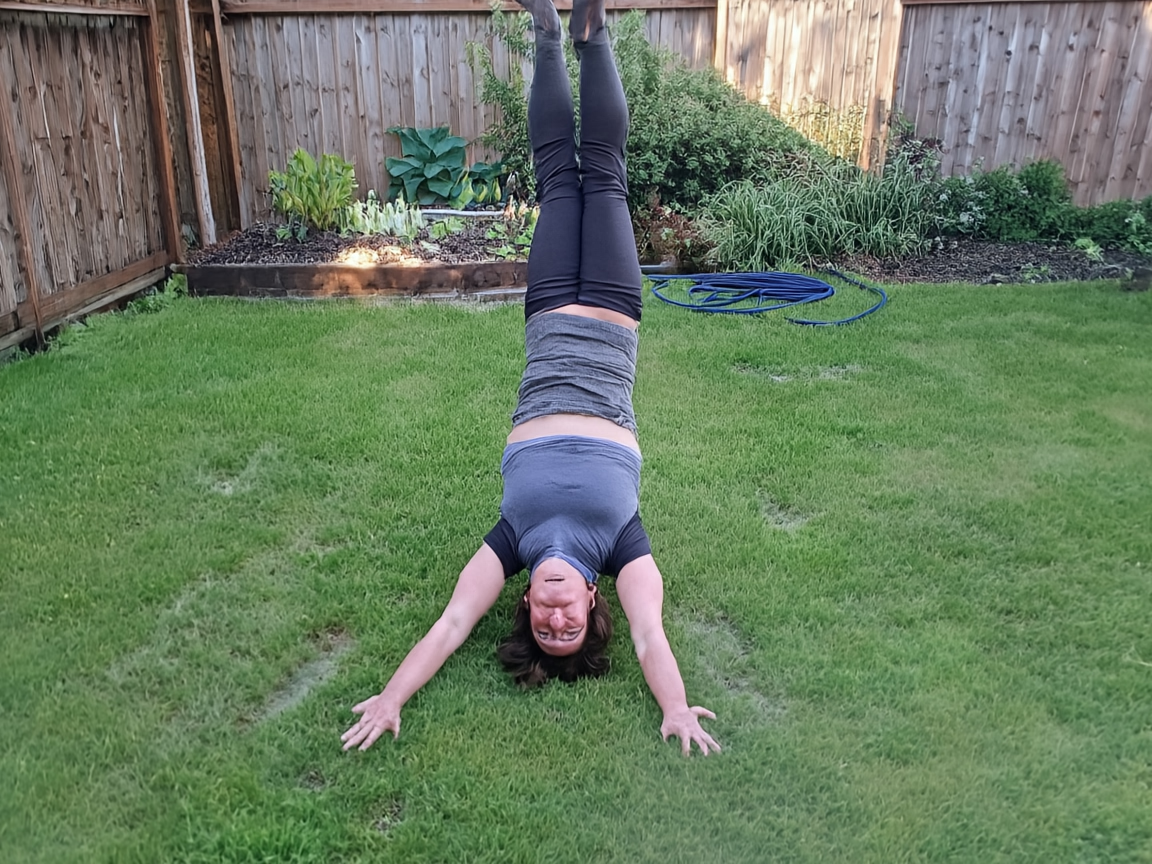
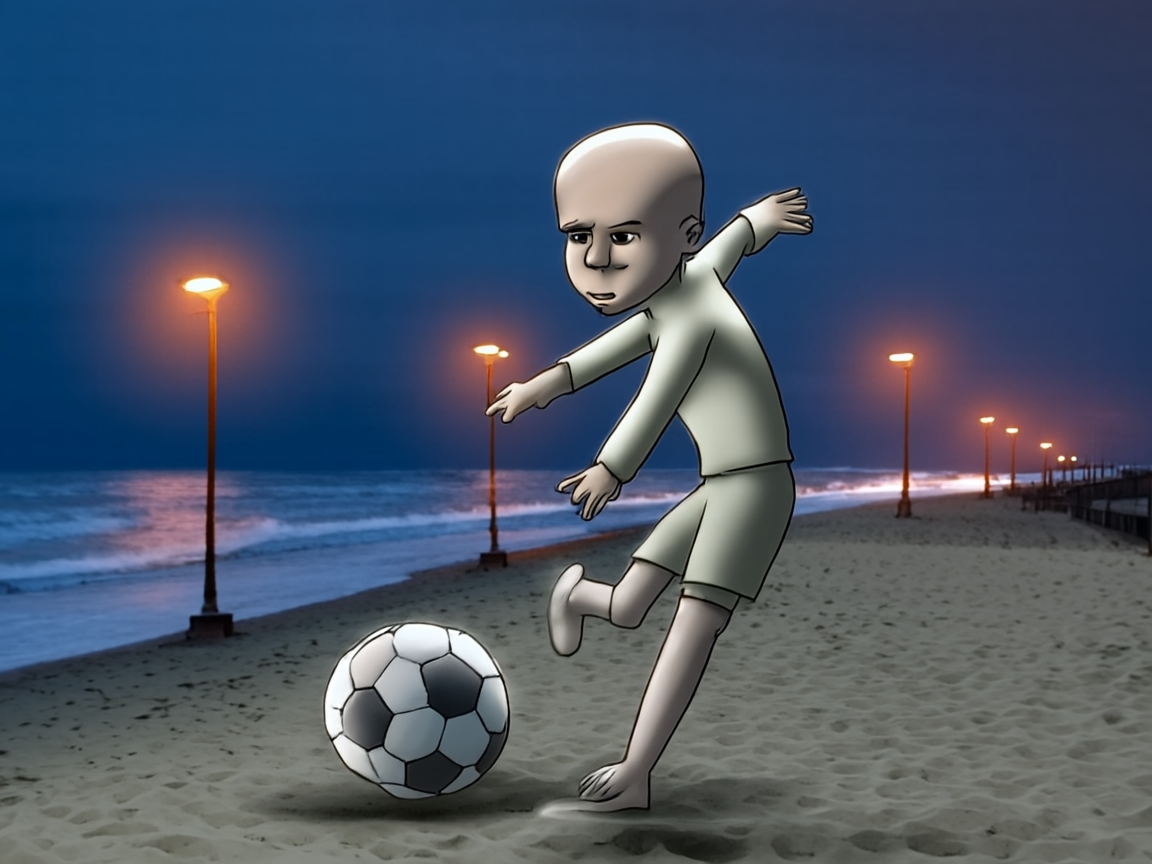
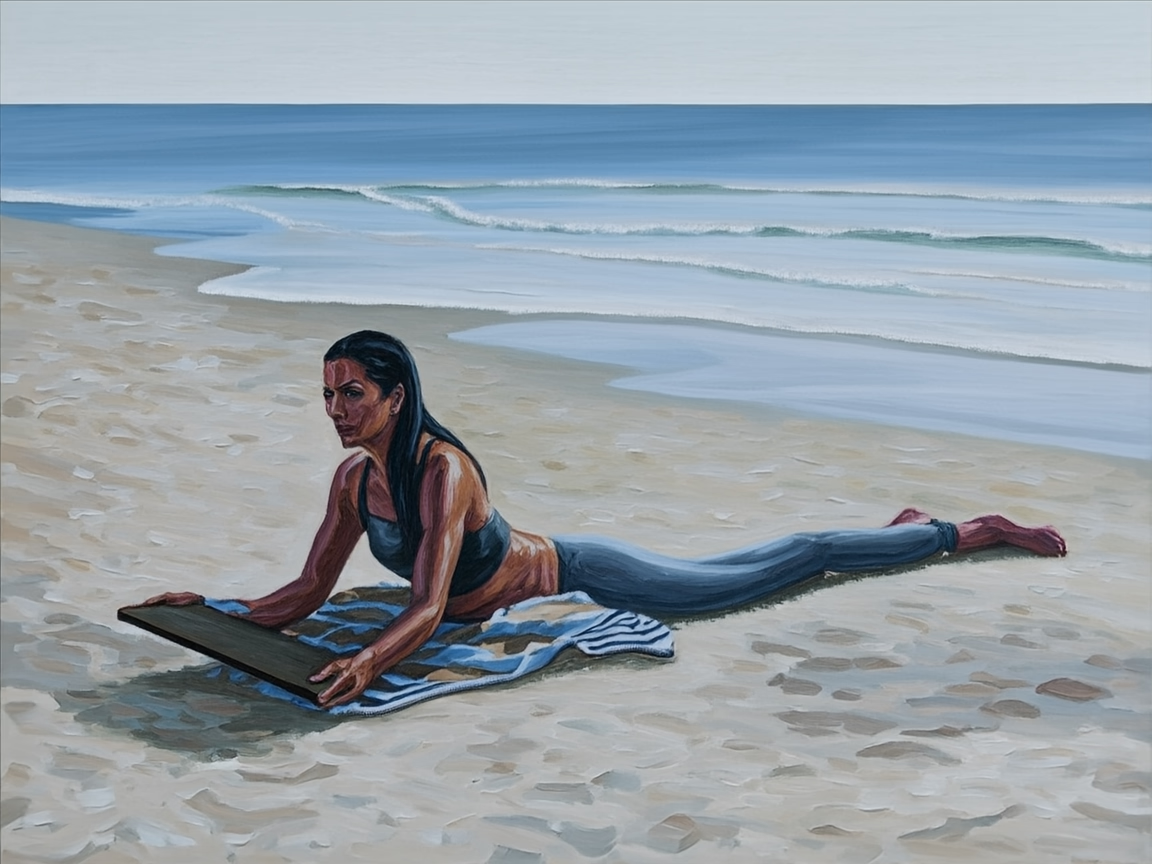
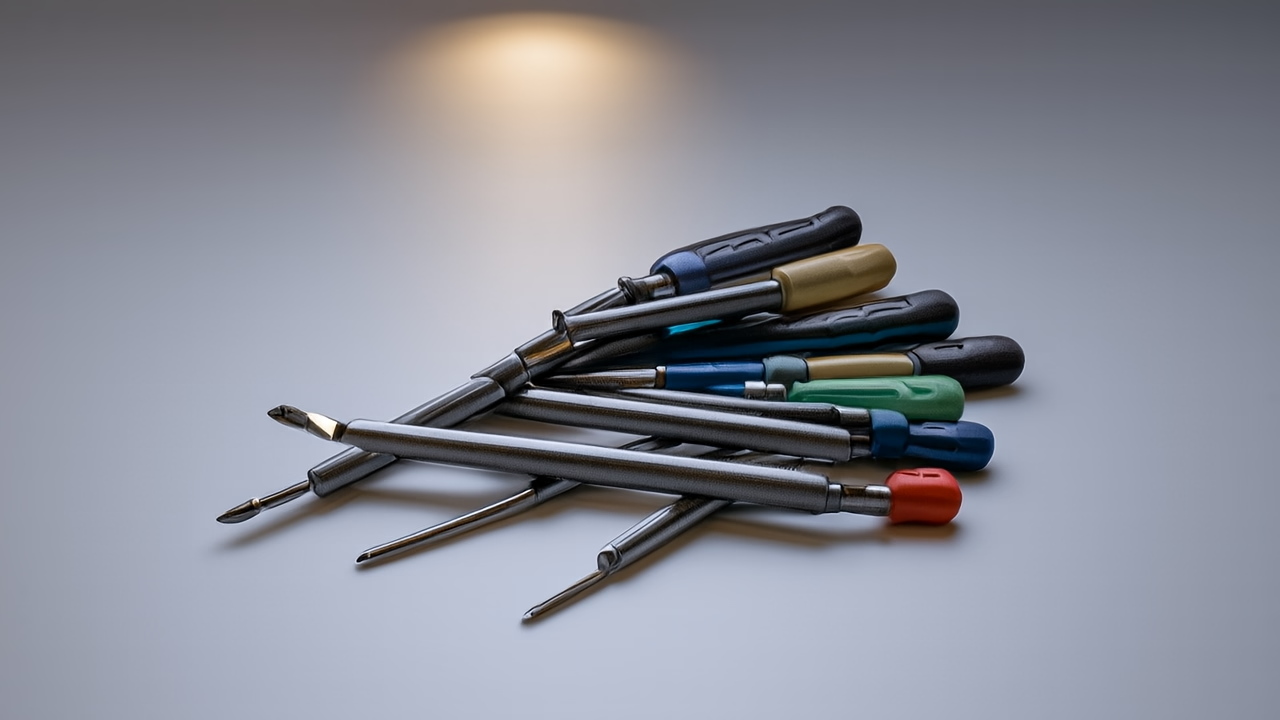
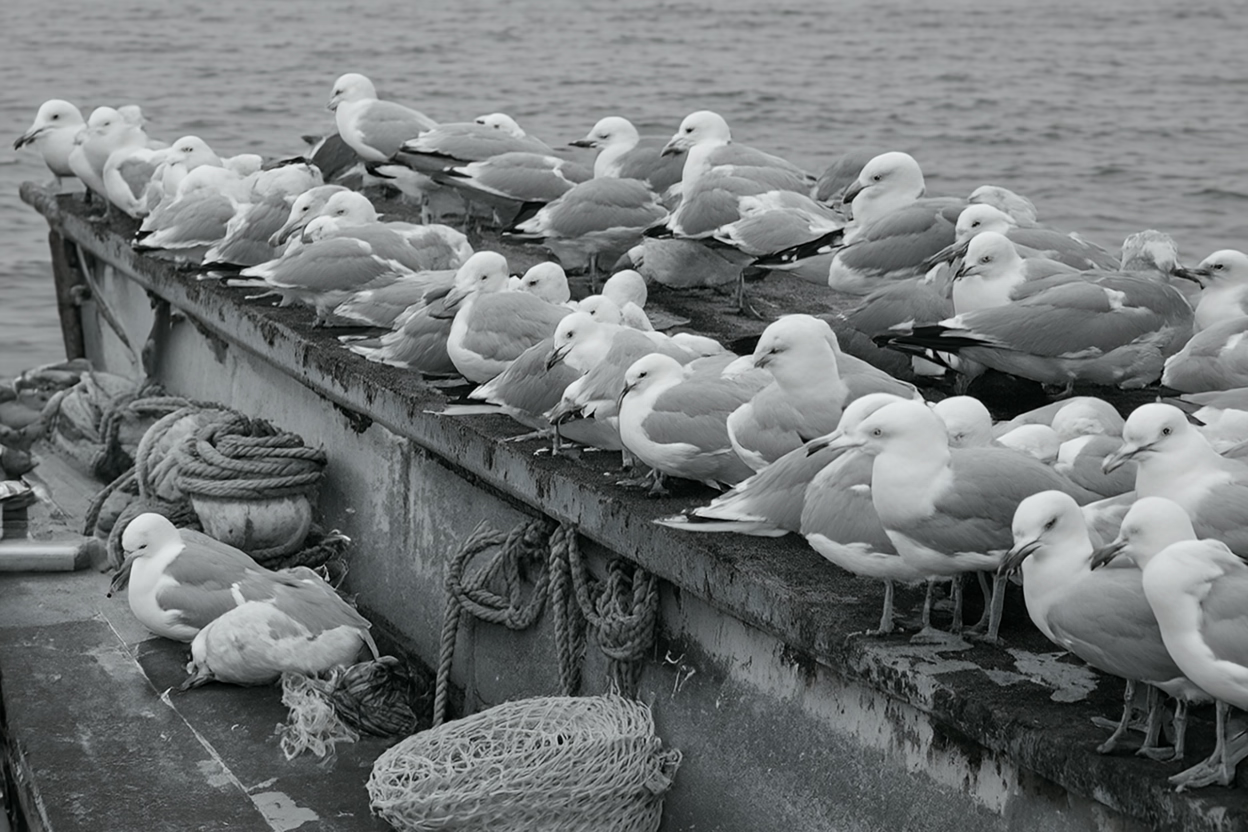
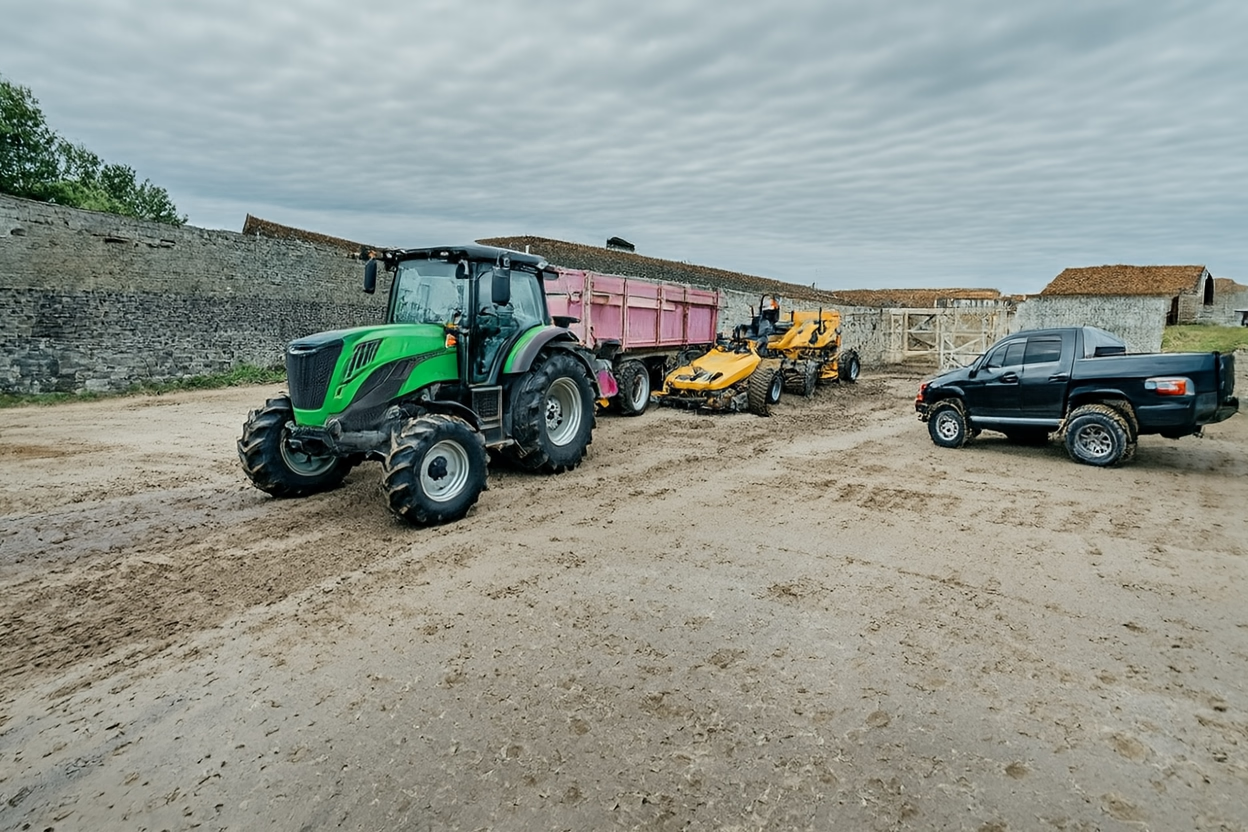
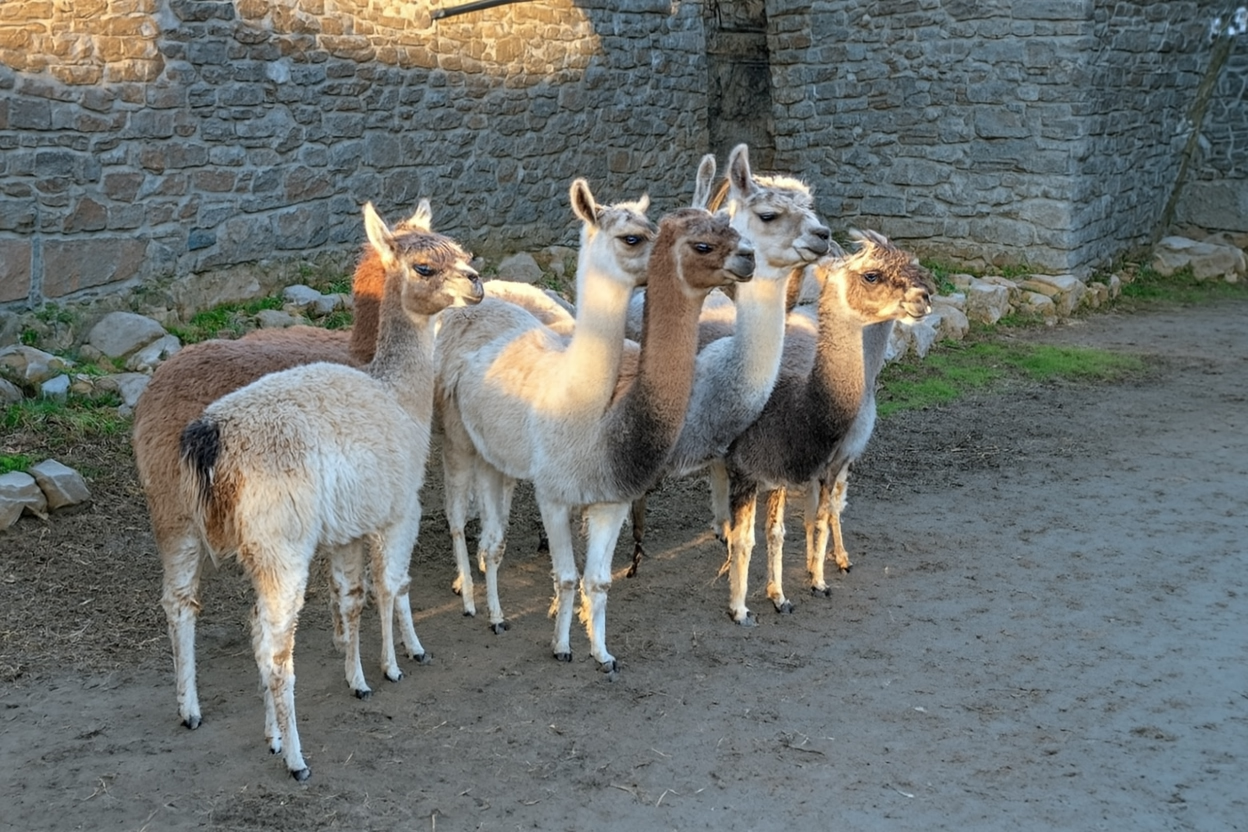
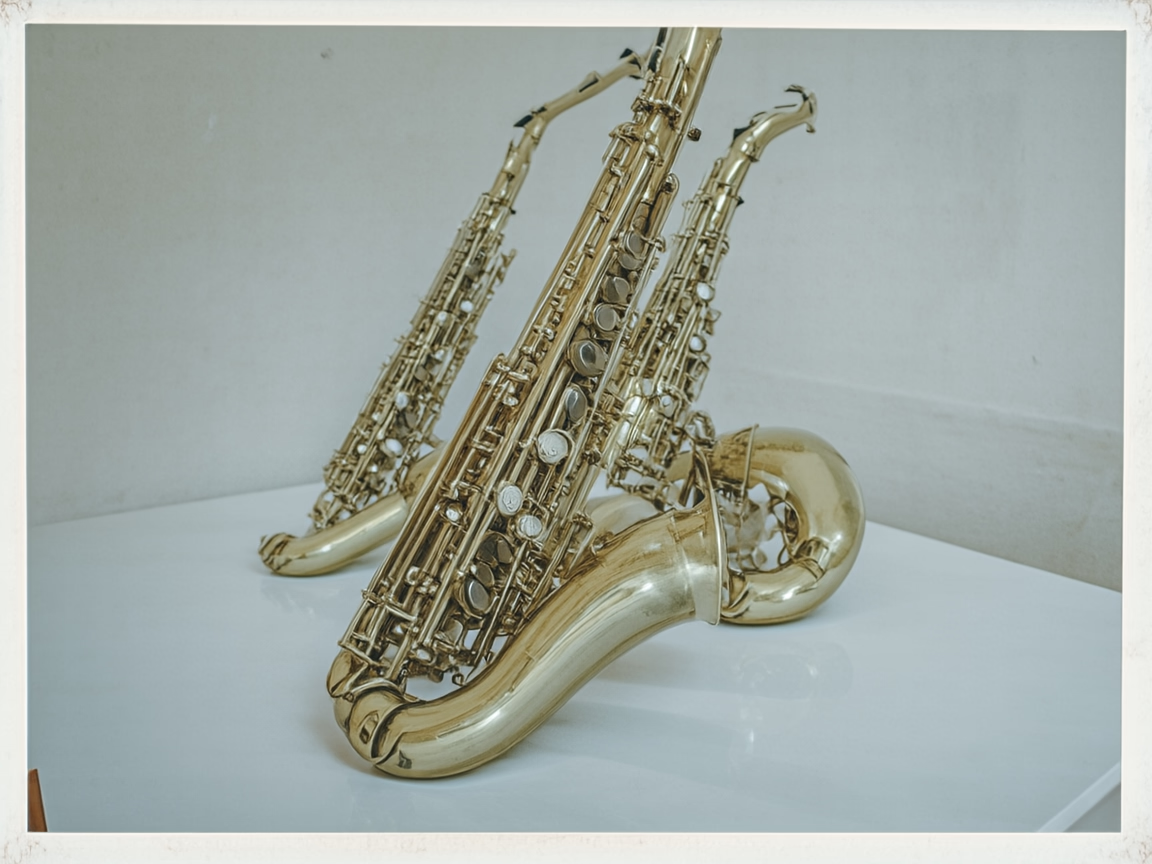
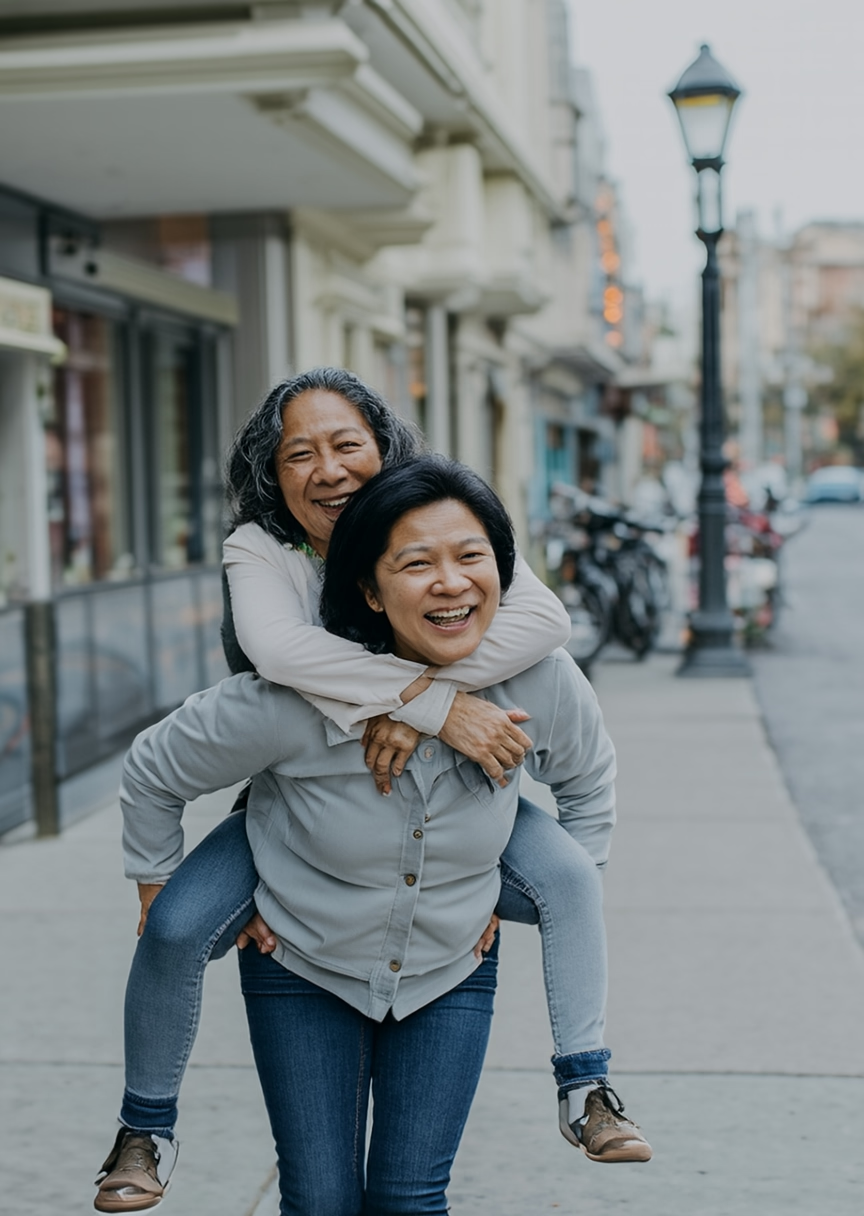
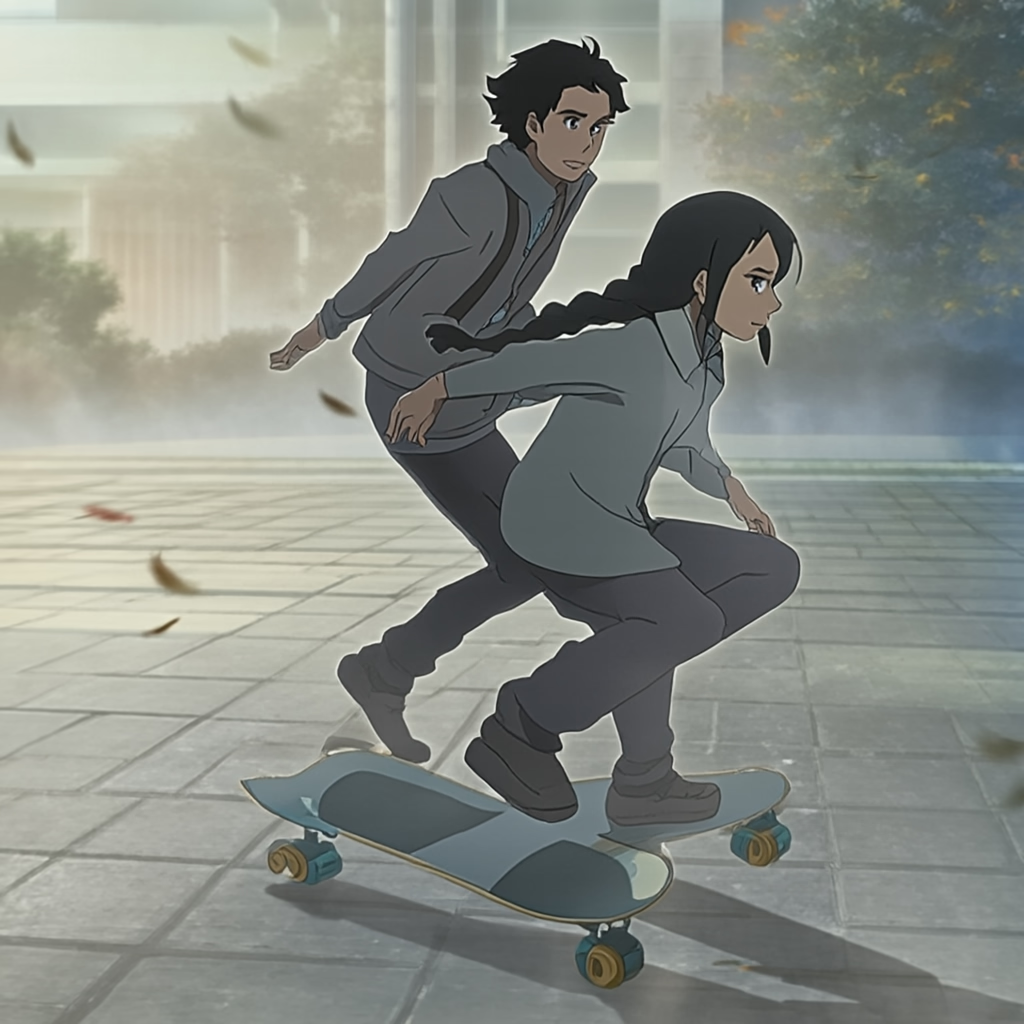
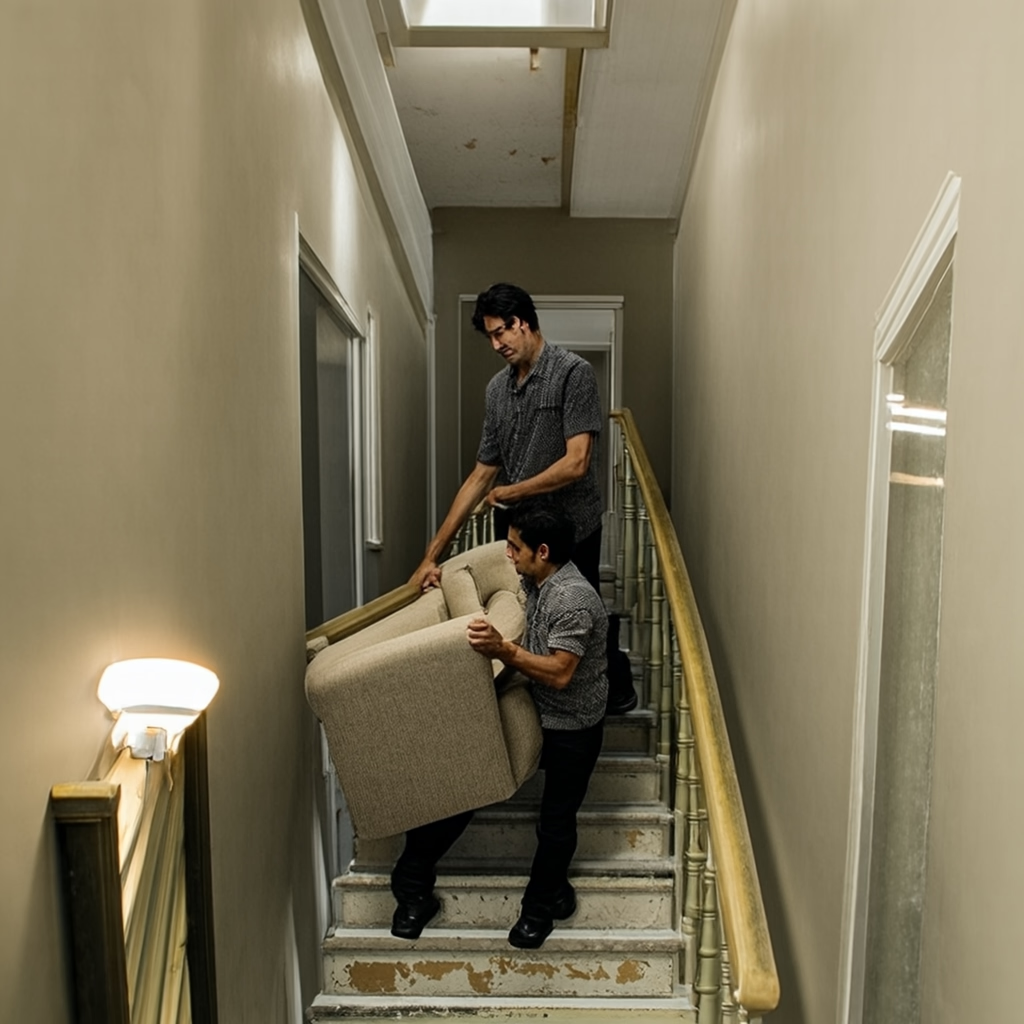
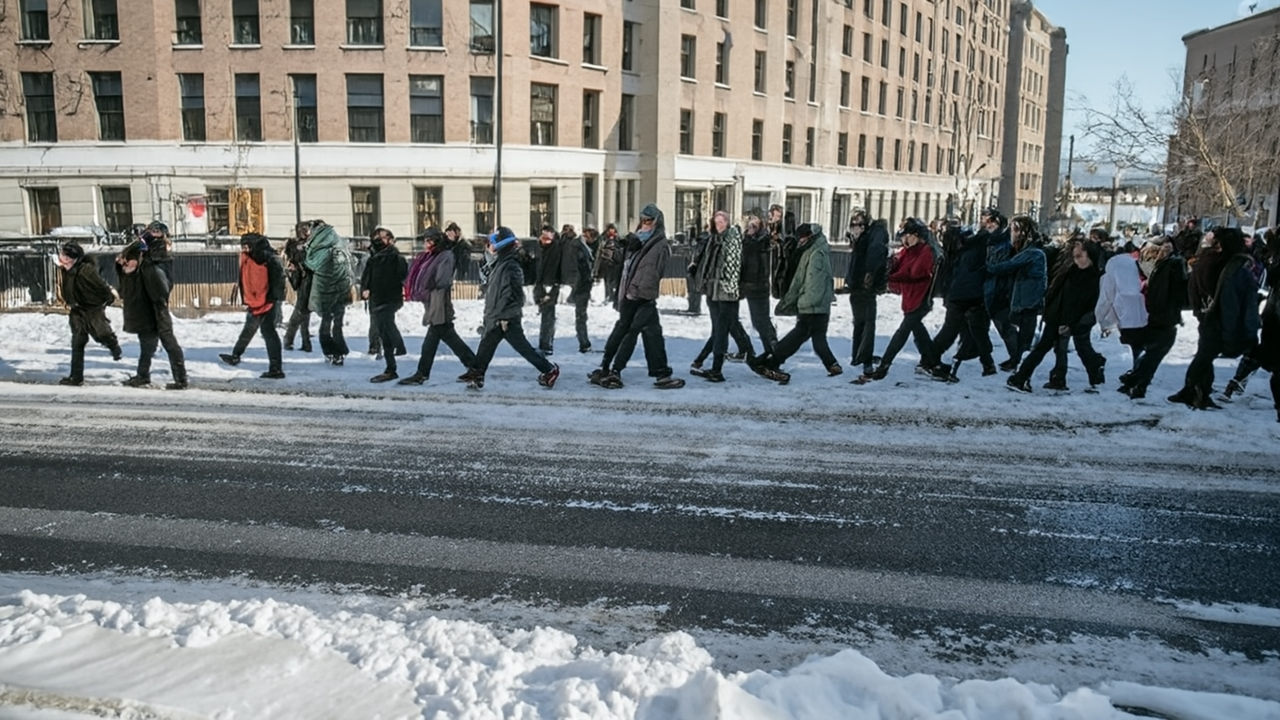
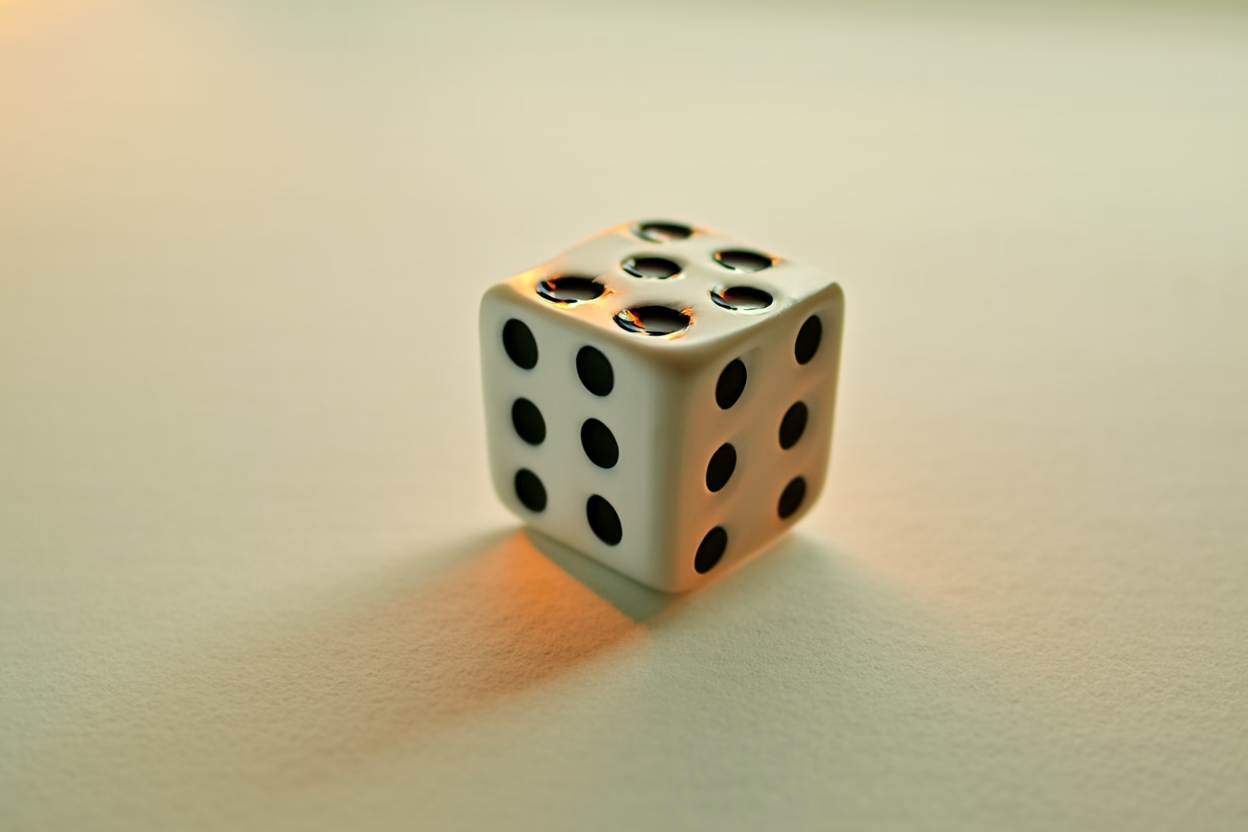
全身:起跑器上的腿部变形
附录 A – 训练设置
该调度在 8000 万样本后变宽,并在整个 1024² 阶段保持宽泛
训练进度
第 2 阶段,从 660M 样本中的 80M 开始
训练时间步在 0.08 至 0.13 之间的占比 · 悬停图表可移动
第 1 阶段 · LogitNormal(0.8, 0.8)
<0.05%
第 2 阶段 · LogitNormal(−0.2, 1.0)
3.0%
第 2 阶段 / 第 1 阶段
107×
本次运行的每项设置,按阶段列出
| 设置 | 512² 阶段 | 1024² 阶段 |
|---|---|---|
| 样本数 | 610.27M(297,985 步) | 49.97M(24,400 步) |
| 全局批大小 | 2,048 | 2,048 |
| 数据 | 原生 512px 级尺寸的图像:368×512、512×512、512×384、512×336、640×360 | 原生 1024px 级尺寸的图像:864×1216、1024×1024、1152×864、1248×832、1280×720 |
| 宽高比混合 | 各占 20%,不缩放 | 各占 20%,不缩放 |
| 加噪 | :噪声尺度随边长翻倍 | |
| 时间步 | 前 8000 万样本(第 39,063 步)使用 LogitNormal(0.8, 0.8),之后使用 LogitNormal(−0.2, 1.0) | 全程使用 LogitNormal(−0.2, 1.0) |
| 目标函数 | x-prediction、v-loss,权重在 t = 0.1 处截断 · readouts 权重为 1 · 最终头上对 t ≤ 0.7 使用 LPIPS 0.1 和 P-DINO 0.01 · PixelREPA 0.1 | |
| 优化器 | 二维块矩阵使用 Muon(动量 0.95,Nesterov)· 其余使用 AdamW(β = 0.9, 0.999,ε = 1e-8)· Muon 更新经 RMS 匹配至 AdamW | |
| 学习率 | 峰值 2e-4 · 在 100 万样本上线性预热 · 保持平坦至 5.5 亿 · 在最后 6000 万样本上按 1 − √ 衰减至 2.5e-5 | 在 50 万样本上线性再预热至 2.5e-5,然后保持平坦 |
| 权重衰减 | 0.1(偏置为 0) | |
| 梯度裁剪 | 1.0(全局范数) | |
| EMA | 半衰期 1,954 步(400 万样本),从 1 亿样本(第 48,829 步)开始 | 半衰期 977 步(200 万样本),从 200 万样本开始 |
| 尖峰感知 EMA | 当梯度范数超过其滚动中位数的 10 倍时,EMA 更新暂停 250 步 | |
| 标题丢弃 | 5%,用于无分类器引导 | |
| 硬件 | 64× H100(8 个节点)· bf16 · FSDP2 · 每 GPU 32 张图像 | 相同,以 4 个累积微批次、每批 8 张的形式 |
有关架构和训练损失的更多细节,请参阅 P-JiT 的附录。
作者声明
本页所有文字均由我们撰写。我们使用 Claude Opus 5.5 帮助我们构建图像画廊和图表。
Huggingface 模型卡和 Github 仓库由 Claude Opus 5.5 自动撰写。我们将 Claude 指向我们的内部实验仓库,让它提取(并清理)必要的代码。