原子模拟帮助研究人员理解分子和材料的行为,从化学反应和相变到机械失效。这些模拟存在成本与精度之间的权衡。量子力学方法如密度泛函理论(DFT)可以提供精确的能量和力,但其计算成本通常限制了它们在大系统或长时间模拟中的应用。经典原子间势要快得多,但其固定的函数形式限制了在不同原子环境中的精度和泛化能力。机器学习原子间势(MLIPs)有助于弥合这一差距。它们使用神经网络以一小部分成本预测势能和原子间力,使研究人员能够研究更大的系统和更长的时间尺度,同时保留大部分所需的精度。
然而,高效运行MLIP本身也面临挑战。原子模拟对可能随时间累积的小误差很敏感,这些误差在计算力时最为明显,力是通过对预测能量求导获得的。在分子动力学模拟中,这些力指导原子速度和位置在许多时间步上的更新,使得数值精度不仅对物理精度很重要,而且对所得轨迹的稳定性也很重要。
因此,许多MLIP继续以FP32运行推理,尽管现代NVIDIA GPU通过低精度Tensor Core操作提供了显著更高的矩阵乘法吞吐量。用于FP32矩阵乘法的Tensor Core方法提供了一种缩小这一差距的方法。它们将每个FP32操作数分解为较低精度的分量,在Tensor Core上计算它们的叉积,并以FP32重新组合结果。这种方法可以提高矩阵乘法吞吐量,同时保持接近原生FP32的精度,而无需重新训练或更改模型的权重或架构。
在这篇文章中,我们评估了Tensor Core FP32方法在Point Edge Transformer(PET)上的实际表现,PET是由EPFL的Lab COSMO开发的基于Transformer的MLIP。PET的大部分运行时间花在高度优化的通用矩阵乘法(GEMM)上,为进一步优化留下的空间有限,使其成为一个严格的测试案例,以检验这些方法是否能带来额外的性能提升。
我们在NVIDIA Blackwell GPU上评估BF16x9,在NVIDIA Ampere GPU上评估TF32x3,比较内核和端到端分子动力学性能以及轨迹级行为。我们进一步测试TF32x3方法的势能平滑性、能量守恒和结构弛豫。我们展示了这些方法如何加速MLIP推理,同时保持接近FP32基线的行为,并概述了如何在其他精度敏感的科学机器学习工作负载上评估它们。
Tensor Core FP32如何弥合硬件差距
现代NVIDIA GPU为BF16和TF32提供的Tensor Core吞吐量远高于FP32矩阵乘法,这在较低精度的可用吞吐量与许多科学工作负载的精度要求之间造成了差距。Tensor Core FP32方法通过将FP32操作数分解为较低精度的分量、在Tensor Core上评估选定的乘积并以FP32累加重新组合它们,帮助缩小这一差距。根据方法和工作负载的不同,这可以在利用更高Tensor Core吞吐量的同时,提供达到或接近原生FP32的精度。
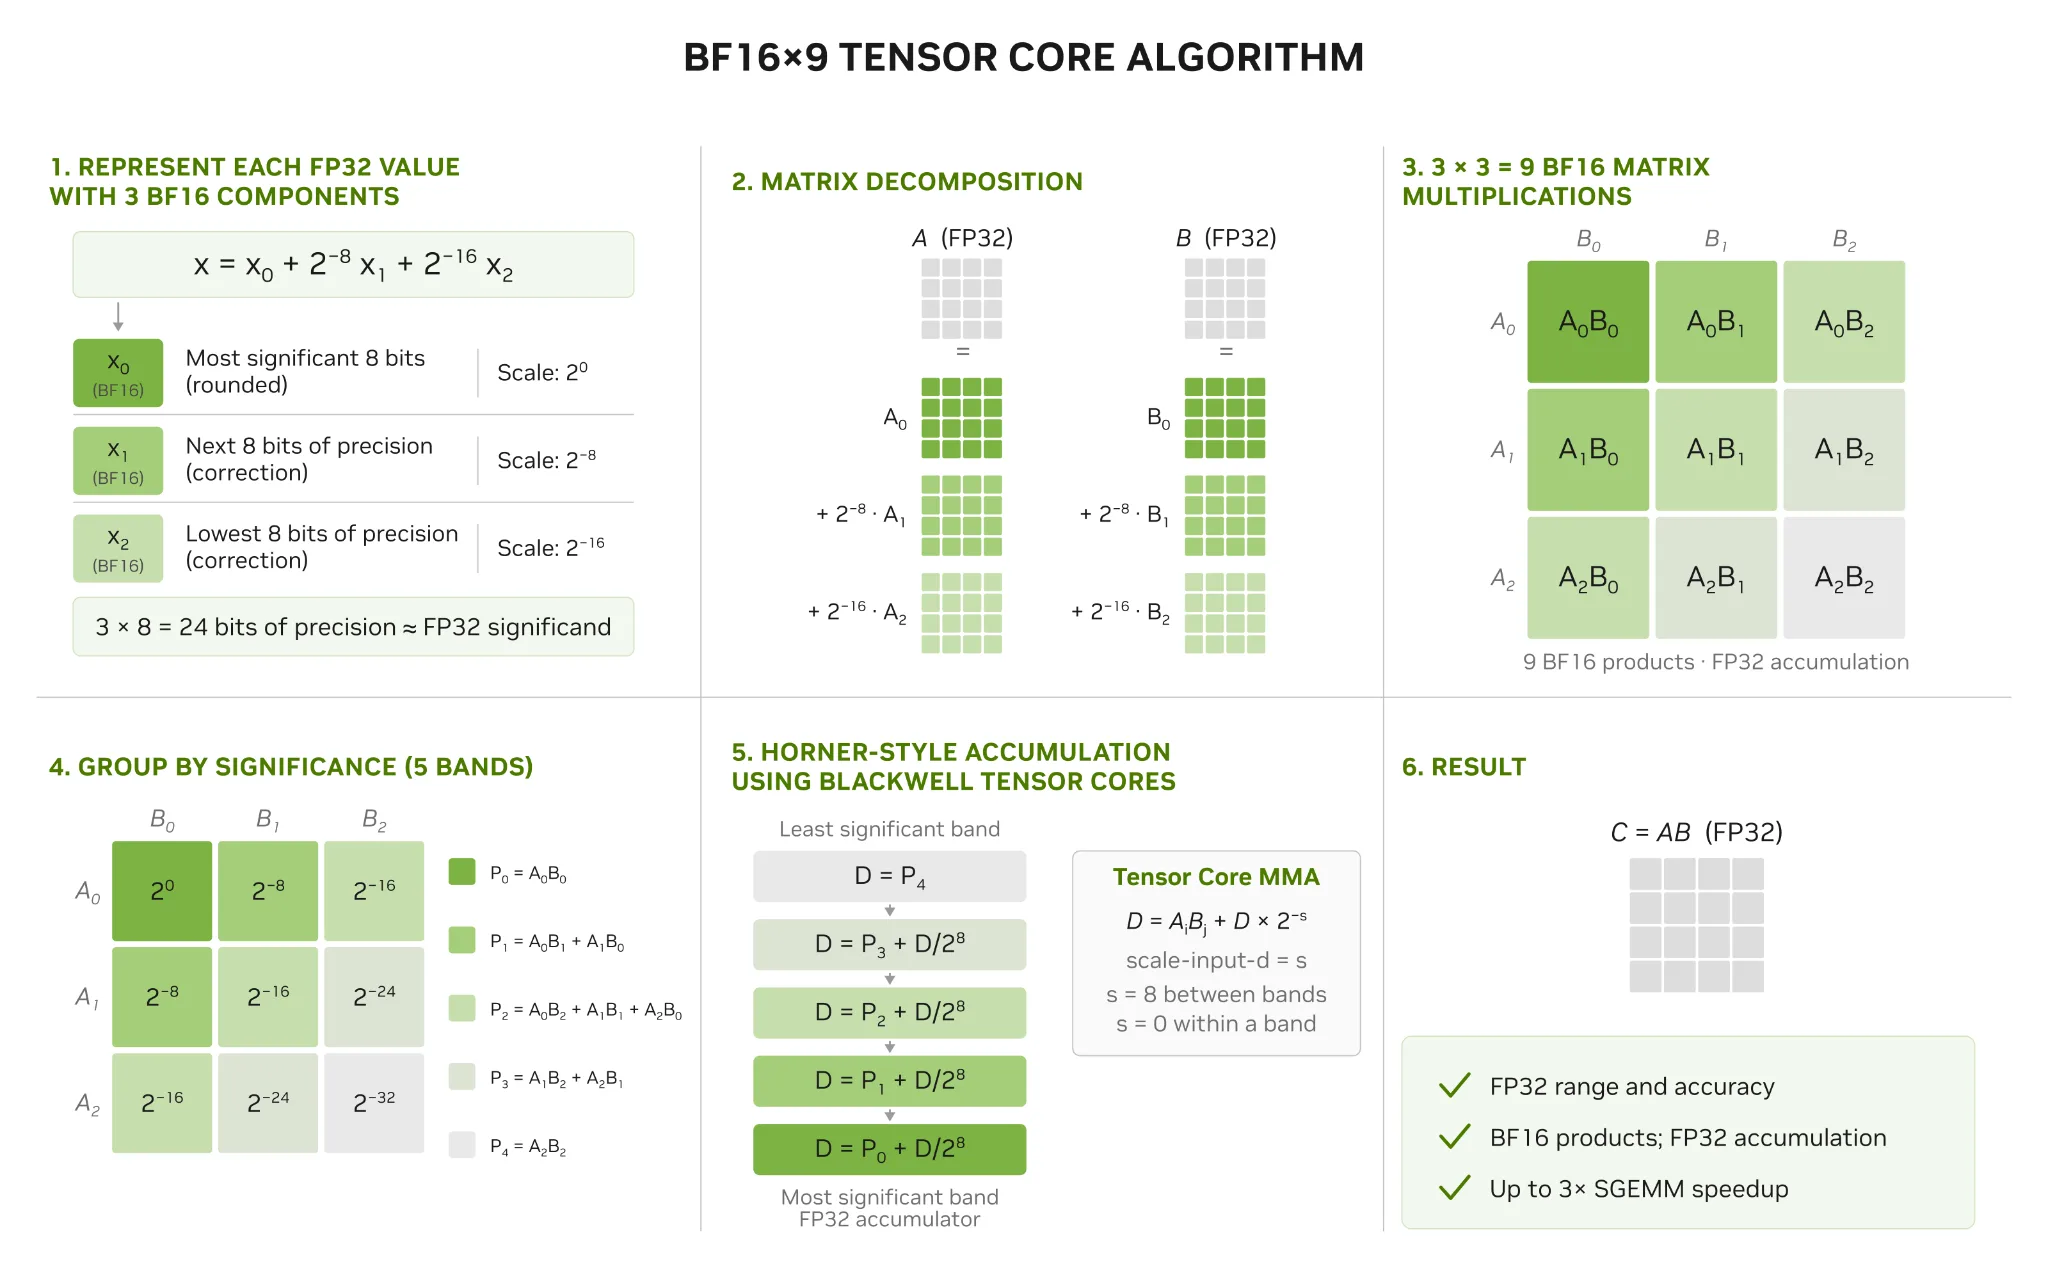
在Blackwell GPU上,NVIDIA cuBLAS提供了BF16x9 Tensor Core路径(图1)。每个FP32操作数被分解为三个BF16分量,九个成对乘积以所需的缩放重新组合。cuBLAS可以通过CUBLAS_EMULATE_SINGLE_PRECISION=1环境变量启用此路径,因此兼容的PyTorch GEMM可以使用它,而无需更改模型架构或实现自定义GEMM。
由于这种方法改变了GEMM的评估方式,当与优化的图构建、融合操作、自定义内核和NVIDIA CUDA graphs结合时,它可能会提供额外的收益。我们在本次评估中没有测量组合收益;应该为每个工作负载端到端地确定。
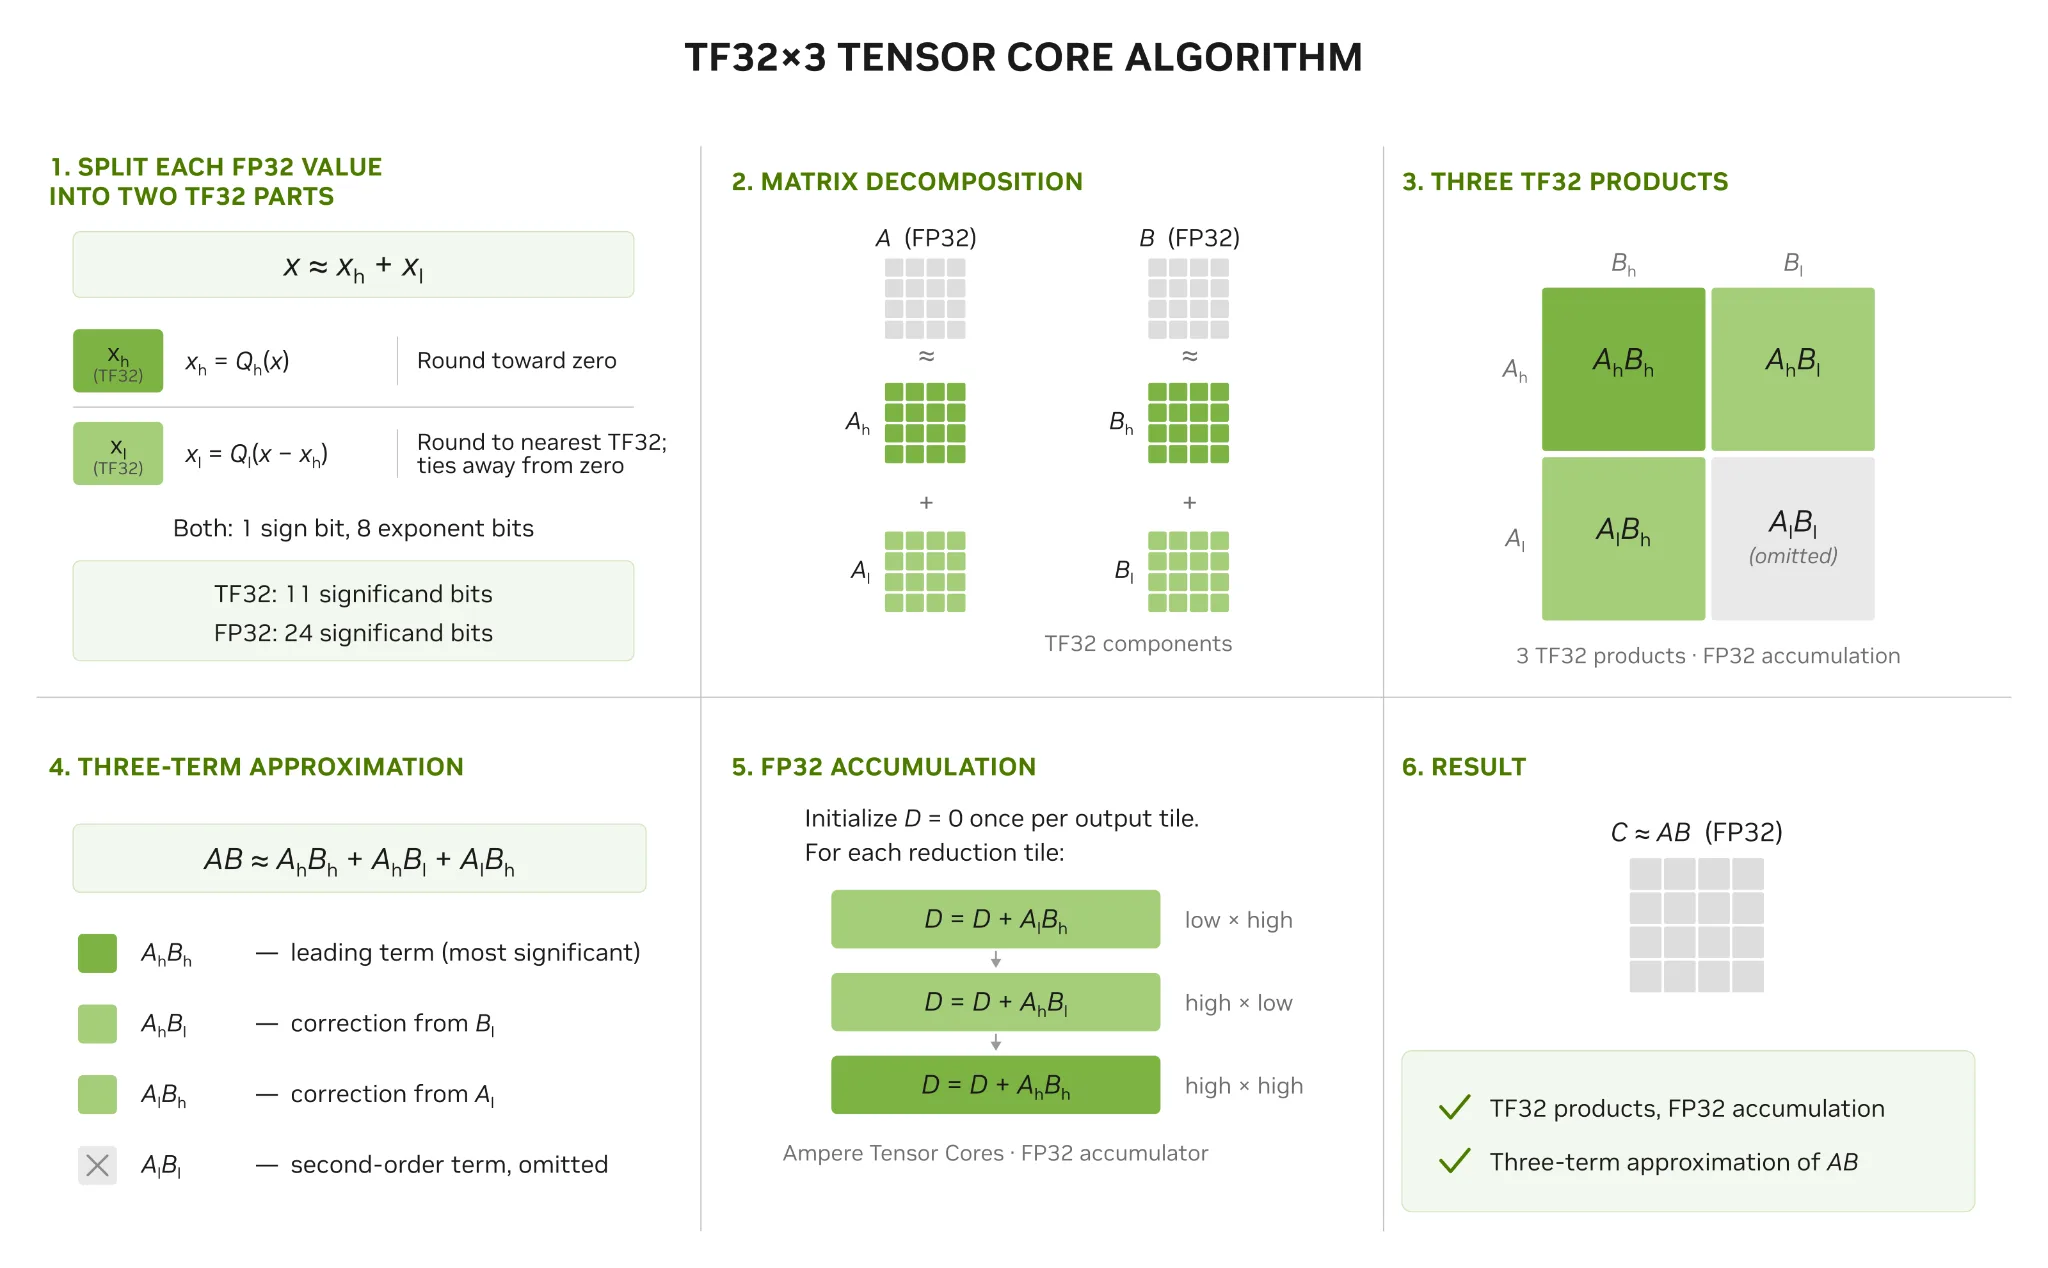
TF32x3 方法在Ampere GPU上应用相同的原理(图2)。TF32x3使用一个主导TF32分量和一个残差TF32分量来表示每个FP32操作数。与BF16x9不同,我们的TF32x3实现不使用缩放因子。它评估三个叉积并省略残差乘残差项,如下式所示
NVIDIA CUTLASS通过OpMultiplyAddFastF32操作符提供此方法。输入和输出保持FP32。Tensor Core执行三个TF32乘积并以FP32累加。
在PET上对Tensor Core FP32矩阵数学进行基准测试
我们在192原子水盒子和17,280原子超胞上评估了26M参数的PET-MAD小检查点(pet-mad-s-v1.6.0-nn-32)。我们还在192原子系统上评估了255M参数的大检查点(pet-mad-m-v1.6.0)。我们将预测的能量、力和应力与原生FP32路径的结果进行了比较。
NVIDIA Blackwell GPU上的BF16x9方法
在计算能力为 10.0 或 10.3 的 NVIDIA Blackwell GPU 上,cuBLAS 支持通过环境变量、数学模式或计算类型(分别用 CUBLAS_COMPUTE_32F_EMULATED_16BFX9、CUBLAS_FP32_EMULATED_BF16X9_MATH 或 CUBLAS_EMULATE_SINGLE_PRECISION=1 请求)启用 BF16x9。使用此路径进行单精度通用矩阵乘法(SGEMM)无需更改模型代码。
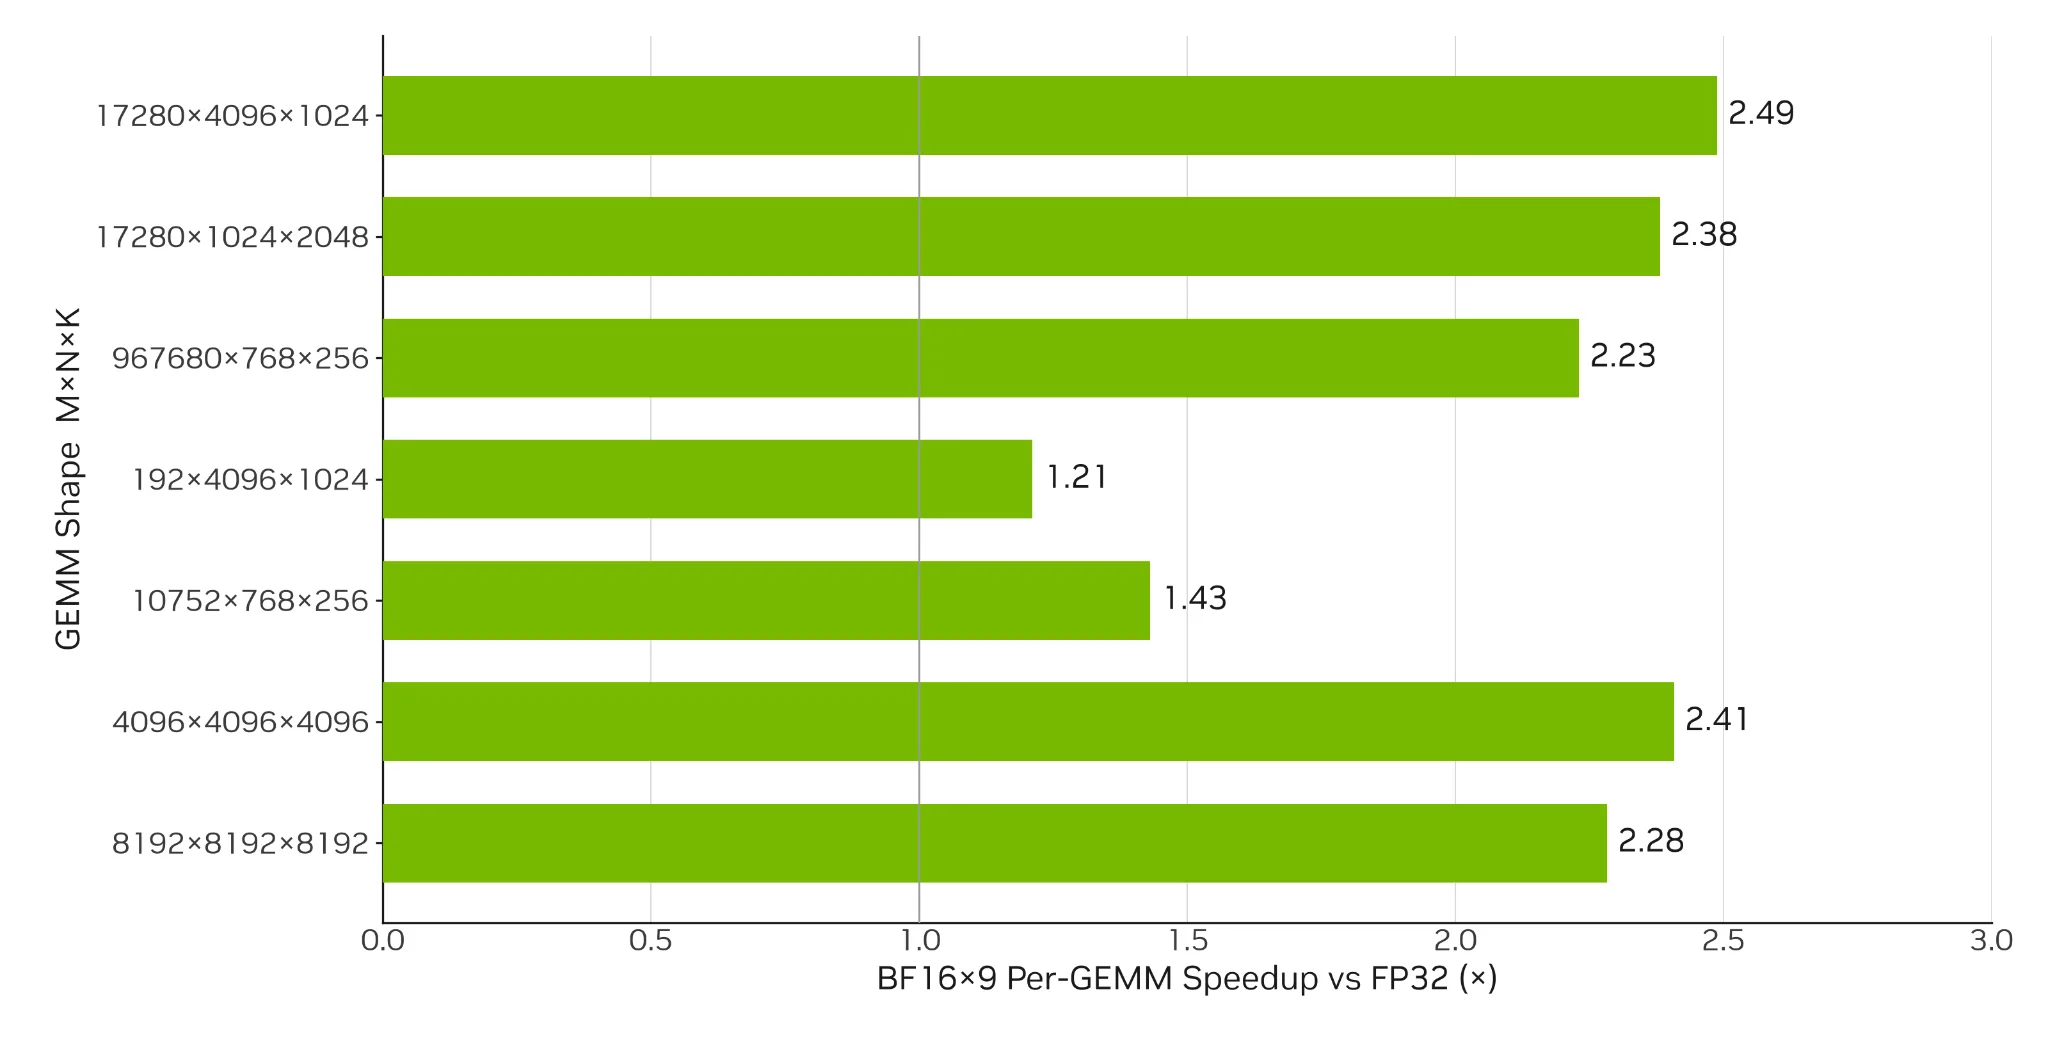
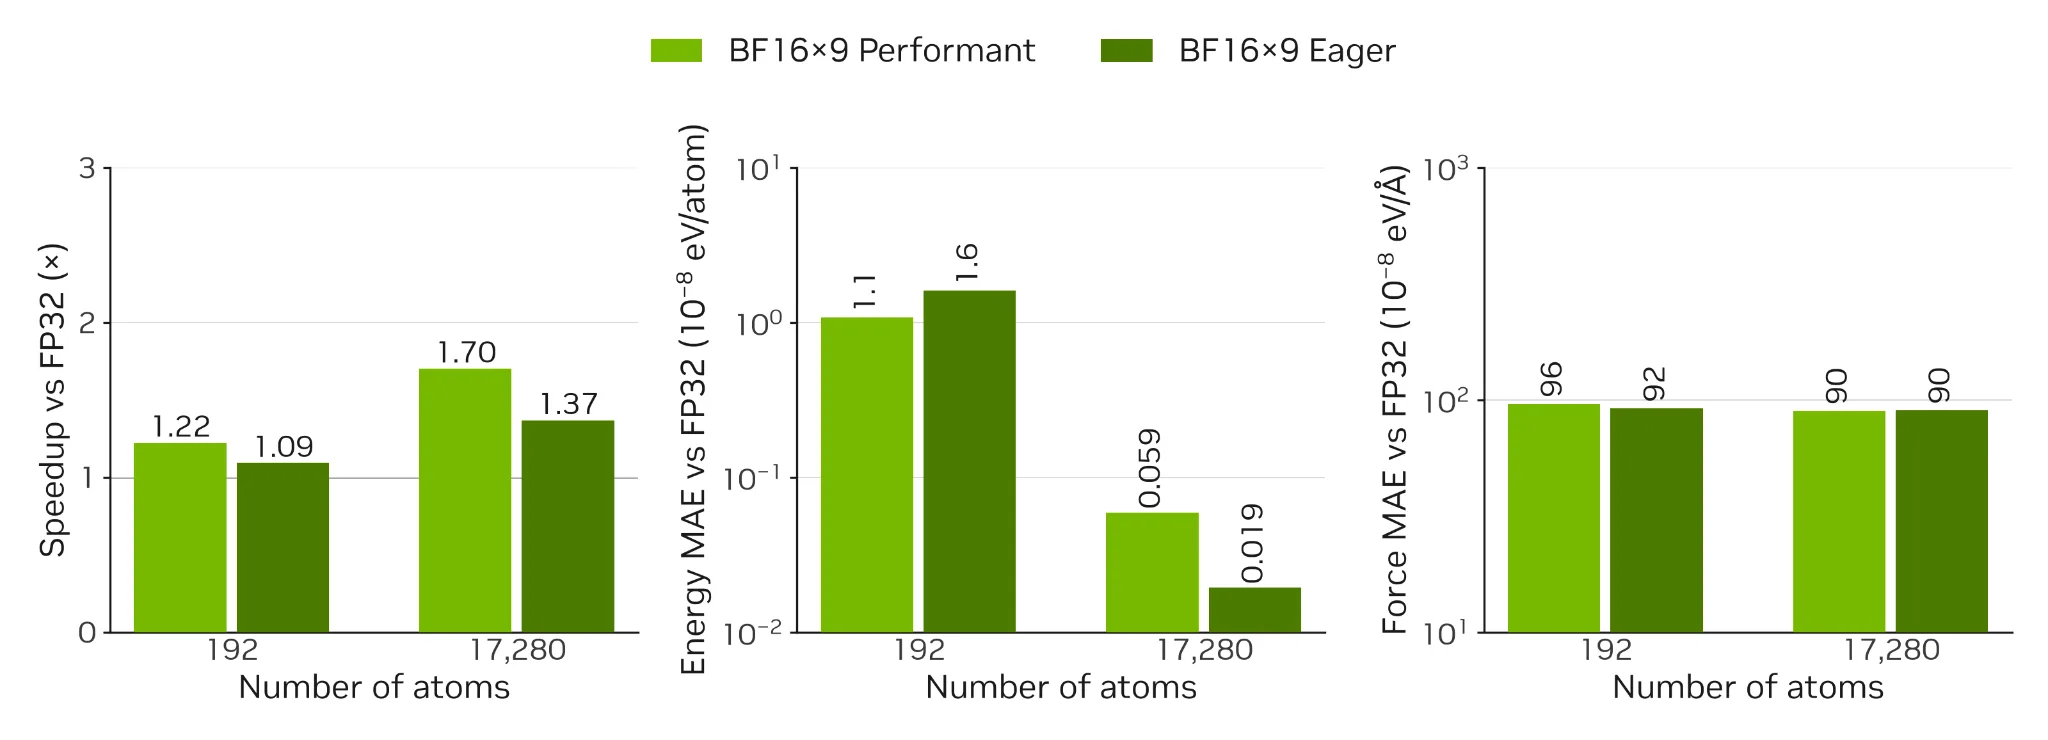
在 Blackwell 上使用 BF16x9 时,PET 中的大型 GEMM 在 17,280 原子工作负载上加速 2.2–2.5 倍(图 3)。图 4 比较了 cuBLAS 的高性能与 eager 策略相对于编译 FP32 的 MD 步加速比和单点能量与力精度。
- 192 原子系统:高性能策略将 MD 步加速 1.2 倍,而 eager 策略达到 1.1 倍。
- 17,280 原子系统:高性能策略实现了 1.7 倍加速,而 eager 策略实现了 1.4 倍。
高性能策略在 cuBLAS 预期更快时使用 BF16x9;eager 策略在操作支持时即使用它。重要的是,BF16x9 Tensor Core 方法带来的误差低于模型自身的不确定性水平。这一结果意义重大,因为 PET 已将其大部分运行时表达为优化的 GEMM 工作,而 BF16x9 路径在不重新训练模型、不改变其 transformer 架构或编写自定义内核的情况下暴露了性能余量。
Ampere GPU 上的 TF32x3 方法
在 Ampere GPU 上,我们通过将 PET 的标准 nn.Linear 层替换为调用 CUTLASS C++ TF32x3 内核的自定义 TF32Linear 层来实现 TF32x3。
CUTLASS C++ 在 示例 27 中提供了此方法的参考实现。PET 实现中的关键设置是:
C++
cutlass::arch::OpMultiplyAddFastF32
这选择了 CUTLASS 的快速、精确 FP32 乘法模式。该内核将每个 FP32 操作数表示为前导和残差 TF32 分量。然后 Tensor Core 计算三个乘积——前导乘前导以及两个前导乘残差乘积——并以 FP32 累加。最小的残差乘残差乘积被省略。CUTLASS C++ 算子声明为 float 输入和输出。因此 PET 继续提供普通 FP32 激活和权重并接收 FP32 结果;从模型其余部分的视角看,该层的行为类似于标准 nn.Linear。只有底层矩阵乘法的实现发生变化。C++ 示例是为 sm80(Ampere)编写的,也可以为 sm90(Hopper)编译。
自定义 TF32Linear 模块替换兼容的 PyTorch 线性层,并使用 CUTLASS C++ TF32x3 内核执行其矩阵乘法,同时保留训练后的权重、偏置和输入形状。
由于 PET 通过微分预测能量来计算力,TF32x3 也用于将梯度传播到层输入。这确保能量和力计算都使用 TF32x3 Tensor Core 算术。权重梯度使用标准 PyTorch 路径,但在固定权重推理期间不需要它们。
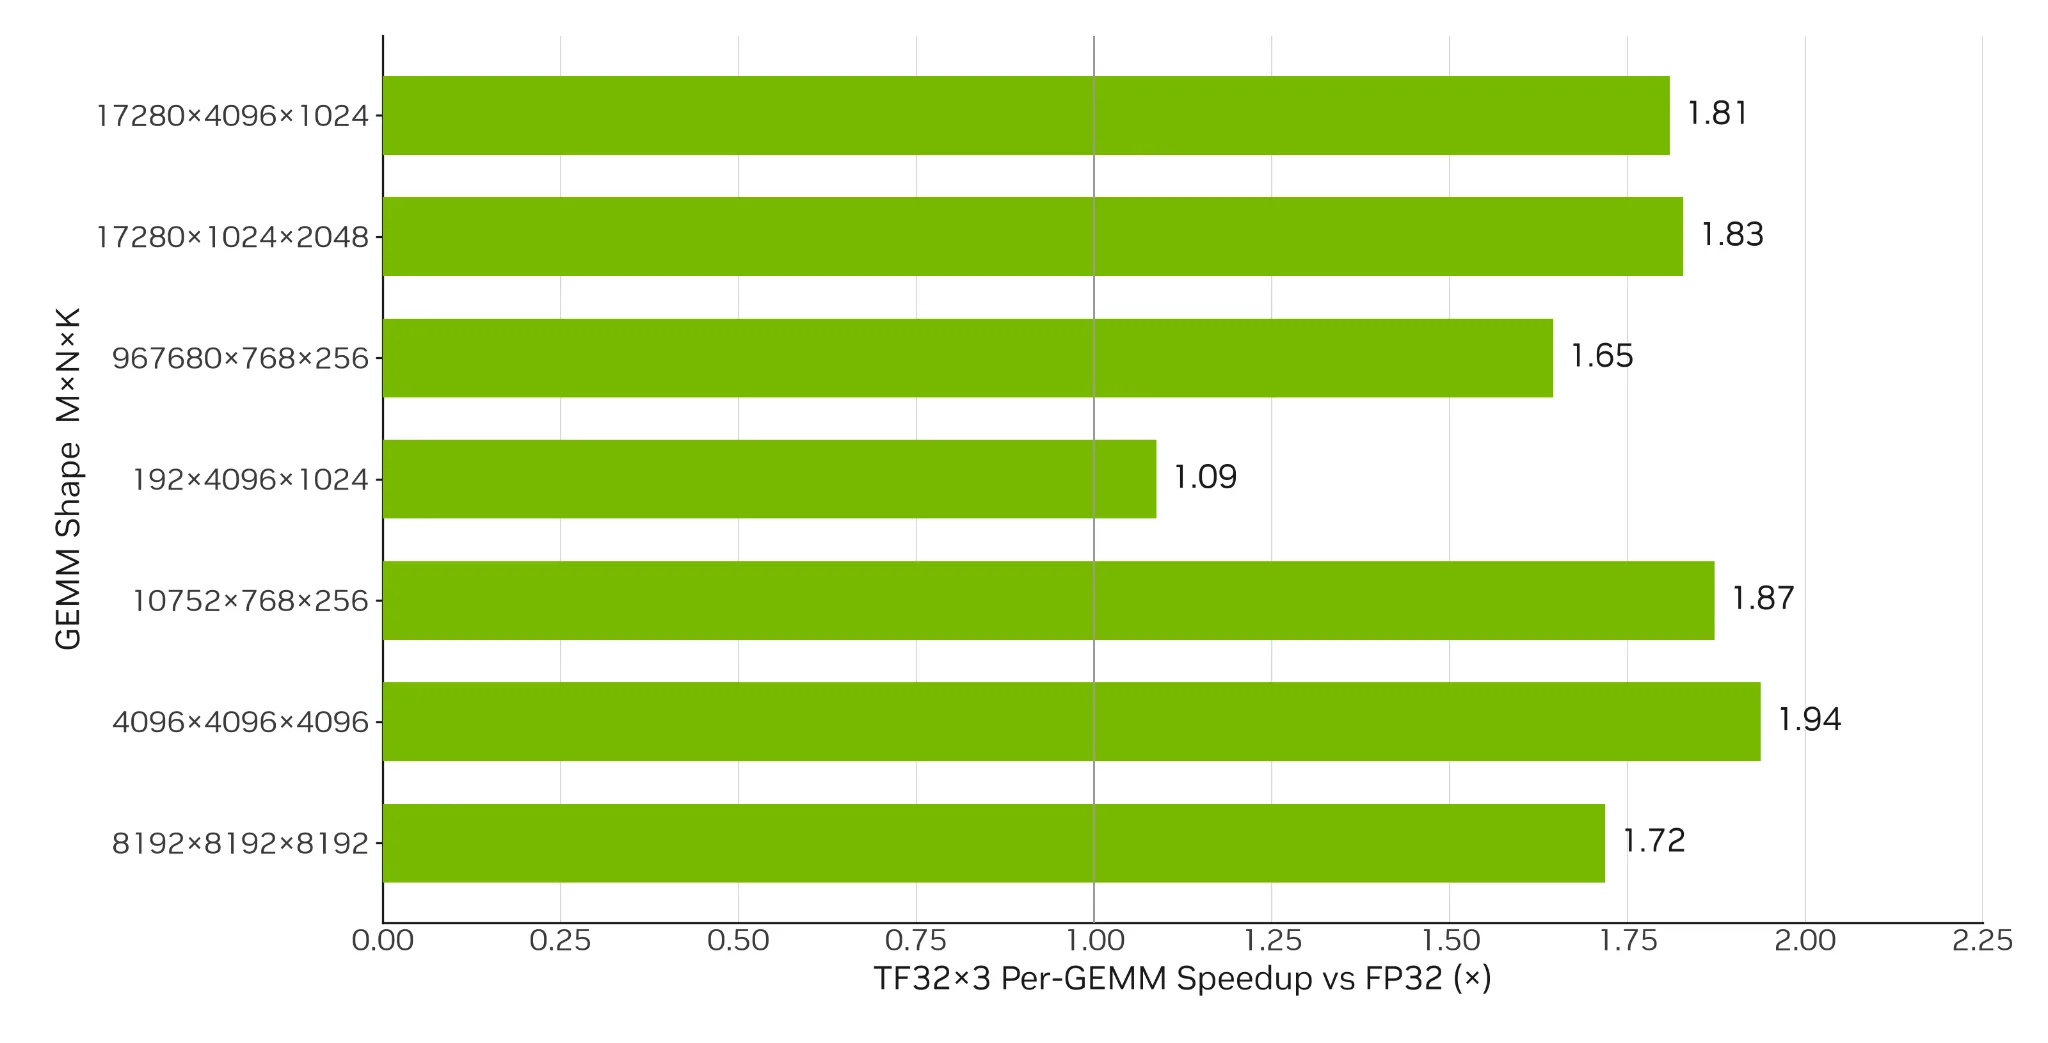
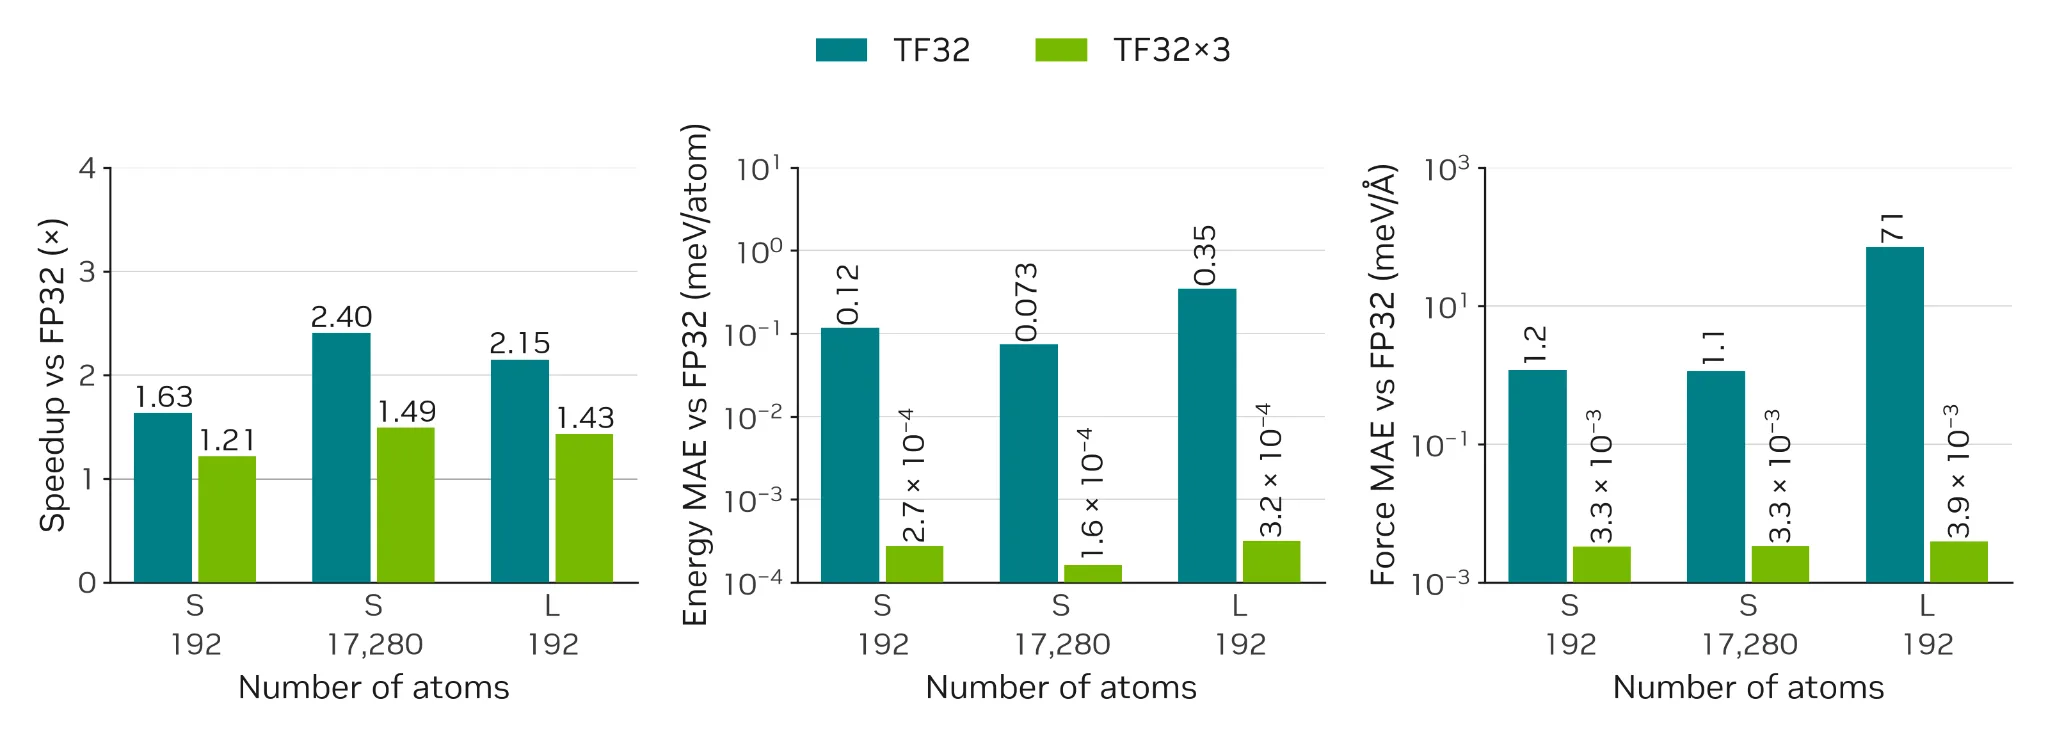
在 A100 上 PET 的主要线性层形状中,TF32x3 将 GEMM 加速约 1.7–1.9 倍(图 5)。图 6 比较了单遍 TF32 和 TF32x3 的 MD 步加速比和单点精度,各自相对于其对应的 FP32 基线测量。单遍 TF32 实现了更高的加速比,但以更大的精度和轨迹稳定性代价为代价(图 6–7)。
- 小检查点(26M 参数):结果显示 192 原子水盒子及其 17,280 原子超胞。TF32x3 将力误差保持在重新编译后 FP32 运行之间差异的大约三倍,并在较大系统上将 MD 步加速 1.5 倍。
- 大检查点(255M 参数):在 192 原子系统上,TF32x3 实现了 1.4 倍加速,而小检查点为 1.2 倍。其力误差为 3.9 × 10⁻⁶ eV/Å,与小检查点基本不变。
验证物理一致性
对于分子模拟,匹配孤立的能量和力预测只是数值保真度的第一项测试。力是学习到的势能面的梯度,并在许多时间步上积分,因此即使微小的数值不规则也可能使表面变得粗糙、使轨迹不稳定或产生非物理的能量漂移。因此,Tensor Core FP32 方法的前景尤其引人注目:它可以为矩阵乘法解锁 Tensor Core 性能,同时保持 FP32 所期望的平滑和稳定行为。
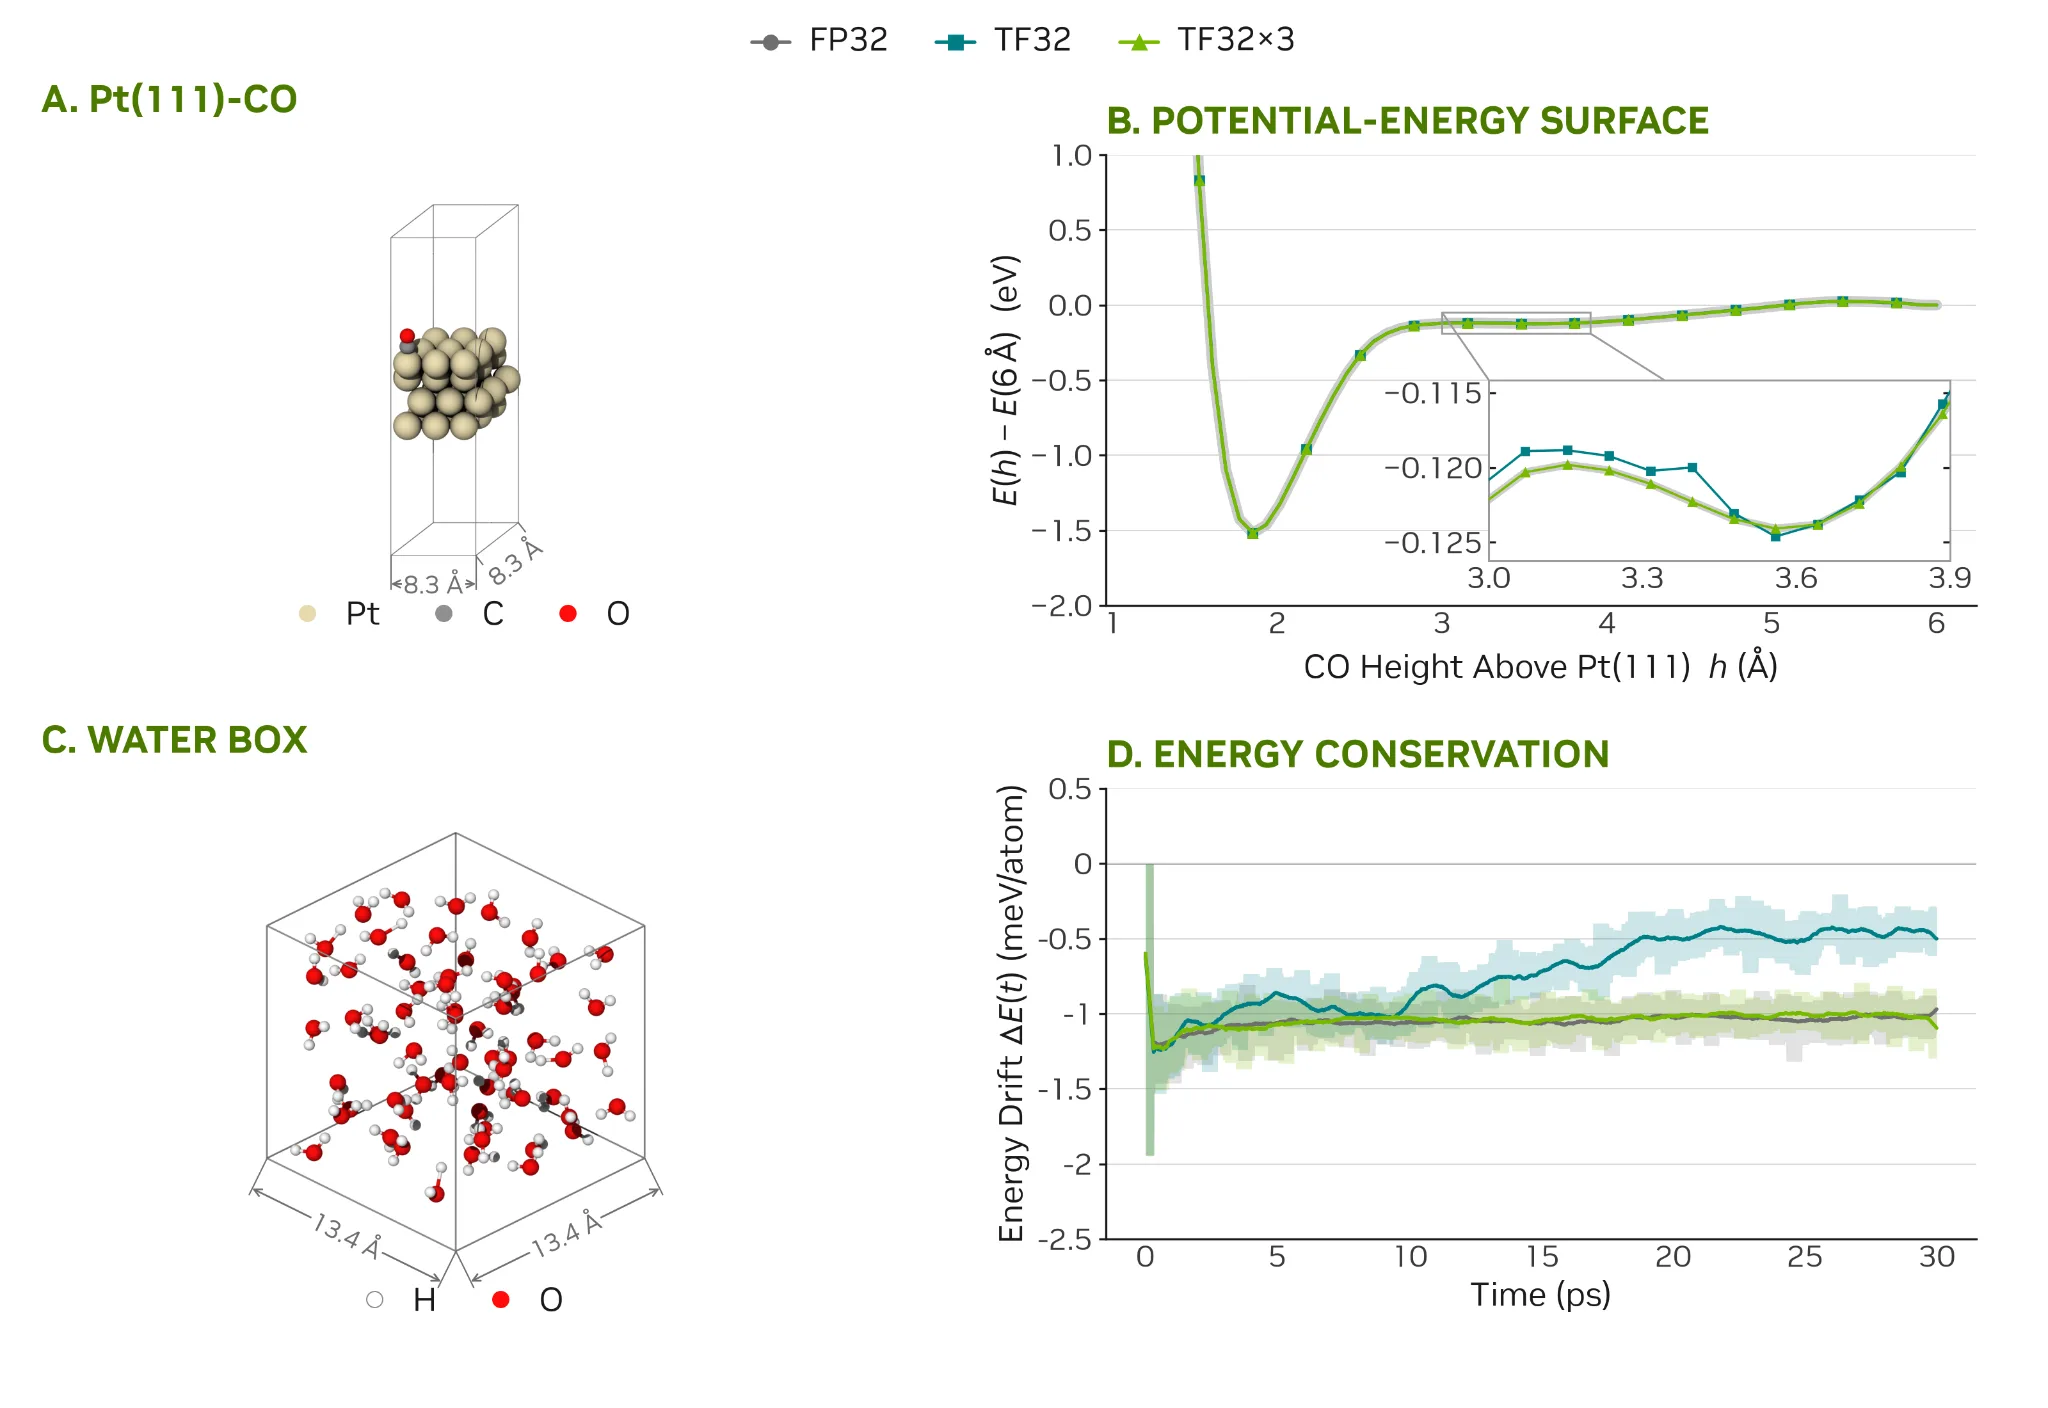
我们使用两个独立的测试来检验势能平滑性和能量守恒(图 7)。为测试能量平滑性,我们将单个 CO 分子从 Pt(111) 表面的顶位刚性拖离,并在 1.2 至 6.0 Å 的范围内以 8.1 × 10⁻² Å 为步长,在 60 个碳原子高度上评估总能量。TF32x3 遵循了平滑的 FP32 CO/Pt(111) 能量曲线,而单遍 TF32 引入了可见的逐点变化。
在另一个 192 原子水盒的 NVE 模拟中,FP32 和 TF32x3 表现出相当的有界能量波动,而单遍 TF32 则表现出更大的系统性漂移。这些结果表明,TF32x3 在测试系统中保持了势能平滑性并维持了能量守恒,而不仅仅是单点精度。
测试结构弛豫
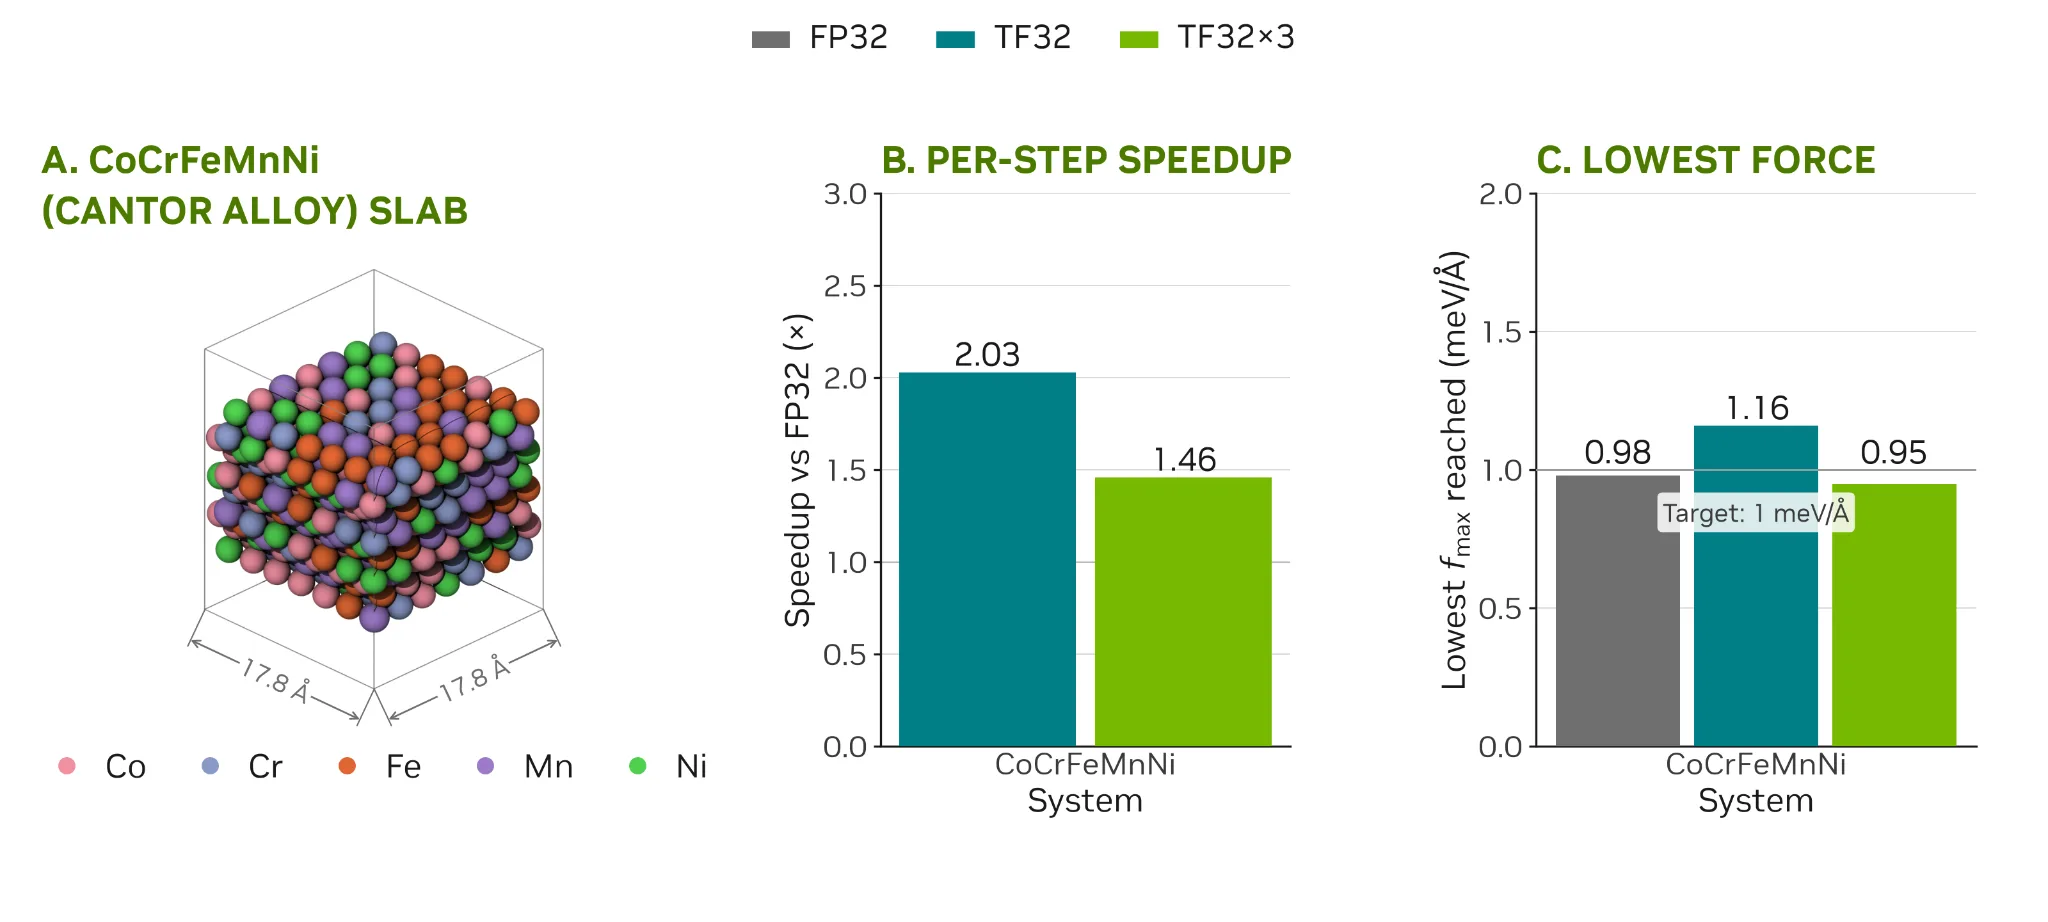
结构弛豫也检验数值保真度,因为优化器会反复使用预测的力来更新原子几何结构。微小的力不一致可能会改变优化路径、增加所需的步数,或阻止系统达到所需的力容差。我们使用 PET 和 NVIDIA ALCHEMI Toolkit 中的 FIRE2 优化器对 539 原子的 Cantor 合金 板进行了弛豫。在三次重复中,FP32 在 218 步内收敛,TF32x3 在 218–222 步内收敛;每次运行都达到了 1.0 × 10⁻³ eV/Å 的力容差。使用单遍 TF32 时,所有三次重复均未能在 500 步限制内收敛,力在 1.2 × 10⁻³ eV/Å 附近趋于平稳。
TF32x3 将每个优化步骤加速了 1.5 倍,同时匹配了 FP32 的收敛速率和标准(图 8)。单遍 TF32 实现了每步 2.0 倍的加速,但即使将优化步数限制加倍至 1,000 步也未能收敛。
这些结果凸显了 Tensor Core 路径的实用价值:在不牺牲 FP32 工作流收敛行为的情况下实现显著加速。
局限性与决策标准
端到端收益取决于系统规模以及运行时间中用于 GEMM 的比例。小系统通常受益较少,因为启动开销、邻居处理、图操作和其他非 GEMM 工作占运行时间的更大比例。当 GEMM 占工作量的更大比例时,大系统受益更多。TF32x3 的性能还取决于针对模型矩阵形状和硬件的内核调优。
数值行为取决于所使用的 Tensor Core 策略。在矩阵乘法测试中,BF16x9 在 FP64 参考下达到或超过了原生 FP32 精度,支持其在受支持的硬件上作为 FP32 GEMM 的直接替代品使用。TF32x3 的精度特征略有不同,应针对模型的精度和物理稳定性要求进行验证。
结论
Tensor Core FP32 方法无需重新训练或更改模型架构即可提升 PET 性能。TF32x3 在 A100 上将主要 GEMM 加速了高达 1.9 倍,将完整的分子动力学步骤加速了高达 1.5 倍。BF16x9 在 NVIDIA B300 Tensor Core GPU 上将主要 GEMM 加速了高达 2.5 倍,将完整步骤加速了高达 1.7 倍。如 TF32x3 所展示的,Tensor Core 方法在测试的能量守恒和结构弛豫工作流中保持了接近 FP32 的行为。
这些结果支持在其他 MLIP 以及运行时间主要由大型 FP32 GEMM 主导的精度敏感科学机器学习模型中评估这些方法。两种 Tensor Core FP32 策略均不需要重新训练或架构重新设计。因此,每种策略都可以作为独立的性能层进行评估,并在工作负载支持时与其他软件优化相结合。
立即在您的模型上尝试 TF32x3 或 BF16x9 Tensor Core 方法——无需重新训练或架构更改。在 cuBLAS 文档 和 NVIDIA ALCHEMI Toolkit 文档 中了解更多信息。在 UPET 仓库 中探索 PET 模型。
致谢
我们感谢 Nikita Fedik、Harun Bayraktar、Gregory Thomsen 和 Vamsi Sripathi 对本文的贡献。