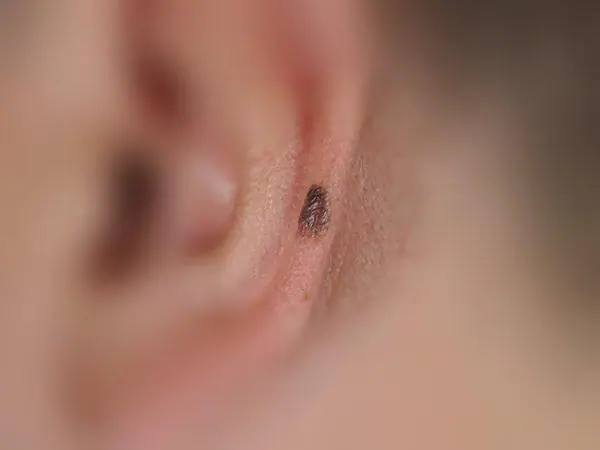
这是一例黑色素瘤。
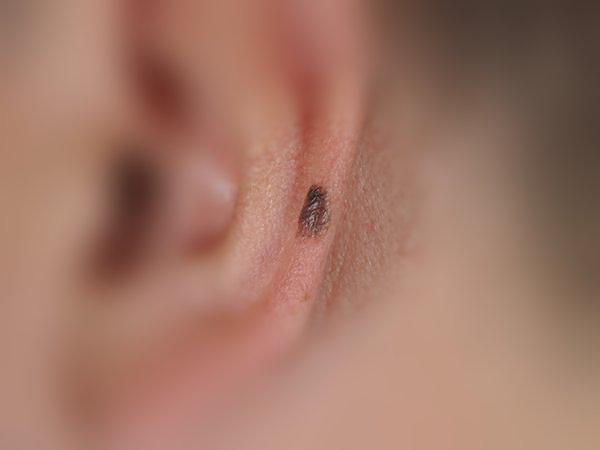
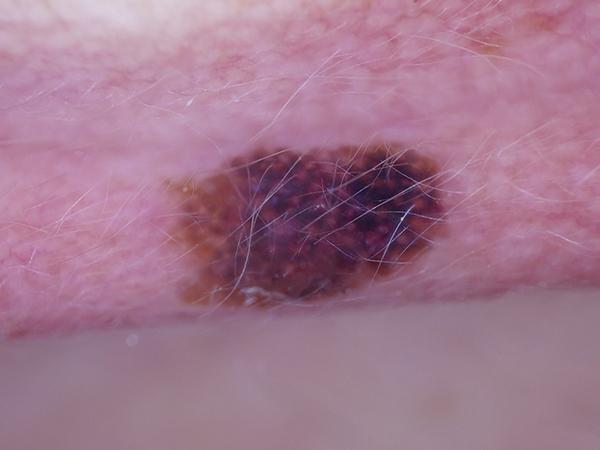 *图1. 耳部侵袭性黑色素瘤,厚度小于0.8毫米。两个LLM都称其为脂溢性角化病,并表示可以出院。CNN称其为黑色素瘤。左侧为临床照片,右侧为皮肤镜图像。图像:MILK10k,MILK研究团队,CC BY-NC。*
我将这两张图像——一张临床照片和一张皮肤镜(皮肤显微镜)图像——展示给了GPT-6 Astra和Claude Fable 5.1,这是2026年10月可用的两个最强大的AI模型。两者都称其为脂溢性角化病,一种无害的疣状生长物,并表示患者可以出院。然后我将它们展示给了微调版的Inception v3,这是一个卷积神经网络(CNN),由Google于2015年首次发布,并在此处基于公开皮肤病学图像进行了微调。CNN根据皮肤镜视图得出了正确答案。
这是我提供给所有三个模型的200个经活检证实的病变之一。CNN正确命名了其中125个(62%)的诊断(在6种可能性中)。两个前沿LLM分别正确命名了84和85个(42%)。一个十年前网络,经过约二十分钟的微调,在识别皮肤癌方面击败了它们两者。
测试
这些病变来自MILK10k,这是一个通过国际皮肤成像协作组织于2025年发布的公共数据集,其中每个病变被拍摄两次:一张临床特写和一张通过皮肤科医生使用的照明放大镜拍摄的皮肤镜图像。我随机抽取了200个病变,全部经组织病理学确认:
- 100个不应出院:30个黑色素瘤,25个基底细胞癌,25个鳞状细胞癌(包括鲍温病)和20个光化性角化病。
- 100个可安全出院:50个良性痣(色素痣)和50个脂溢性角化病。
每个病变都进行了活检,包括良性的,因此这些病变更难诊断:一个有人决定切除的痣,是让临床医生担心的痣。
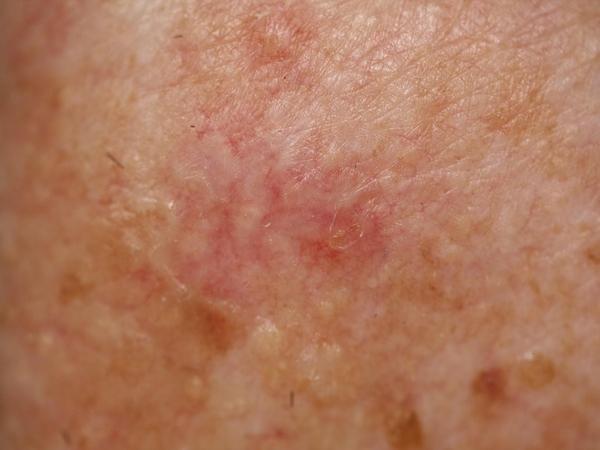
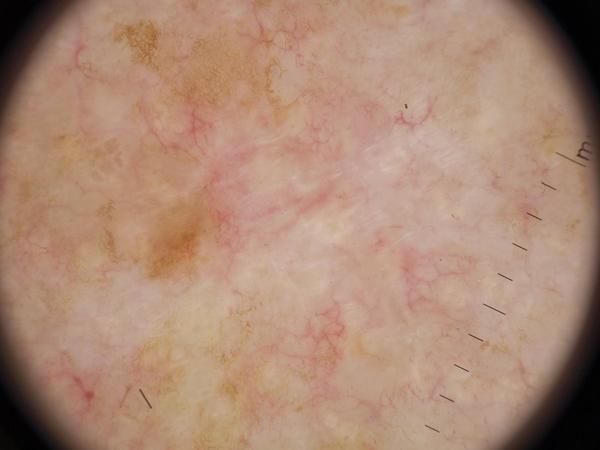
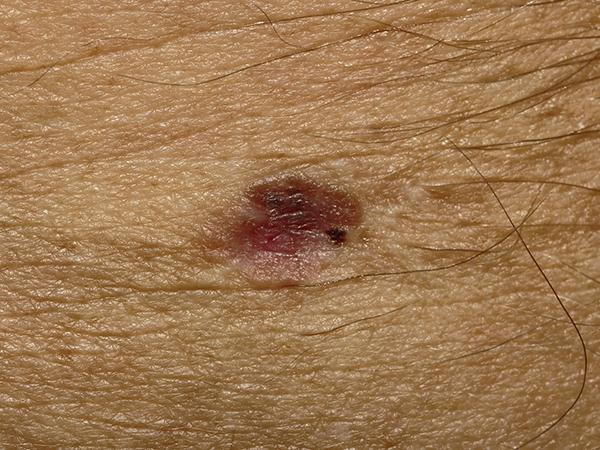
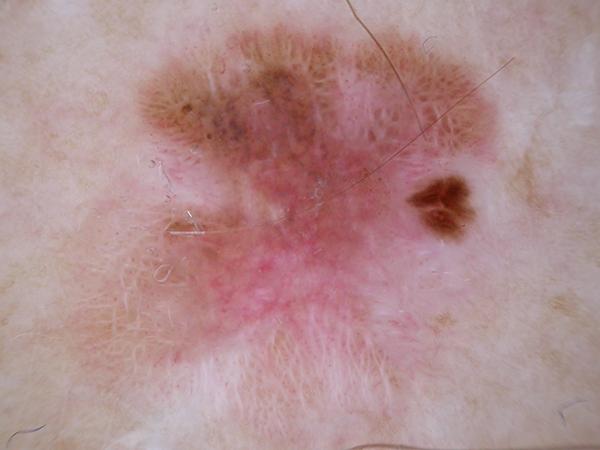
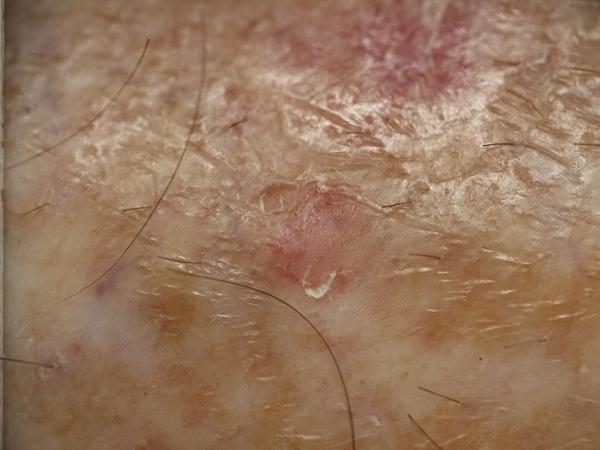
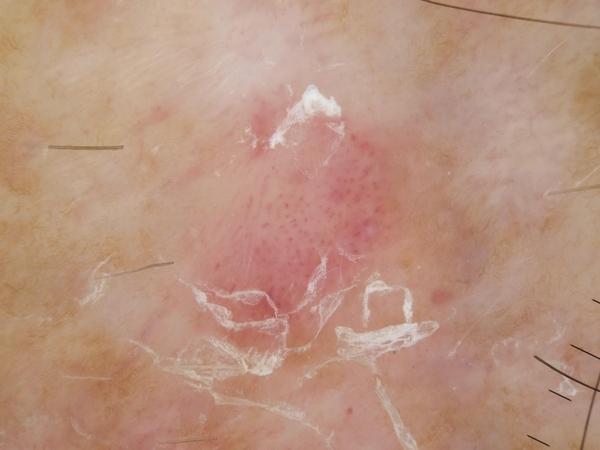 *图2. 200个测试病变中的另外三个。左侧为临床照片,右侧为皮肤镜图像。图像:MILK10k,MILK研究团队,CC BY-NC。*
LLM被给予两张图像,没有其他信息,并被要求,如临床医生可能使用它们那样,给出六种诊断中最可能的(或“不确定”)、一个置信度、第二选择,以及病变是否可以安全出院而无需治疗、活检或随访。两个模型在默认设置下得到相同的提示,且都没有拒绝任何病例。
CNN故意不是最先进的。我使用了在日常生活照片上预训练的Inception v3,然后在单个H100 GPU上对来自ISIC Archive的68,011张皮肤镜和临床图像微调了所有层。这200个测试病变,以及同一病变或患者的每张其他照片,在训练前已从其数据(包括验证集)中移除,因此它从未见过它们,它们也没有被用于选择模型或设置其阈值。它对每个病变的两张图像进行评分,将它们结合,大部分权重放在皮肤镜图像上,并从相同的六种诊断中选择。
你可以自己尝试CNN。值得注意的是,该模型小到可以完全在手机浏览器中使用WebGPU运行。没有上传任何内容,其随机样本按钮从这同样的200个病变中抽取。
诊断:62%对42%
图3. 两个LLM和CNN的正确首选诊断,它们从相同的六种诊断中选择。标签显示正确回答数占该组织学病变数量的比例。
CNN总体上更经常正确,在大多数诊断上也更正确。允许第二选择时,它达到200个中的173个,而两个LLM分别为134和138。它正确命名了30个黑色素瘤中的13个,而两个LLM分别为8和11。最大的差距在无害病变上:它识别了50个痣中的37个和50个脂溢性角化病中的26个,而GPT-6 Astra为16和13,Claude Fable 5.1为33和6。它在基底细胞癌上比GPT-6 Astra少一个,在光化性角化病上落后于两个LLM。
模型们的失败方式也不同。每个LLM都有一个最喜欢的答案:GPT-6 Astra将75个病变称为基底细胞癌,而实际只有25个,包括30个黑色素瘤中的14个;Claude Fable 5.1将53个病变称为光化性角化病,而实际只有20个。CNN在黑色素瘤上的错误则相反:在它弄错的17个中,它将8个称为痣,6个称为脂溢性角化病。
结果汇总表
| GPT-6 Astra | Claude Fable 5.1 | CNN (Inception v3) | |
|---|---|---|---|
| 正确诊断(200个中) | 84 (42%) | 85 (42%) | 125 (62%) |
| 首选或次选正确 | 134 | 138 | 173 |
| 黑色素瘤作为首选(30个中) | 8 | 11 | 13 |
| 保留的不安全病变(100个中) | 97 | 96 | 在其预设阈值下为77;匹配时为98或99 |
| 安全出院的病变(100个中) | 32 | 22 | 在其预设阈值下为76 |
| 出院的黑色素瘤(30个中) | 3 | 4 | 在其预设阈值下为18;匹配时为2或1 |
注意事项
- 样本量小。200个病变足以显示模式,但不足以对接近的结果进行排名,而30个黑色素瘤对最重要的数字给出了很大的不确定性。每个LLM病例只运行一次;不同运行之间答案会变化。
- 困难病例。每个病变都做了活检。在来自档案库的普通图像上,CNN 区分应出院与不应出院的病变的能力要好得多(ROC 曲线下面积为 0.96,而此处为 0.86)。
- 数据污染。MILK10k 自 2025 年起就已公开,因此 LLM 可能在训练中见过它;如果真有什么影响,那也只会对它们有帮助。而 CNN 肯定没有见过。
- 并非最先进。Inception v3 只是一个基线模型。最先进的皮肤癌诊断 AI 使用在更多数据上训练的 image transformer 集成模型,而基于它们构建的受监管产品表现要好得多。
以患者身份提问
改为以患者身份提问,仅提供临床照片并问“我需要看医生吗?”,两个 LLM 在几乎所有病例中都建议看医生,包括无害病变:在另外 100 个经活检证实的黑色素瘤中,分别有 99 个和 98 个如此建议。
结论
一个使用过时架构的小型、老旧、专用网络,识别皮肤病变的能力远胜于两个前沿 LLM。
自行运行
病例、提示词、每个 LLM 的回复以及评分代码都在一个下载包中,CNN 则在此处。
我设计了测试并做出了临床裁定。分析和初稿由 Claude Code(Anthropic 的编程工具,运行于 Claude 模型)生成;所测试的两个 LLM 之一也是 Anthropic 的。评分由脚本对照组织学完成。
图像来自 MILK10k 数据集(MILK 研究团队,International Skin Imaging Collaboration),依据 CC BY-NC 许可使用。
Magnus Lynch 医生是 Guy's Hospital 的顾问皮肤科医生和 Mohs 外科医生,以及 King's College London 的荣誉 Reader(相当于副教授)。他的临床工作涵盖皮肤癌、Mohs 及面部重建手术和激光;他的研究涵盖皮肤癌与疤痕的细胞生物学以及 AI 在皮肤科的应用。完整简介。