随着人工智能和加速计算不断突破可能的边界,最新的 NVIDIA CUDA 版本应运而生,以释放前所未有的性能和规模。
NVIDIA CUDA 13.5 在多个重要新平台上提供通用可用性(GA)。NVIDIA Vera Rubin 支持从早期开发者访问转为通用可用性(GA),已为企业生产做好准备。自 CUDA 13.4 起已 GA 的 Windows on Arm 支持,现已扩展到适用于 Windows 的 NVIDIA DGX Station。
CUDA 13.5 还通过局部性域和 NVIDIA 多进程服务(MPS)引入了对 GPU 工作调度方式的更多自定义。并且 CUDA 13.5 在库、编译器、NVIDIA CUDA Tile 和开发者工具方面提供了创新。
本文将展示 CUDA 13.5 的亮点。
CUDA 13.5 增强功能
CUDA 13.5 带来的一些显著增强包括:
局部性域增强
CUDA 13.5 让应用程序可以在跨局部性域的均匀流式多处理器(SM)分区或包含所有可用 SM 的分区之间进行选择。默认情况下,本地化绿色上下文分区在每个域中使用相同的保证 SM 数量,将补充 SM 留在这些分区之外。
新的 cudaDevSmResourceGroupLocalityDomainSupplementalSms 标志与 cudaDevSmResourceGroupLocalityDomainId 结合使用,会将这些额外 SM 包含在每个选定域中。这使得应用程序在跨局部性域分区时可以使用所有设备 SM,尽管生成的分区大小可能不同。
应用程序可以使用 cudaDevSmResourceSplit() API 中的发现模式来获取每个分区的 SM 数量并相应地分配工作。这允许您在每个局部性域统一 SM 大小的均匀性和可预测性之间进行选择,或者选择每个局部性域拥有的最大 SM 数量,并尽可能利用 GPU 硬件。更多信息请参阅 CUDA Runtime API。
NVIDIA MPS
MPS v3 让您对工作负载如何共享 GPU 拥有更多控制,从调度单个服务器到为客户端组分配资源。
加权时间切片
加权时间切片 允许您为承载需要更长计算时间的工作负载的服务器提供更长的计算轮次。设置基础时间片,按 MPS 服务器缩放它,并独立调整 GPU 在工作负载之间切换的积极程度。
SM 分区负载均衡
SM 分区负载均衡 允许工作负载在资源可用时使用超出其基础分区的容量。使用 --max-chunks 启用借用,并使用 --shareable=true 允许分区在没有附加客户端时借出其 SM。这些设置是独立的,因此分区可以借用、借出或两者兼有。MPS 在重新分配借用资源之前会回收它们,而应用程序继续看到稳定的基础分区大小。
基于 Cgroup 的路由
基于 Cgroup 的路由 将您的工作负载启动器的进程分组连接到 MPS 资源策略。将 cgroup v2 子树映射到 MPS 命名空间,通过守护进程主套接字连接的客户端会自动路由到该命名空间。
SM 分区分配
按命名空间的 SM 分区分配 让您为每个设备选择一次分区,然后将该选择应用于路由到该命名空间的每个客户端。您不再需要为这些客户端单独配置 CUDA_MPS_SM_PARTITION。命名空间分配优先,而没有分配的设备保留环境变量回退。
基于轮询的内存记账回退
基于轮询的内存记账 在 cgroup 阈值通知缺失或不可靠时提供回退。在驱逐决策期间,MPS 可以直接读取当前使用量和限制,而不是依赖缓存的通知状态。要强制轮询,请在内存记账开始前运行 nvidia-cuda-mps-control memacct set force_polling=true。这会增加每个驱逐决策的工作量,但消除了对通知传递的依赖。
CUDA 图中的批处理一维复制
CUDA 13.5 为批处理一维内存复制添加了 CUDA 图支持。应用程序现在可以在流捕获中包含现有的 cudaMemcpyBatchAsync 调用,而无需更改批处理复制调用语法,从而允许将多个传输捕获并重放为可重用图工作流的一部分。应用程序还可以显式添加批处理复制节点,并在不更改批处理结构的情况下更新兼容的复制地址和大小。
NVIDIA Rubin 上的 Windows 驱动程序模式
从 NVIDIA Rubin 架构开始,CUDA 支持 Windows 显示驱动程序模型(WDDM)和 Microsoft 计算驱动程序模型(MCDM),其中 MCDM 提供仅计算驱动程序模型。Tesla 计算集群(TCC)在 Rubin 及更高版本的 GPU 上不受支持。假设使用 TCC 模式的应用程序和部署工具应为其目标系统使用受支持的 WDDM 或 MCDM 配置。
CUDA Tile 更新
CUDA Tile 中的多 GPU 通信
CUDA 13.5 添加了对 直接在 CUDA Tile 内核中进行多 GPU 通信 的支持。单播指针允许内核访问另一个 NVLink 连接的 GPU 上的内存,而多播指针和专用的多播操作支持在具有 NVIDIA NVLink SHARP 支持的 NVIDIA NVSwitch 结构上跨多个 GPU 进行归约和存储。应用程序在启动前准备共享内存映射,然后在内核中将通信与计算结合,从而实现融合矩阵乘法和跨 GPU 归约等工作负载。
Tile 到单指令多线程(SIMT)互操作性(公开预览)
CUDA 13.5 允许 CUDA Tile 内核直接调用 SIMT 库设备函数。在此版本之前,Tile 和 SIMT 库代码只能跨内核边界组合,数据通过全局内存在它们之间传递。通过此预览,用 cuTile Python 或 CUDA Tile C++ 编写的内核可以在其自身代码中间调用 SIMT 库中的设备函数,操作已位于寄存器或共享内存中的数据。这些库包括 NVIDIA NVSHMEM、NVIDIA CCCL Coop、NVIDIA Warp 和 NVIDIA MathDx,后者涵盖 NVIDIA cuFFTDx、NVIDIA cuBLASDx、NVIDIA cuSolverDx 和 NVIDIA nvCOMPDx,并且这些库很快都将启用此互操作支持。
tile 库(.tilelib)打包了 SIMT 库函数的接口和实现信息。编译器按照库期望的方式将每个 tile 划分到线程,传达任何共享内存和同步要求,并生成单个内核。要在 C++ 中启用预览,请使用 nvcc --tile-preview simt 编译,并将 tilelib 传递给 tile 编译器。在 cuTile Python 中,使用由 cuda.tile_preview 包提供的 cuda.tile_preview.foreign_call。
在 13.5 中,Tile-SIMT 互操作预览仅涵盖库函数。从 tile 代码调用自己的 __device__ 函数计划在未来版本中提供。有关更多信息,请参阅 文档。
NVIDIA CUDA Python
NVIDIA CUDA Python 持续扩展对 CUDA 编程的 Pythonic 访问。CUDA Python 核心库 cuda.core1.2 引入了批量内存复制、程序化依赖启动(PDL)、更简单的运行时编译以及更灵活的 CUDA Graph 更新。
批量内存复制
新的 cuda.core.utils.copy_batch() 通过单次 CUDA 驱动程序调用提交多个缓冲区复制。CopyOptions 提供对源访问顺序、内存位置提示和重叠行为的控制,使应用程序对数据移动有更多控制。
以下示例使用现有源缓冲区和目标缓冲区提交两个独立的复制:
from cuda.core.utils import copy_batch

# Each source and destination pair must have matching sizes.
# Copies within the batch must not alias.
copy_batch(
    stream,
    srcs=[src_a, src_b],
    dsts=[dst_a, dst_b],
)

stream.sync()
从 Python 使用 PDL
LaunchConfig 现在通过 programmatic_stream_serialization 选项公开 PDL。在计算能力 9.0 或更新的 GPU 上,协作内核可以在同一 CUDA 流中重叠执行,允许依赖内核在其前驱完成之前开始独立工作。这使 Python 应用程序能够访问内核间重叠,同时保留对启动配置的显式控制。请参阅 LaunchConfig 文档。
from cuda.core import LaunchConfig, launch

config = LaunchConfig(
    grid=num_blocks,
    block=256,
    programmatic_stream_serialization=True,
)

# The kernel must implement the PDL synchronization protocol.
launch(stream, config, dependent_kernel, *kernel_args)
更灵活的 CUDA Graph 更新
应用程序可以在未来实例化之前更新图定义节点,并通过 graph[node] 视图修改可执行图节点,而无需重新实例化图。支持的更新包括内核参数、内存复制、内存设置、子图、事件和主机回调。这些功能简化了在应用程序参数变化时重用图。
from cuda.core import LaunchConfig
from cuda.core.graph import GraphDefinition

# Define a graph with one kernel node.
graph_def = GraphDefinition()
node = graph_def.launch(
    LaunchConfig(grid=1, block=256),
    kernel,
    output_a,
)

# Instantiate once and run with the original output buffer.
graph = graph_def.instantiate()
graph.launch(stream)
stream.sync()

# Update the executable node's arguments without reinstantiating.
graph[node].update(args=(output_b,))

# The same graph now launches the kernel with output_b.
graph.launch(stream)
stream.sync()
CCCL
CUDA Toolkit 13.5 带来了 CCCL 3.5,为 CUB 提供了公共调优 API、可重现的浮点扫描、新的批量 Top-K 选择以及直接从 GPU 内存读取问题大小的归约。这些新增功能使开发者对算法执行有更多控制,并简化了具有数据依赖工作负载的流水线。
使用公共调优 API 自定义 CUB 性能
CCCL 3.5 为 CUB 设备级算法引入了公共调优策略。开发者可以通过执行环境中的 cuda::execution::tune(...) 自定义参数,如每块线程数、每线程项数、向量化和算法选择。
以下示例展示了策略选择器如何为 GPU 计算能力选择调优参数。此选择器为设备级归约返回 cub::ReducePolicy;扫描选择器将返回 cub::ScanPolicy。不提供自定义策略的应用程序继续使用 CUB 的默认调优。有关示例,请参阅 CUB 调优文档。
struct ReduceTuning
{
    __host__ __device__
    constexpr cub::ReducePolicy
    operator()(cuda::compute_capability cc) const
    {
        auto pass = cub::ReducePassPolicy{
            .threads_per_block = 256,

            // Use 20 items per thread for compute capability 10.0
            // and newer, and 16 for older GPUs.
            .items_per_thread =
                cc >= cuda::compute_capability{10, 0} ? 20 : 16,

            .vec_size = 4,
            .reduce_algorithm = cub::BLOCK_REDUCE_WARP_REDUCTIONS,
            .load_modifier = cub::LOAD_LDG
        };

        // Provide tuning for both multi-tile and single-tile reductions.
        return {.multi_tile = pass, .single_tile = pass};
    }
};

// Attach the selector to the execution environment using the public tuning API.
auto env = cuda::std::execution::env{
    cuda::stream_ref{stream},
    cuda::execution::tune(ReduceTuning{})
};

// Keep using the public device-wide API. CUB applies the custom policy
// supplied through the environment.
auto status = cub::DeviceReduce::Sum(d_input, d_output, num_items, env);
批量 Top-K 选择
Top-K 选择是 AI 工作负载中的重要操作,包括文本生成期间的 token 选择以及为稀疏注意力选择相关 token。新的 cub::DeviceBatchedTopK 跨多个段独立选择最小或最大的 K 个项目,支持键和键值对、可变段大小以及可随段变化的 K 值。NVIDIA 针对 AI 工作负载开发了此算法。CUB 的批量 Top-K 已集成到 FlashInfer 中,后者是用于 LLM 推理的 GPU 内核库。
constexpr int segment_size = 4;
constexpr int k = 2;

auto segments_in = cuda::make_strided_iterator(
    cuda::make_counting_iterator(d_input), segment_size);
auto segments_out = cuda::make_strided_iterator(
    cuda::make_counting_iterator(d_output), k);

auto env = cuda::std::execution::env{
    ...
};

auto status = cub::DeviceBatchedTopK::MaxKeys(
    segments_in,
    segments_out,
    cuda::args::constant<segment_size>{},
    cuda::args::constant<k>{},
    num_segments,
    env);
可重现的浮点扫描
cub::DeviceScan 增加了对浮点求和运行间可重现性的支持。现在,您可以通过执行环境请求固定的归约顺序,在相同 GPU 上使用相同输入和构建配置产生可重复的结果。
以下示例请求包含求和的可靠结果。有关详细信息,请参阅 cub::DeviceScan 文档。
auto env = cuda::std::execution::env{
    cuda::stream_ref{stream},
    cuda::execution::require(
        cuda::execution::determinism::run_to_run)
};

auto status = cub::DeviceScan::InclusiveSum(
    d_input, d_output, num_items, env);
将数据依赖的归约保留在 GPU 上
CUB 归约现在可以使用 cuda::args::deferred 读取存储在设备可访问内存中的元素计数。前面的内核或选择操作可以产生该计数,归约可以按流顺序读取它,而无需将其传输到主机。这也使得捕获的归约能够在每次 CUDA Graph 重放时处理不同的元素计数,而无需更新或重新捕获图。
例如,在选择操作将其输出计数写入 d_count 后,归约可以直接使用它:
auto env = cuda::std::execution::env{
    cuda::stream_ref{stream},
    cuda::execution::require(
        cuda::execution::determinism::run_to_run)
};

auto status = cub::DeviceScan::InclusiveSum(
    d_input, d_output, num_items, env);
有关详细信息,请参阅 cub::DeviceReduce 文档。
新的开发者工具
NVIDIA Nsight Perf SDK for AI——公开预览
CUDA Toolkit 13.5 引入了 NVIDIA Nsight Perf SDK for AI 的公开预览,为长时间运行的训练和推理工作负载带来始终开启的性能分析。该 SDK 保留原始运行中选定的 GPU 和 CPU 性能指标及执行上下文,帮助开发者调查难以复现的间歇性性能问题。开发者可以在 Perfetto 中探索收集的数据。在此了解更多信息。
其他功能
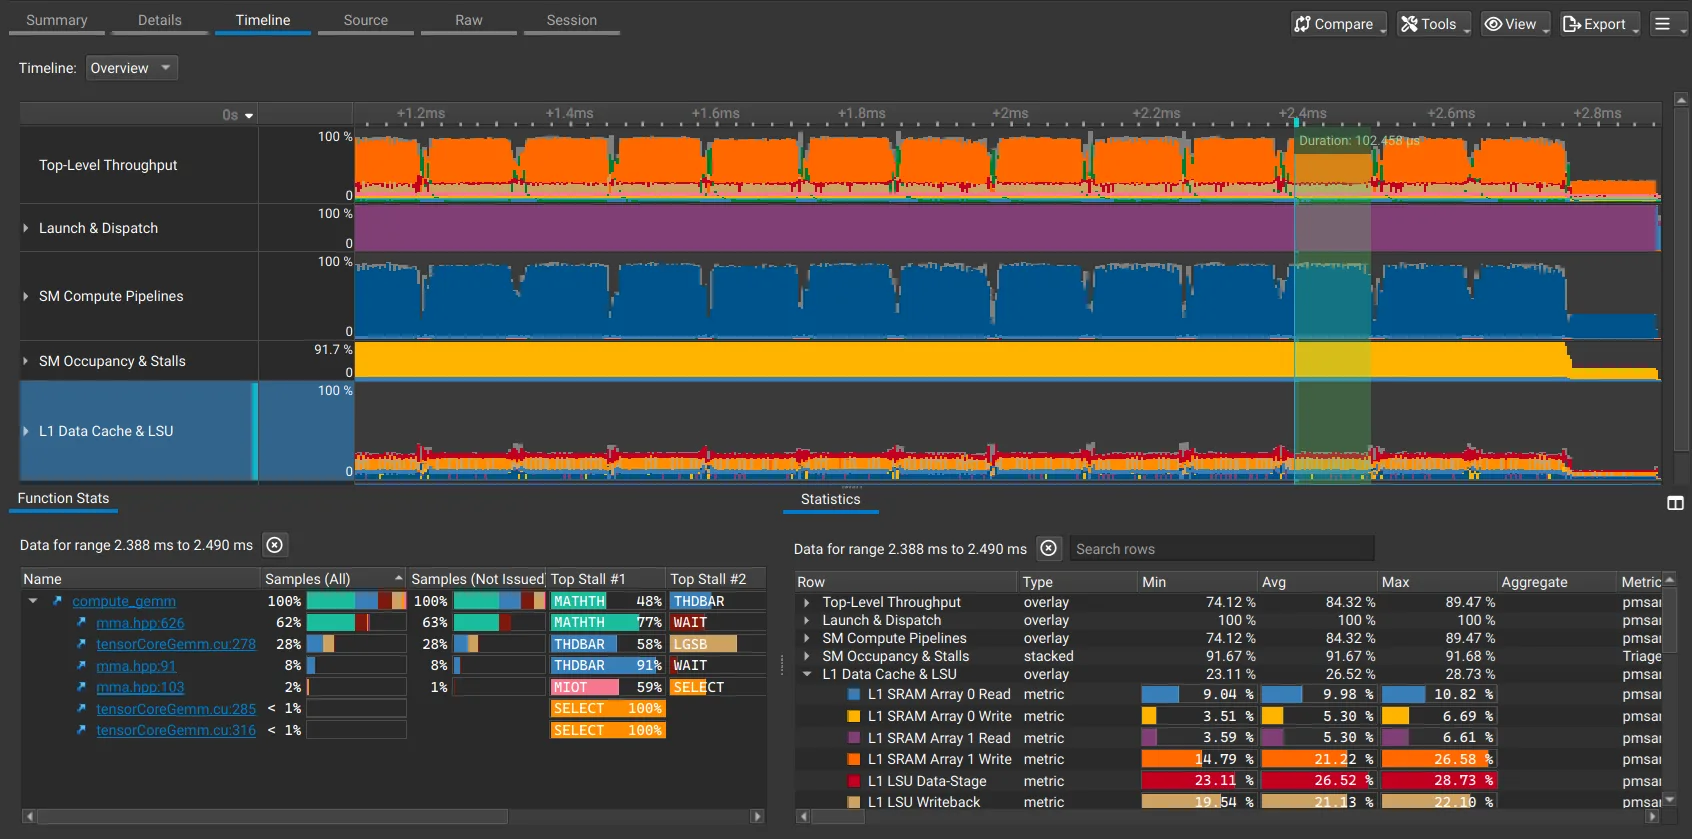
NVIDIA Nsight Compute 2026.4 在 NVIDIA Nsight Compute 中引入了专用的时间线页面,使开发者更容易探索 GPU 工作负载随时间变化的性能。该页面将时间分辨的性能分析数据集中到一个视图中,帮助开发者识别工作负载阶段、瞬态停顿以及聚合指标可能掩盖的硬件利用率变化。开发者可以在时间线之间切换,并访问集成的函数统计信息分析,而无需离开页面,从而将相关的性能洞察保持在一起。从详情页面直接链接可简化到相关时间线的导航,而内置指南可帮助用户在报告不包含时间线数据时快速上手。
CUDA Toolkit 13.5 在 CUDA-GDB 中增加了对 CUDA 驱动日志事件停止执行的支持,帮助开发者在错误发生时进行调查。可配置规则按线程、严重性或消息模式过滤事件,使开发者能够专注于相关诊断信息。当匹配的事件停止执行时,开发者可以检查主机端调用栈以追踪触发代码并确定根本原因。
此版本还支持在启用 CUPTI 跟踪时生成 GPU 核心转储。开发者可以在异常发生时捕获 GPU 状态,并在稍后使用支持的调试器检查转储,而无需在禁用跟踪的情况下重现故障。
新的 NVIDIA Compute Sanitizer 代理技能帮助 AI 编码代理选择正确的诊断方法,并解释 CUDA 内存、竞态条件和同步错误。
NVIDIA Nsight Cloud 现在通过 Nsight Operator 支持 OpenTelemetry 跟踪集成和 NVIDIA Dynamo 部署的性能分析配置,帮助开发者大规模调查 AI 工作负载性能。
数学库
CUDA 13.5 中的核心 CUDA 数学库现在在 Vera Rubin 上具有性能改进。cuBLAS 将 Ozaki-II 方案扩展到 FP64 对称秩-k 更新。其他新功能和显著的性能改进包括:
NVIDIA cuBLAS
- 在 NVIDIA Vera Rubin 上更快的 GEMM: 更新的启发式方法和内核调优改善了 Vera Rubin 上开箱即用的 NVFP4 和 MXFP8 矩阵乘法性能,包括专家混合(MoE)LLM 训练形状。训练和推理工作负载无需按形状自动调优即可获得更高吞吐量。
- 用于 FP64 对称秩-k 更新的 Ozaki-II: Ozaki-II 方案现在在 NVIDIA Ampere 及更新 GPU 上支持 {D,Z}SYR{K,2K,KX} 和 ZHER{K,2K,KX}。因此,使用基于 cuSOLVER 构建的 Cholesky 分解和最小二乘求解器的应用程序现在也能为这些例程获得 Tensor Core 加速。
- 在 NVIDIA Blackwell 上更快的原生 FP64 对称更新: 双精度和双复数精度的 SYR2K、HER2K、SYRKX 和 HERKX 在 NVIDIA B200 上速度提升高达 1.5 倍。使用原生 FP64 对称更新的科学代码(如特征值求解器和矩阵分解)无需更改代码即可加速。
- 针对非对齐形状优化的 BF16 内核: 维度不是八的倍数的 BF16 矩阵乘法现在在 NVIDIA Hopper 及更新 GPU 上使用与 FP16 相同的优化内核。具有不规则层大小的模型(包括通过 NVIDIA cuDNN 调度的卷积)不再因选择 BF16 而非 FP16 而承受性能损失。
- Windows on Arm 对 Blackwell GPU 的支持: cuBLAS 在 Windows on Arm 上为 Blackwell GPU(包括 GB300 工作站)增加了功能支持。基于 Arm 的 Windows 系统上的开发者可以运行 cuBLAS 加速的应用程序,而无需切换平台。
NVIDIA cuSPARSE
- 使用 ALG3 更快的 FP32 和 FP64 CSR SpMM: 在数据中心 GPU 上提供 1.65 倍至 2.27 倍的性能提升,加速稀疏矩阵-稠密矩阵乘法。
- 新的 SpSV ALG2 算法: 以几何平均值衡量,求解性能比 ALG1 快 2.7 倍,加速重复求解稀疏三角系统的工作负载。
- 更快的 SpSV 分析: 在分析阶段实现 2.79 倍的几何平均加速,减少稀疏三角求解的设置时间。
- 更低的 SpSV 内存使用: 减少稀疏三角求解的内存占用,为应用程序数据留出更多 GPU 内存。
- 扩展的混合索引支持: 在 SpMV(CSR、SELL)、SpMM(CSR)、SpSV(SELL)以及稀疏到稠密/稠密到稀疏转换(CSR、CSC)中使用 64 位偏移和 32 位索引,从而支持更大的稀疏矩阵,同时保持索引内存使用低于完全 64 位索引。
- 混合精度 CSR SpMV: 在
cusparseSpMV中将 FP16 或 BF16 矩阵值与 FP32 输入/输出向量和 FP32 计算相结合,减少矩阵存储需求,同时保留 FP32 累加。 - 新的实验性
cusparseSpMVGenericAPI: 在仅存储上三角或下三角的情况下对对称矩阵执行 SpMV,通过避免重复的非对角线元素来减少存储需求。 - 新的实验性
cusparseSpMatConvertAPI: 在 CSR 和 CSC 格式之间转换,使稀疏矩阵布局更容易适应不同的操作。 - 使用
csrcolor实现更快的图着色:以几何平均值衡量,性能提升约 3 倍,减少稀疏矩阵着色所花费的时间。
nvJPEG
- GPU 混合解码吞吐量:
NVJPEG_BACKEND_GPU_HYBRID后端的解码吞吐量提升 10% 到 600%,具体取决于图像大小以及是否使用标准霍夫曼表。 - 自动后端选择: 使用
nvjpegDecodeAPI 时,NVJPEG_BACKEND_GPU_HYBRID现在也被视为自动后端选择的一部分(之前仅考虑NVJPEG_BACKEND_HYBRID和NVJPEG_BACKEND_HARDWARE)
更新的编译器
在打包期间使用 nvprune 预编译设备代码
CUDA 13.5 在 nvprune 中引入了 --precompile 选项,允许开发者在 prune 步骤中将中间设备代码(PTX、TileIR)编译为原生 SASS/ELF。
这消除了将 fat binary 部署到已知目标架构(例如云服务提供商、软件包分发商)的下游使用者的运行时 JIT 开销。
你应选择与部署环境匹配的目标,并在你打算支持的 GPU 架构上验证生成的产物。
扩展 CompileIQ 支持
CUDA 13.5 将高级控制文件(ACF)支持扩展到 PTX Compiler 和 NVVM 库。这使基于这些库构建的编译工作流能够应用 CompileIQ 生成的编译器控制。
对 TMA 寻址的更多控制以及更快的基于周期的三角函数
CUDA 13.5 扩展了 PTX 和设备内建函数能力,帮助开发者优化数据移动和数学运算。
在内核中配置 TMA 越界寻址
分块计算经常遇到张量边界,其中分块的一部分落在张量维度之外。高效处理这些不规则分块对于 MoE、矩阵乘法和卷积等工作负载非常重要。
CUDA 13.5 扩展了 PTX tensormap.replace 指令,使内核可以直接更新张量映射的 Tensor Memory Accelerator(TMA)越界寻址模式。这使开发者在复用张量映射描述符时能够控制寻址行为,并可为受影响工作负载中的非法地址失败消除一种性能代价高昂的变通方法。
使用基于周期的输入进行快速近似单精度三角函数计算
CUDA 13.5 新增了 __sin2pif、__cos2pif 和 __sincos2pif 设备内建函数,用于以周期表示的输入进行快速近似单精度三角函数计算。
此能力适用于可使用快速近似三角函数结果的基于相位的计算。
sin 和 cos 指令对应的 PTX .2pi 变体为已使用基于周期相位的工作负载避免了额外的角度转换操作。
使用 cuobjdump 更轻松地读取 CUDA 二进制符号
CUDA 13.5 改进了 cuobjdump 中的 ELF 符号表输出,使理解 CUDA 二进制中包含的函数和变量变得更加容易。
表 1. 符号属性和 CUDA 特定元数据
| 列 | 描述 |
|---|---|
| Type | 标识符号类型,例如函数或对象 |
| Bind | 显示符号的绑定,例如局部或全局 |
| Vis | 显示符号可见性 |
| Other | 标识 CUDA 特定属性,例如内核入口点和内存空间属性 |
此前,符号信息和 CUDA 特定属性以原始十六进制字段显示,开发者必须手动解码。更新后的输出在四列中呈现描述性值,遵循 readelf -s: 用户熟悉的约定
这使得区分内核入口点和设备函数以及检查与全局、常量、共享和托管变量相关的属性变得更加容易。当多个 CUDA 属性适用时,输出会一起列出它们的名称。无法识别的属性值仍以 UNKNOWN(0xNN) 显示。
此增强适用于现有的 --dump-elf 和 --dump-elf-symbols 选项。例如,开发者可以使用以下命令检查 CUDA 二进制:
cuobjdump --dump-elf-symbols application.cubin
无需额外选项即可获得描述性输出。现有信息——包括符号名称、值、大小和节索引——仍然可用。
如果你使用脚本解析这些符号表转储,请更新脚本解析器以适应新的列和命名属性值。
开始使用 CUDA Toolkit 13.5
CUDA Toolkit 13.5 为 NVIDIA Vera Rubin GPU 架构提供 GA 支持,更新了 GPU 资源管理和通信能力,并在 CUDA Python、CCCL、CUDA Tile、NVIDIA Nsight 开发者工具和核心数学库方面进行了增强。
下载 CUDA Toolkit 13.5 并查阅 CUDA Toolkit 13.5 发行说明,以获取完整的功能列表、支持的平台和兼容性信息。
Jackson Marusarz、Mahender Hari、Mridula Prakash、Daniel Rodriguez 和 Sandeep Hiremath 对本博客中的工作做出了贡献。