Codex 发布时,团队里有人问我:“当 Codex 能一次性搞定我们过去几个月构建的用例时,我们该做什么?”
这个问题触及了 FDE 在 OpenAI 意味着什么的核心。我们与客户并肩工作,理解他们最棘手的问题,并构建他们可以依赖的解决方案。我们学到的东西有助于塑造我们的产品,并为 Research 提供具体的问题去解决。
这就是进步。如果我们每隔几个月就让自己变得过时,那我们的 FDE 团队就是在尽职尽责。
我在 2025 年初创立了这个团队,目的是弥合我们所说的“部署鸿沟”:模型看似具备的能力与人们能够可靠地用来完成工作之间的差距。
模型能力的进步速度超过了将其投入使用的系统和流程。有时缺失的环节是一个产品。有时模型在基准测试中表现良好,却无法在现实变量和约束下完成工作。
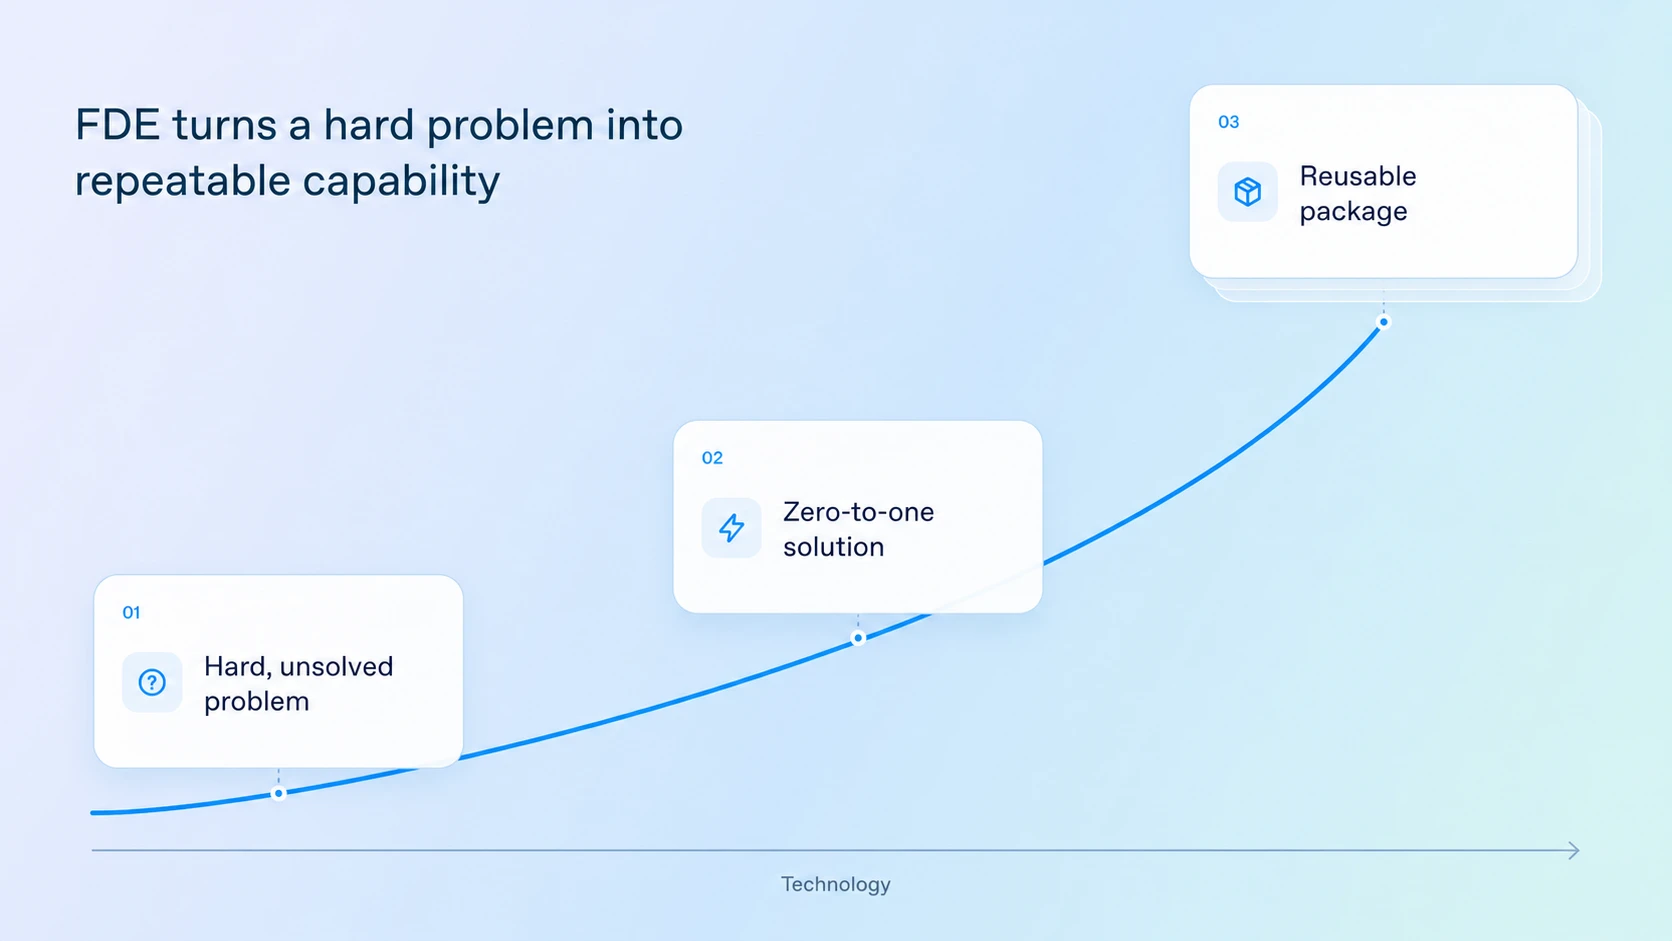
我们专注于客户最难的问题。在我们的模型今天就能胜任的地方,我们与 Product 和客户合作,使解决方案可重复;在模型力有不逮的地方,我们与客户和 Research 合作,界定差距并做出改进。我们的目标是让每一次合作都能为下一位客户留下更好的起点——如果我们把下限提高到客户下次不再需要 FDE 来解决这类问题的程度,那我们就做得很好了。
John Deere 是一家拥有 200 年历史的农业企业,其面临的挑战是如何为农民规模化提供个性化建议。
一个例子是其精准杂草控制技术 See & Spray,它利用摄像头和机器学习来识别并喷洒杂草,而不是处理整片田地,从而将化学品使用量减少多达 70%。
但要实现这些效益,农民需要知道如何配置该技术、规划他们的季节,并随着条件变化调整他们的做法。
John Deere 部署了 OpenAI 的 API,以帮助使这种支持个性化且可扩展。
AI 可以用自然语言回答农民的问题,提供量身定制的设置指导和推荐,识别设备何时可能未发挥全部潜力,并帮助农民了解他们从该技术中获得的价值。
这一机会超越了任何单次交互:在整个客户旅程中提供相关指导,帮助农民更好地利用他们的设备,同时提高效率和可持续性。
这正是 OpenAI FDE 致力于解决的挑战类型:帮助组织从 AI 能力迈向在复杂的现实环境中交付实际价值的系统。
但问题往往是开放式的,可能没有既定的标准答案,也没有现成的操作手册。每个人都想构建从未存在过的东西。愿意为此付出必要努力的人却更少。
在寻找有才华的 FDE 的同时提高“足够好”的基线,意味着不断的实验和应用。
从结果出发
在每次 FDE 团队会议开始时,我都会放一张幻灯片,上面写着一个核心价值观:“从结果出发,不惜一切代价取得成功,然后跟进规模化”。
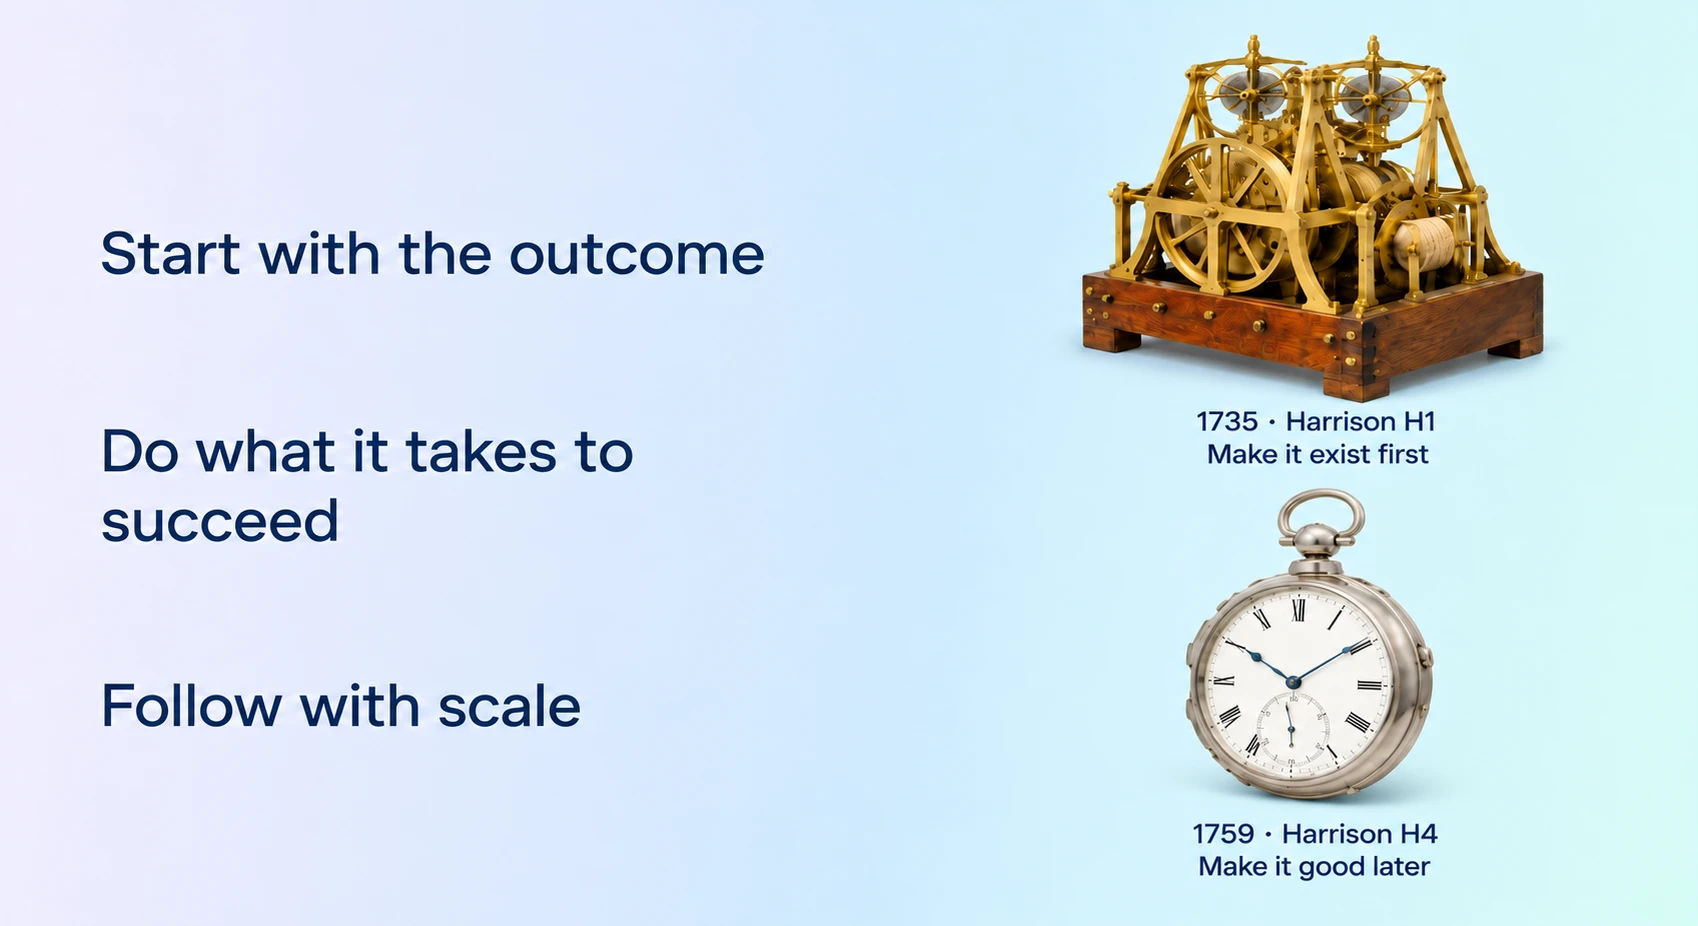
一个令人印象深刻的演示可以在任何人问它是否在现实世界中有效之前走得很远。
我们的工作是把客户的问题解决到我们能在生产环境中为之负责的标准。
2025 年中期,我们约有 15 名 FDE 与一家大型半导体客户合作,处理 10 多个用例。目标是让他们的验证流程实现 AI 原生,涵盖:
- 定向测试生成
- 根因分析与调试
- 架构助手
在这个行业中,验证可能占项目工作量的约 70%。机会巨大,而且有许多可能的起点。
有些 FDE 几天前才加入 OpenAI,从未从事过半导体工作。他们嵌入客户的验证团队,在业余时间学习芯片设计,并与工程师一起构建评估,以测试 AI 能否生成有用的测试并正确诊断芯片故障。
在学习的同时,我们为各个用例构建了定制化的测试框架。在最初的 3-6 个月里,所有这些都进入了生产环境并获得了早期用户采用。回报体现在指标上:
- 通过基于 AI 的定向测试生成节省了约 48% 的时间。
- 通过内核优化,性能中位数提升了 22%。
- 数周的调试被压缩到数小时
当我们回顾这一切时,首席硬件官问道:“你们来这儿之前做过芯片设计师吗?”
我们的 FDE 并不需要在第一天就了解这个行业,但学习它是他们的责任。
随着编码助手让软件构建变得更快,理解客户的业务变得更加重要。我们组建的团队由通才和领域专家混合组成。
你需要足够的知识来做出合理的判断,以及足够的好奇心来质疑关于现状的假设。
例如,在生命科学领域,我们 FDE 的科学背景有助于他们赢得研究人员的信任,这些研究人员从事临床前药物发现任务,如靶点验证与优先级排序、基因表达分析以及化学合成路线重建。这种专业知识使他们能够就这些工作流程如何改进提供有依据的判断。
让成功可重复
我们已经证明这些工作流程能够交付价值,但每一个仍然需要过多的定制集成才能扩展到另一个团队。下一个挑战是在保持这些成果的同时,让软件更易于部署和维护。
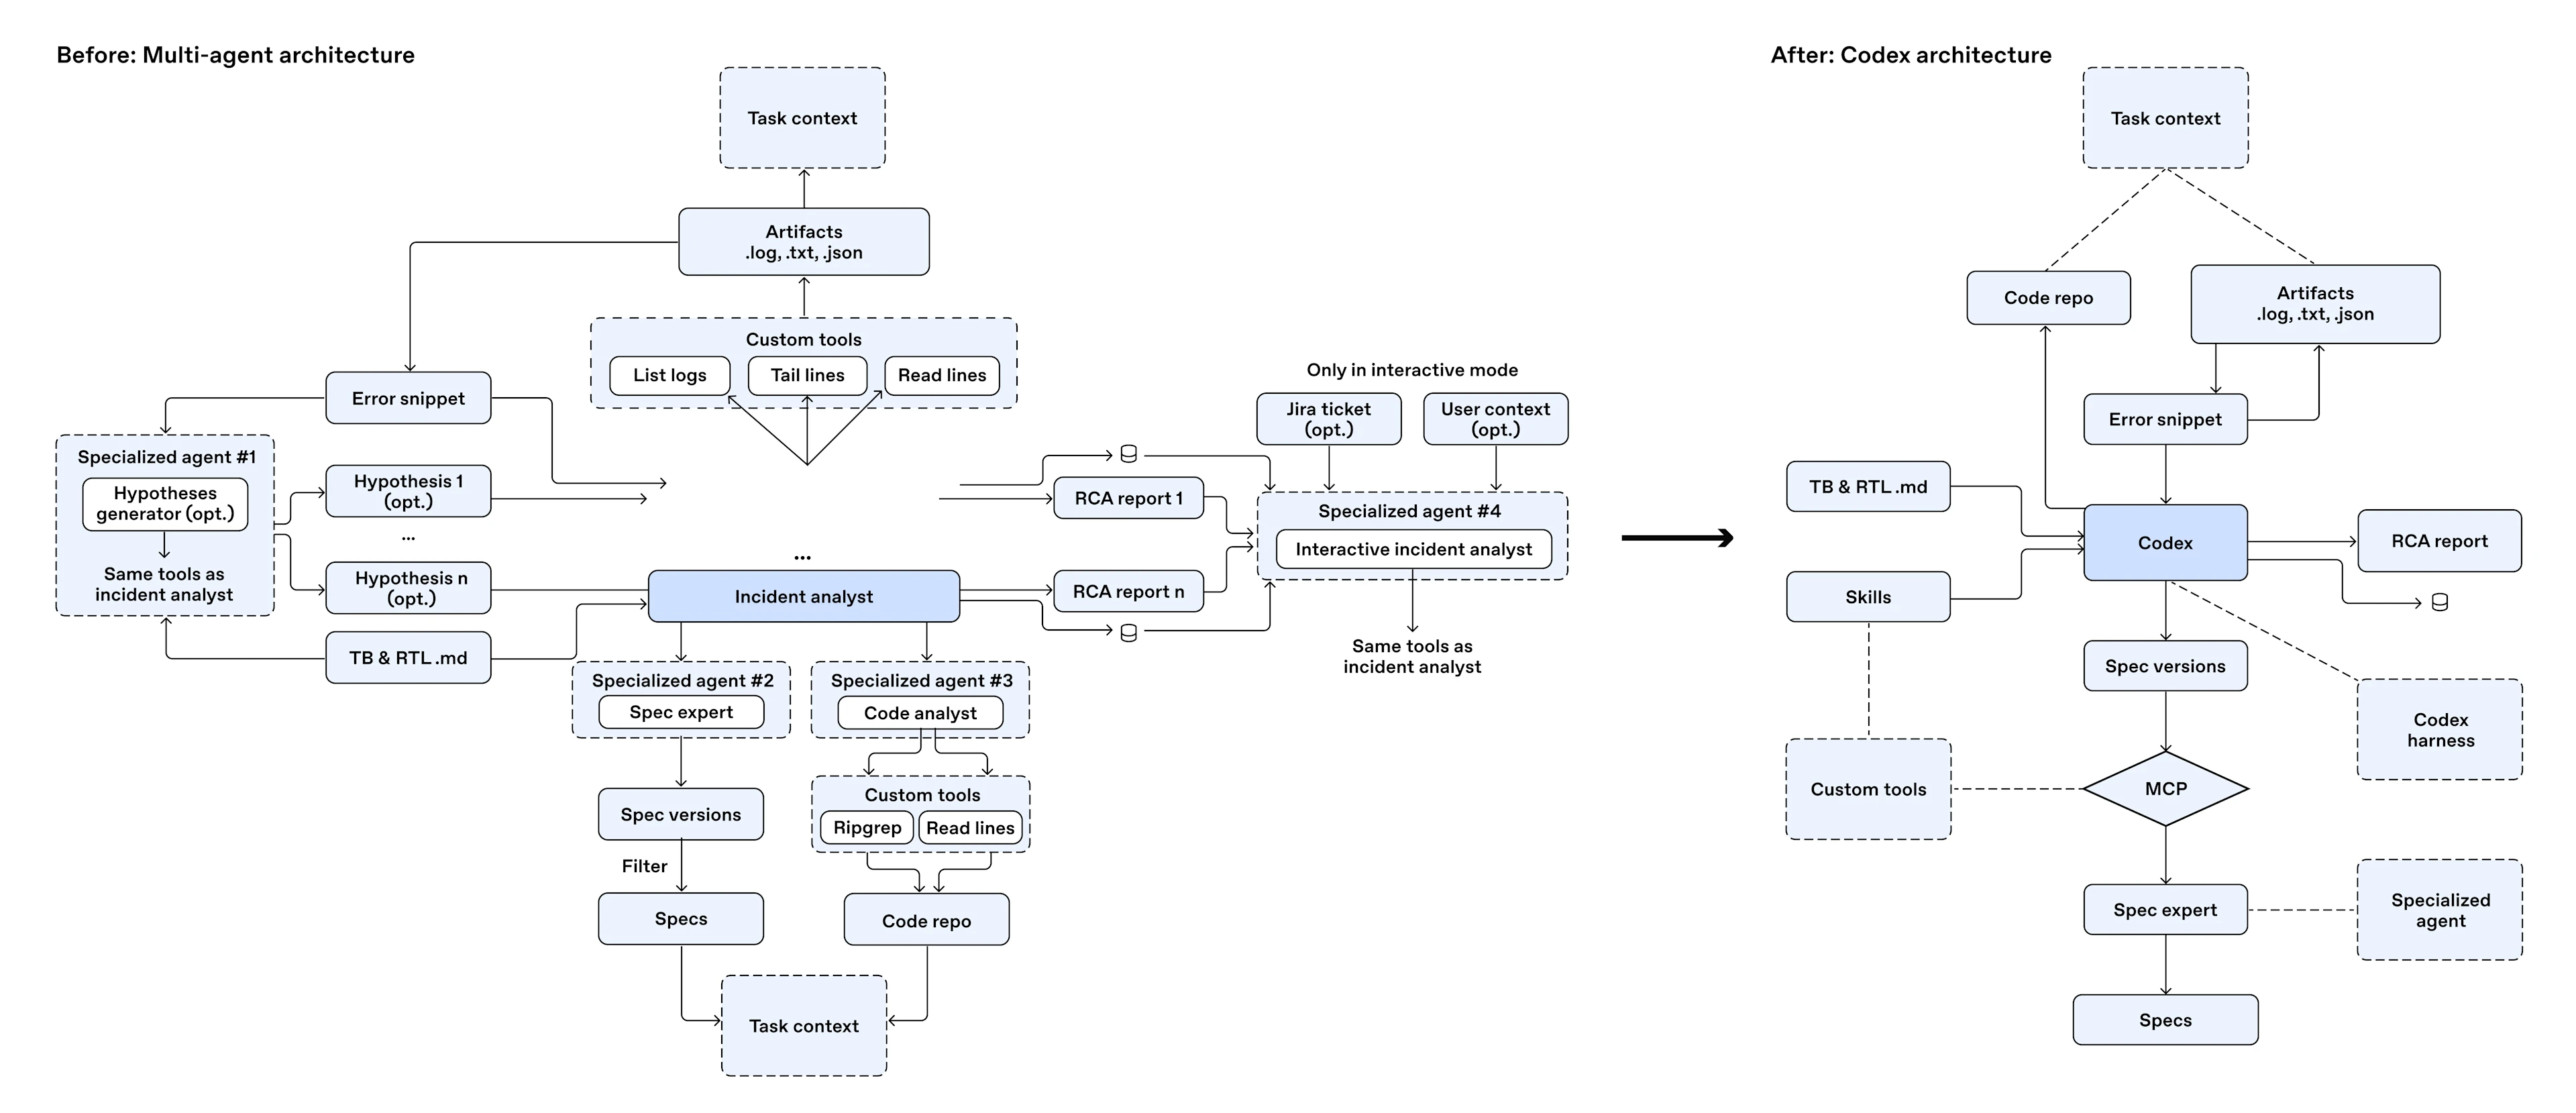
那时,Codex 的能力已经增强。一位 FDE 尝试围绕它重建自己的应用,随后与团队合作,将各个用例迁移到一个以 Codex 为核心的通用框架上。
定制应用变成了基于通用 Codex 原语构建的插件和技能。Codex 还成为了交互界面,使我们能够停用此前为各个用例单独编写的终端 UI 和 CLI。
我们得以从每个项目中移除约 90% 的定制代码,这改变了我们构建、维护和扩展这些工作流程的方式:
- 我们可以受益于对 Codex 的集中式改进,减少每个用例所需的胶水代码
- 关键功能被打包为技能和插件,使它们更易于在彼此之间共享,并由 AI CoE 集中管控。这意味着从一个团队扩展到下一个团队可以简单到只需换入新的连接器/MCP 服务器、构建新的评估(我们也有相应的技能)并启动运行。
- 在 2026 年 8 月的一个例子中,初始部署耗时两个月。将解决方案扩展到第二个团队只用了一天。随着我们扩大规模,后续团队的上手速度更快——这一趋势持续至今,2026 年 8 月的一个用例在初始部署耗时 2 个月后,第二个团队仅用 1 天。
这是让我们自身变得过时的一种方式。我们为达到生产环境所做的工作确立了真正重要的东西。随着底层产品的改进,我们可以替换掉大部分定制实现,同时保留它所交付的价值。
这就是顺序重要的原因。LLM 让我们能够快速构建。利用这种速度将有价值的东西交到用户手中,了解哪些在实践中站得住脚,然后扩展行之有效的部分。
同样的原则适用于所有合作项目。
OpenAI Presence 是我们面向企业语音和聊天智能体的产品,它源于真实的客户部署。这项工作始于 Swarm,并通过 Agents API 演进,如今一位客户已用 AI 处理其超过一半的来电。
将这些部署投入生产让我们了解到哪些问题需要定制解决方案,以及哪些构建模块可供其他团队使用。我们将这些构建模块引入 Presence,使开发者更容易自动化受监管的工作流程,而无需重建底层基础设施。每次部署都帮助塑造了产品,并为下一位客户提供了更好的起点。
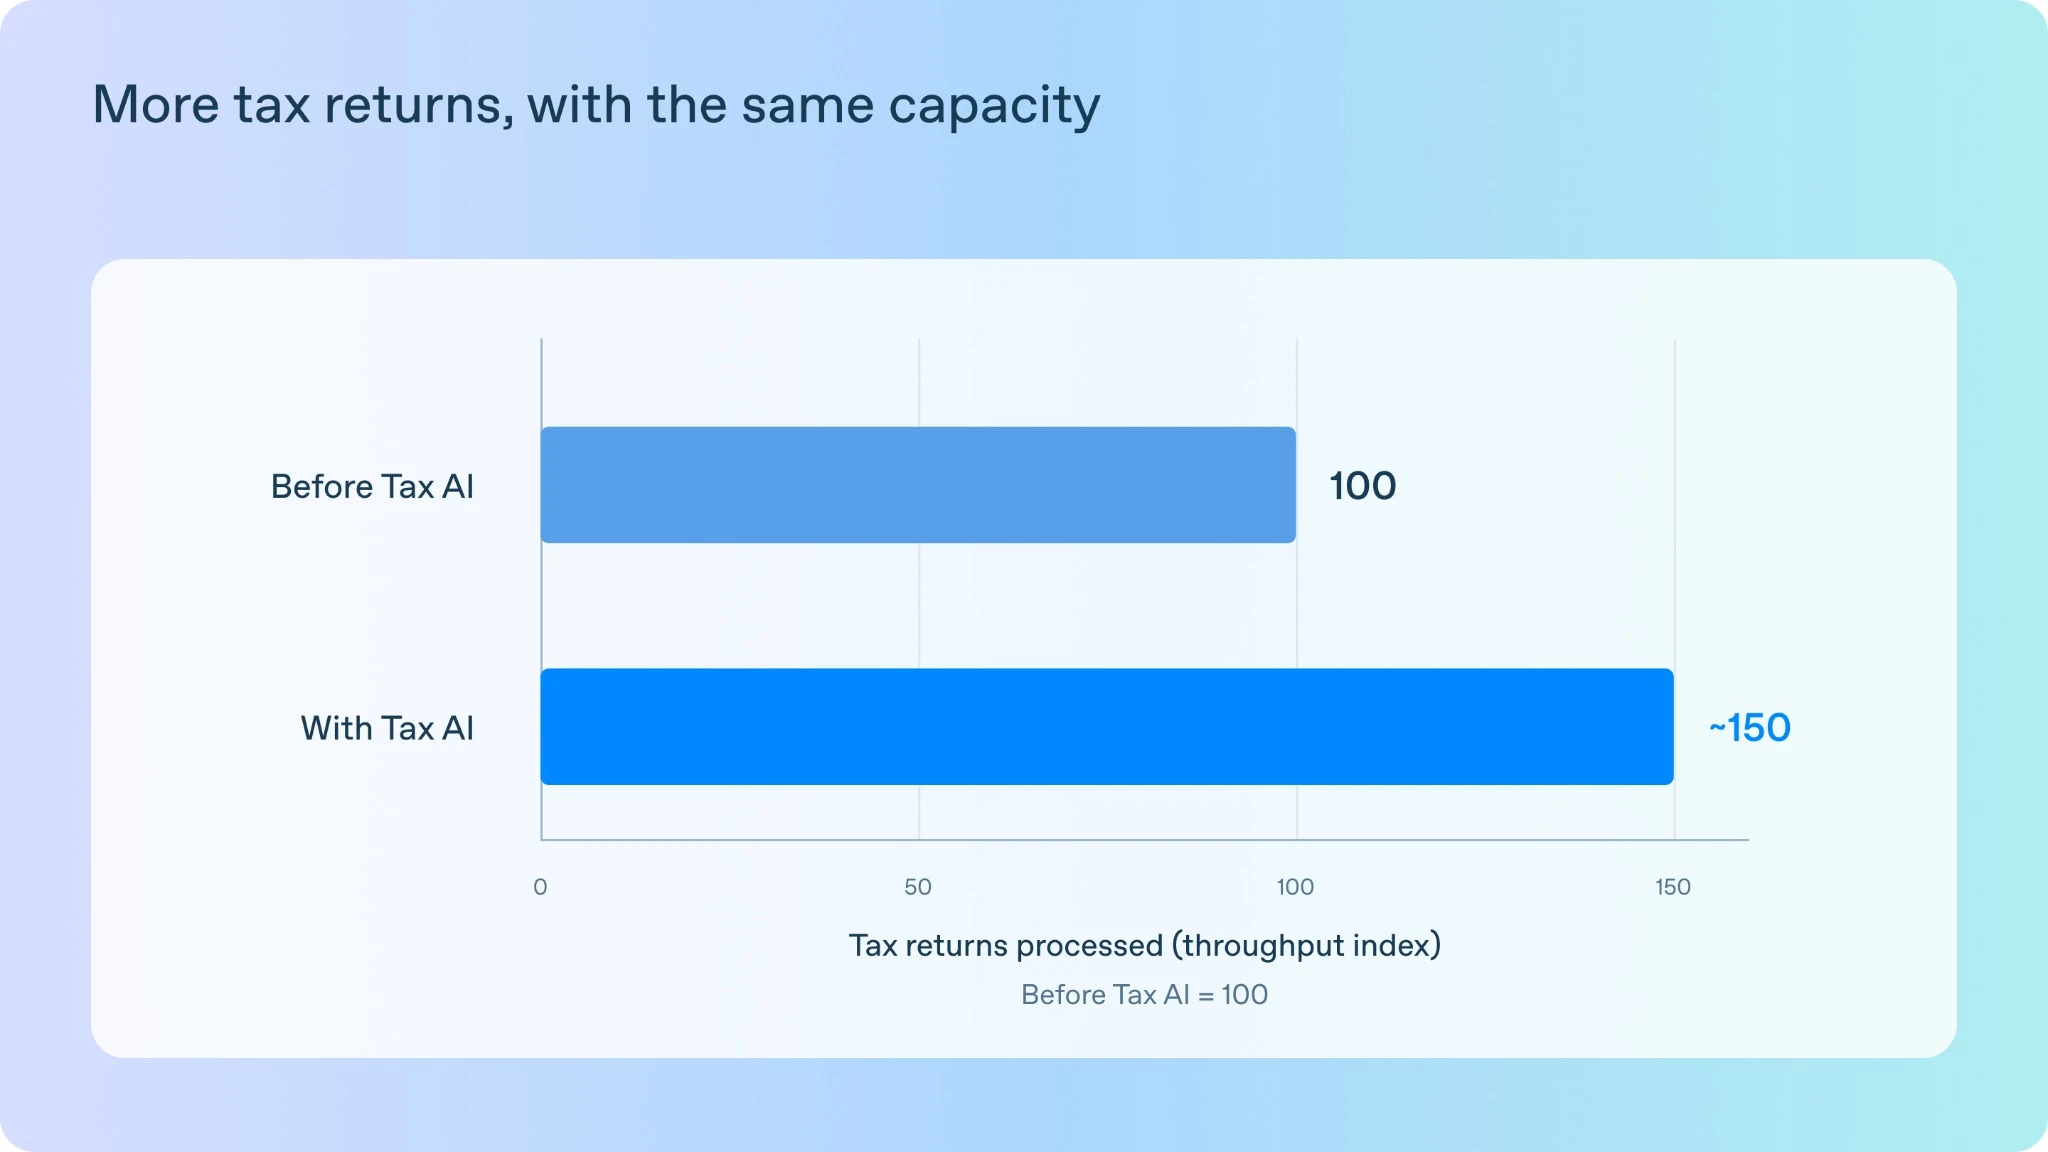
在 Thrive Holdings,OpenAI 的 FDE 和研究人员与工程师和会计师并肩工作,为 Crete 的会计师事务所构建 Tax AI。在试点期间,Tax AI 处理了 7,000 份纳税申报表,并将吞吐量提高了约 50%。
最困难的挑战之一是自动化租赁房产申报,这需要六周的工程和从业者审查才能达到 90% 的精确率和召回率。这项工作创建了可复用的模式,使 Tax AI 更容易扩展到其他复杂的税务表格。
这些团队现在正将同样的方法应用于簿记、审计和 IT 支持——构建通过从业者反馈和实际使用不断改进的系统。
在智能差距出现时将其弥合
有时更好的产品让我们能够简化所构建的东西,但有时模型本身还无法完成这项工作。
如果我们只构建当今模型已经能够实现的东西,我们就不会发现 Research 接下来需要弥合的智能差距。因此,我们的许多重要合作项目都从这些极限开始,客户、FDE 和 Research 承诺共同攻克它们。
我们已经与一家大型电信客户开发了一个客户服务平台,他们希望将其扩展到语音。
语音约占其客户服务量的 90%。这些案例的遏制成本高于聊天,并在口音、语气以及延迟/准确性达到生产级方面带来了一系列新的技术挑战。把它做好将对其业务产生重大影响。
在范围界定期间,我们的模型在我们用于评估其能否在生产中胜任这项工作的关键评估上得分约为 60%。我们已经达到了其能力的极限。客户服务场景中的函数调用和指令遵循需要改进。
我们向客户解释了这一点,并将 Research 引入这项工作。FDE 与客户合作构建平台并定义模型需要做什么。Research 致力于弥合能力差距, successive 模型快照让我们能够根据客户的需求测试进展。
在六个月里,关键评估上的性能从约 60% 提升到 80%,然后达到 90% 以上,达到了生产所需的水平。
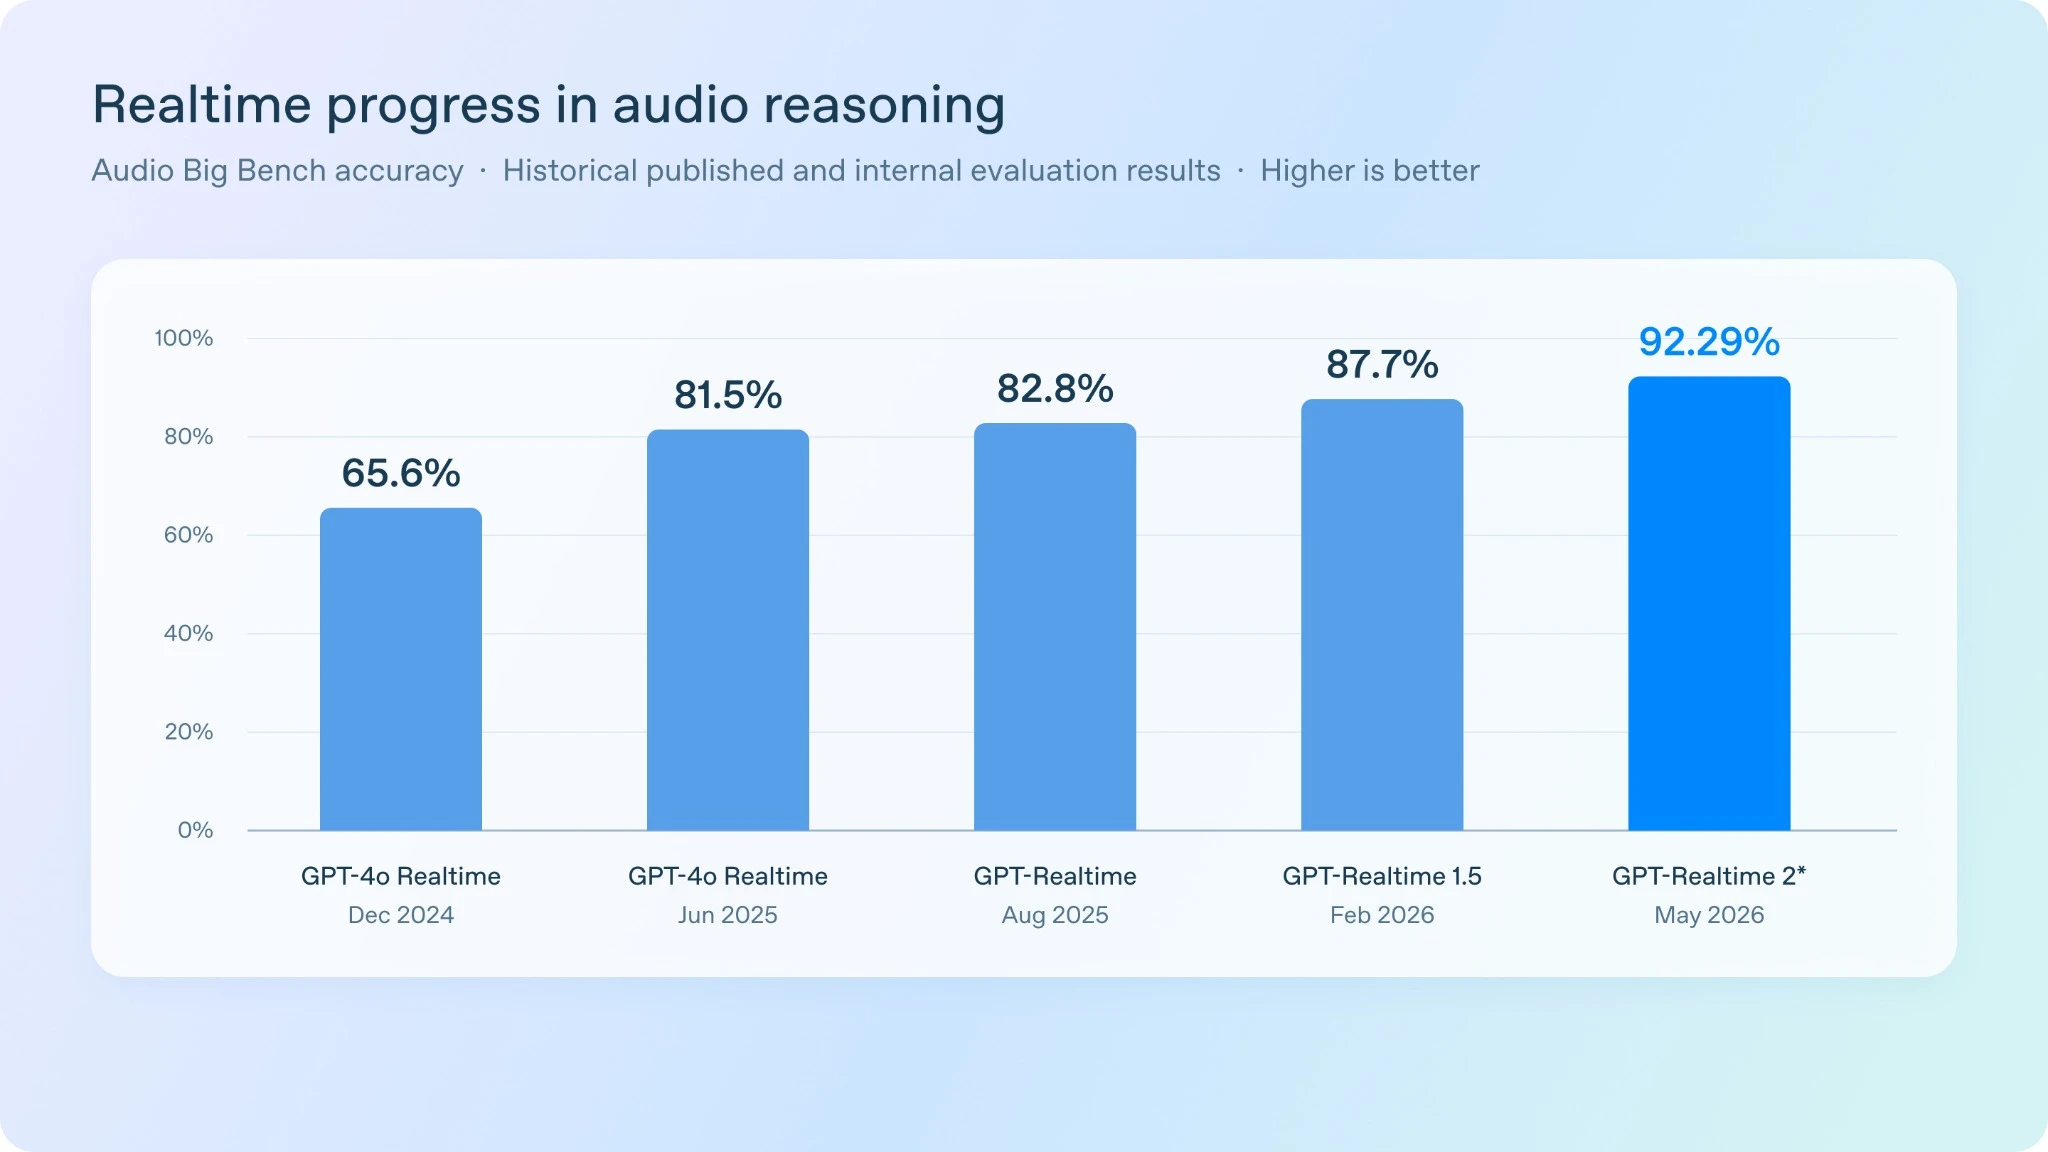
由此产生的语音模型现在支持该客户的部署、其他定制客户服务部署,以及通过 Presence 进行的托管部署。在一个客户业务中遇到的问题帮助确定了可服务于许多其他客户的改进。
每个部分都很重要。客户承诺解决一个模型尚无法解决的问题。FDE 保持足够紧密的联系,以界定该问题、构建平台并从头到尾推动合作。Research 改进了底层模型能力。
这是让我们自身变得过时的另一种方式:帮助将当今模型无法解决的问题转化为未来模型可以交付的能力。我们工作的回报超出了我们在任何单个客户身上花费的时间。
去寻找更难的问题
我加入 OpenAI 是为了帮助让 AI 在人们的日常工作中变得有用。这仍然指导着团队。我经常对团队说,在 LLM 开发的大多数情况下,奥卡姆剃刀(Occam's Razor)适用——最简单的解决方案就是最好的。在一家以其前沿研究为定义的公司里,在一个被夸大其词所污染的行业中,我们希望构建可靠运行、该领域的人可以依赖的东西。
目标是让每一次合作都能改进接下来的事情:一个更容易部署的产品、一个能处理更难任务的模型,或者为下一个客户减少定制工作。
如果你有一个想要解决的难题,我们很乐意与你合作。如果你想帮助解决这些问题,我们很乐意你加入我们。
那么,当 Codex 能够处理我们花了数月构建的工作时,我们该怎么办?
去寻找更难的问题。