自动驾驶(AV)开发者需要能够在车载系统的计算和延迟限制内运行的推理模型。更大的模型为开发这些能力提供了基础,但将其部署到车辆中需要额外的工作来减小模型尺寸、保留有用的推理能力,并在目标硬件上验证性能。
NVIDIA Alpamayo 2 Edge 通过一个自适应推理视觉-语言-动作(VLA)模型来满足这一需求,该模型专为在 NVIDIA DRIVE AGX Thor 上实时运行而设计。它基于 NVIDIA Cosmos 3 Edge 的 2B Nemotron 推理骨干构建,并搭配扩散动作专家,利用环视摄像头观测、时序上下文和导航输入来生成因果链(CoC)推理和未来驾驶轨迹。它自适应地进行推理,仅在需要时生成推理,减少不必要的 token 生成,并在常规驾驶期间节省推理计算。
Alpamayo 2 Edge 在 NVIDIA AlpaGym 中通过闭环强化学习(RL)进行后训练,在未使用闭环 RL 的最佳性能检查点基础上,将闭环驾驶性能提升了 48.9%。这些能力共同为开发者提供了一个强大、边缘就绪的基础,用于将基于推理的驾驶引入车载栈。
使推理模型足够紧凑以进行车载部署引入了一个关键挑战:在减小模型尺寸的同时保持其推理和驾驶行为的质量。这需要一种方法来衡量推理质量,并利用该反馈来改进模型。NVIDIA AlpaJudge 是用于 Alpamayo 2 Edge 开发的人类校准评估和奖励模型,用于评估推理轨迹、选择更高价值的训练数据并提供 RL 奖励。
本文介绍 Alpamayo 2 Edge,解释其在 DRIVE AGX Thor 上的推理优化,并探讨在 AV 开发工作流中使用 AlpaJudge 的三种方式:
- 在 PhysicalAI-AV 样本上运行 AlpaJudge-RB 和 AlpaJudge-RF,检查其分数,并将评估适配到策略生成的推理
- 选择能暴露有用学习机会的训练示例
- 使用人类对齐的推理分数作为后训练的奖励
这些工作流共同将面向边缘的驾驶模型与可重复的测量和改进流程连接起来。
将基于推理的驾驶带到边缘
车载驾驶模型必须在系统的推理预算内解释不断变化的场景并生成有用的轨迹。关键问题是模型在该约束下保留了多少驾驶和推理能力。
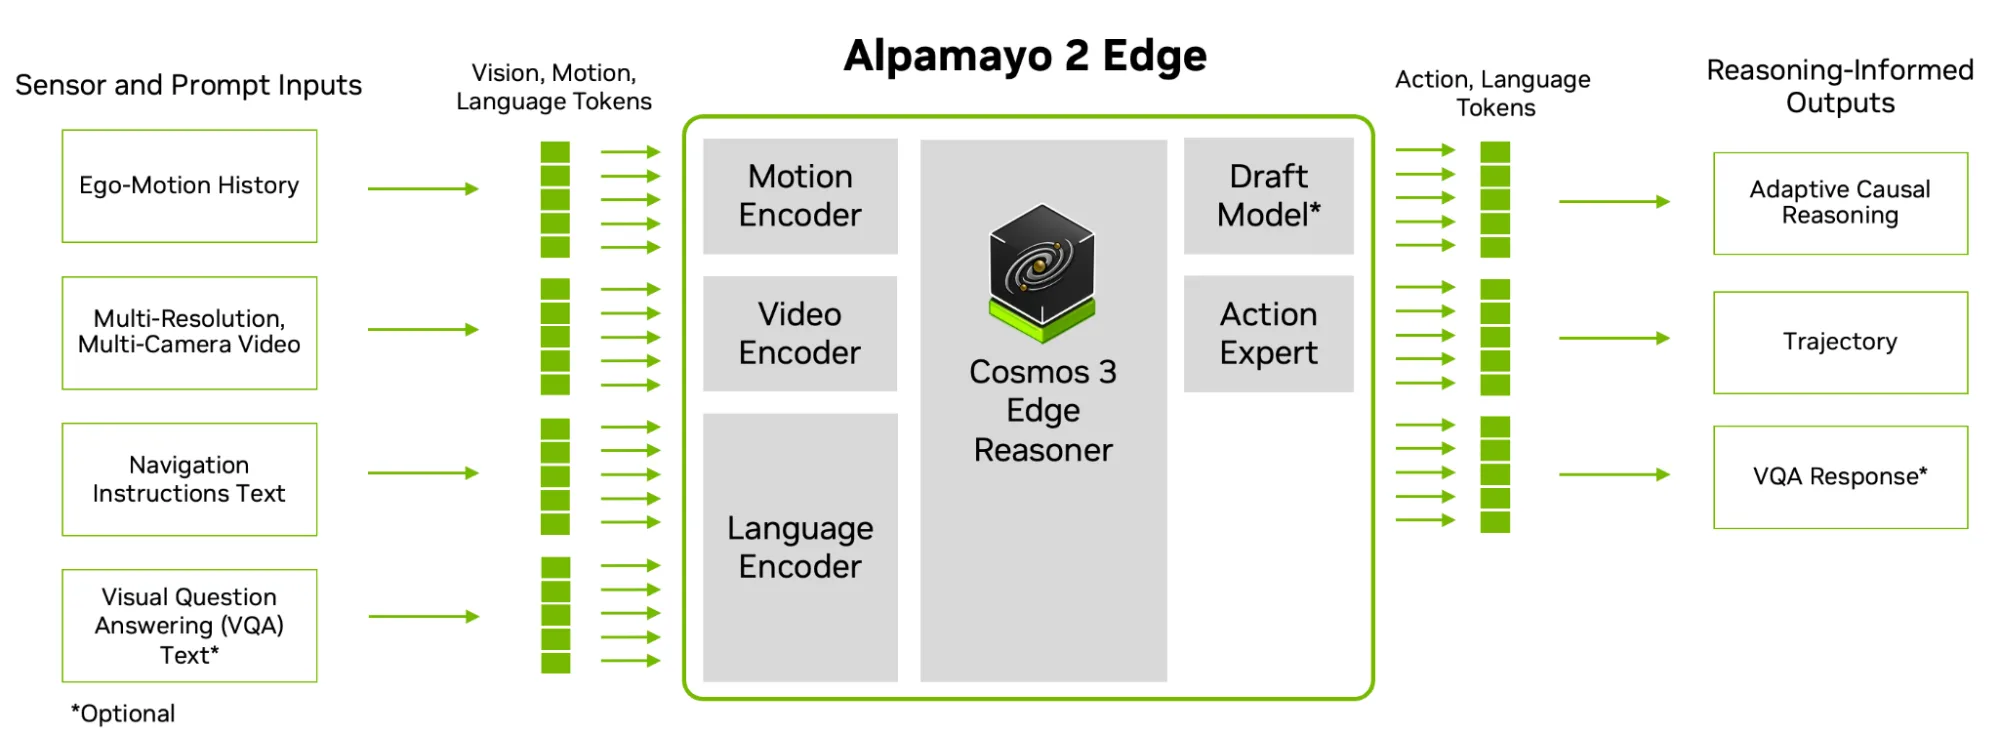
为了平衡模型容量和效率,Alpamayo 2 Edge 利用了多项新特性:
- 一个 2B 参数的 Nemotron 推理骨干,尺寸适合车载推理
- 自适应推理,减少不必要的 token 生成,并在常规驾驶期间节省推理计算
- 离线蒸馏,使用 Alpamayo 2 Super 生成的 CoC 推理自动标签进行训练
- 在 AlpaGym 中进行闭环强化学习后训练,模型在仿真中端到端地从其行动的后果中学习
- 多分辨率输入,以在线高效编码环视观测
- 使用 DFlash2 进行推测解码,以在不牺牲质量的情况下加速在线推理
- 使用 NVIDIA TensorRT 和 NVIDIA TensorRT-Edge-LLM 进行量化和推理加速的配方
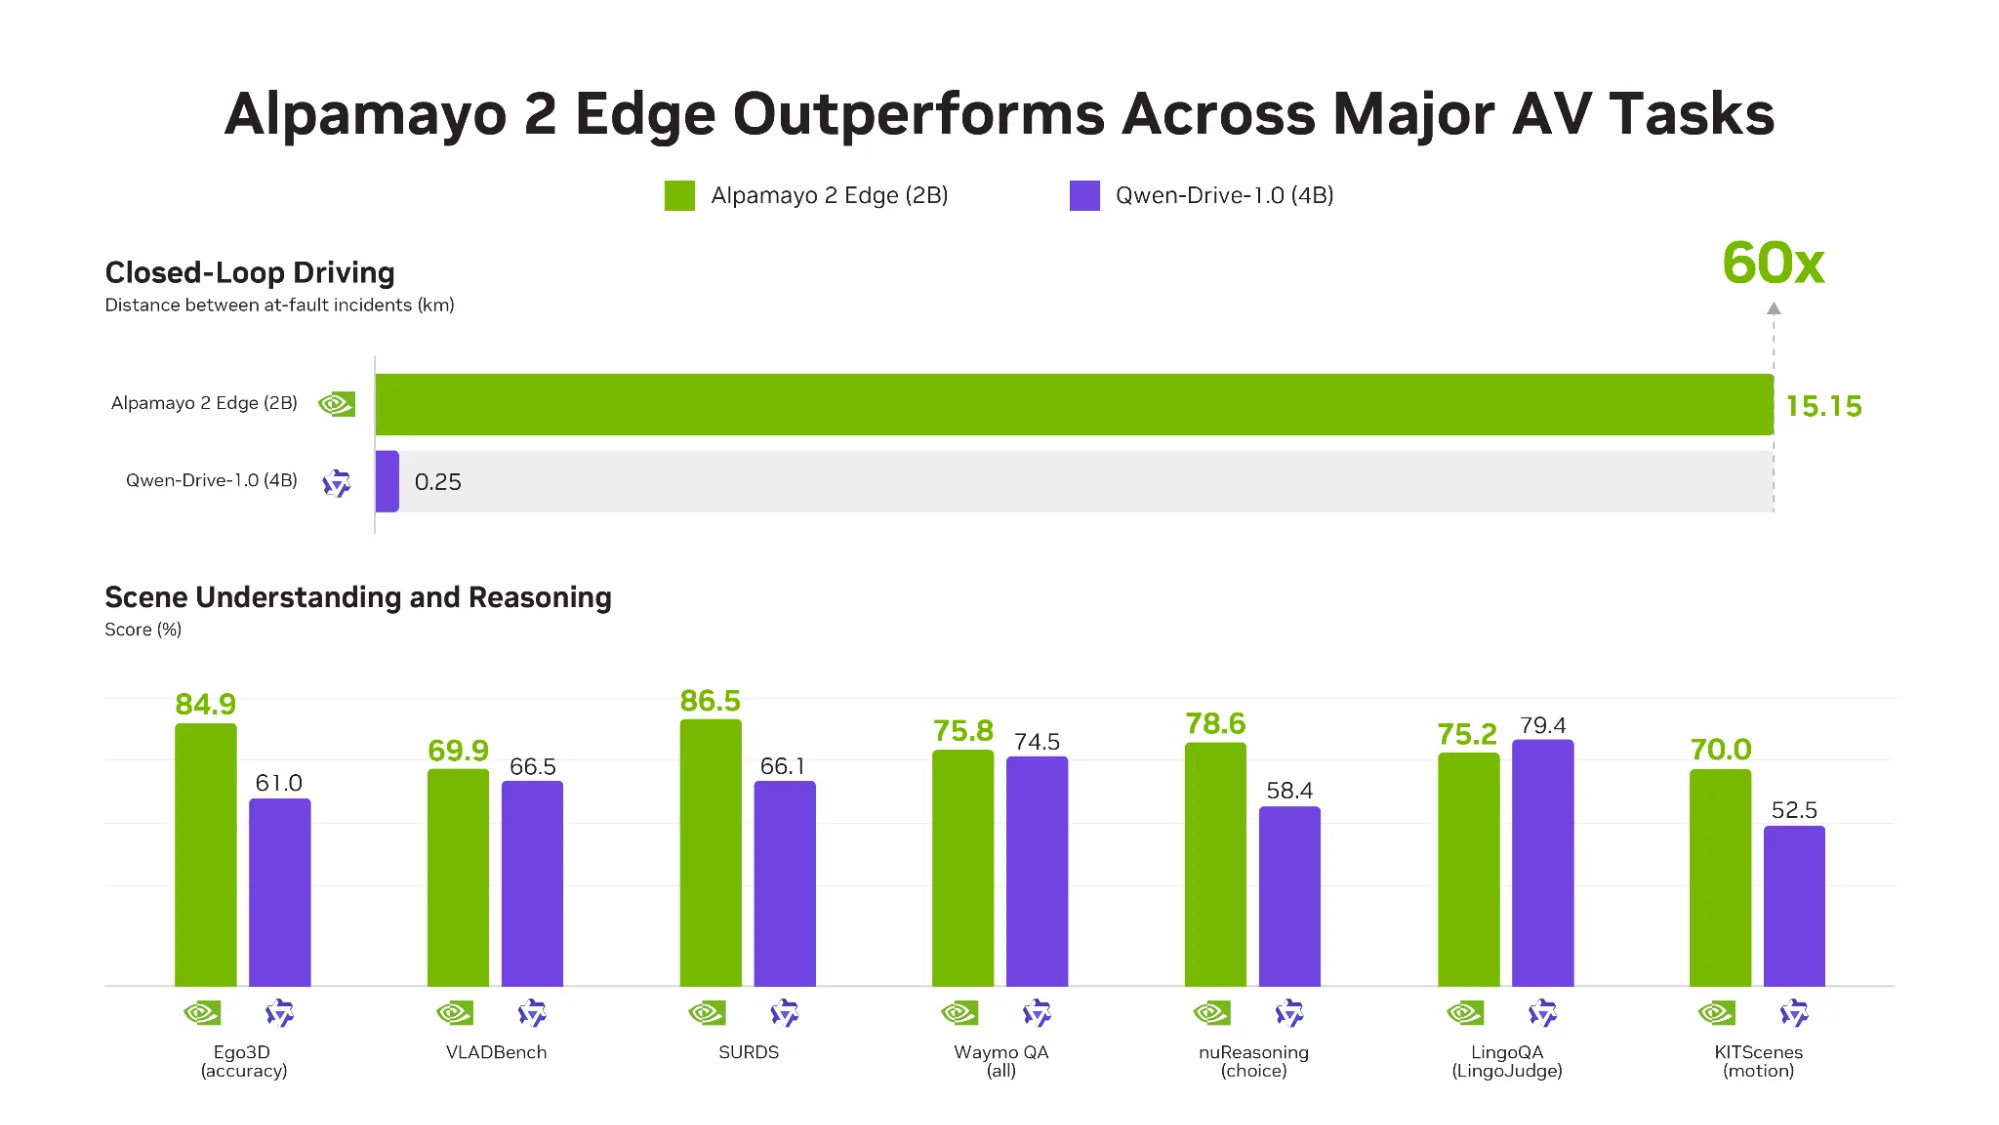
下面的图 2 展示了这些选择如何转化为能力,在闭环驾驶、开环轨迹预测以及场景理解和推理方面将 Alpamayo 2 Edge 与 Qwen-Drive-1.0 进行比较。
早期合作伙伴反馈也强调了 Alpamayo 2 Edge 的驾驶性能和推理速度:
“在获得 Alpamayo 2 Edge 早期访问权限的几天内,我们就在自己伦敦街道录音的 NuRec 重建中让它闭环运行。在我们的早期仿真测试中,Edge 保持车道的运行次数是 Alpamayo 1.5 的两倍多,从车道偏移中恢复的频率高出约 40%,并且在开箱即用的情况下,在同一 GPU 上的规划速度大约是我们手动调优的 Alpamayo 1.5 服务器的两倍。” ——Matas Simonavicius,PORT 首席技术官
“Alpamayo 2 Edge 展现了令人印象深刻的泛化能力,在我们的零样本评估中,与 Alpamayo 2 Super 相比,位移误差(minADE)降低了 13.6%,3 秒时的横向预测误差(RMSE)降低了 46.1%,尽管传感器配置存在显著差异。在我们自己的驾驶数据上进行微调后,与 Alpamayo 2 Edge 基线相比,位移误差进一步降低了 44.2%。在短短几天内,我们就从收到模型进展到在真实车辆上运行我们的首批测试。” — Luca Crotti,Niulinx 联合创始人兼运动规划负责人
▶ https://developer.download.nvidia.com/devblogs/niulinx-police-officer.mp4
视频 1. Niulinx 的驾驶演示显示车辆在交通警察信号前停车并在人行横道处礼让行人
“在不到48小时内,我们让NVIDIA的Alpamayo 2 Edge在AGX Thor上以10 Hz运行,实现实时规划。”—— Hans Salomonsson,首席执行官兼联合创始人, Embedl
▶ https://developer.download.nvidia.com/devblogs/Embedl.mp4
视频 2. Alpamayo 2 Edge 在 PyTorch 中运行与使用 Embedl 优化运行的并排比较,显示规划速度、延迟和推理输出的差异
Alpamayo 2 Edge 仓库的推理脚本展示了模型如何运作:它接收随时间变化的环境摄像头观测、导航文本和历史自车运动,以生成 CoC 推理轨迹和未来轨迹。
import torch
import transformers

from alpamayo2_edge.checkpoint import load_model
from alpamayo2_edge.load_physical_aiavdataset import load_physical_aiavdataset
from alpamayo2_edge.helper import prepare_model_inputs, to_device
from alpamayo2_edge.models.utils import fuse_traj_tokens

data = load_physical_aiavdataset(**clip)
model, loading_info = load_model("nvidia/Alpamayo2-Edge")

settings = dict(
    seed=43,
    top_p=0.98,
    top_k=None,
    temperature=0.6,
    num_traj_sets=1,
    num_traj_samples=1,
    max_generation_length=256,
    diffusion_kwargs={"inference_step": 10},
)

prepared = prepare_model_inputs(data, model.config, model.tokenizer)
prepared = to_device(prepared, device="cuda")

"""Seed text and diffusion sampling, then run the model on prepared inputs."""
torch.manual_seed(settings["seed"])
generator = torch.Generator(device="cuda").manual_seed(settings["seed"])
with (
    torch.inference_mode(),
    torch.autocast(
        device_type=torch.device("cuda").type,
        dtype=model.dtype,
        enabled=model.dtype != torch.float32,
    ),
):
    xyz, rot, _, extra = model.sample_trajectories_from_data(
        prepared,
        num_traj_sets=settings["num_traj_sets"],
        num_traj_samples=settings["num_traj_samples"],
        top_p=settings["top_p"],
        top_k=settings["top_k"],
        temperature=settings["temperature"],
        max_generation_length=settings["max_generation_length"],
        diffusion_kwargs={**settings["diffusion_kwargs"], "generator": generator},
        return_extra=True,
    )
特别需要注意的是,模型现在有时会生成特殊的<NOMINAL>标记而不是推理轨迹,这表明是常规驾驶并节省推理计算量。
在部署期间保持质量
从 Hugging Face 下载模型时,默认情况下,Alpamayo 2 Edge 的权重以 BF16 表示,并且可以在任何支持的 NVIDIA GPU 上作为 PyTorch 模型直接运行。然而,要在 DRIVE AGX Thor 上实时运行,Alpamayo 2 Edge 必须进一步进行推理优化。
Alpamayo 开发者中心包含了 DRIVE AGX Thor 部署工作流的配方:准备 Alpamayo 2 Edge 检查点和 DFlash2 起草器,校准 FP8 缩放因子,导出 ONNX 图,使用 TensorRT Edge-LLM 插件构建 TensorRT 引擎,并运行 Python 测试框架。该配方的参考配置在 DRIVE AGX Thor-X 上使用 DRIVE OS 7.2.7.0、CUDA 13.4 和 TensorRT 11.3.1.9 进行测量。
按照 Alpamayo 2 Edge 部署配方准备模型、评估输入和引擎后,使用以下命令运行捆绑包
python -m alpamayo2edge_edgellm.runtime.run \
  --engines "$WORK/engines" \
  --model "$MODEL" \
  --reference "$INPUTS" \
  --dflash2 \
  --rolling \
  --warmup 1 \
  --repeat 5 \
  --output "$WORK/results.json"
该配方记录了导出、构建、校准来源、板卡要求和各阶段测量结果,以便开发者可以在其 DRIVE AGX Thor 配置上复现延迟和配对质量检查。作为参考,生成的优化模型具有 160 毫秒至 190 毫秒的像素到轨迹推理延迟,具体取决于推理量。相同的配方检查将优化模型的输出与基于相同输入和种子动作噪声构建的 BF16 PyTorch 参考进行比较。
使用 AlpaJudge 评估推理
轨迹指标描述模型如何规划或驾驶。推理评估增加了另一个维度:模型的解释是否识别了相关的场景上下文并支持其描述的决策。AlpaJudge为 Alpamayo 2 Edge 开发(以及之前的模型)的这一方面提供了经过人工校准的评论器。以下工作流描述了如何进行该评估并将其用于模型改进。
根据可用输入选择评判器
AlpaJudge 提供两种检查点变体。根据要评估的示例可用的证据选择变体。
| 变体 | 所需输入 | 返回的评估 |
| AlpaJudge-RB,基于参考 | 问题、参考答案和候选答案;无图像 | [0, 1] 中的一个对齐概率 |
| AlpaJudge-RF,无参考 | 三帧前广角和三帧前长焦、自车元动作历史与未来,以及候选理由 | 五个评分标准概率加上动作、组件和总体分数 |
RB 衡量与提供的参考的一致性,而不是独立检查场景。RF 不需要参考理由,但需要同步的视觉证据和格式化的元动作上下文。
工作流 1:在 PhysicalAI-AV 样本上运行 AlpaJudge
示例笔记本提供了一个有用的起点,可视化与 PhysicalAI-AV 样本相关的数据、元动作上下文、候选理由和参考理由。然后可以使用策略生成的 CoC 轨迹对同一记录重新评分。在输出中保留剪辑 ID、时间戳、摄像头名称和动作上下文,以便低分可以追溯到场景。
在开环评估中,候选解释和轨迹可以与记录的注释进行比较。在闭环评估中,每个策略决策处的解释可以使用该次推演的观测和动作上下文进行评分。高推理分数是理由与评判者评分标准匹配的证据,而碰撞、偏离道路、近距离接触和轨迹度量描述了驾驶行为的不同方面。应一起报告它们。
步骤 1:设置包并打开笔记本
从 AlpaJudge 仓库根目录,安装锁定环境,为模型和 PhysicalAI-AV 数据集进行身份验证,并打开示例笔记本:
uv sync --locked --dev
hf auth login
uv run jupyter lab examples/alpajudge_pai.ipynb
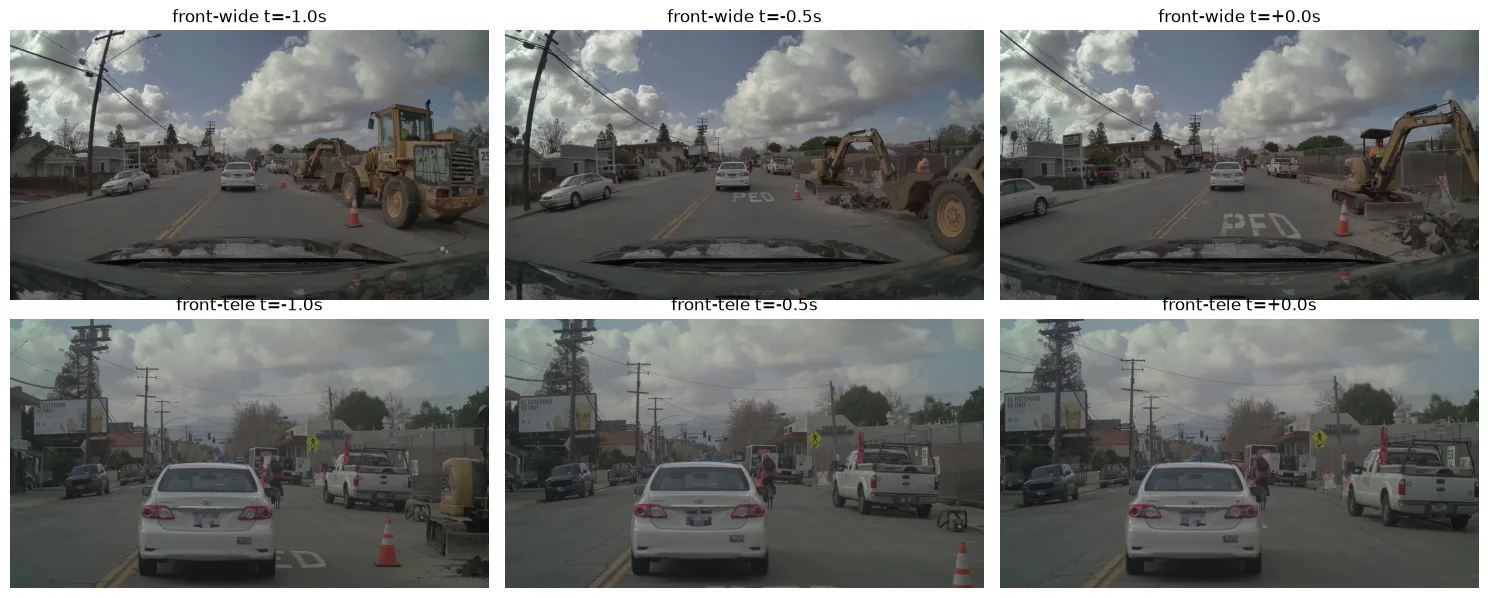
笔记本使用剪辑030c760c-ae38-49aa-9ad8-f5650a545d26在 5.1 秒处。它解码 −1.0、−0.5 和 0.0 秒处的前广角和前长焦帧,最旧的在前。示例理由和元动作字符串是手动编写的;数据集提供摄像头帧。使用不同时刻时,请一起替换所有文本字段。
步骤 2:下载两个评判器检查点
笔记本会下载一次 nvidia/alpajudge,并选择 reference-based/ 和 reference-free/ 子文件夹。这些是独立的检查点,配有独立的加载器。其 snapshot 调用会筛选到这两个文件夹;将 ALPAJUDGE_MODEL_REVISION 设置为不可变修订版本,以获得可复现的运行。模型加载需要 CUDA GPU,并且在激活之前大约需要 5 GB 用于权重。
checkpoint_root = snapshot_download(
    repo_id="nvidia/alpajudge",
    revision=MODEL_REVISION,
    allow_patterns=["reference-based/*", "reference-free/*"],
)
步骤 3:对样本评分并检查两个输出
首先运行笔记本中固定的施工区样本。使用其记录的检查点和输入,冒烟测试报告 RB 对齐度为 0.999,RF 总体为 0.842。五个 RF 子分数评估动作/参考一致性、动作安全性、组件接地、组件完整性和因果一致性。RF 模型定义 action = p_match × (1 + p_safe)/2 和 component = mean(p_grounded, p_complete, p_causal),然后将它们组合为 overall = 0.6 × action + 0.4 × component。
笔记本核心调用:
rb_model, rb_tokenizer = load_reference_based(
    str(checkpoint_root),
    subfolder="reference-based",
    device="cuda",
)
rb = score_reference_based(
    rb_model,
    rb_tokenizer,
    [{
        "question": QUESTION,
        "answer": REFERENCE_RATIONALE,
        "student": CANDIDATE_RATIONALE,
    }],
)[0].item()

rf_model, rf_processor = load_reference_free(
    str(checkpoint_root),
    subfolder="reference-free",
    device="cuda",
)
rf = score_reference_free(
    rf_model,
    rf_processor,
    front_wide_frames=front_wide_frames,
    front_tele_frames=front_tele_frames,
    meta_action_history=META_ACTION_HISTORY,
    meta_action_future=META_ACTION_FUTURE,
    rationale=CANDIDATE_RATIONALE,
)

print(rb, rf.overall, rf.subscores)
要评估 Alpamayo 2 Edge 本身,请在选定的剪辑上运行其推理脚本,并检查 output.json 中 text.cot 下生成的推理理由。在加载 AlpaJudge-RF 的六帧时,使用相同的剪辑和决策时间,并用生成的字符串替换笔记本中手工编写的推理理由。提供与此决策匹配的元动作历史和未来,而不是复制笔记本的施工场景示例。如果有专家参考 CoC 轨迹可用,将其作为 answer 传递给 RB,并将 Edge CoC 作为 student。
工作流 2:选择更高价值的训练示例
AlpaJudge 的分数对于训练数据选择很有用,因为得分最高和最低的示例通常服务于不同的目的。非常低的基于参考的分数可能表明标签不匹配、rollout 失败或真正困难的案例。在丢弃这些案例之前先审查它们;一刀切地移除低分剪辑也会移除策略需要学习的罕见失败。非常高的分数可以识别当前模型已经能够一致解释、并且不再从中学习太多的场景。中间范围通常包含对进一步训练信息量很高的数据。
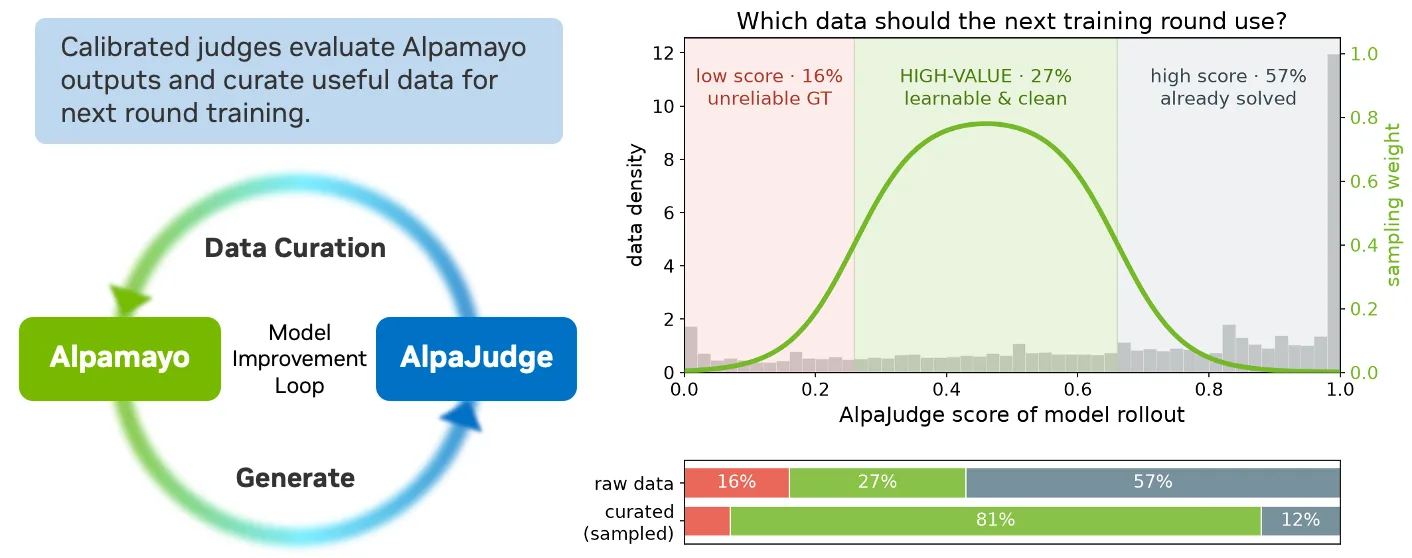
将其应用于你自己的数据集,首先要为每个剪辑生成候选 CoC rollout,并使用固定的 AlpaJudge 检查点。对每个候选与配对的参考进行评分(如果使用 AlpaJudge-RB),记录分数、剪辑 ID 和任何场景元数据,然后手动审查低分和安全关键的示例。在开发集上设置选择阈值,按场景类型和机动对保留集进行分层,并保持留出的评估集不变。重采样信息量大的剪辑用于进一步训练,并将新检查点与相同的基线集进行比较。
工作流 3:使用推理分数进行后训练
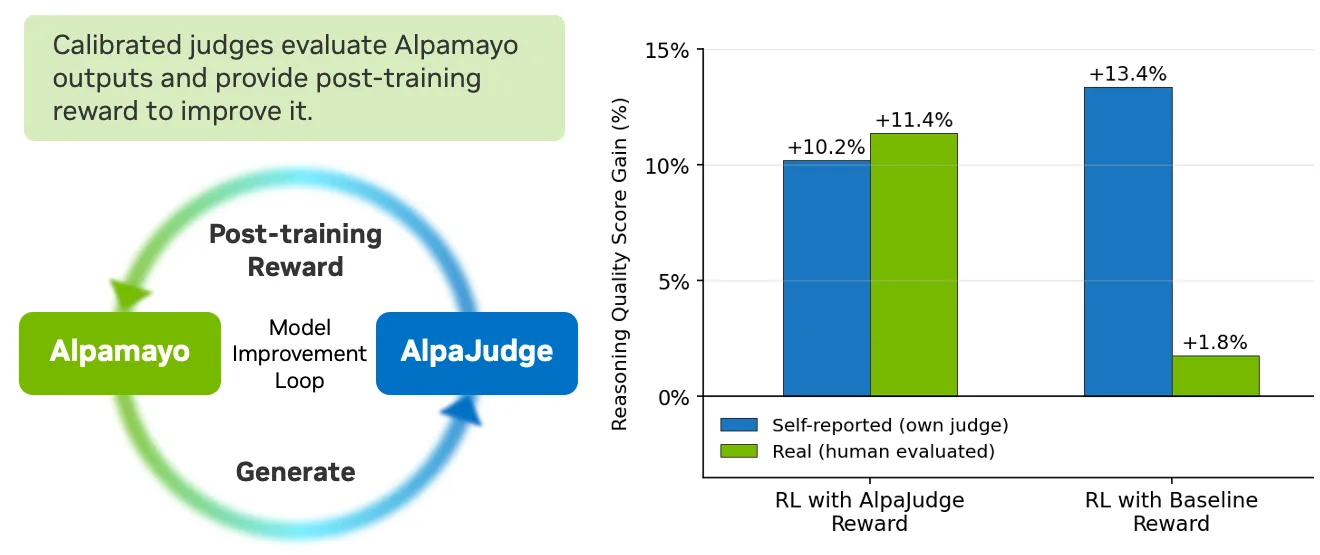
公开的 Alpamayo RL 配方 提供了一种具体模式,用于将推理奖励添加到开环 GRPO 训练中。它生成策略 rollout 组,解码每个 CoC 和轨迹,计算轨迹误差和舒适度,然后调用可插拔的推理评分器,再将各项组合成一个标量奖励。当每个样本都有参考推理轨迹时,AlpaJudge-RB 可以作为该评分器:传入固定的驾驶问题、作为答案的参考以及作为学生的采样 CoC,然后使用返回的对齐概率作为推理信号。
适配器可以通过 score_reference_based 批量处理文本对,来实现该配方的 BaseReasoningGrader.score(predictions, references) -> Tensor[N] 契约。在 GRADER_REGISTRY 中注册该适配器,并将推理奖励配置指向相应的检查点。奖励函数应保留其轨迹门控,并记录两个组件分数,这样策略就不太可能因为流畅但错误的驾驶解释而获得高总奖励。
开始使用 Alpamayo 2 Edge 和 AlpaJudge
这些工作流形成了一个可重复的开发循环:运行边缘模型,将其推理与轨迹和安全指标一起评分,选择信息量大的剪辑,并将下一个候选与初始基线进行比较。对于也用 RL 训练策略的团队,AlpaJudge 可以通过如上所述的适配器提供推理奖励。
在 Hugging Face 上探索 Alpamayo 2 Edge 和 AlpaJudge。如需讨论和开发者问题,请访问 Alpamayo 开发者论坛。查看以下内容以获取更多信息:
- Alpamayo 开放平台 及其最新版本。
- 最先进的研究 为 Alpamayo 的开发提供信息。