机器人学的一个核心挑战是构建能够泛化到训练演示之外的策略。一个在训练场景中成功的策略,往往在物体形状、位置或光照发生变化时就会失败。要泛化到这些新条件,策略需要理解任务背后的物理规律,而不仅仅是模仿演示。这种能力来自它所构建的骨干网络。
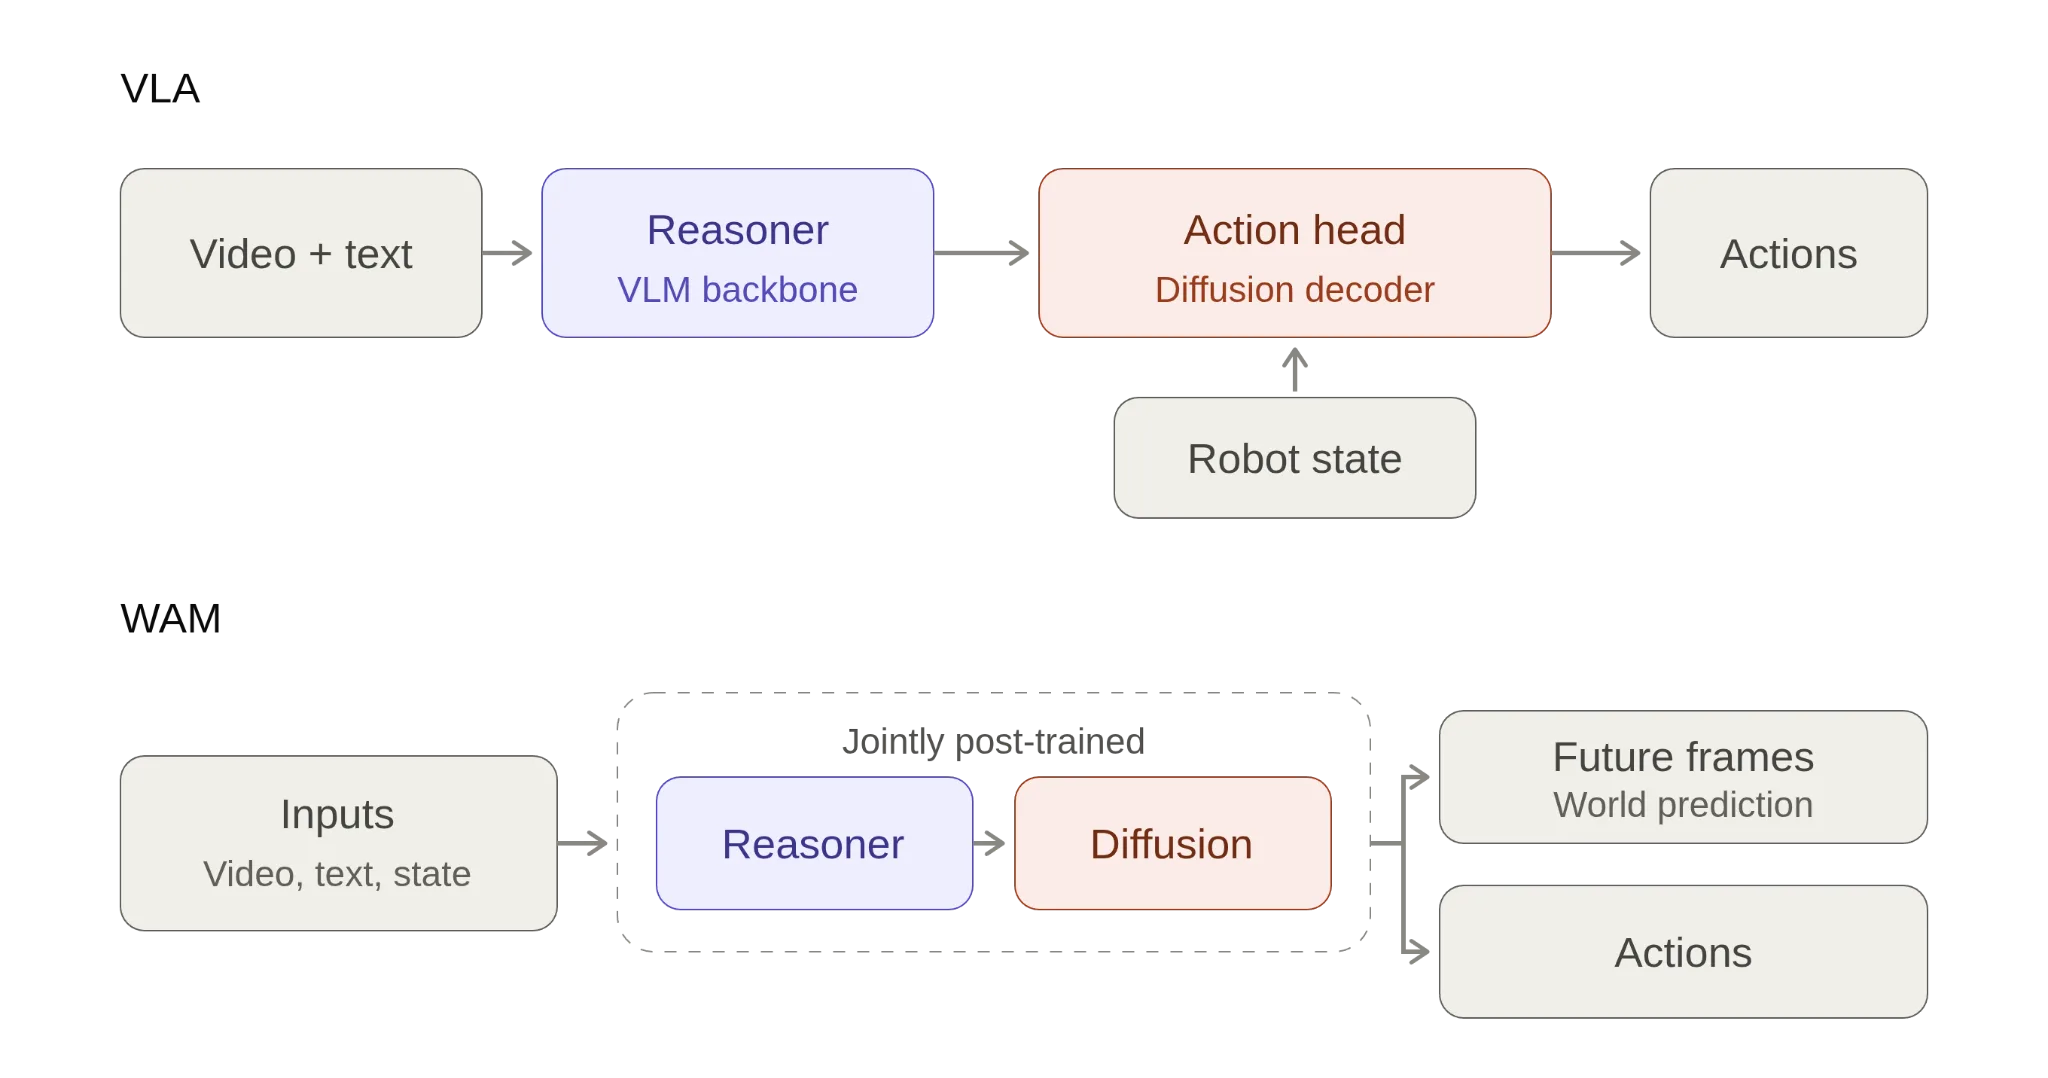
构建语言条件机器人策略的标准做法是在预训练的视觉语言模型(VLM)上添加动作模块,从而产生视觉-语言-动作(VLA)模型。这种方法将通用操作推向了很远。但 VLM 骨干网络学习的是描述世界,而不是预测世界如何演化。当任务依赖于预判场景将如何变化时,机器人恰恰需要这种缺失的动力学模型。越来越多的研究用视频世界模型替代语言骨干网络,从而产生世界动作模型(WAM)。NVIDIA 研究员 Jim Fan 在其Robotics’ End Game演讲中探讨了这一转变——这一想法后来被概括为“VLAs are dead, long live World Action Models.”
本文探讨后训练如何将 WAM 转化为专门的机器人策略、WAM 与 VLA 的对比,以及为什么开放的NVIDIA Cosmos 3世界模型为构建 WAM 提供了强大的基础。
当今后训练策略是如何构建的
在 VLA 范式中,预训练的 VLM 提供对场景和语言指令的语义理解,而后训练则学习将这种理解映射为机器人动作。现代通用机器人策略越来越多地建立在这一方法之上。
然而,VLM 的优化目标是生成关于图像的文本,而不是对场景将如何演化进行建模。它不会学习当夹爪闭合时杯子会发生什么、毛巾如何折叠、物体被释放后会落在哪里。VLA 在语义上泛化良好,但在对未见过的行为和环境的物理泛化方面效果较差,因为它们的骨干网络建模的是语言和感知,而不是世界动力学。
WAM 改变了什么
WAM 通过将策略构建在视频世界模型之上,克服了动力学建模的限制。由于骨干网络对世界如何演化进行建模,后训练不必从头教授动力学,而是对一个已经具备物理先验的模型进行专门化。NVIDIA 研究论文World Action Models are Zero-shot Policies表明,联合预测视频和动作赋予策略一些 VLA 难以轻易获得的特性:
- 它从多样化的数据中学习。VLA 学习将指令映射到轨迹,并且通常需要同一任务的近乎相同的演示。WAM 学习物理规律:物体在被推、被抓取或被放下时如何运动。任何交互数据都能教给它一些东西。一个对 VLA 来说会被浪费的多样化数据集,对 WAM 来说则成为训练信号,数据收集也变得更便宜。
- 它在开放世界中泛化。物理比语义更通用。物体下落或滑动的方式不会随物体而改变,因此一个已经学习了动力学的模型会将这种知识带入它从未训练过的场景和运动中。
- 它用少量演示就能适应新机器人。一个已经理解物理交互的模型,只需要少得多的任务特定数据就能专门化到新的机械臂或夹爪。
对于构建策略的团队来说,这些是实际的收益:达到给定能力所需的数据更少、在训练分布之外的行为更好、通往新具身形态的路径更短。它们是预训练骨干网络的特性,因此会体现在由它后训练出的每一个策略中。
Cosmos 3 是强大的 WAM 基础
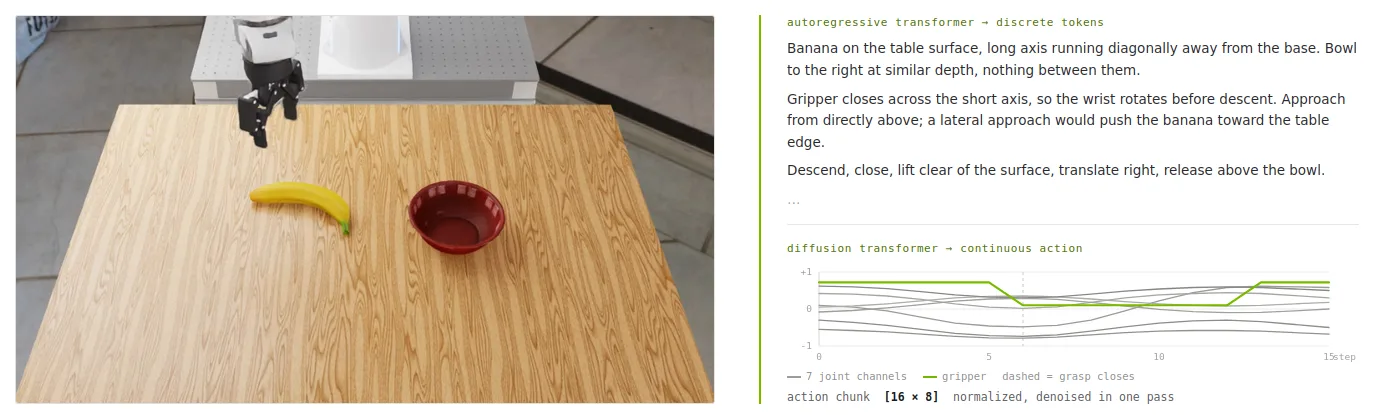
Cosmos 3是一个全模态模型(omni-model)世界基础模型,构建在Mixture-of-Transformers(MoT)架构之上。多模态输入流经用于推理的自回归 transformer,产生文本等离散 token。这引导用于连续模态(包括图像、视频、音频和动作)的扩散 transformer。文本通过下一 token 解码生成;其他一切,包括动作,都通过迭代去噪合成。单个模型跨越这些模态,同时为每种模态保留最适合的生成机制。Cosmos 3 有三种规模:4B NVIDIA Cosmos Edge、16B NVIDIA Cosmos Nano 和 64B NVIDIA Cosmos 3 Super。
使 Cosmos 3 成为强大后训练基础的是其物理世界数据的广度。该数据集包括约 7.67 亿张图像、3.48 亿段真实世界动力学视频、800 万个动作样本,涵盖机器人操作、自动驾驶、相机运动和第一人称运动。
从世界模型到机器人策略:Cosmos 3 Policy DROID 模型
Cosmos 3 是专门化的起点。Cosmos3-Nano-Policy-DROID是一个 16B 参数的策略,由 Cosmos 3 Nano 后训练而来,面向DROID平台,即配备 Robotiq 夹爪的 Franka Panda 机械臂。4B 版本Cosmos3-Edge-Policy-DROID以相同方式后训练,可用于设备端部署。给定语言指令和多相机观测,它生成机器人动作轨迹。其全模态基础带来三个特性:
- 它边行动边想象。当模型输出动作时,它还可以输出视频:如果执行这些动作,机器人相机会看到什么。动作和预测结果来自同一个模型,在同一时间产生。
- 它保留了完整的全模态架构。后训练没有移除任何内容。该策略检查点仍然可以推理并生成视频,而不仅仅是输出关节位置。
- 先验是可衡量的。Cosmos 3 技术报告比较了两个使用相同配方、数据和算力训练的 DROID 策略。一个从基础检查点开始,另一个从在多域动作数据上训练的全模态检查点开始。全模态检查点将 RoboLab 成功率从 28.1% 提升到 36.8%。这清楚地表明,改进来自架构,而不仅仅是规模。
部署考量
WAM 承载完整的生成式世界模型,而不仅仅是一个动作头。它比紧凑型 VLA 更大,但 Cosmos 3 映射到不同的部署层级,而不是强制进行单一权衡:
- 工作站服务(Nano,16B)。Cosmos3-Nano-Policy 在机器人旁边运行,而不是在机器人上运行。真实世界的 DROID 部署在单个 NVIDIA RTX PRO 6000 上为其提供服务,机器人通过网络流式传输观测数据并接收动作块。
- 设备端(Edge,4B)。Cosmos 3 Edge 直接在嵌入式硬件上运行相同的策略工作负载。它以机器人控制分辨率(640×360 观测)运行,并在 NVIDIA Jetson Thor 上每次推理生成 32 个动作,同时以 15 Hz 实现实时控制。它受 NVIDIA 边缘计算机支持,包括 RTX PRO GPU、DGX、GeForce RTX GPU 和 Jetson,包括新的 Jetson T2000 和 T3000 模块。
为什么用 Cosmos 3 构建机器人策略?
WAM 代表了从学习行动到学习世界如何演变的转变。Cosmos 3 使这种方法变得实用:
- 开放基础,SOTA 起点。基础模型、数据集、后训练配方、训练权重、评估工具和服务栈均在允许商业使用的许可下发布。
- 更快的适应。强大的物理先验减少了新策略所需的特定任务数据。将你的数据转换为机器人学习生态系统已经记录的 LeRobotDataset 格式,运行已发布的配方。
- 一个基础,多种机器人。每个新的具身形态,例如 Franka、双臂设置、UR、WidowX,仍然需要自己的后训练运行。但它们都从相同的预训练基础开始,而不是从头预训练世界模型,从而减少了每个形态所需的演示。
开始使用
评估 WAM 是否优于你当前 VLA 的最快方法是在你自己的数据上从 Cosmos 3 后训练一个并进行比较。
- 在 Hugging Face 和 GitHub 上探索开放的 Cosmos 3 模型集合和数据集。
- 阅读 Cosmos 3 技术报告以了解完整的架构细节和评估。
- 收听 8 月 13 日的 Cosmos Labs 直播。
- 成为社区的一员,加入 Cosmos Discord 频道。