NVIDIA CUDA Tile(cuTile)是一种基于 Python 的 DSL 和并行编程模型,适用于 NVIDIA GPU,可自动利用高级硬件功能,为 tile 级 GPU 编程提供峰值性能。通过将线程级和 warp 级调度抽象为高级的、以 tile 为中心的基元,cuTile 使您能够用 Python 编写 GPU 内核,同时编译器优化会自动针对 Tensor Cores 等高级硬件功能。
作为 cuTile 的早期采用者,Jane Street 的机器学习工程师在 cuTile 中实现了 Mamba-2(一种最先进的序列模型),并与 NVIDIA 合作优化内核。Jane Street 是一家技术深厚的全球贸易公司,利用深度学习推动高级量化研究的创新。本文介绍了支持 Mamba-2 前向传递的三个自定义内核及其背后的 cuTile 优化。
概述与先决条件
要使用 cuTile,请确保您的环境满足 cuTile Python 快速入门 指南中列出的要求。将包导入为 cuda.tile,并在本文介绍的内核实现中将其公开为 ct。
序列建模的计算权衡
序列建模架构面临计算权衡:传统的 softmax 注意力使用由 Tensor Cores 加速的矩阵乘法进行快速训练,但在推理时,计算和内存需求随序列长度线性增加。相比之下,循环神经网络(RNN)训练缓慢且不可并行化,但无论序列长度如何,都需要恒定的计算量和固定的内存占用。
Mamba-2 架构
Mamba-2 架构来自一个旨在兼顾两者优势的模型系列。与 RNN 类似,它具有固定大小的隐藏状态和循环更新,可以使用 Tensor Cores 以计算高效的方式分块计算。
Mamba-2 的核心循环为:
其中:
- 、、 和 是 token 处 Mamba-2 层的输入(通过将块的输入投影得到,类似于注意力层中的查询、键和值)
- 是 token 处的输出
- 是跨 token 携带的固定大小隐藏状态。它不是 RNN 中的向量,而是一个矩阵(更多数字和更强的表示能力)
- 和 是学习的模型参数
直观地说:
- (每个头一个标量)表示应更新多少状态。 中的所有值均为负,因为前一状态乘以 ,所以当 时状态保持不变
- (大小为 H 的向量)的作用类似于注意力中的值
- (大小为 S 的向量)的作用类似于注意力中的键
- (大小为 S 的向量)是状态如何混合以产生输出,其作用类似于注意力中的查询
状态 是一个大小为 S,H 的矩阵( 是外积)。为了简化计算编写,使用 并将乘积 称为 。方程则简化为:
这种循环公式非常适合顺序推理。然而,训练和预填充需要比 for 循环更快的方法。虽然线性状态更新允许并行扫描算法,但这种方法需要具体化一个巨大的隐藏状态张量,使其主要受内存限制且无法利用 Tensor Cores。
另一种方法通过矩阵乘法直接计算任何未来隐藏状态,从而利用 Tensor Cores。为简化忽略 项,从 到 就是:
如果通过堆叠所有 构建形状为 (T, S) 的矩阵 ,并通过堆叠所有 构建形状为 (T, H) 的矩阵 ,那么这仅仅是 :
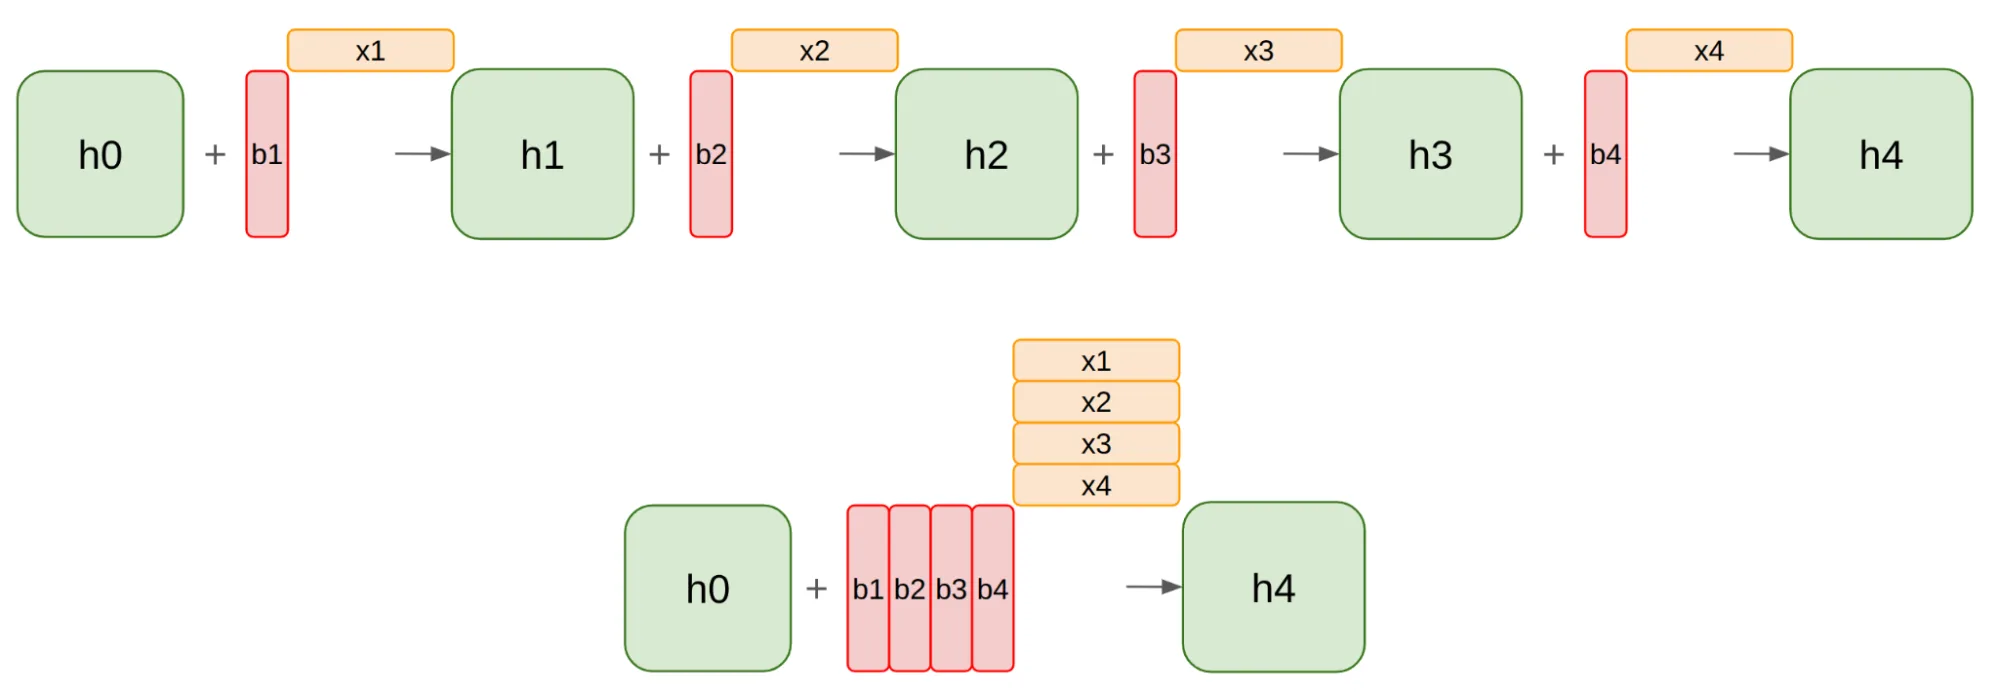
使用此跳跃公式,您可以高效地计算序列中各个块“检查点”处的隐藏状态。下一步是找到一种方法,仅 给定 来计算输出 、、、。如果计算 、、、、…… 这会很容易,但这样做会违背跳跃公式的目的。
暂时仍移除衰减项 ,目标是计算:
其中使用前一个公式来展开隐藏状态。跳跃连接项 很容易推理。对于其他项,看起来像这样:
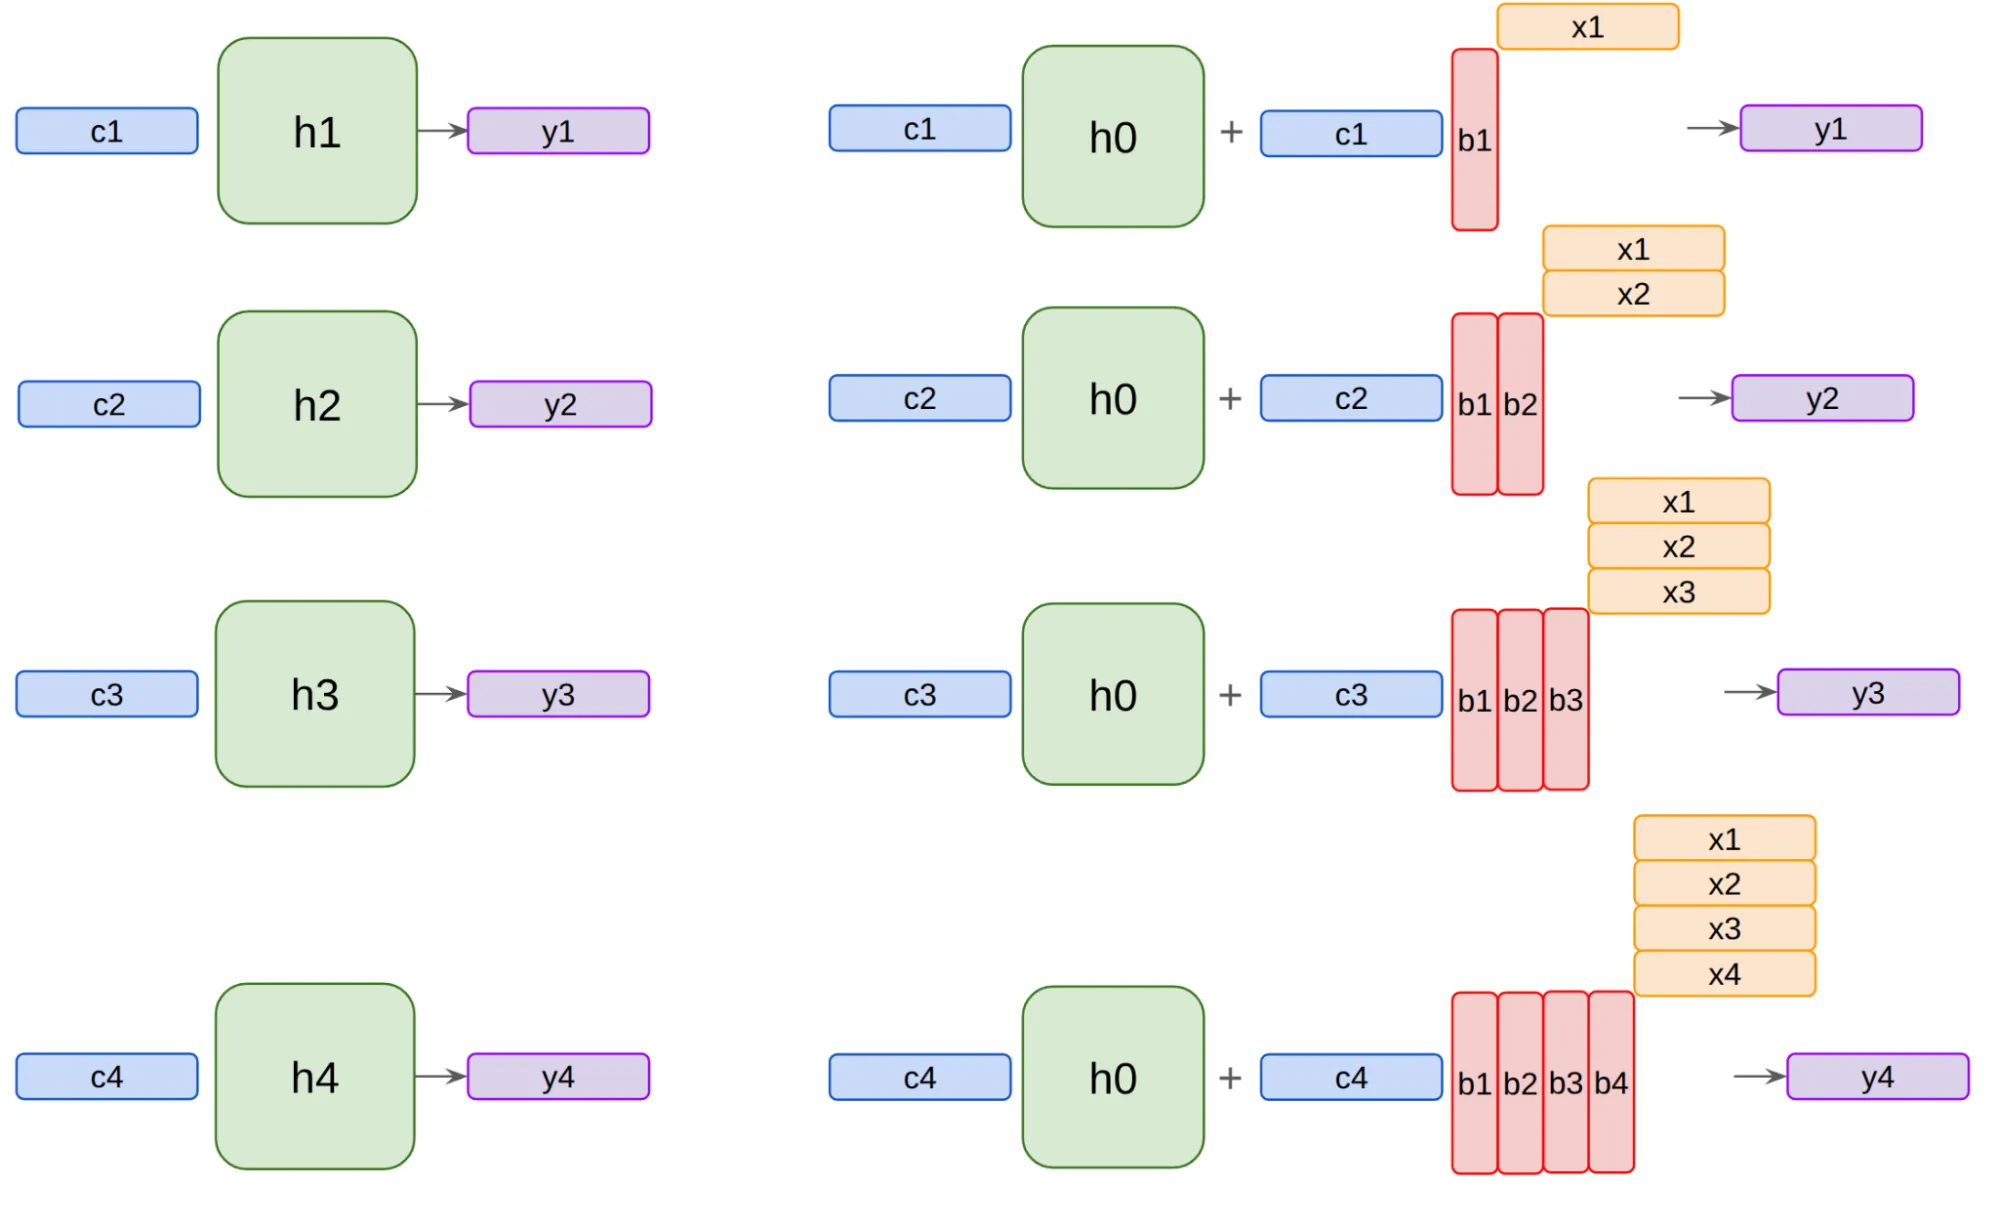
同样,将一组 、、 和 分组到矩阵中,可以用 Tensor Core 友好的矩阵乘积重新表达(图 3),其中 乘 乘积中的三角形是因果掩码(类似于因果 softmax 注意力)。
在计算输出 时,您有 与所有 (对于 )的乘积,因此在计算完整矩阵乘积时,需要屏蔽未来的项(对角线以上)。在数学上,这变为(加回跳跃连接):
其中 是传统的因果掩码。
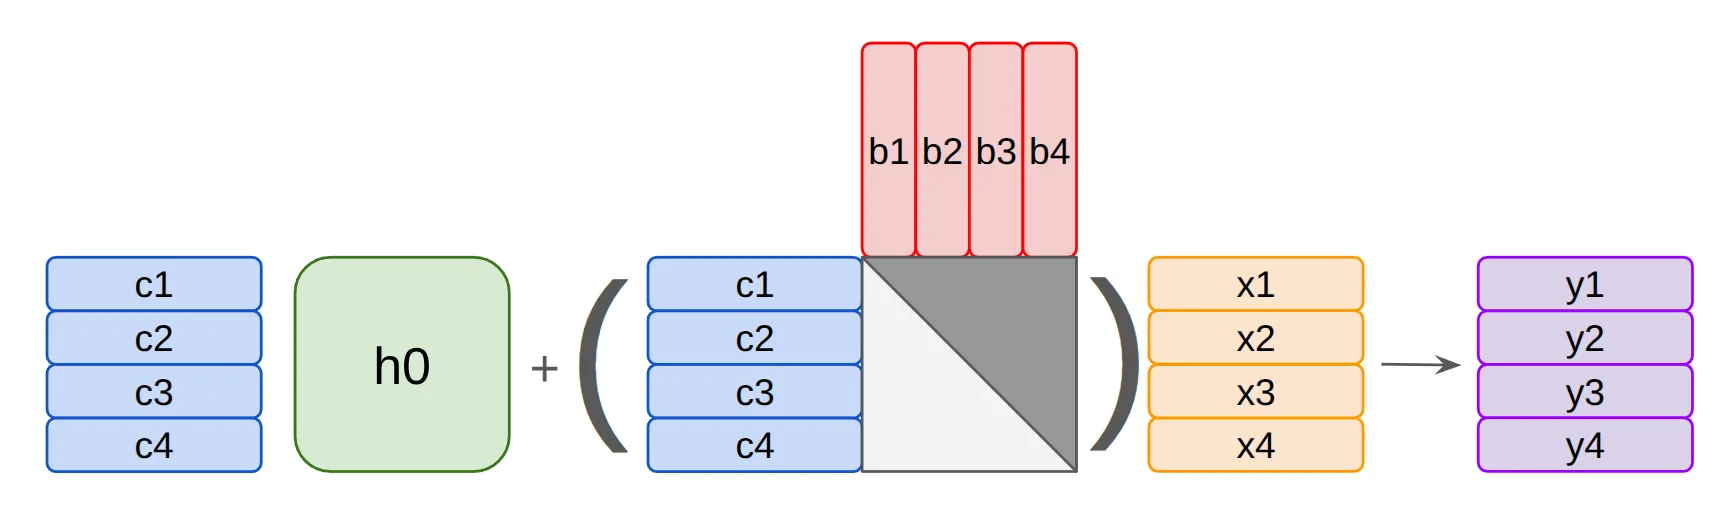
请注意,这看起来与注意力非常相似(没有 softmax),因为当移除衰减项时,Mamba-2 只是线性注意力(进行了一些重命名)。加回衰减会使事情稍微复杂一些。循环的展开将如下所示:
在对数空间中重新表述允许用累积和替换顺序乘法。如果 (或 )的行预先乘以指数,这仍然是矩阵乘法。在张量 中跟踪 的累积和,得到以下新方程:
将新的隐藏状态跳跃代入输出计算,得到以下结果:
其中矩阵 在 处包含项 。请注意,所有 的项都会被因果掩码遮蔽,因此只保留 为比 更多 之和的项。根据构造,所有 值均为负数,这使得 为负数。正数的任何指数都不会被保留,从而保证数值稳定性。
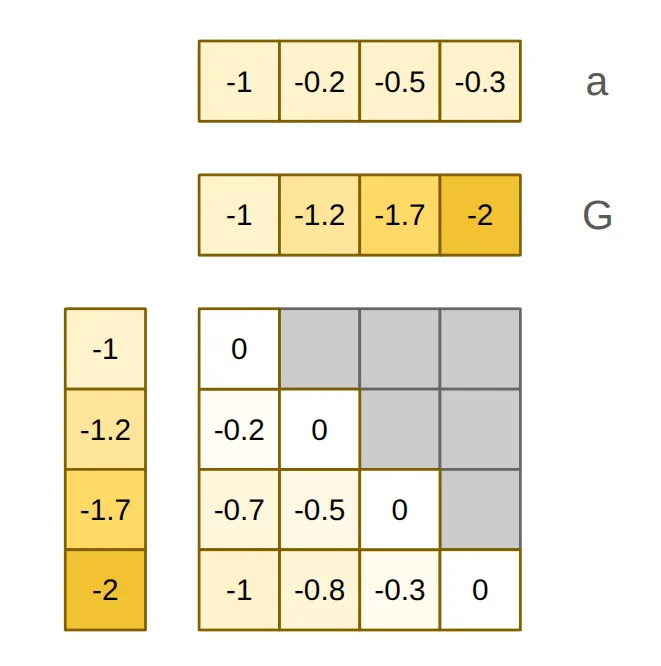
这将转化为三个内核:
chunk_cumsum:计算每个块内 的累积和。fwd_pass_state:使用上述跳跃公式计算每个块起始处的隐藏状态。compute_out:使用上一步中计算的该块初始隐藏状态,计算每个块的输出。
内核 1:计算累积和
的累积和(前面数学中的 )在步骤 2 和步骤 3 中都需要。为避免多次重新计算,第一个内核将计算一次 并将其存储。请注意,这不是全局累积和,而只是每个块内的累积和。
该内核的输入是每头标量衰减 a 和每 token 时间步 dt。头 h 在 token t 处的有效衰减为 a[h] * dt[t, h],内核沿块维度累加该乘积。这些累积和都在对数空间中,并且总是对它们取指数(或它们的某种线性组合)。由于计算 exp2 比计算 exp 便宜得多,结果会按 log2(e) 缩放。
该内核引入了所有三个内核都会使用的 cuTile 原语:ct.bid``,``ct.load / ct.store 和 ct.cumsum。
完整内核很短:
@ct.kernel
def chunk_cumsum_kernel(
    a: torch.Tensor,        # [num_heads]
    dt: torch.Tensor,       # [batch_size, num_tokens, num_heads]
    output: torch.Tensor,   # [batch_size, num_tokens, num_heads]
    chunk_size: ct.Constant[int],
    BLOCK_H: ct.Constant[int],
) -> None:
    chunk_idx, head_tile_idx, batch = ct.bid(0), ct.bid(1), ct.bid(2)
    dt_tile = ct.load(dt, index=(batch, chunk_idx, head_tile_idx),
                          shape=(1, chunk_size, BLOCK_H),
                          padding_mode=ct.PaddingMode.ZERO).astype(ct.float32)
    a_tile = ct.load(a, index=(head_tile_idx,),
                        shape=(BLOCK_H,),
                        padding_mode=ct.PaddingMode.ZERO).astype(ct.float32)

    d_tile = ct.cumsum(a_tile * dt_tile, axis=1) * LOG2E
    ct.store(output, index=(batch, chunk_idx, head_tile_idx), tile=d_tile.astype(output.dtype))
该内核以 (num_chunks, num_head_tiles, batch_size) 的网格启动,第一行使用 ct.bid 确定你在网格中的位置。a_tile(形状 [BLOCK_H])和 dt_tile(形状 [1, chunk_size, BLOCK_H])的广播乘积给出该 tile 上每 token、每头的有效衰减。ct.cumsum(..., axis=1) 然后沿块内 token 维度进行扫描,结果以 fwd_pass_state 和 compute_out 所期望的布局存储。
内核 2:fwd_pass_state
fwd_pass_state 计算每个块的初始隐藏状态以及最后一个块之后的最终隐藏状态。它不直接计算输出。相反,它准备携带状态,之后 compute_out 会将其投影为输出。其核心是如前所述对块进行顺序循环。每次内核启动加载隐藏状态的一个 (batch, head, head_tile, state_tile) 切片,如下所示。在该切片内,hid_tile 的形状为 [BLOCK_HEAD, BLOCK_STATE],并将包含每个块初始隐藏状态的一个 tile。
head_tile_idx, state_tile_idx, batch_head = ct.bid(0), ct.bid(1), ct.bid(2)
batch = batch_head // x.shape[2]
head = batch_head % x.shape[2]
group = head // num_heads_per_group

hid_tile = ct.load(
    init_state,
    index=(batch, head, head_tile_idx, state_tile_idx),
    shape=(1, 1, BLOCK_HEAD, BLOCK_STATE),
).reshape((BLOCK_HEAD, BLOCK_STATE))
在循环的每次迭代中,首先存储隐藏状态:
num_chunks = ct.cdiv(b.shape[1], chunk_size)
for chunk_idx in range(num_chunks):
    ct.store(
        hiddens,
        index=(batch, head, chunk_idx, head_tile_idx, state_tile_idx),
        tile=hid_tile.reshape((1, 1, 1, BLOCK_HEAD, BLOCK_STATE)).astype(hiddens.dtype),
    )
循环的其余部分加载一个块的 x、b、dt 和 decay_cumsum,以计算下一个块的初始隐藏状态。如前所示,数学为:
ct.extract 支持从加载的衰减 tile 中取最后一个 token(以计算 )。出于性能原因,使用 exp2 而不是 exp,如前所示。ct.mma 是将在利用 Tensor Core 的同时执行矩阵乘法加法的 API。
 x_tile = ct.load(
        x, index=(batch, chunk_idx, head, head_tile_idx),
        shape=(1, chunk_size, 1, BLOCK_HEAD),
        padding_mode=ct.PaddingMode.ZERO,
    ).reshape((chunk_size, BLOCK_HEAD))
    b_tile = ct.load(
        b, index=(batch, chunk_idx, group, state_tile_idx),
        shape=(1, chunk_size, 1, BLOCK_STATE),
        padding_mode=ct.PaddingMode.ZERO,
    ).reshape((chunk_size, BLOCK_STATE))
    dt_tile = ct.load(
        dt, index=(batch, chunk_idx, head),
        shape=(1, chunk_size, 1),
        padding_mode=ct.PaddingMode.ZERO,
    ).reshape((chunk_size,))
    d_tile = ct.load(
        decay_cumsum, index=(batch, chunk_idx, head),
        shape=(1, chunk_size, 1),
        padding_mode=ct.PaddingMode.ZERO,
    ).reshape((chunk_size,))
    d_last = ct.extract(d_tile, index=(chunk_size - 1,), shape=(1,))

    b_dt_d = b_tile * (dt_tile * ct.exp2(d_last - d_tile))[:, None]
    hid_tile = ct.exp2(d_last) * hid_tile
    hid_tile = ct.mma(x_tile.transpose(), b_dt_d.astype(b.dtype), hid_tile)
在最后一个块之后,hid_tile 包含最终隐藏状态,并将其存储。在推理期间,该值可以作为下一次调用的 init_state 反馈;在训练期间,它通常被丢弃。
ct.store(
    final_state,
    index=(batch, head, head_tile_idx, state_tile_idx),
    tile=hid_tile.reshape((1, 1, BLOCK_HEAD, BLOCK_STATE)),
)
顺序依赖保持在单个网格点(程序实例)内,而独立的 (batch, head, head_tile, state_tile) 切片在网格中并行运行。
内核 3:compute_out
compute_out 是前向传递中的最后一个内核。它接收由 fwd_pass_state 生成的每块初始隐藏状态,并计算 token 输出,实现前面推导出的输出方程:
直接的 PyTorch 实现会分别计算这三项,在全局内存中物化完整的 [B, n_chunks, chunk_size, chunk_size] 交互矩阵 C @ B.T。compute_out 将它们融合到一个分块内核中,并将该矩阵保留在寄存器中。
每次内核启动拥有一个 (batch, chunk, head, head_tile) 输出 tile,并分两个阶段工作。阶段 1 循环遍历状态 tile,使用 ct.mma 构建交互矩阵 cb_tile = C @ B.T,同时累加携带状态项 C @ H.T。
chunk_idx, head_tile_idx, batch_head = ct.bid(0), ct.bid(1), ct.bid(2)
batch = batch_head // x.shape[2]
head  = batch_head %  x.shape[2]
group = head // num_heads_per_group

cb_tile  = ct.full((chunk_size, chunk_size), 0.0, dtype=ct.float32)
out_tile = ct.full((chunk_size, BLOCK_HEAD),  0.0, dtype=ct.float32)

# Phase 1: build CB = C @ B.T and accumulate the carried-state output
for state_tile_idx in range(state_size // BLOCK_STATE):
    b_tile = ct.load(
        b, index=(batch, chunk_idx, group, state_tile_idx),
        shape=(1, chunk_size, 1, BLOCK_STATE), padding_mode=ct.PaddingMode.ZERO,
    ).reshape((chunk_size, BLOCK_STATE))
    c_tile = ct.load(
        c, index=(batch, chunk_idx, group, state_tile_idx),
        shape=(1, chunk_size, 1, BLOCK_STATE), padding_mode=ct.PaddingMode.ZERO,
    ).reshape((chunk_size, BLOCK_STATE))
    h_tile = ct.load(
        hiddens, index=(batch, head, chunk_idx, head_tile_idx, state_tile_idx),
        shape=(1, 1, 1, BLOCK_HEAD, BLOCK_STATE),
    ).reshape((BLOCK_HEAD, BLOCK_STATE))

    cb_tile  = ct.mma(c_tile, b_tile.transpose(), cb_tile)
    out_tile = ct.mma(c_tile, h_tile.transpose().astype(c_tile.dtype), out_tile)
阶段 2 对 cb_tile 应用衰减和因果掩码(ct.arange 和 ct.where 构建下三角掩码 M,因此从不物化掩码张量),然后加上所有项以得到最终输出 tile。两个累加器都从 ct.full 寄存器 tile 开始,最终的 ct.mma 转换为 ct.tfloat32,以接近 FP32 的精度通过 Tensor Core 运行。
# Phase 2: decay + causal mask then final computation
d_tile  = ct.load(decay_cumsum, index=(batch, chunk_idx, head),
                  shape=(1, chunk_size, 1), padding_mode=ct.PaddingMode.ZERO).reshape((chunk_size,))
dt_tile = ct.load(dt, index=(batch, chunk_idx, head),
                  shape=(1, chunk_size, 1), padding_mode=ct.PaddingMode.ZERO).reshape((chunk_size,))
x_tile  = ct.load(x, index=(batch, chunk_idx, head, head_tile_idx),
                  shape=(1, chunk_size, 1, BLOCK_HEAD), padding_mode=ct.PaddingMode.ZERO).reshape((chunk_size, BLOCK_HEAD))
d_val   = ct.load(d, index=(head,), shape=(1,))

cb_tile  = cb_tile * ct.exp2(d_tile[:, None] - d_tile[None, :])  # pairwise decay
idx      = ct.arange(chunk_size, dtype=ct.int32)
cb_tile  = ct.where(idx[:, None] >= idx[None, :], cb_tile, 0.0)  # causal mask
out_tile = out_tile * ct.exp2(d_tile[:, None])                   # decay carried state

dt_x     = dt_tile[:, None] * x_tile
out_tile = ct.mma(cb_tile.astype(ct.tfloat32), dt_x.astype(ct.tfloat32), out_tile)
out_tile = out_tile + d_val * x_tile                            # D * x skip
ct.store(out, index=(batch, chunk_idx, head, head_tile_idx),
         tile=out_tile.reshape((1, chunk_size, 1, BLOCK_HEAD)).astype(out.dtype))
如前所述,虽然在 ct.exp2(d_tile[:, None] - d_tile[None, :]) 行中计算了一些数值不稳定的指数(其中一些是正数),但会立即将它们掩码掉,因此潜在的溢出不会污染计算。
Mamba-2 性能优化
在 cuTile-Python DSL 中定义 Mamba-2 工作负载后,引入了若干关键性能优化:
- 延迟提示: cuTile 允许你为
ct.load和ct.store操作标注延迟提示,以对 DRAM 流量建模。编译器利用这些提示来优化指令调度和流水线缓冲区深度。 - 交换 A/B: 在 NVIDIA Blackwell 第五代 Tensor Core 上,MMA 操作数是不对称的:操作数 A 可以位于 Tensor Memory 中,但操作数 B 必须位于 Shared Memory 中。对于
fwd_pass_state中的 SIMT 操作 + Dot 操作这类输入融合模式,使用恒等式 将融合操作数(b_dt_d)路由到操作数 A,从而缓解共享内存争用。 - GMEM 布局:
decay_cumsum和dt的默认跨步内存访问会降低为对缓存不友好的 LDG 指令。转置为[batch, head, token]布局可确保连续访问,从而能够使用 TMA。 - cuTile-Python 自动调优器: 由于性能瓶颈会随输入形状而变化,没有单一优化策略适合所有模型配置。这些优化与 cuTile 参数(
block_size、占用率)一起集成到统一搜索空间中,利用 cuTileexhaustive_search自动为每种输入形状找到最佳设置。
Mamba-2 前向传递性能基准测试
此 Mamba-2 前向传递内核的实现可通过 TileGym 获取。完整示例如下所示。
import torch
import tilegym
from tests import common
from tests.ops.test_mamba2 import Mamba2ProblemSpec

tilegym.set_backend("cutile")
num_tokens, state_size = 16384, 128

torch.manual_seed(0)
spec = Mamba2ProblemSpec(batch_size=4, num_tokens=num_tokens, num_groups=1,
num_heads=8, state_size=state_size, head_size=64,
chunk_size=128, dtype=torch.bfloat16, state_dtype=torch.float32)
fwd_inputs = spec.get_sample_inputs(with_reference=False, with_backward=False)
fwd = common.benchmark(
    lambda: tilegym.ops.mamba2_chunk_forward(**fwd_inputs),
    use_cupti=True,
)
print(f"Forward: {fwd['forward']['median'] * 1000:.2f} us")
在以下软件和硬件配置下,将所实现的 Mamba-2 前向传递的性能与用 Triton 编写的 Mamba-2 内核开源实现进行了评估:
软件
- mamba_ssm 2.3.2.post1(NVIDIA Dynamo-Triton 参考实现),Triton 3.7.1
- cuTile:
cuda-tile1.5.0 - TileIR 汇编器(
tileiras)13.4 - PyTorch 2.13.0,CUDA 13.3(驱动程序和运行时 API,NVCC V13.3.33),驱动程序 595.58.03
- cuda-python / cuda-bindings 13.3.1
- Python 3.12.3,Ubuntu 24.04.4 LTS,内核 6.8.0-107
硬件
- 单块 NVIDIA B300 SXM6,计算能力 10.3(NVIDIA Blackwell Ultra)
- 1920 MHz 最大 SM 时钟,1100 W 功率限制,268 GiB HBM
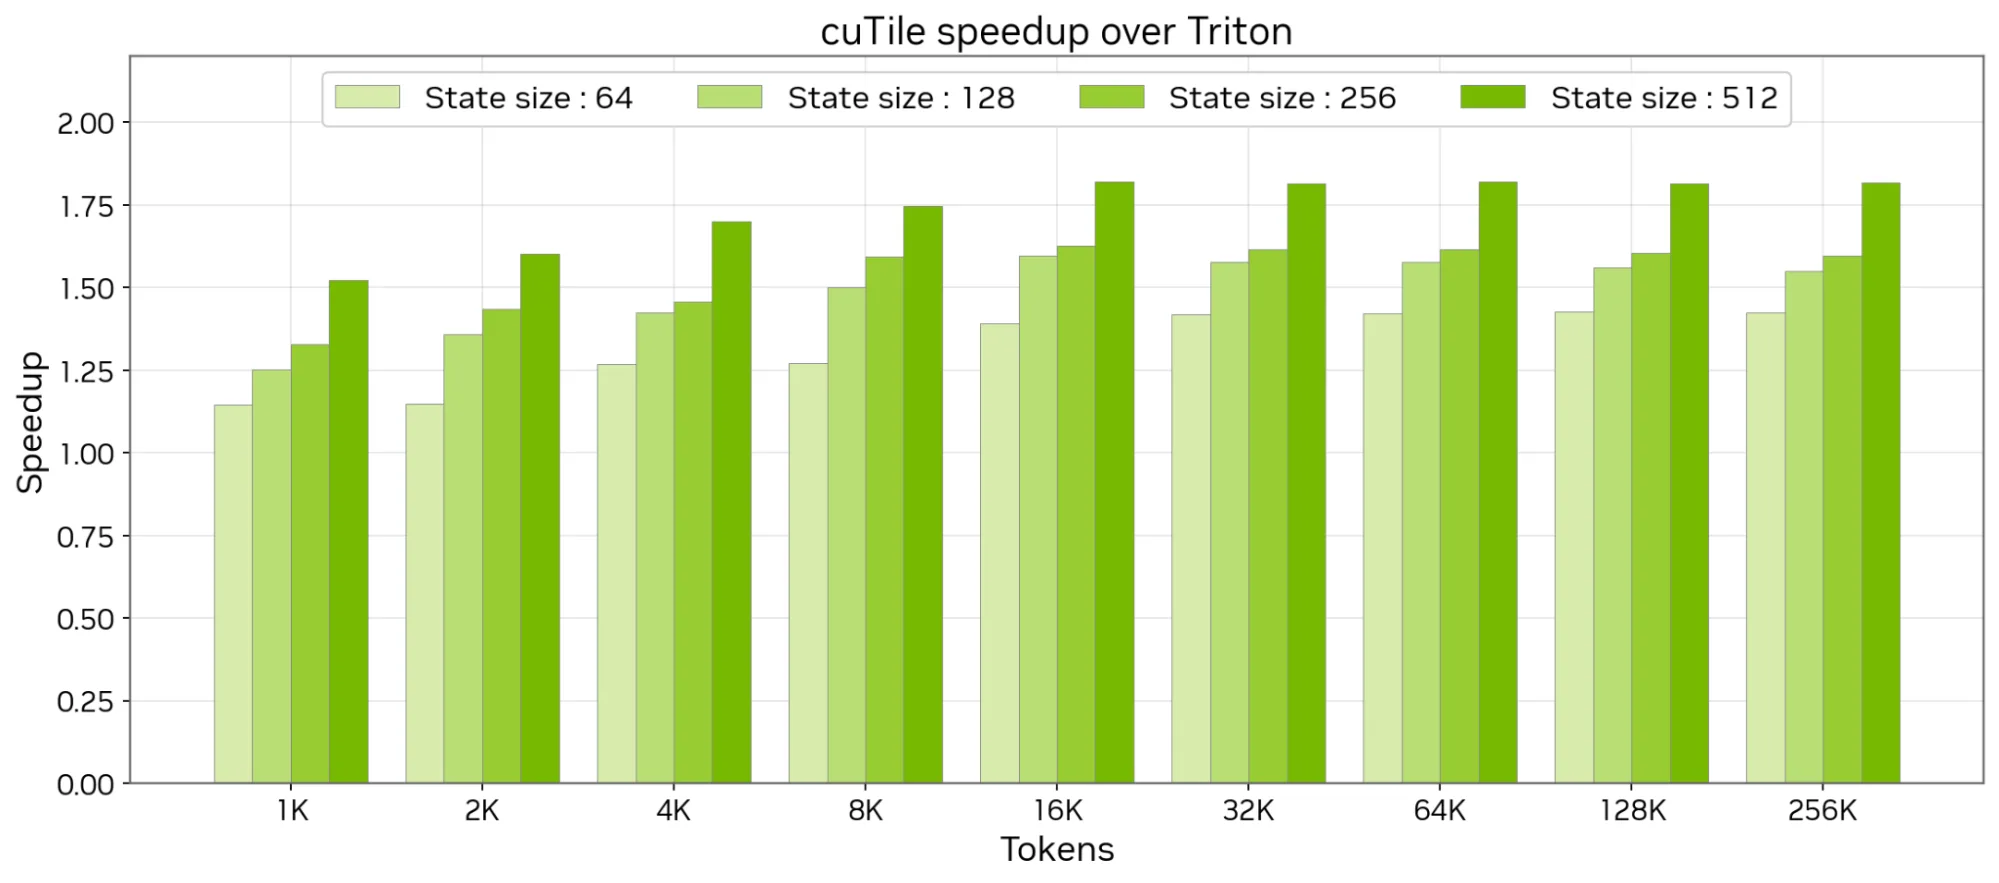
结果表明,优化后的 cuTile 前向传递内核快 1.14 倍至 1.82 倍,且加速比随序列长度和状态大小的增加而增大。请注意,这些仅是内核级加速,端到端训练结果还将取决于反向传递的实现。
开始使用 cuTile
cuTile 使您能够用 Python 编写清晰、易读且高性能的内核。开始使用 cuTile 并浏览文档、GitHub 仓库和示例代码。