
•
•
专有模型
•
2026 年 9 月发布
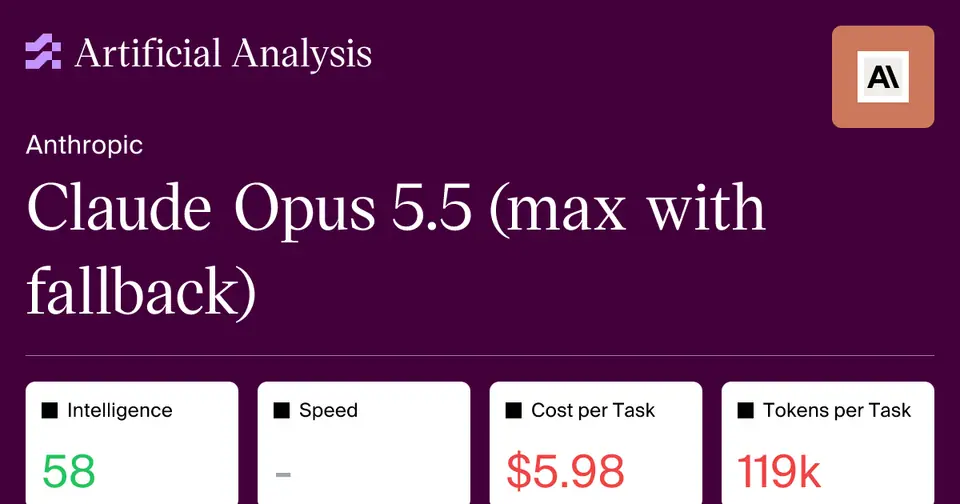
Claude Opus 5.5(Max,默认回退)智能、性能 & 价格分析
模型概要
智能
58
Artificial Analysis 智能指数
速度
97.5
每秒输出词元数
成本
输入 $4.00 输出 $20.00 缓存折扣 95%
$5.98
每个智能指数任务的成本
冗长度
260M
智能指数测试中的输出词元数
Claude Opus 5.5(Max,默认回退)在智能方面处于领先模型之列,但与价格相近的其他模型相比略显昂贵。它的速度也高于平均水平,但输出非常冗长。该模型支持文本和图像输入,输出文本,上下文窗口为 1M 词元。
Claude Opus 5.5(Max,默认回退)在 Artificial Analysis 智能指数上得分 58,远高于同类可比模型的平均水平(中位数:27)。在评测智能指数时,它生成了 260M 词元,与中位数 85M 相比非常冗长。
Claude Opus 5.5(Max,默认回退)的定价为每 1M 输入词元 $4.00(略贵,中位数:$2.00),每 1M 输出词元 $20.00(昂贵,中位数:$10.00)。平均而言,在智能指数上评测 Claude Opus 5.5(Max,默认回退)每个任务的成本为 $5.98。
Claude Opus 5.5(Max,默认回退)的速度为每秒 97 个词元,高于平均水平(83)。
| 推理 | 是 |
|---|---|
| 输入模态 | |
| 输出模态 | |
| 上下文窗口 | 1M |
各项指标与同一类别的模型进行比较:
- 非推理模型 → 仅与其他非推理模型比较
- 推理模型 → 与推理和非推理模型一并比较
- 开放权重模型 → 仅与同一规模类别的其他开放权重模型比较:
- 微型:≤4B 参数
- 小型:4B–40B 参数
- 中型:40B–150B 参数
- 大型:>150B 参数
- 专有模型 → 与同一价格区间内的专有和开放权重模型比较,采用 3:1 的输入/输出混合价格比:
- <每 1M 词元 $0.15
- 每 1M 词元 $0.15–$1
- >每 1M 词元 $1
智能
Artificial Analysis 智能指数 · 越高越好
速度
每秒输出词元数 · 越高越好
每任务成本
每个智能指数任务的加权平均成本(美元) · 越低越好
智能
Artificial Analysis 智能指数
Artificial Analysis 智能指数 v4.3.2 包含 10 项评测:AA-Briefcase v1.1、GDPval-AA v2.1、AutomationBench-AA、Terminal-Bench 4.0、SciCode、Humanity's Last Exam、GDP.pdf、CritPt、AA-Omniscience、AA-LCR v1.1
无公开可用的 API
Artificial Analysis 智能指数 v4.3.2 包含:AA-Briefcase v1.1、GDPval-AA v2.1、AutomationBench-AA、Terminal-Bench 4.0、SciCode、Humanity's Last Exam、GDP.pdf、CritPt、AA-Omniscience、AA-LCR v1.1。更多细节(包括各项评测的拆解及我们的运行方式)请参阅智能指数方法论。
按开放权重/专有划分的 Artificial Analysis 智能指数
Artificial Analysis 智能指数 v4.3.2 包含 10 项评测:AA-Briefcase v1.1、GDPval-AA v2.1、AutomationBench-AA、Terminal-Bench 4.0、SciCode、Humanity's Last Exam、GDP.pdf、CritPt、AA-Omniscience、AA-LCR v1.1
无公开可用的 API
Artificial Analysis 智能指数 v4.3.2 包含:AA-Briefcase v1.1、GDPval-AA v2.1、AutomationBench-AA、Terminal-Bench 4.0、SciCode、Humanity's Last Exam、GDP.pdf、CritPt、AA-Omniscience、AA-LCR v1.1。更多细节(包括各项评测的拆解及我们的运行方式)请参阅智能指数方法论。
表示模型权重是否可获取。若商业使用受到条件限制,模型标注为“商业使用受限”;若许可证禁止商业使用,则标注为“非商业”。
智能指数与每任务成本
Artificial Analysis 智能指数 · 每个 Artificial Analysis 智能指数任务的加权平均成本(美元)
最具吸引力的象限
帕累托线
每个智能指数任务的加权平均成本。每项评测的成本根据输入、缓存命中、缓存写入、推理和回答词元的价格计算,除以任务数,再按其在智能指数中的权重加权。
Artificial Analysis 智能指数 v4.3.2 包含:AA-Briefcase v1.1、GDPval-AA v2.1、AutomationBench-AA、Terminal-Bench 4.0、SciCode、Humanity's Last Exam、GDP.pdf、CritPt、AA-Omniscience、AA-LCR v1.1。更多细节(包括各项评测的拆解及我们的运行方式)请参阅智能指数方法论。
能力指数
衡量模型在特定能力和行业上的表现
Artificial Analysis 金融 & 会计指数
包含 7 项评测:AA-Omniscience、GDPval-AA v2.1、AA-Briefcase v1.1、Humanity's Last Exam、AutomationBench-AA、AA-LCR v1.1、GDP.pdf · 越高越好
无公开可用的 API
基准测试
评测
由 Artificial Analysis 独立测量的智能评测 · 越高越好
无公开可用的 API
智能体知识型工作,(Elo-500)/2000
知识
1 - 幻觉率
智能体 SaaS 工作流
智能体真实世界工作任务,(Elo-500)/2000
推理 & 知识
专业文档推理,全部通过
智能体编程 & 终端使用
长上下文推理
SciCode审核中
编程
CritPt审核中
物理推理
终端中的智能体科研工作流
开源仓库中的智能体软件工程
对电子表格 & 文档的定量分析
法律智能体工作,幻觉门控的全部通过率
智能体业务运营
Kubernetes 故障根因分析
医学长上下文推理
视觉推理
虽然模型的智能通常可以迁移到各类用例,但特定评测可能与某些用例更相关。
Artificial Analysis 智能指数 v4.3.2 包含:AA-Briefcase v1.1、GDPval-AA v2.1、AutomationBench-AA、Terminal-Bench 4.0、SciCode、Humanity's Last Exam、GDP.pdf、CritPt、AA-Omniscience、AA-LCR v1.1。更多细节(包括各项评测的拆解及我们的运行方式)请参阅智能指数方法论。
AA-Briefcase v1.1已更新
AA-Briefcase Elo
AA-Briefcase v1.1 是 Artificial Analysis 开发的智能体知识型工作基准测试。AA-Briefcase Elo 是一个综合指标,汇总了评分细则通过率、分析质量 Elo 和呈现效果 Elo · 越高越好
无公开可用的 API
AA-Briefcase Elo 是一个综合指标,汇总了分析质量 Elo、呈现效果 Elo 和评分细则通过率,其中评分细则表现通过合成的两两对战转换为 Elo。Elo 及 95% 置信区间边界的下限为 0。
AA-Omniscience
AA-Omniscience 指数
AA-Omniscience 指数(越高越好)衡量知识的可靠性和幻觉情况。它奖励正确回答,惩罚幻觉,对拒绝回答不扣分。得分范围为 -100 到 100,0 表示答对与答错数量相当,负分表示答错多于答对。
无公开可用的 API
AA-Omniscience 指数(越高越好)衡量知识的可靠性和幻觉情况。它奖励正确回答,惩罚幻觉,对拒绝回答不扣分。得分范围为 -100 到 100,0 表示答对与答错数量相当,负分表示答错多于答对。
智能指数对比
智能指数与每任务成本
Artificial Analysis 智能指数 · 每个 Artificial Analysis 智能指数任务的加权平均成本(美元)
最具吸引力的象限
帕累托线
每个智能指数任务的加权平均成本。每项评测的成本根据输入、缓存命中、缓存写入、推理和回答词元的价格计算,除以任务数,再按其在智能指数中的权重加权。
Artificial Analysis 智能指数 v4.3.2 包含:AA-Briefcase v1.1、GDPval-AA v2.1、AutomationBench-AA、Terminal-Bench 4.0、SciCode、Humanity's Last Exam、GDP.pdf、CritPt、AA-Omniscience、AA-LCR v1.1。更多细节(包括各项评测的拆解及我们的运行方式)请参阅智能指数方法论。
词元使用量
每个智能指数任务的输出词元数
运行 Artificial Analysis 智能指数中一个任务所用输出词元数的加权平均值
无公开可用的 API
每个智能指数任务所需的词元数。计算方式是将每项评测的输出词元数乘以各基准测试在智能指数中的相对权重,再除以任务数(不含重复运行)。
成本
每个智能指数任务的成本
每个智能指数任务的加权平均成本(美元) · 按词元类型分段 · 越低越好
每个智能指数任务的加权平均成本。每项评测的成本根据输入、缓存命中、缓存写入、推理和回答词元的价格计算,除以任务数,再按其在智能指数中的权重加权。
运行 Artificial Analysis 智能指数的成本
运行 Artificial Analysis 智能指数中全部评测的成本(美元)
运行 Artificial Analysis 智能指数中各项评测的成本,根据该模型的输入、缓存命中、缓存写入、推理和回答词元价格,以及各项评测所用的词元数(不含重复运行)计算得出。
定价:缓存命中、输入和输出
价格(美元/百万词元)
缓存提示词(此前已处理过)的每词元价格,通常相比常规输入价格有大幅折扣,以每百万词元的美元数表示。此处显示的是缓存命中价格;缓存写入和缓存存储单独计费,且因提供商而异,详见“各提供商缓存定价”。
上下文窗口
上下文窗口
上下文窗口:词元数上限 · 越高越好
无公开可用的 API
更大的上下文窗口与 RAG(检索增强生成)类 LLM 工作流相关,这类工作流通常需要对大量数据进行推理和信息检索。
输入 & 输出词元合计的最大数量。输出词元的上限通常要低得多(因模型而异)。
速度
以输出速度(每秒词元数)衡量
输出速度
每秒输出词元数 · 越高越好
模型生成词元期间每秒接收到的词元数(即对于支持流式输出的模型,从 API 收到第一个数据块之后)。
数据代表该模型第一方 API 的表现;若没有第一方 API,则为各提供商的中位数。
每个智能指数任务的耗时
每个智能指数任务的加权平均解码时间(分钟) · 不含首词元时间(TTFT)和开销时间 · 越低越好
每个 Artificial Analysis 智能指数任务的加权平均耗时(秒)。计算方式是将每个任务的输出词元数除以输出速度,并按各基准测试在智能指数中的相对权重加权。
延迟
以首词元时间(秒)衡量
延迟:首个回答词元的时间
收到首个回答词元所需的秒数 · 已计入推理模型的“思考”时间
API 请求发出后,收到首个回答词元所用的时间,单位为秒。对于推理模型,这包括模型给出回答前的“思考”时间。对于不支持流式输出的模型,则表示收到完整补全结果的时间。
端到端响应时间
输出 500 个词元所需的秒数,根据首词元时间、推理模型的“思考”时间和输出速度计算
端到端响应时间
输出 500 个词元所需的秒数,含推理模型的“思考”时间 · 越低越好
收到 500 词元响应所需的秒数。主要组成部分:
- 输入时间:收到首个响应词元的时间
- 思考时间(仅限推理模型):推理模型在给出回答前输出词元进行推理所花的时间。词元数量依据 60 个多样化提示词上的平均推理词元数(方法细节)。
- 回答时间:按输出速度生成 500 个输出词元所需的时间
数据代表该模型第一方 API 的表现;若没有第一方 API,则为各提供商的中位数。
常见问题
关于 Claude Opus 5.5(Max,默认回退)的常见问题
Claude Opus 5.5(Max,默认回退)于 2026 年 9 月 22 日发布。
Claude Opus 5.5(Max,默认回退)由 Anthropic 打造。
Claude Opus 5.5(Max,默认回退)在 Artificial Analysis 智能指数上得分 58,在相近价格档位的其他模型中远高于平均水平(中位数:27)。
Claude Opus 5.5(Max,默认回退)的输出速度为每秒 97.5 个词元(基于 Anthropic 的 API),与相近价格档位的其他模型相比高于平均水平(中位数:83.4 词元/秒)。
Claude Opus 5.5(Max,默认回退)的首词元时间(TTFT)为 728.27 秒(基于 Anthropic 的 API),与相近价格档位的其他模型相比处于较高水平(中位数:3.74 秒)。
基于 Anthropic 的 API,Claude Opus 5.5(Max,默认回退)每 1M 输入词元 $4.00(略高于平均水平,中位数:$2.00),每 1M 输出词元 $20.00(处于较高水平,中位数:$10.00)。
Claude Opus 5.5(Max,默认回退)每 1M 输入词元 $4.00,每 1M 输出词元 $20.00(基于 Anthropic 的 API)。按混合费率(缓存命中/输入/输出比例为 7:2:1)计算,为每 1M 词元 $2.94。不同提供商的定价可能不同。比较各提供商定价
在智能指数上评测时,Claude Opus 5.5(Max,默认回退)生成了 260M 输出词元,与相近价格档位的其他模型相比处于较高水平(中位数:85M)。
是,Claude Opus 5.5(Max,默认回退)是一个推理模型。它会使用扩展思考或思维链推理来处理复杂问题,然后再给出回答。
Claude Opus 5.5(Max,默认回退)支持文本和图像输入。
Claude Opus 5.5(Max,默认回退)支持文本输出。
是,Claude Opus 5.5(Max,默认回退)支持图像输入,可以分析、描述图像并回答与图像有关的问题。
是,Claude Opus 5.5(Max,默认回退)是多模态模型。它可以处理文本和图像输入,并生成文本输出。
Claude Opus 5.5(Max,默认回退)的上下文窗口为 1.0M 词元。它决定了模型在单次请求中能够处理多少文本和对话历史。
否,Claude Opus 5.5(Max,默认回退)是专有模型。模型权重未公开。
Claude Opus 5.5(Max,默认回退)是专有模型,Anthropic 尚未披露其模型规模或参数量。
Claude Opus 5.5(Max,默认回退)在 Artificial Analysis 智能指数上得分 58。这一综合基准测试从推理、知识、数学和编程等方面评估模型。
是,Claude Opus 5.5(Max,默认回退)可通过 9 家提供商的 API 使用。比较 API 提供商
Claude Opus 5.5(Max,默认回退)可通过 9 家 API 提供商使用。比较提供商