我今天早些时候获得了 Grok 3 的早期访问权限,这让我成为最早能快速体验它的人之一。
思考
✅ 首先,Grok 3 显然拥有接近最先进的思考模型(“思考”按钮),并且在我的《卡坦岛》问题上开箱即用地表现出色:
“创建一个棋盘游戏网页,显示六边形网格,就像《卡坦岛》游戏一样。每个六边形网格编号为 1..N,其中 N 是六边形瓷砖的总数。使其通用化,以便可以使用滑块更改“环”的数量。例如,在卡坦岛中,半径为 3 个六边形。请使用单个 HTML 页面。”
很少有模型能可靠地做到这一点。顶级的 OpenAI 思考模型(例如 o1-pro,每月 200 美元)也能做到,但 DeepSeek-R1、Gemini 2.0 Flash Thinking 和 Claude 都不能。
❌ 它没有解决我的“表情符号之谜”问题,我在其中给出了一个笑脸,并附带了隐藏在 Unicode 变体选择器中的消息,即使我以 Rust 代码的形式给出了如何解码的强烈提示。我见过的最大的进展来自 DeepSeek-R1,它曾经部分解码了该消息。
❓ 它解决了我给它的几个井字棋棋盘,并带有相当漂亮/清晰的思维链(许多最先进的模型经常在这些问题上失败!)。所以我提高了难度,要求它生成 3 个“棘手”的井字棋棋盘,但它失败了(生成了无意义的棋盘/文本),但 o1 pro 也失败了。
✅ 我上传了 GPT-2 论文。我问了一堆简单的查找问题,都很好。然后要求估计训练 GPT-2 所需的训练 FLOPs,而不进行搜索。这很棘手,因为 token 数量没有明确说明,所以必须部分估计和部分计算,这考验了查找、知识和数学能力。一个例子是 40GB 文本 ≈ 40B 字符 ≈ 40B 字节(假设 ASCII)≈ 10B tokens(假设约 4 字节/token),在约 10 个 epoch 下 ≈ 100B token 训练运行,在 1.5B 参数和 2+4=6 FLOPs/参数/token 的情况下,这是 100e9 X 1.5e9 X 6 ≈ 1e21 FLOPs。Grok 3 和 4o 都未能完成此任务,但 Grok 3 使用思考功能很好地解决了它,而 o1 pro(GPT 思考模型)则失败了。
我喜欢这个模型在要求时会尝试解决黎曼猜想,类似于 DeepSeek-R1,但不像许多其他模型那样立即放弃(o1-pro、Claude、Gemini 2.0 Flash Thinking)并简单地说这是一个伟大的未解决问题。我最终不得不阻止它,因为我有点为它感到难过,但它表现出了勇气,谁知道呢,也许有一天……
我在这里的整体印象是,这大约处于 o1-pro 的能力水平,并且领先于 DeepSeek-R1,尽管我们当然需要看实际的、真正的评估。
深度搜索
非常整洁的产品,似乎结合了 OpenAI / Perplexity 所称的“深度研究”以及思考。只不过不是“深度研究”而是“深度搜索”(叹气)。它可以对各种研究性/查找性问题产生高质量的回答,你可以想象这些问题在互联网上的文章中有答案,例如,我尝试的几个问题,这些是我从最近在 Perplexity 上的搜索历史中偷来的,以及结果如何:
- ✅ “即将到来的苹果发布会有什么消息?有什么传闻吗?”
- ✅ “为什么 Palantir 的股票最近飙升?”
- ✅ “《白莲花度假村》第三季在哪里拍摄?和第一、二季是同一个团队吗?”
- ✅ “Bryan Johnson 用什么牙膏?”
- ❌ “《单身即地狱》第四季的演员们现在在哪里?”
- ❌ “Simon Willison 提到他正在使用什么语音转文字程序?”
❌ 我确实在这里发现了一些尖锐的问题。例如,模型默认似乎不喜欢将 X 作为来源引用,尽管你可以明确要求它这样做。有几次我发现它幻觉出不存在的 URL。有几次它说了一些我认为不正确的事实性内容,并且没有提供引用(可能引用根本不存在)。例如,它告诉我《单身即地狱》第四季的“金正洙仍在和金敏雪约会”,这肯定完全不对,对吧?当我要求它生成一份关于主要 LLM 实验室及其总资金和员工数量估算的报告时,它列出了 12 个主要实验室,但没有包括它自己(xAI)。
我对 DeepSearch 的印象是,它大约相当于 Perplexity DeepResearch 的水平(这很棒!),但还没有达到 OpenAI 最近发布的“Deep Research”的水平,后者感觉更彻底、更可靠(尽管也远非完美,例如,当我尝试时,它也相当错误地将 xAI 排除在“主要 LLM 实验室”之外……)。
随机 LLM“陷阱”测试
我尝试了一些我喜欢时不时尝试的有趣/随机的 LLM 陷阱查询。陷阱是指对人类来说特别容易但对 LLM 来说特别难的查询,所以我很好奇 Grok 3 在哪些方面取得了进展。
✅ Grok 3 知道“strawberry”中有 3 个“r”,但随后它告诉我“LOLLAPALOOZA”中只有 3 个“L”。开启思考模式可以解决这个问题。
✅ Grok 3 告诉我 9.11 > 9.9。(其他 LLM 也常犯这个错误),但同样,开启思考模式可以解决。
✅ 一些简单的谜题即使不思考也能正确回答,例如“莎莉(一个女孩)有 3 个兄弟。每个兄弟有 2 个姐妹。莎莉有多少个姐妹?”例如,GPT4o 会说 2(错误)。
❌ 遗憾的是,模型的幽默感似乎没有明显改善。这是 LLM 在幽默能力和一般模式崩溃方面的常见问题,众所周知,例如,在 1008 个要求 ChatGPT 讲笑话的输出中,90% 是重复的相同 25 个笑话。即使更详细地提示,远离简单的双关语领域(例如,给我一段单口喜剧),我也不确定它的幽默是否是最先进的。生成的示例笑话:“为什么鸡要加入乐队?因为它有鼓槌,想成为摇滚明星!”在快速测试中,思考模式没有帮助,可能还让它变得更糟。
❌ 模型似乎对“复杂的伦理问题”仍然过于敏感,例如,生成了一页论文,基本上拒绝回答如果让 100 万人免于死亡,那么误称某人的性别在伦理上是否合理。
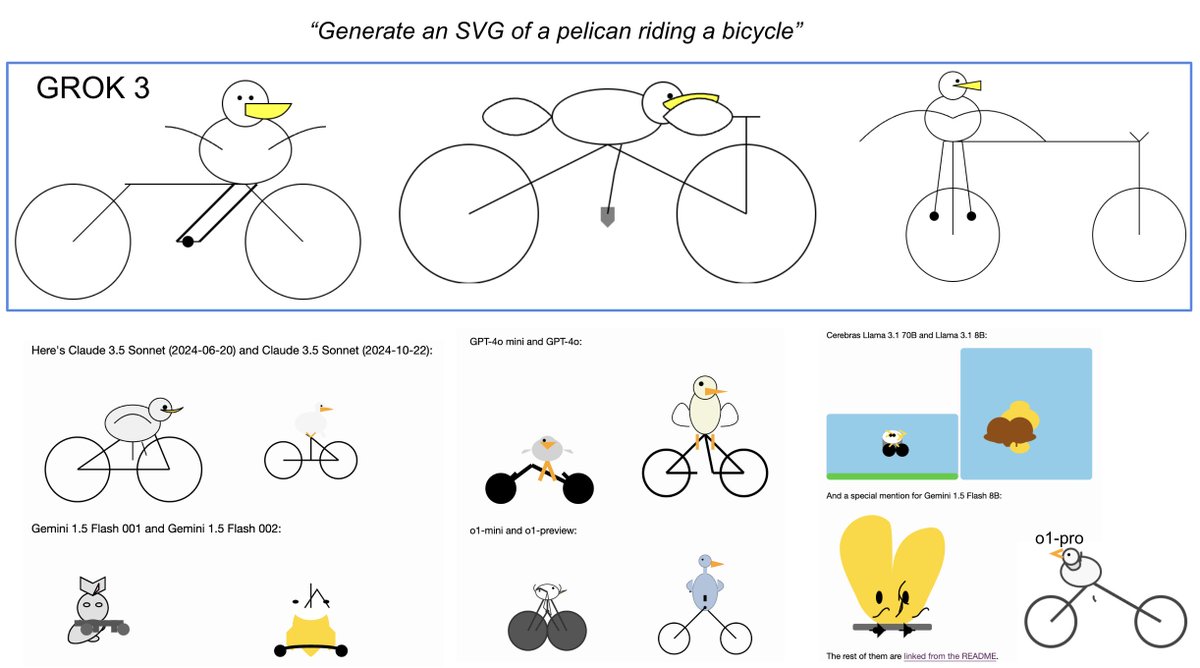
❌ Simon Willison 的“生成一只骑自行车的鹈鹕的 SVG”。这考验了 LLM 在二维网格上布局多个元素的能力,这非常困难,因为 LLM 不能像人类一样“看”,所以它们是在黑暗中用文本排列事物。标记为失败,因为这些鹈鹕相当不错,但仍然有点破损(见图和比较)。Claude 的最好,但我怀疑他们在训练中特别针对了 SVG 能力。
总结。就今天早上约2小时的快速体验而言,Grok 3 + Thinking 的感觉大致处于 OpenAI 最强模型(o1-pro,每月200美元)的最先进水平附近,并且略优于 DeepSeek-R1 和 Gemini 2.0 Flash Thinking。考虑到团队大约一年前从零开始,这相当令人难以置信,达到最先进水平的时间跨度是前所未有的。也请记住一些注意事项——模型是随机的,每次可能给出略有不同的答案,而且现在还为时过早,所以我们必须在接下来的几天/几周内等待更多的评估。早期的 LM arena 结果确实看起来相当令人鼓舞。目前,衷心祝贺 xAI 团队,他们显然拥有巨大的速度和动力,我很高兴将 Grok 3 加入我的“LLM 委员会”,并听取它未来的看法。