多基因风险评分(polygenic risk score,PRS)用于根据基因变异预测疾病风险,通常会纳入数百到数百万个基因变异的影响。然而,目前它在临床决策中的采用率仍然很低,部分原因在于以往的全基因组关联研究(GWAS)绝大多数评估的是欧洲队列,导致其应用于非欧洲人群时准确率大幅下降。这种准确率差异源于不同人群在遗传结构、群体结构和变异等位基因频率上的差异。
此外,对数十万人开展全新的(de novo)GWAS,对大多数医疗体系来说成本高得难以承受。一个可行的方案是迁移学习:以现有以欧洲人群为主的 GWAS 为基础,再用目标人群专属的 GWAS 对这些大规模结果加以补充。
为此,在这篇博客文章中,我们介绍一项研究:在八个临床性状上,评估 PRS 在非欧洲目标人群中的表现,同时改变目标人群以及用于构建预测模型的欧洲人群的样本规模。具体来说,我们评估了在 UK Biobank(UKB)中基于数十万欧洲个体得到的 PRS,向 Biobank Japan(BBJ)样本的可迁移性;BBJ 是一个表型信息非常详尽的队列,包含近 20 万名日本个体。我们的首要目标是提供系统的、基于实证的指导:跨人群 GWAS 和 PRS 模型训练应当如何进行,才能使目标人群中的预测表现达到最优。
GWAS 人群规模对目标祖先人群 PRS 表现的影响
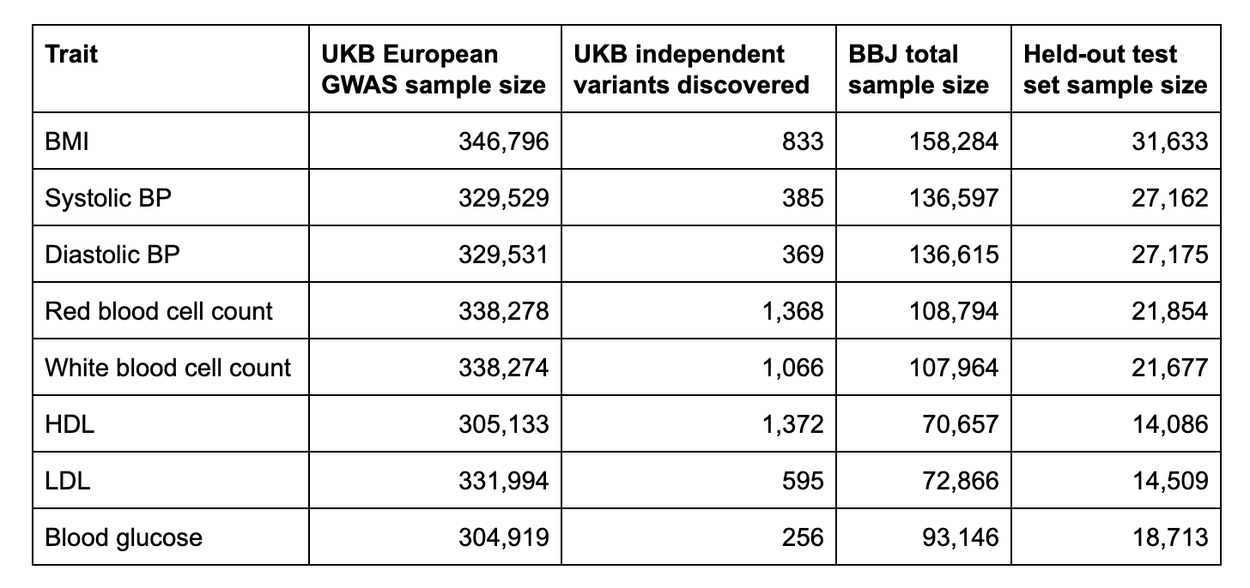
UKB 和 BBJ 这两个大规模、基因分型与表型信息都很深入的数据集,使我们能够开展数据集消融实验,系统评估 PRS 表现随样本量变化的情况。我们选择了两个人群中都有测量的八个临床相关性状进行评估:体重指数(BMI)、收缩压、舒张压、红细胞计数、白细胞计数、高密度脂蛋白胆固醇(HDL)、低密度脂蛋白胆固醇(LDL)和血糖。在 UKB 中,已测得的遗传变异所能解释的性状方差比例(单核苷酸多态性遗传力)估计在 0.07 至 0.28 之间。
我们使用三种方法来评估 PRS 表现的可迁移性:
- UKB 发现阶段 GWAS + 弹性网络(elastic net):探究变异在欧洲人群与日本人群之间的直接可迁移性。对每个性状,我们先在完整的 UKB 欧洲人群上运行 GWAS 以识别欧洲特有的遗传关联,并筛选出同样存在于 BBJ 日本数据集中的独立变异。以这些变异作为输入,我们在 BBJ 与 UKB 样本的各种组合上训练弹性网络模型,计算目标人群的 PRS。具体来说,我们将 12–13 种 BBJ 样本量与 7 种 UKB 样本量两两配对,每个性状由此得到 96–104 个 PRS 模型。
- 荟萃分析(meta-analysis) + 弹性网络:探究在变异发现阶段混入日本人群数据的影响。首先,我们在完整的 UKB 欧洲人群和抽样得到的 BBJ 日本数据集上分别运行 GWAS,然后通过荟萃分析合并这些遗传关联,生成最终的变异集合。基于这些变异,我们在 UKB / BBJ 混合数据集上训练弹性网络模型,得到目标人群的 PRS。
- PRS-CSx:探究专为处理不同人群间连锁不平衡差异而设计的 PRS-CSx 模型。对每个性状,我们将 PRS-CSx 应用于完整的 UKB 欧洲样本和抽样得到的 BBJ 日本样本。由于 PRS-CSx 模型会针对同一个样本为每个人群给出两个不同的评分,我们还拆分了验证集,以找出这两个评分的最优线性组合。
在所有实验中,PRS 模型都在同一个留出的 BBJ 样本集上进行评估。
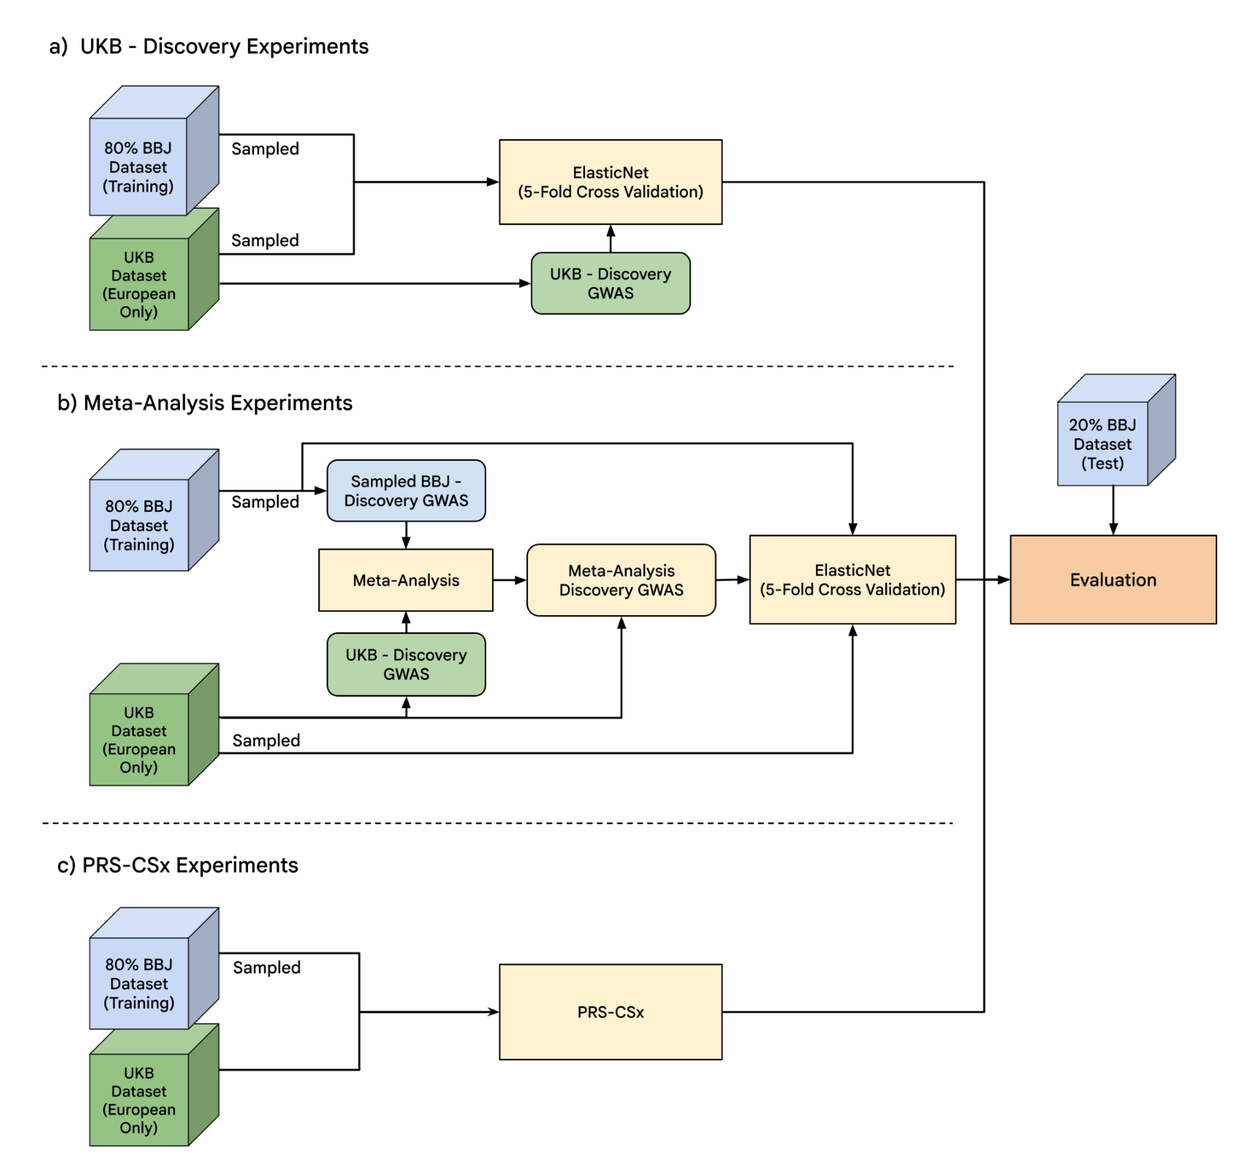 *跨祖先基因组预测的实验设计。a) 主实验探究的是:将弹性网络应用于通过大规模欧洲 GWAS 发现的变异时,不同数量的欧洲和日本样本对其表现的影响。 b) 荟萃分析实验将各人群专属的 GWAS 结果整合进用于构建弹性网络模型的变异生成过程。 c) PRS-CSx 实验在多种人群专属样本量下拟合 PRS-CSx 模型。*
对于跨人群 PRS 预测,数据多并不总是更好
在每个实验中,我们用皮尔逊相关系数来量化模型表现。正如预期,当目标人群数据有限或完全没有时,欧洲的发现阶段数据能提供有用的基线。然而,一旦样本量达到 1.5 万或更多,目标人群专属模型的表现就更胜一筹,因为与外部欧洲数据联合训练似乎限制了通过增加目标人群采样所能获得的准确率提升。
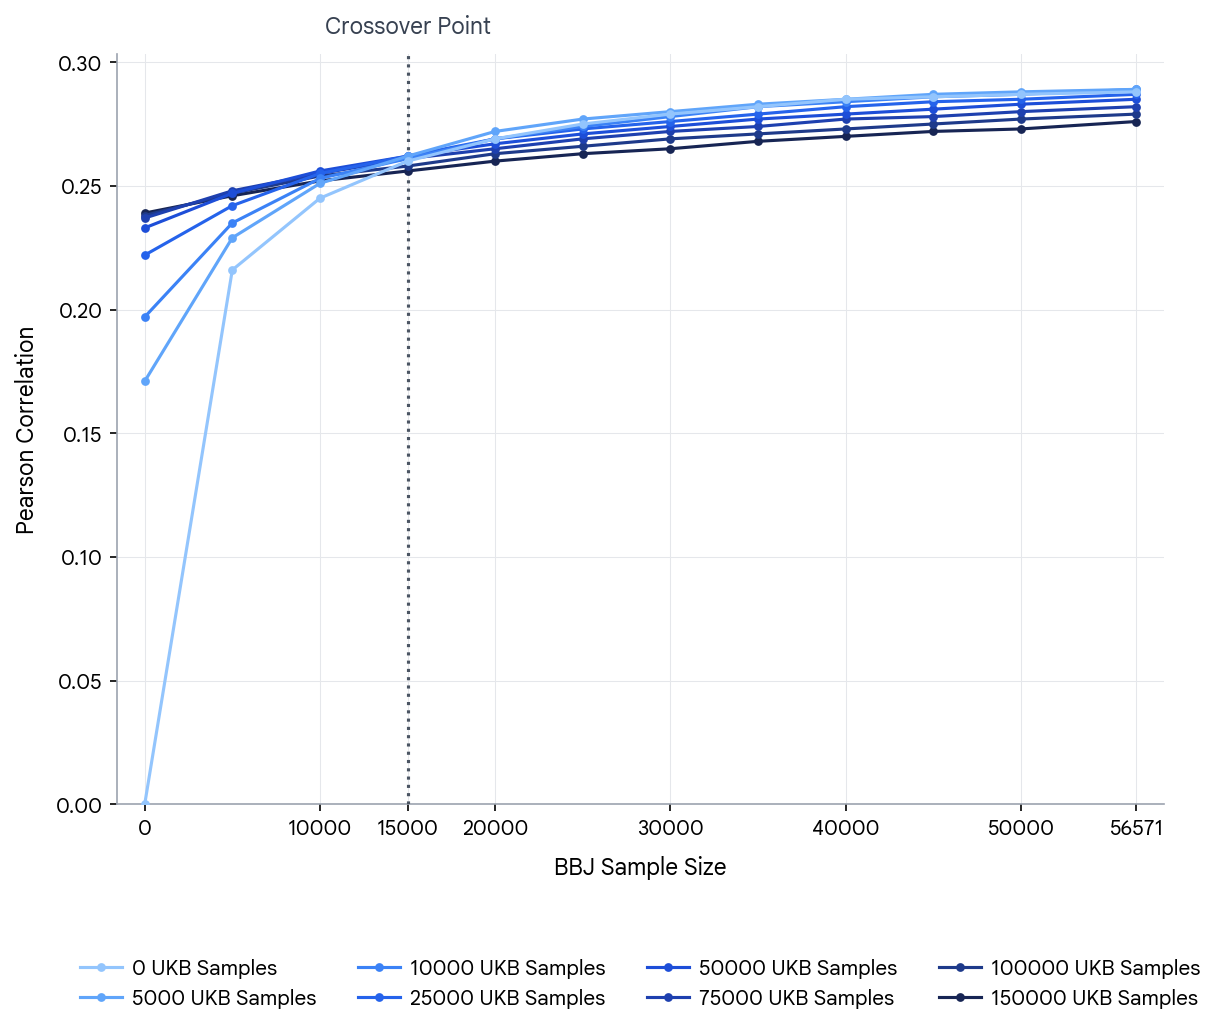
这一出人意料的现象在我们考察的所有表型中都成立。当目标样本量极小(例如 5,000 个样本)时,在训练中合并欧洲 UKB 数据能带来可观的统计增益。随着用于训练 PRS 模型的目标样本量增加,合并外部人群数据的收益逐渐减弱。
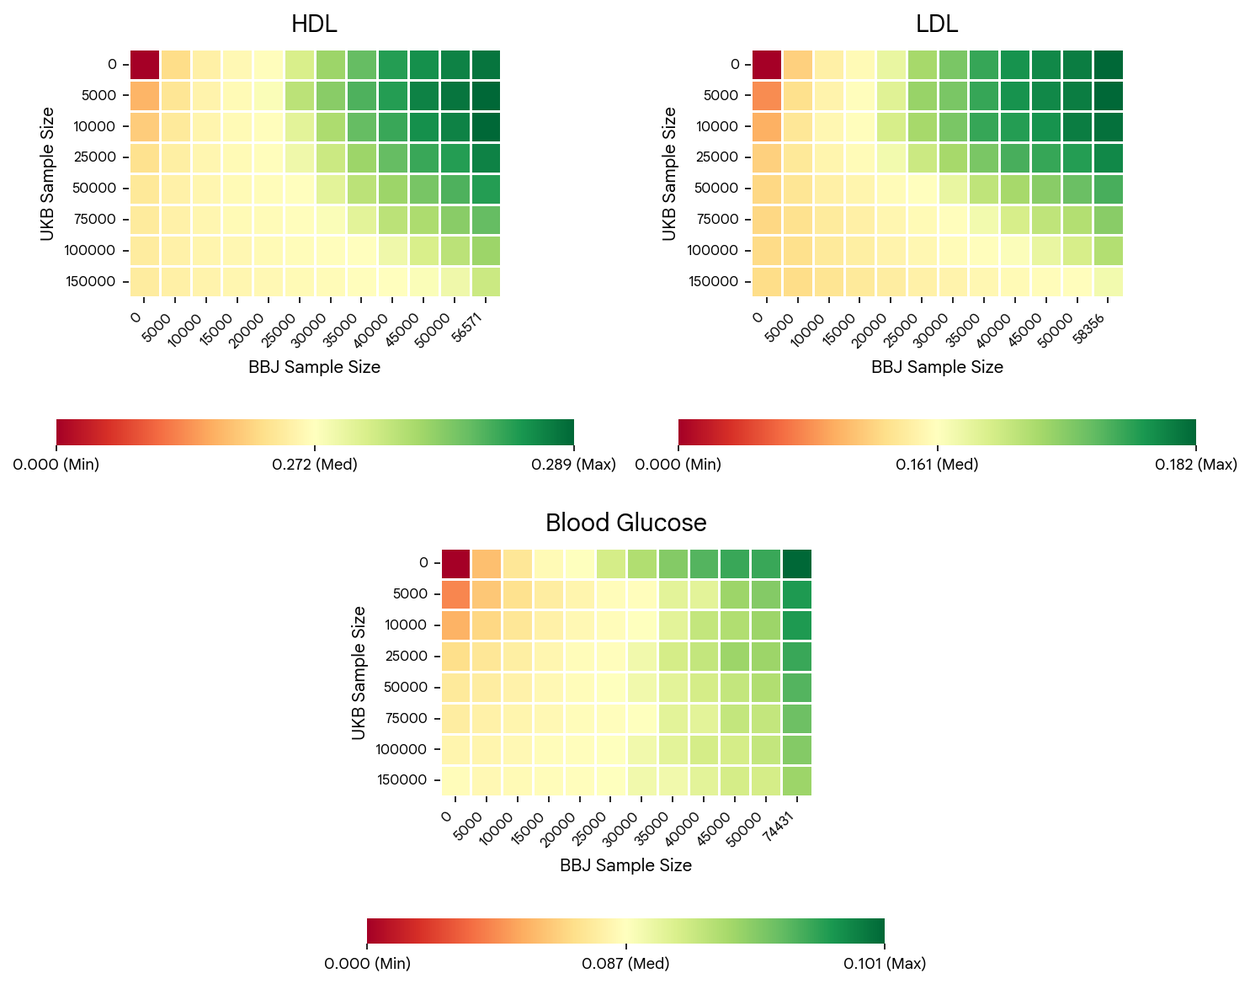
虽然这一趋势在各表型中都存在,但使用欧洲数据的优势消退的交叉点,在很大程度上取决于所研究的具体性状。我们可以用同一性状在不同人群间的遗传相关性来量化“共享遗传学”的程度。我们观察到,“保守”性状,即两个人群间遗传相关性较高的性状,在目标样本量大得多(2.5 万至 4 万以上)时才会被目标人群专属训练数据追平,在此之前仍能从合并 UKB 欧洲训练数据中获益。
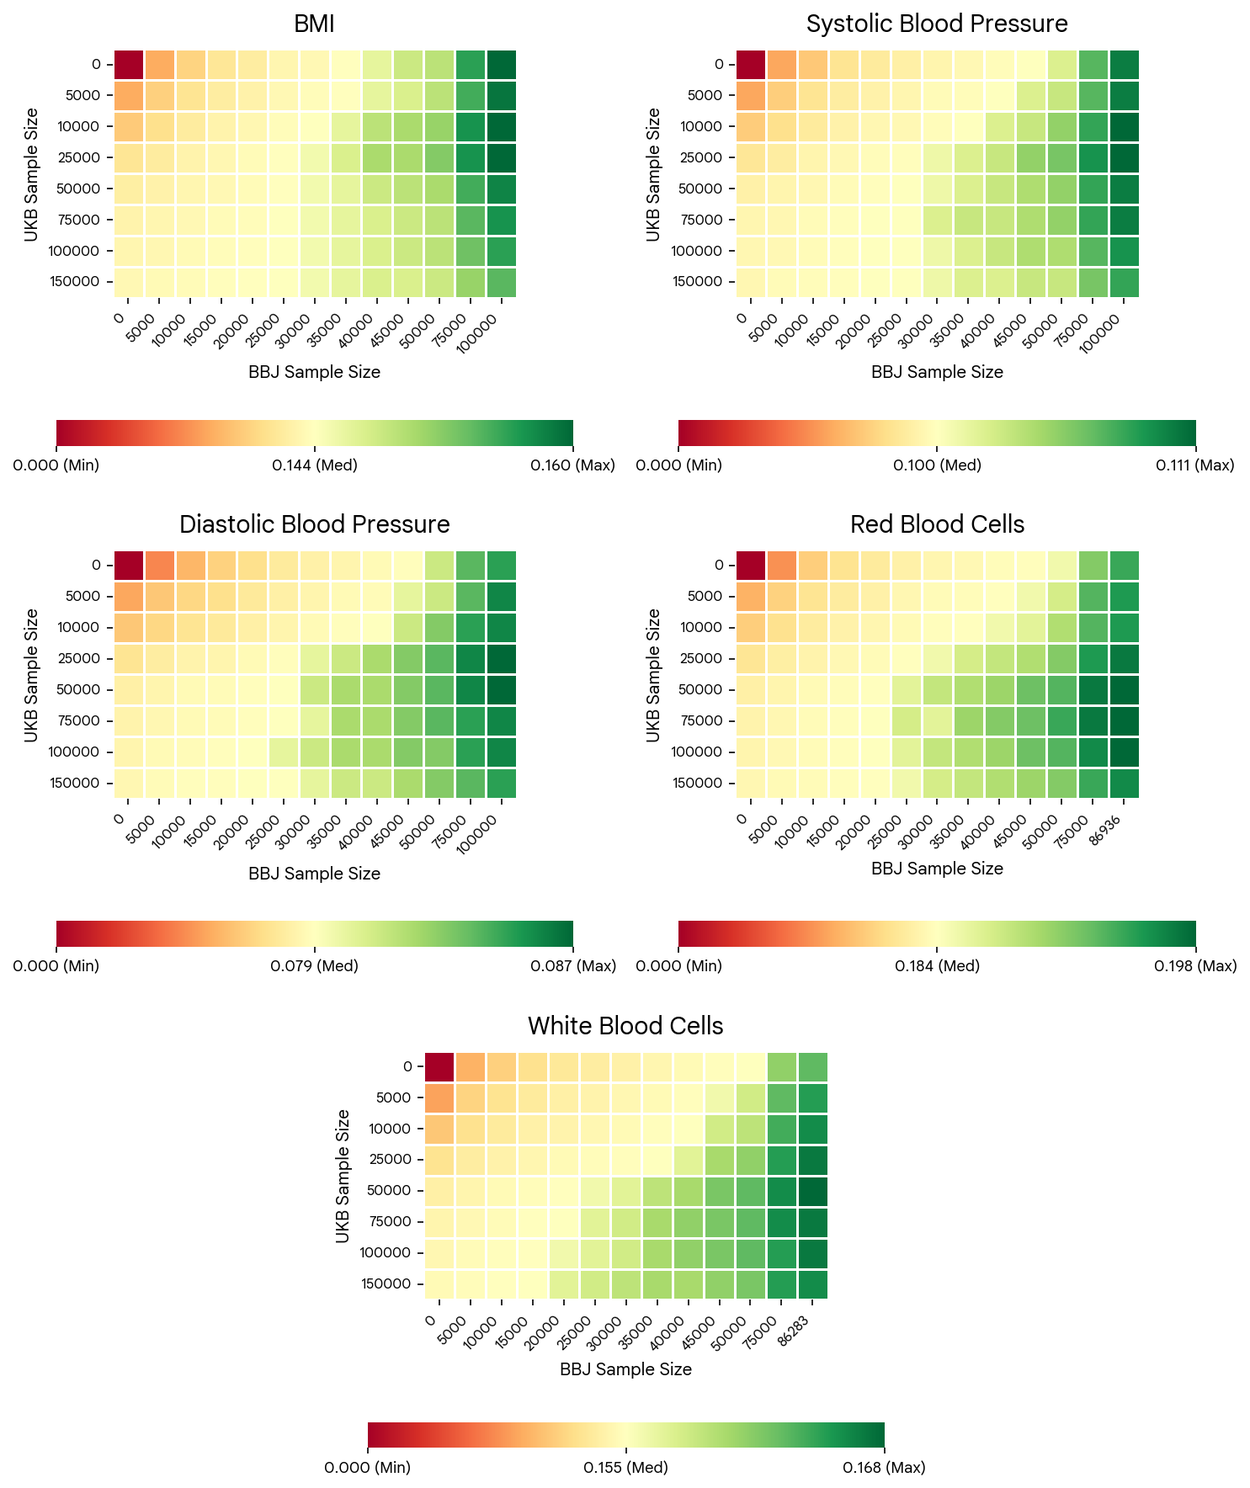
与此形成鲜明对比的是,血脂水平(HDL、LDL)和血糖所对应的 BBJ 样本量要小得多,超过这一样本量后,最优的 UKB 样本量就低于最大值,而且这个最优样本量本身也更小。这些高度人群特异的性状从 UKB 数据中获益较少,因为这些数据与目标分布相距更远。
荟萃分析和 PRS-CSx 的影响
上述实验把 PRS 模型的输入变异限定为在 UKB 欧洲人群中发现的变异,排除了 BBJ 样本独有的、与性状相关的变异。为了把分析扩展到这些变异,我们新增了两种预测方法。
首先,我们对每种 BBJ 样本量分别运行 GWAS。第一种新方法使用完整的 UKB GWAS 和对应样本量的 BBJ GWAS 进行跨人群荟萃分析,以识别候选变异,然后在这些变异上拟合弹性网络。第二种方法使用 PRS-CSx 来组合这两组 GWAS 汇总统计量。
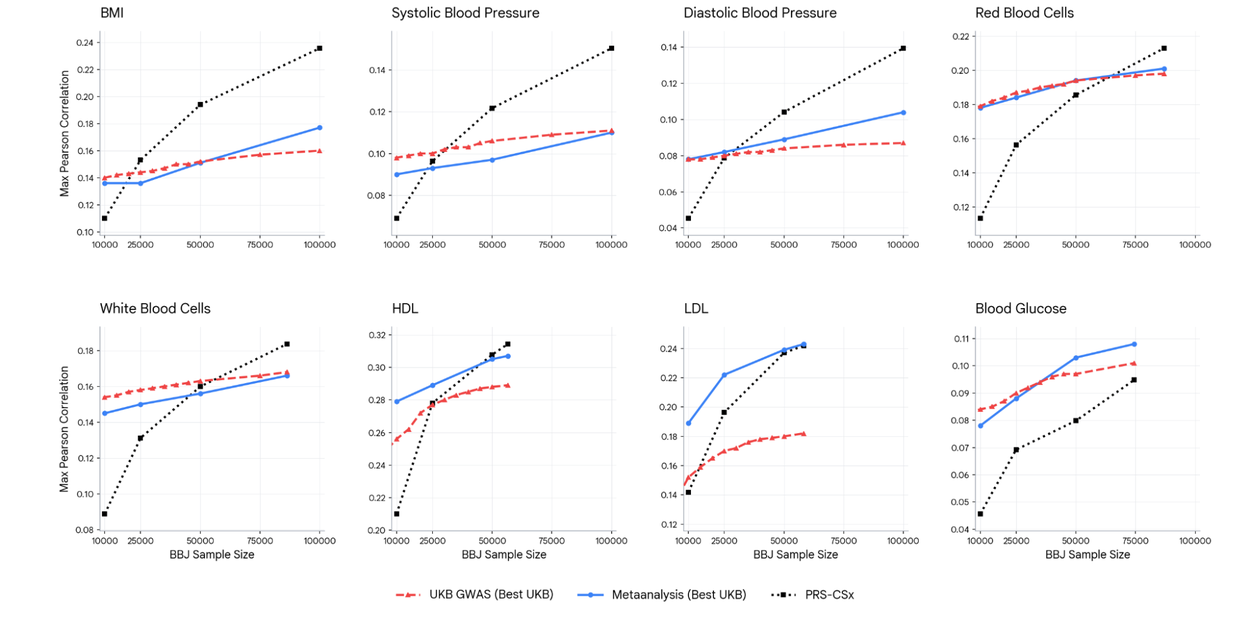
通过追踪荟萃分析和 PRS-CSx 在不同发现阶段样本量下的净表现增益,我们观察到它们的表现随 BBJ 样本量而不同。
对于保守性状,荟萃分析的影响较小,主要是因为 BBJ GWAS 的样本量小得多,统计功效不足。然而,对于 HDL 和 LDL 这类人群特异性性状,以及程度稍轻的血糖,荟萃分析的表现明显优于单一人群的发现方式。这种增益主要来自对弹性网络变异输入的调整:当 BBJ 样本为 10,000 个或更少时,在训练中纳入 UKB 欧洲样本会使预测略有改善;而在 BBJ 样本更多时,则看不到这种改善。
由于 PRS-CSx 会动态加权各人群专属的模型,理论上它的表现对保守性状与人群特异性状的敏感度较低。然而,我们观察到该模型需要比弹性网络模型更多的数据才能表现良好。当目标样本量低于 25k 时,除 BMI 外,PRS-CSx 在所有表型上都不及对应的最强弹性网络模型。当样本量接近 100k 时,除血糖外,PRS-CSx 在所有表型上都追平或超过了表现最好的模型。
结论
对跨人群基因组预测的系统评估表明,在将多基因风险评分(PRS)应用于代表性不足的祖先人群时,更大规模的外部人群数据集并不总是有益。具体来说,来自 UK Biobank 大型欧洲队列的迁移学习,在目标人群样本量较低时(Biobank Japan 样本少于 15,000 个)提供了统计上的增益,但随着 BBJ 样本量增长,它反而会降低预测准确率。这种表现上的交叉取决于性状:遗传上保守的性状(如 BMI)在更大的样本量下仍能从合并外部数据中获益,而人群特异性状(如血脂和血糖)则在样本更少时收益就已减弱。重要的是,PRS-CSx 这类先进的多祖先方法需要大量目标人群样本,才能胜过更简单的方法;而跨人群荟萃分析则能在较小规模下为人群特异性状带来稳健的收益。归根结底,这些发现强调,要在多样化人群中优化预测表现,既需要扩大本地的、多样化的生物样本库,也需要根据性状遗传力和样本量谨慎选择建模策略。
致谢
我们衷心感谢 Biobank Japan 以及 RIKEN 和 The Institute of Medical Science The University of Tokyo 的合作者使这项研究成为可能,同时感谢 Google 的其他合作者:Babak Behsaz、Andrew Carroll、Farhad Hormozdiari 和 Taedong Yun。我们也感谢 Hiroki Kayama 和 Joe Ledsam 的机构支持,以及 Michael Brenner 和 Katherine Chou 的领导层支持。