返回 文章 build CMS 文章

Gemini 3.8 Live 语音模型发布:用纯 Web 技术构建实时语音对话界面

Google 发布 Gemini 3.8 Live 语音模型,作者用 GPT-6 Astra 生成了一个纯 Web 技术实现的实时语音对话界面。

Gemini语音模型WebSocketWeb Audio API
成长分 / 100 68 综合收获、行动、留存与影响

Gemini 3.8 Live 语音模型发布:用纯 Web 技术构建实时语音对话界面
为什么值得读了解 Google 最新发布的 Gemini 3.8 Live 和 3.8 Live Extended Thinking 语音到语音模型。

学习如何用纯 Web 技术(WebSocket + Web Audio API)构建实时语音对话界面,无需任何库。

关键洞察
  1. Gemini 3.8 Live 和 3.8 Live Extended Thinking 是 Google 新发布的语音到语音模型,形态与 OpenAI 的 GPT-Live 系列相似。
  2. 作者使用 GPT-6 Astra Extra High 根据文档自动生成了一个 Web UI,用于试用这些新模型。
  3. 该 Web UI 支持选择模型和语音预设、输入可选系统提示词、通过浏览器进行语音对话,并能在模型说话时打断它。
转成行动

深入阅读

正文与原文对照

原文保真覆盖:全文原文字符:1657

工具 Gemini Live audio:通过实时语音对话与 Gemini 3.8 Live 和 Gemini 3.8 Live Extended Thinking 交谈。该界面捕获实时语音输入,显示对话转录文本,并允许你自然地打断回复或发送文字消息。Extended Thinking 模型支持可配置的推理级别,处理对话时还可以附带可选的文档上下文作为参考。

Google 今天发布了 Gemini 3.8 Live 和 3.8 Live Extended Thinking,这是两款新的语音到语音模型,形态与 OpenAI 的 GPT-Live 系列相近。

我让 GPT-6 Astra Extra High 阅读文档,并让它为我构建了这个 Web 界面来试用这些新模型。你可以选择模型和语音预设,输入可选的系统提示词,然后通过浏览器开始语音对话,包括在模型说话时打断它。

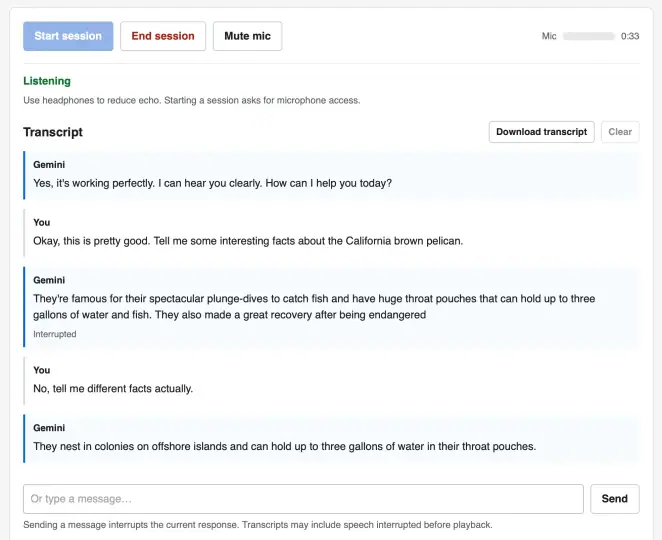
带有转录文本的语音聊天网页界面截图。顶部按钮:开始会话、结束会话、静音麦克风,另有麦克风电平表和显示 0:33 的计时器。状态:正在聆听。建议使用耳机以减少回声。开始会话会请求麦克风权限。转录文本(带有下载转录文本和清除按钮)。Gemini:Yes, it's working perfectly. I can hear you clearly. How can I help you today? 你:Okay, this is pretty good. Tell me some interesting facts about the California brown pelican. Gemini:They're famous for their spectacular plunge-dives to catch fish and have huge throat pouches that can hold up to three gallons of water and fish. They also made a great recovery after being endangered — 标记为已打断。你:No, tell me different facts actually. Gemini:They nest in colonies on offshore islands and can hold up to three gallons of water in their throat pouches. 底部是一个文本输入框,显示“Or type a message…”,旁边有发送按钮,并有提示:发送消息会打断当前回复。转录文本可能包含在播放前被打断的语音。

该实现不使用任何库。它连接到 wss://generativelanguage.googleapis.com/ws/google.ai.generativelanguage.v1alpha.GenerativeService.BidiGenerateContent?key=... WebSocket 端点,并使用 Web Audio API 的 AudioContext 进行采集和播放。

这是用于上手该 WebSockets API 的 Gemini Live 教程。