Sentence Transformers 是一个 Python 库,用于使用和训练嵌入模型与重排序(reranker)模型,应用场景广泛,如检索增强生成、语义搜索、语义文本相似度等。其 v6.0 更新引入了第四种模型类型:MultiVectorEncoder,用于 ColBERT 式的后期交互(late interaction)检索,并配套提供了完整的训练方案。在这篇博文中,我将演示如何用它微调一个多向量模型,使其在你的数据上超越通用检索模型。这套方法同样可以从零训练出强大的新多向量模型。下文的所有内容都运行在 pip install -U "sentence-transformers[train]" 上。
微调多向量模型涉及几个组成部分:模型本身、数据集、损失函数、训练参数、评估器和训练器类。我会逐一介绍这些组件,并配上实际示例,说明如何用它们微调出强大的多向量模型。
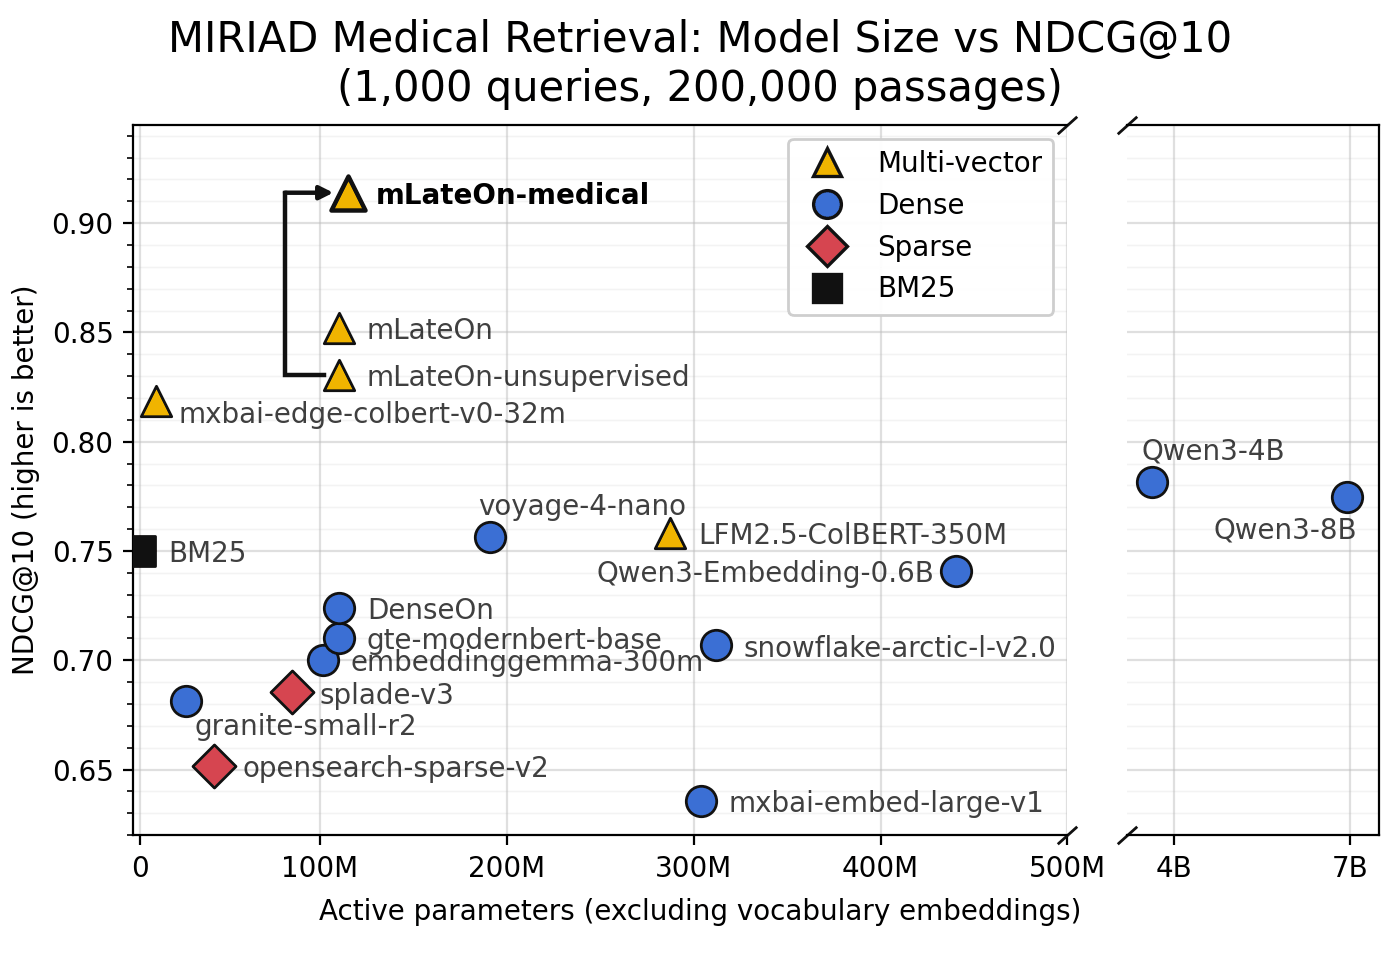
最后,在评估一节中,我会展示我微调出的 multi-vector-encoder/mLateOn-medical 模型。它是在撰写这篇博文的同时,用一块 RTX 3090 训练了 14.5 小时得到的,在我的医疗检索评估中轻松超越了我能找到的所有通用检索模型,无论是稠密、稀疏、词法还是多向量模型。
如果你更关心微调稠密嵌入模型、稀疏嵌入模型或重排序模型,可以阅读我之前的博文:训练和微调嵌入模型、训练和微调稀疏嵌入模型以及训练和微调重排序模型。
这篇博文讲的是训练多向量模型。如果你想了解如何使用它们,从加载、编码到在向量数据库中建立索引,请参阅配套博文 Multi-Vector (Late Interaction) Embedding Models with Sentence Transformers。
目录
什么是多向量模型?
稠密嵌入模型把整段文本压缩成一个向量,相似度就是两个这样的摘要之间的一次点积。多向量模型(也称后期交互模型或 ColBERT 式模型)则跳过了这一压缩步骤。它为每个词元保留一个小向量,并用 MaxSim 算子给查询和文档打分:每个查询词元找到与之最匹配的文档词元,再把这些得分求和。词元级匹配恰好保留了单个向量不得不平均掉的细粒度信号,这通常意味着更强的检索效果,代价是索引更大。
配套博文 Multi-Vector Embedding Models 详细介绍了架构、编码、打分和索引,所以这一节我会写得简短一些,尽快进入训练部分。

为什么要微调?
微调多向量模型能显著提升其在你所属特定领域的检索表现:网页搜索、法律取证、代码搜索和科学文献综述,在词汇、查询风格和相关性的定义上都各不相同。由于查询和文档是逐词元匹配的,多向量模型能捕捉到单向量模型往往会平均掉的细粒度领域信号,即便只有少量领域内的微调数据,它们的响应也非常好。
此外,大多数已发布的检索模型是针对短段落配置的。经典的 ColBERT 检查点把文档截断在 180 或 300 个词元,许多流行的稠密模型则截断在 256 或 512,因为它们 MS MARCO 式的训练数据很少超过这个长度。如果你的文档很长,这些模型会在打分前悄悄丢掉每篇文档的大部分内容。在我的医疗评估中,段落平均长度为 941 个词元,我测得这种截断最多会损失 0.24 的 NDCG@10,远大于不同模型架构之间的任何差异。当你训练自己的模型时,可以按你的数据所需来配置文档长度。
LightOn 在代码检索上遇到了同样的问题:通用的 LateOn 不够用,于是他们训练了 LateOn-Code。你所在的领域,无论是医疗、法律、金融还是公司内部文档,都不会有官方模型。这篇博文告诉你如何在几个小时内,用一块消费级 GPU 自己把它做出来。
训练组件
训练 MultiVectorEncoder 模型涉及以下组件:
- 模型:要微调的模型,或要从头构建的架构。
- 数据集:用于训练和评估的数据。
- 损失函数:衡量模型表现并指导优化过程的函数。
- 训练参数(可选):影响训练性能、跟踪和调试的参数。
- 评估器(可选):用于在训练前、训练中或训练后评估模型的类。
- 训练器:把所有训练组件整合在一起。
下面我们逐一详细看看每个组件。
模型
多向量训练让你在起点上有真正的选择空间,而且这一选择比你想象的更重要。
微调现有的多向量模型
如果你想进一步微调现有的多向量模型,完全不必操心架构:
from sentence_transformers import MultiVectorEncoder

# Loading in fp32 is preferred for training if your memory can handle it
model = MultiVectorEncoder(
    "lightonai/mLateOn-unsupervised",
    model_kwargs={"torch_dtype": "float32"},
    processor_kwargs={"model_max_length": 8192},  # the tokenizer-level token limit
)
检查点自带了它的配方:查询和文档的标记词元、投影头、打分跳过列表(skiplist)。微调时,通常应保留这一切,只改动你的数据所要求的部分。首先要检查的是长度配置,因为许多已发布的检查点把文档上限设在 180 到 512 个词元(参见为什么要微调?),而我的医疗段落长达 1,400 个词元。mLateOn 系列已经支持骨干网络完整的 8192 词元上下文,但如果你的起始检查点带有上限,就把它解除:
# Let the model read full documents instead of the caps it was trained with,
# e.g. GTE-ModernColBERT-v1 ships with query_length=48 and document_length=300
model[0].query_length = None
model[0].document_length = None
在没有设置各任务上限的情况下,截断会回退到分词器的 model_max_length,这就是我在上面加载时配置该上限的原因。
我还做了一处改动:加入标点跳过列表,让标点词元不参与文档侧的打分和存储。在一次四路消融实验(无、标点、停用词、两者都有)中,它在质量上小幅胜出,并且在这份数据上白白让文档索引缩小了 9.6%:
import string

# model[2] is the MultiVectorMask module
model[2].skiplist_words = list(string.punctuation)
model[2].resolve_with_tokenizer(model.tokenizer)  # token ids are cached, so re-resolve after changing
基于基础 Transformer 构建
你也可以让 MultiVectorEncoder 指向任意基础 Transformer,系统会自动为它追加一个随机初始化的新词元级投影层:
from sentence_transformers import MultiVectorEncoder

model = MultiVectorEncoder("answerdotai/ModernBERT-base", model_kwargs={"torch_dtype": "float32"})
# MultiVectorEncoder(
#   (0): Transformer({..., 'architecture': 'ModernBertModel'})
#   (1): Dense({'in_features': 768, 'out_features': 128, 'bias': False, ...})
#   (2): MultiVectorMask({'skiplist_words': [], 'skiplist_tasks': ['document'], ...})
#   (3): Normalize({...})
# )
这就是经典的 ColBERT 流水线:一个产生上下文词元嵌入的 Transformer,一个把每个嵌入投影到 128 维的词元级 Dense,一个决定打分时哪些词元计入的 MultiVectorMask,以及一个词元级的 Normalize。投影层从随机初始化开始,因此在模型可用之前必须先训练。有意思的是,这种方式对强大的稠密嵌入骨干网络同样有效。在我的实验中,仅凭一个新的投影层和 25k 训练对,基于 Alibaba-NLP/gte-modernbert-base 的结果就与现有检查点起点相差不到 0.03。
经典的 ColBERT 分词技巧([MASK] 查询扩展、[Q] / [D] 前缀词元、文档长度上限、标点跳过列表)默认全部关闭,可以自行配置。完整选项请参阅 Creating Custom Models。值得一提的是,我在自己领域的微调中测试了 [MASK] 查询扩展的四种配置,没有一种带来可测量的差异,所以不必觉得非得照搬经典配方。
该选哪个起点?
我在准备这篇博文时直接测量了这个问题:选取六个起点,用完全相同的配方在 MIRIAD 的 25k 个医疗问题-段落对上分别训练,然后在 1,000 个留出问题上对一个 50,000 段落的语料库进行评估:
| 起点 | 零样本 NDCG@10 | 训练 25k 对之后 | 变化量 |
|---|---|---|---|
| lightonai/mLateOn-unsupervised | 0.9087 | 0.9398 | +0.0311 |
| lightonai/mLateOn | 0.9277 | 0.9319 | +0.0042 |
| lightonai/LateOn-unsupervised | 0.9026 | 0.9206 | +0.0180 |
| lightonai/LateOn | 0.9185 | 0.9105 | -0.0080 |
| lightonai/GTE-ModernColBERT-v1 | 0.9198 | 0.9007 | -0.0191 |
| 基于 gte-modernbert-base 的全新投影头 | - | 0.9177 | - |
结果让我很意外,而且在两个模型家族中都得到了复现。*-unsupervised 检查点对新领域的适应能力远好于它们已完成训练的同系模型,尽管起点更低,最终却反超了对方。这些检查点处于大规模对比预训练之后、通用检索的监督微调之前,因此带有完整的后期交互结构,却没有那些之后领域训练还得先撤销的通用调优。相比之下,已完成训练的检查点在我尝试过的每一种学习率下都几乎没有进步,甚至出现退步。
所以,如果你喜欢的模型家族发布了监督微调前的检查点,就从它开始。如果没有,那么在强大的检索预训练骨干网络上接一个全新的投影层,是紧随其后的次优选择。对领域适应来说,从已完全训练好的检查点继续训练是最差的选择,尽管它是感觉上最自然的。
数据集
MultiVectorEncoderTrainer使用 datasets.Dataset 或 datasets.DatasetDict 实例进行训练和评估。你可以从 Hugging Face Datasets Hub 加载数据,也可以使用任意你喜欢的格式的本地数据(例如 CSV、JSON、Parquet、Arrow 或 SQL)。
注意:许多开箱即可与 Sentence Transformers 配合使用的公开数据集,在 Hugging Face Hub 上都被打上了 sentence-transformers 标签,因此你可以在 https://huggingface.co/datasets?other=sentence-transformers 轻松找到它们。不妨浏览一下,找找可能适用于你的任务、领域或语言的现成数据集。
Hugging Face Hub 上的数据
你可以使用 load_dataset 函数加载 Hub 上数据集中的数据:
from datasets import load_dataset

train_dataset = load_dataset("tomaarsen/miriad-4.4M-split", split="train")

print(train_dataset)
"""
Dataset({
    features: ['question', 'passage_text'],
    num_rows: 4467542
})
"""
这就是我在这篇博文中用来训练的数据集:来自 MIRIAD 的 440 万个医疗问题,每个问题都配有包含其答案的源段落(平均 941 个词元)。这类简单的(查询,相关段落)对,是为你自己的领域收集检索训练数据时最容易获得的,而且正如你将看到的,有它们就足够了。
本地数据
你也可以用 load_dataset 加载常见文件格式的本地数据:
from datasets import load_dataset

dataset = load_dataset("csv", data_files="my_file.csv")
# or
dataset = load_dataset("json", data_files="my_file.json")
如果你的本地数据需要预处理,可以用 datasets.Dataset.from_dict 通过列表字典来初始化数据集:
from datasets import Dataset

queries = []
documents = []
# Open a file, perform preprocessing, filtering, cleaning, etc.
# and append to the lists

dataset = Dataset.from_dict({
    "query": queries,
    "document": documents,
})
数据集格式
数据集格式必须与损失函数相匹配(或者说,你要选择与数据集格式相匹配的损失函数),这一点很重要。验证某种数据集格式能否用于某个损失函数,需要两步:
- 如果按照损失函数概览表,你的损失函数需要标签,那么数据集中必须有一个名为 "label" 或 "score" 的列。该列会被自动当作标签。
- 所有不叫 "label" 或 "score" 的列,都会按照损失函数概览表被视为输入。剩余列的数量必须与所选损失函数的有效输入数量一致。这些列的名称无关紧要,只有顺序重要。
在此之上还有两条多向量特有的约定:
- 按位置分配查询和文档:无论列名是什么,第一列都会被嵌入为查询,其后所有列都被嵌入为文档。这个默认行为可以通过标准的
router_mapping训练参数按列覆盖。 - 知识蒸馏格式:每个候选文档一列,即
(query, document_1, ..., document_N, scores),其中scores是每行 N 个教师模型得分组成的列表。对于把查询和文档的 ID 与独立文本数据集分开存放的 KD 数据集(例如 lightonai/ms-marco-en-bge),可以使用resolve_ids即时把 ID 解析成文本。
损失函数
损失函数量化模型在一批给定数据上的表现,使优化器能够更新模型权重,得到更理想(即更低)的损失值。适合你任务的损失函数取决于你拥有的数据和想要达到的目标。完整的选项列表见损失函数概览。
对于常见的问答对或问题-段落对,主力方案是使用 MultiVectorMultipleNegativesRankingLoss 进行批内负例(in-batch negatives)训练,即批次中的其他每个文档都充当每个查询的负例。批次越大,负例越多,训练效果越强,因此实际中你会想用它的 GradCache 变体 CachedMultiVectorMultipleNegativesRankingLoss,它把有效批大小与 GPU 能容纳的批大小解耦:
from sentence_transformers import MultiVectorEncoder
from sentence_transformers.multi_vector_encoder.losses import CachedMultiVectorMultipleNegativesRankingLoss

model = MultiVectorEncoder("lightonai/mLateOn-unsupervised", model_kwargs={"torch_dtype": "float32"})

loss = CachedMultiVectorMultipleNegativesRankingLoss(
    model=model,
    mini_batch_size=16,  # how many documents to encode per chunk: bounds memory, not quality
)
mini_batch_size 参数通过按此大小分块编码文档来限制显存占用,而有效的对比批大小(下面我的训练运行中为 128,在我的消融实验中,更大的批次没有带来进一步提升)则可以自由选择。无论分块大小如何,GradCache 都保证结果完全一致,所以在较小的 GPU 上调低它,只会增加训练耗时。当文档长度差异很大时,可以考虑它的同类 mini_batch_num_tokens,它按总词元预算而非文档数量来打包每个分块,这样一个包含异常长文档的分块就不会让显存飙升(我的 mini_batch_size=16 在每篇文档约 940 个词元时,对应 mini_batch_num_tokens=15_000)。
多向量模型特有的一个陷阱是:对比损失默认使用 scale=1.0,而稠密嵌入的对应损失默认使用 scale=20.0。之所以有 20.0,是因为余弦相似度只是 [-1, 1] 区间内的一个值,范围太窄,无法形成陡峭的 softmax。MaxSim 得分则是对每个查询词元的最佳匹配相似度求和,因此范围大致是 [0, query_length]:一个 32 词元的查询最高可得 32 分。所以不要把 scale=20.0 从稠密模型的训练脚本里照搬过来,否则会使 softmax 饱和,让梯度消失。
关于从更强的教师模型进行蒸馏(最强的通用后期交互模型正是这样训练出来的),请参阅 MultiVectorDistillKLDivLoss 以及训练概览文档中的知识蒸馏标签页。
训练参数
你可以使用 MultiVectorEncoderTrainingArguments 类来自定义训练过程。这个类可以调整影响训练速度的参数,也能帮助你了解训练过程中发生了什么。
关于最有用的训练参数的更多信息,请查看 Multi-Vector Encoder > Training Overview > Training Arguments。值得一读,能让你的训练发挥出最大效果。
下面是一个示例,使用的是我实际训练运行中的取值:
from sentence_transformers import MultiVectorEncoderTrainingArguments
from sentence_transformers.base.sampler import BatchSamplers

args = MultiVectorEncoderTrainingArguments(
    # Required parameter:
    output_dir="models/mLateOn-medical",
    # Optional training parameters:
    num_train_epochs=1,
    per_device_train_batch_size=128,  # the effective contrastive batch, thanks to GradCache
    per_device_eval_batch_size=16,
    learning_rate=1e-4,
    warmup_steps=0.05,
    prompts={"question": "[Q] ", "passage_text": "[D] "},  # the checkpoint's markers, keyed by training column
    fp16=False,  # Set to True if you have a GPU that supports FP16
    bf16=True,  # Set to True if you have a GPU that supports BF16
    batch_sampler=BatchSamplers.NO_DUPLICATES,  # in-batch negatives benefit from no duplicates
    # Optional tracking/debugging parameters:
    eval_strategy="steps",
    eval_steps=0.1,
    save_strategy="steps",
    save_steps=0.05,
    logging_steps=0.01,
    run_name="mLateOn-medical",  # Will be used in e.g. Trackio, W&B, etc.
)
其中有几项值得说明一下:
prompts:训练不会自动应用模型中存储的提示词,所以要显式地把它们映射到你的训练列上。这里是检查点用于问题列的[Q]标记,以及用于段落列的[D],使训练与推理保持一致。max_length(刻意不设置):该参数只在训练期间限制分词长度,适用于你希望训练比模型完整服务长度更便宜的情况。我测量了这个捷径在这份数据上的代价:以 512 词元训练,NDCG@10 下降约 0.015,换来约 2 倍的速度,而且这个差距不会随数据增多而缩小,因为模型根本看不到被截掉的部分。除非你对速度的需求高于质量,否则请保持不设置,让训练与推理一致。learning_rate=1e-4:在 5e-6 到 2e-4 的范围内扫描之后,这个高于常规的学习率对我效果最好。
评估器
要在训练期间跟踪模型表现,你可以向训练器传入 eval_dataset 来获得评估损失,但具体的检索指标要有用得多。Sentence Transformers 为多向量模型内置了以下评估器:
| 评估器 | 所需数据 |
|---|---|
MultiVectorInformationRetrievalEvaluator |
查询、语料库以及相关文档映射 |
MultiVectorNanoBEIREvaluator |
无需数据 |
MultiVectorTripletEvaluator |
(锚点, 正例, 负例)三元组 |
MultiVectorRerankingEvaluator |
{'query': '...', 'positive': [...], 'negative': [...]} 字典列表 |
MultiVectorDistillationEvaluator |
带有候选文档和教师得分的查询 |
对于领域微调,真正重要的是用你自己的留出数据构建的 MultiVectorInformationRetrievalEvaluator。构建它有一个小技巧:语料库要足够难,才能把不同模型区分开。在我的例子中,MIRIAD 的问题是由各自的源段落生成的,这使检索异常容易。仅针对 10k 个金标准段落,几乎所有模型的 NDCG@10 都超过 0.97。如果你的评估也这样饱和了,就加入干扰段落(我用的是训练集中去重后的段落),直到分数拉开差距:
from datasets import load_dataset
from sentence_transformers.multi_vector_encoder.evaluation import MultiVectorInformationRetrievalEvaluator

dataset = load_dataset("tomaarsen/miriad-4.4M-split")

# Gold: 1,000 evaluation questions, each mapping to its own passage, with the
# eval split's full ~10k unique passages as the initial corpus
corpus = {}
queries = {}
relevant_docs = {}
passage_to_id = {}
for idx, row in enumerate(dataset["eval"]):
    if row["passage_text"] not in passage_to_id:
        passage_to_id[row["passage_text"]] = f"p{len(passage_to_id)}"
        corpus[passage_to_id[row["passage_text"]]] = row["passage_text"]
    if idx < 1_000:
        queries[f"q{idx}"] = row["question"]
        relevant_docs[f"q{idx}"] = {passage_to_id[row["passage_text"]]}

# Distractors: unique train passages that make the haystack realistic
seen = set(passage_to_id)
for row in dataset["train"]:
    if len(corpus) >= 200_000:
        break
    if row["passage_text"] not in seen:
        seen.add(row["passage_text"])
        corpus[f"d{len(corpus)}"] = row["passage_text"]

evaluator = MultiVectorInformationRetrievalEvaluator(
    queries=queries,
    corpus=corpus,
    relevant_docs=relevant_docs,
    name="miriad-dev",
    batch_size=16,
)
# results = evaluator(model)
训练器
MultiVectorEncoderTrainer 是所有前述组件汇合的地方。下面是训练出 multi-vector-encoder/mLateOn-medical(即引言中的那个模型)的完整脚本:
import logging
import string
import traceback

from datasets import load_dataset

from sentence_transformers import (
    MultiVectorEncoder,
    MultiVectorEncoderModelCardData,
    MultiVectorEncoderTrainer,
    MultiVectorEncoderTrainingArguments,
)
from sentence_transformers.base.sampler import BatchSamplers
from sentence_transformers.multi_vector_encoder.evaluation import MultiVectorInformationRetrievalEvaluator
from sentence_transformers.multi_vector_encoder.losses import CachedMultiVectorMultipleNegativesRankingLoss

logging.basicConfig(format="%(asctime)s - %(message)s", datefmt="%Y-%m-%d %H:%M:%S", level=logging.INFO)


def main():
    # 1. Load the starting checkpoint: contrastively pretrained, not yet supervised
    # Loading in fp32 is preferred for training if your memory can handle it
    model = MultiVectorEncoder(
        "lightonai/mLateOn-unsupervised",
        model_kwargs={"torch_dtype": "float32"},
        processor_kwargs={"model_max_length": 8192},
        model_card_data=MultiVectorEncoderModelCardData(
            language="en",
            license="apache-2.0",
            model_name="mLateOn finetuned on MIRIAD medical retrieval",
        ),
    )

    # 2. Lift the per-task length caps so training and inference see full medical passages
    model[0].query_length = None
    model[0].document_length = None

    # 3. Skip punctuation tokens during scoring: a small quality win and a 9.6% smaller index
    model[2].skiplist_words = list(string.punctuation)
    model[2].resolve_with_tokenizer(model.tokenizer)

    # 4. Load 1 million medical question-passage pairs
    train_dataset = load_dataset("tomaarsen/miriad-4.4M-split", split="train").select(range(1_000_000))

    # 5. In-batch negatives with GradCache: large effective batch, memory-bounded chunks
    loss = CachedMultiVectorMultipleNegativesRankingLoss(model=model, mini_batch_size=16)

    # 6. A light dev evaluator to watch progress during training: 500 held-out questions
    # against the eval split's ~10k unique passages. The full 200k protocol runs afterwards.
    eval_split = load_dataset("tomaarsen/miriad-4.4M-split", split="eval")
    corpus, queries, relevant_docs, passage_to_id = {}, {}, {}, {}
    for idx, row in enumerate(eval_split):
        if row["passage_text"] not in passage_to_id:
            passage_to_id[row["passage_text"]] = f"p{len(passage_to_id)}"
            corpus[passage_to_id[row["passage_text"]]] = row["passage_text"]
        if idx < 500:
            queries[f"q{idx}"] = row["question"]
            relevant_docs[f"q{idx}"] = {passage_to_id[row["passage_text"]]}
    dev_evaluator = MultiVectorInformationRetrievalEvaluator(
        queries=queries, corpus=corpus, relevant_docs=relevant_docs, name="miriad-dev", batch_size=16
    )

    # 7. Training arguments, as discussed above
    run_name = "mLateOn-medical"
    args = MultiVectorEncoderTrainingArguments(
        output_dir=f"models/{run_name}",
        num_train_epochs=1,
        per_device_train_batch_size=128,
        per_device_eval_batch_size=16,
        learning_rate=1e-4,
        warmup_steps=0.05,
        prompts={"question": "[Q] ", "passage_text": "[D] "},
        fp16=False,  # Set to True if you have a GPU that supports FP16
        bf16=True,  # Set to True if you have a GPU that supports BF16
        batch_sampler=BatchSamplers.NO_DUPLICATES,
        eval_strategy="steps",
        eval_steps=0.1,
        save_strategy="steps",
        save_steps=0.05,
        logging_steps=0.01,
        run_name=run_name,
    )

    # 8. Create a trainer & train
    trainer = MultiVectorEncoderTrainer(
        model=model,
        args=args,
        train_dataset=train_dataset,
        loss=loss,
        evaluator=dev_evaluator,
    )
    trainer.train()

    # 9. Save the trained model
    model.save_pretrained(f"models/{run_name}/final")

    # 10. (Optional) Push it to the Hugging Face Hub
    try:
        model.push_to_hub(run_name)
    except Exception:
        logging.error(f"Error uploading model to the Hugging Face Hub:\n{traceback.format_exc()}")


if __name__ == "__main__":
    main()
这就是全部配方:一个监督微调前的检查点、一百万个领域数据对、批内负例、完整文档长度,以及高于常规的学习率。这次训练在我的单块 RTX 3090 上用了 14.5 小时,显存峰值为 17.5 GB,其中每一项选择都是实测对比的胜出者,而不是拍脑袋的猜测。
对预算较少的读者,我的扩展性实验表明,100k 个数据对(训练 75 分钟)的 NDCG@10 与完整的百万对训练相差不到 0.012。大部分收益都出现在第一个小时内。
回调
MultiVectorEncoder 训练器支持多种 transformers.TrainerCallback 子类,包括:
WandbCallback:如果安装了wandb,则将训练指标记录到 W&BTensorBoardCallback:如果tensorboard可用,则将训练指标记录到 TensorBoardCodeCarbonCallback:如果安装了codecarbon,则在训练期间跟踪碳排放
通过 report_to 训练参数启用这些回调,例如 report_to=["wandb", "codecarbon"],并安装所需的依赖。它默认为 "none",而 report_to="all" 会激活所有已安装依赖的集成。
关于这些回调以及如何创建自己的回调,更多信息请参阅 Transformers 回调文档。
多数据集训练
通常,表现顶尖的通用模型是同时在多个数据集上训练的。然而,由于各数据集格式不同,这种做法可能很有挑战性。幸运的是,MultiVectorEncoderTrainer 允许你在格式不统一的多个数据集上训练。此外,它还可以灵活地为每个数据集应用不同的损失函数。同时在多个数据集上训练的步骤如下:
- 使用
datasets.Dataset实例的字典(或datasets.DatasetDict)作为train_dataset(也可以同时作为eval_dataset)。 - (可选)使用将数据集名称映射到损失函数的字典。仅当你希望对不同数据集使用不同损失函数时才需要。
每个训练/评估批次只包含来自其中一个数据集的样本。从多个数据集中采样批次的顺序由 MultiDatasetBatchSamplers 枚举定义,可以通过 multi_dataset_batch_sampler 传给 MultiVectorEncoderTrainingArguments。有效选项如下:
MultiDatasetBatchSamplers.ROUND_ROBIN:从各数据集轮流采样,直到其中一个耗尽。采用这种策略时,很可能不是每个数据集的所有样本都会被用到,但各数据集被采样的机会均等。MultiDatasetBatchSamplers.PROPORTIONAL(默认):按各数据集的大小比例进行采样。采用这种策略时,每个数据集的所有样本都会被使用,较大的数据集被采样得更频繁。
评估
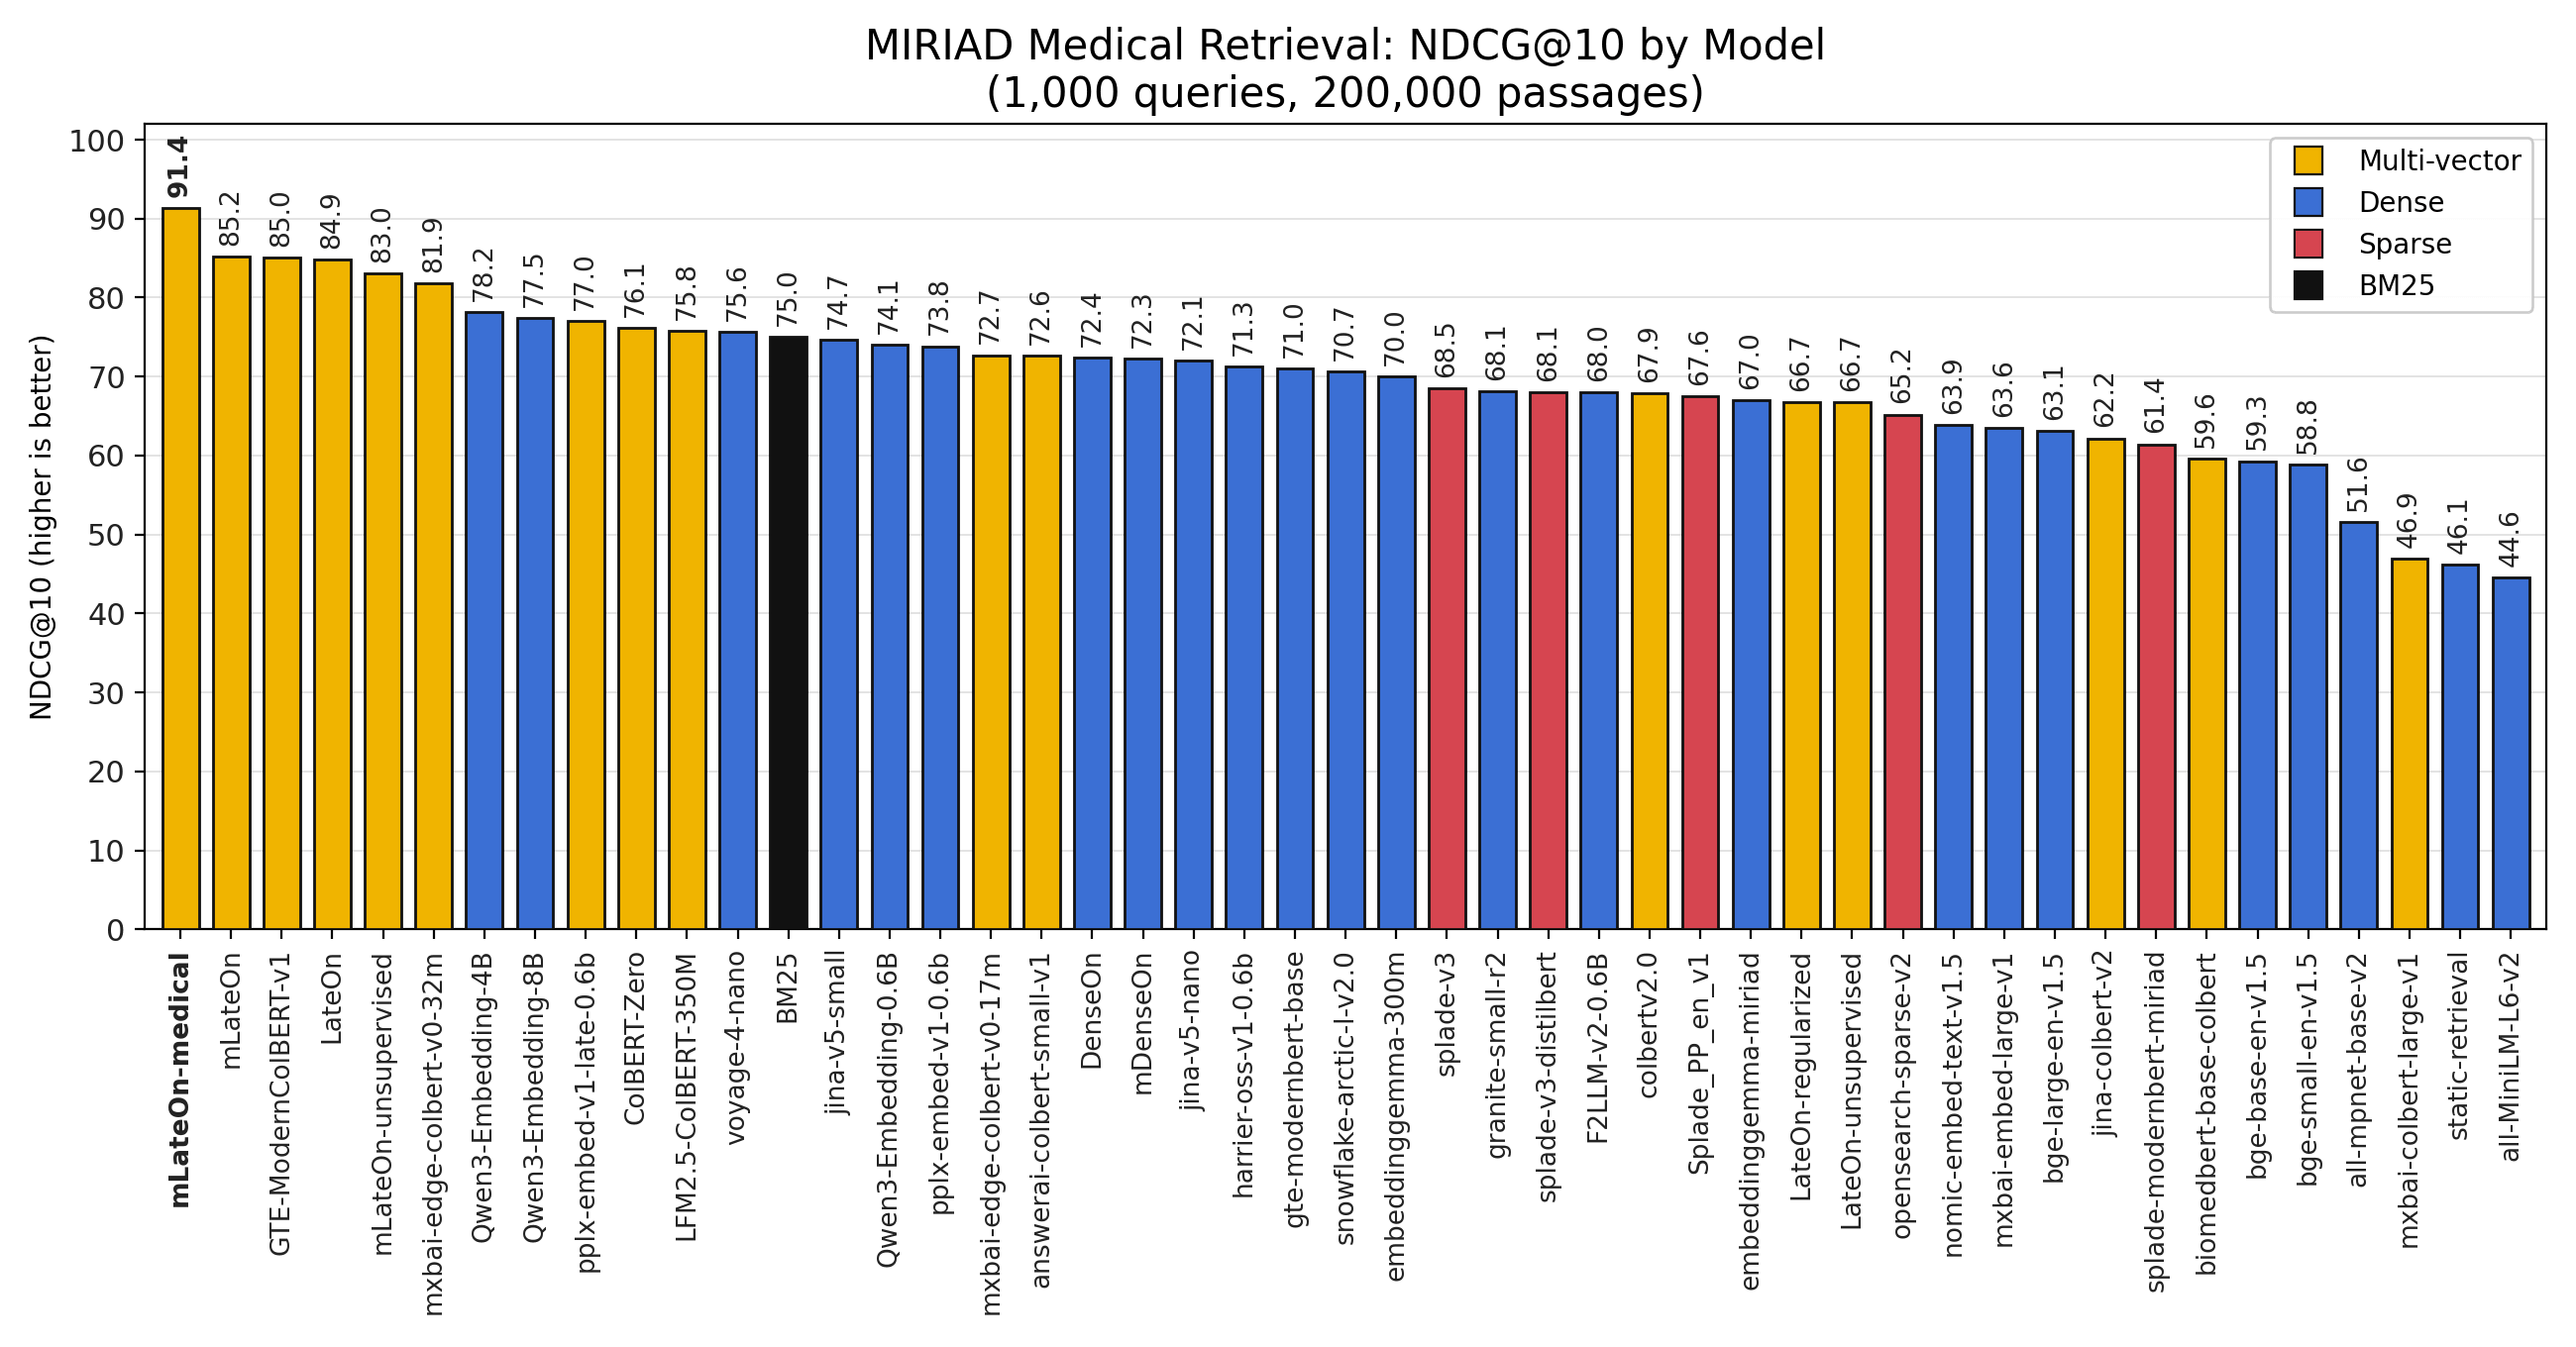
为了弄清微调后的模型处于什么水平,我在 MIRIAD 评估集上,将它与四个架构家族的 50 多种检索模型配置进行了对比评估。评估集的构建方式与上面评估器一节完全一致:1,000 个留出的医疗问题,在 200,000 个唯一段落中检索(10k 个金标准段落混在来自训练集、去重后的 190k 个干扰段落中)。这个语料库是该选哪个起点?中 50,000 段落语料库的四倍大,所以两张表之间的分数不可比较。
主要结果如下,完整表格在下方可折叠区域中:
| 模型 | 家族 | NDCG@10 |
|---|---|---|
| multi-vector-encoder/mLateOn-medical(我的模型) | 多向量,已微调 | 0.9139 |
| lightonai/mLateOn | 多向量,零样本 | 0.8520 |
| lightonai/GTE-ModernColBERT-v1(已解除长度上限) | 多向量,零样本 | 0.8502 |
| Qwen/Qwen3-Embedding-4B | 稠密,零样本 | 0.7817 |
| voyageai/voyage-4-nano | 稠密,零样本 | 0.7563 |
| BM25 | 词法 | 0.7501 |
| naver/splade-v3 | 稀疏,零样本 | 0.6853 |
微调后的模型位居榜首,以 +0.062 的 NDCG@10 超过了任意架构中最强的零样本模型。换句话说,最强的零样本模型能在 75.8% 的查询中把正确段落排在第一位,而微调后的模型达到 84.9%,将排名第一的错误率降低了三分之一以上。
架构上的规律同样清晰:榜单顶部清一色是后期交互模型。在长文档上,即使训练条件和骨干网络都相同,每个词元一个向量也胜过每篇文档一个向量。DenseOn 和 LateOn 除了头部之外,训练数据和架构都相同,后期交互的那一个领先 +0.12;多语言的一对(mDenseOn 和 mLateOn)也复现了这一点,领先 +0.13。堆规模也救不了单向量。Qwen3-Embedding-4B 是最强的稠密模型,活跃(非嵌入)参数量约为我的模型的 33 倍,却仍然差了 0.13,而 8B 版本的得分比 4B 还低。
BM25 的表现也出人意料地好,它超过了所有稀疏模型、所有受截断上限限制的多向量模型,以及除三个以外的所有稠密模型:这三个是数十亿参数的 Qwen3-Embedding-4B 和 8B,以及读取完整 32k 词元上下文、仅以 0.006 的微弱优势领先的 voyage-4-nano。不过,别指望这种表现能迁移到你自己的数据上。MIRIAD 的问题是由段落生成的,因此查询与其金标准段落之间的词汇重叠远高于典型的检索场景,而 BM25 不限上下文长度,可以利用每一个重叠的词,而大多数神经网络检查点会截断。BM25 基线成本低廉,值得一直跑一下,只是别指望还有这样的优势。
全部模型一览,按得分排序,并按架构家族着色。
点击查看完整评估表
标有 @N 的模型在评估时将文档长度上限解除到了 N 个词元,因为它们原生的上限(180 到 512 个词元)否则会截断平均 941 词元的段落。对每个多向量模型而言,这一解除相比原样使用的那一行都带来了 +0.08 到 +0.24 的 NDCG@10 提升,就连稠密模型 DenseOn 经同样处理后也提升了 +0.03。
请注意,这并不意味着 multi-vector-encoder/mLateOn-medical 在所有领域都是最强的模型。它只是在我的领域里最强。这完全没问题,因为我只需要这个模型在我的数据上表现良好。
不要低估在你的领域上微调多向量模型的威力。在一块消费级 GPU 上花十四个半小时,就产出了一个在这份数据上没有任何通用检索模型能接近的模型,而且这套配方只是一个脚本,既不需要教师模型,也不需要挖掘负例!
优化索引
对多向量检索,一个合理的质疑是索引体积,而这个领域几乎是最糟糕的情形。由于每个词元存一个向量,我的模型每个段落约需 878 个向量,因此 200,000 段落的语料库在 fp16 下约需 45 GB,而稠密模型远不到 1 GB。文档长度正是造成这一差距如此悬殊的原因。配套文章中的 Natural Questions 段落平均每段只有约 125 个词元向量,少了七倍,所以短段落语料库的索引起点要比这个小得多。HierarchicalTokenPooling 模块正是针对这一点进行压缩:它对每篇文档的词元嵌入做聚类并存储聚类均值,大约保留 1 / pool_factor 的向量:
from sentence_transformers.multi_vector_encoder.modules import HierarchicalTokenPooling

pooling = HierarchicalTokenPooling(pool_factor=4)
document_embeddings = model.encode_document(passages, token_pooling=pooling)
我是在训练完成的模型上事后测量的,没有做任何感知池化的训练,而在长文档上,它的代价低得惊人。
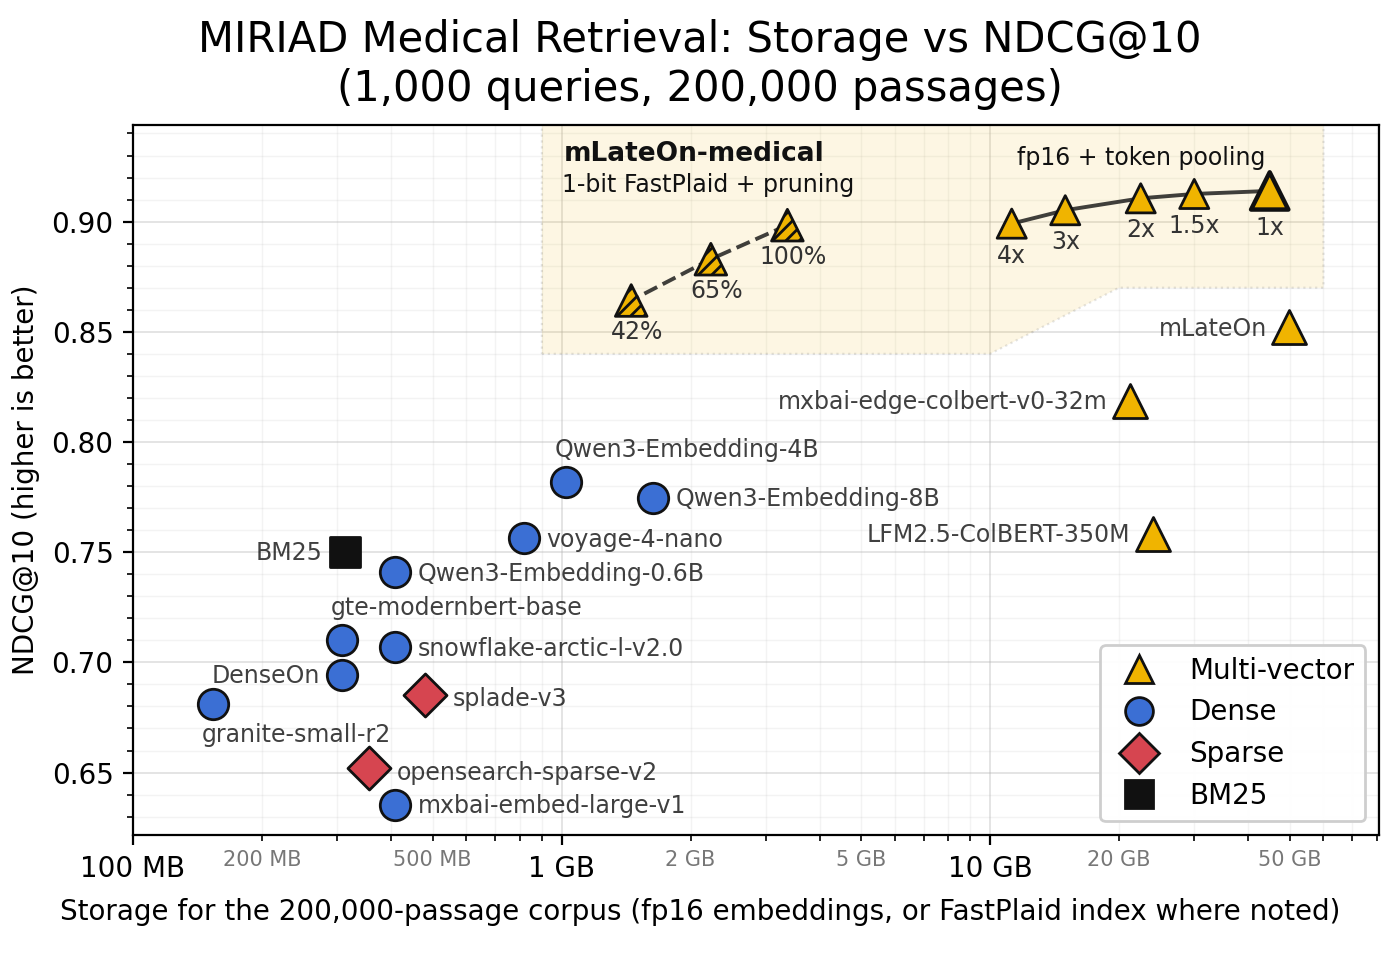
实心点是未压缩的嵌入,这样每个家族都按同样的方式计算,并用精确搜索打分。不过,你不会真的这样部署其中任何一个。稠密索引通常使用 int8 或二值量化加重打分,稀疏索引会压缩倒排列表,多向量索引则使用 PLAID 式的残差压缩。不要把这些点理解为你需要购买的磁盘容量,而应理解为相对的存储成本。
词元池化是那条实线。把向量数量减半,NDCG@10 只损失 0.0033,排名第一的准确率不受影响;只保留四分之一的向量,即 11.2 GB,得分仍有 0.8991。曲线还在延续(我一直测到只保留十分之一的向量,得分仍为 0.8765),但一旦可以采用量化,就没什么理由把池化推到那么远,这也正是下方虚线要说明的内容。
虚线展示的是真实部署可能的样子。我让 Omar Khattab 提前拿到了模型和基准测试,他用 fast-plaid 以 1 比特残差量化测量了这些配置,使用紧凑的 17 位质心 ID 和 18 位文档 ID,代替通常未打包的 64 位整数,另外还有文档侧的剪枝:
| 配置 | 保留的向量 | 索引 | NDCG@10 |
|---|---|---|---|
| 1 比特 PLAID,全部向量 | 100% | 3.37 GB | 0.8984 |
| 1 比特 PLAID + 剪枝 | 65% | 2.23 GB | 0.8830 |
| 1 比特 PLAID + 剪枝 | 42% | 1.45 GB | 0.8642 |
第一行比原始嵌入小 13 倍,代价是 0.0155 的 NDCG@10。这比池化曲线上的任何一点都划算得多。量化缩小的是每个向量,而池化和剪枝削减的是保留的向量数量,所以它们可以叠加,而量化是应当首先采用的手段。再往下推,最后一行的索引为 1.45 GB,小于 Qwen3-Embedding-8B 的 fp16 嵌入(1.64 GB),得分却高出 0.0895。多向量索引太大的质疑,在正确配置的索引面前站不住脚。
这里的剪枝很朴素,只是为了证明在量化之上同样可以削减词元,因此请把最后两行看作下限,而非前沿水平。如果你完全不想手动调优量化,配套文章的索引一节介绍了 fast-plaid、Qdrant、Weaviate 和 Vespa。
多向量检索的开销只取决于它的索引。这个语料库的原始嵌入为 45 GB,而配置得当的索引至少能缩小 7 倍,准确率几乎不变。索引值得你投入与检查点同样多的关注。
致谢
感谢 Omar Khattab 测量了优化索引一节中的量化与剪枝索引配置,并就后期交互的索引成本与我进行了讨论。
更多资源
训练示例
这些页面提供了带讲解的训练示例以及训练脚本的链接。你可以借助它们熟悉多向量训练循环:
- MIRIAD:医疗检索的领域专用训练,是这篇博文所用配方的一个更早、更简单的前身
- MS MARCO:对比学习与知识蒸馏的配方
- Multimodal:ColPali 式的视觉文档检索训练
- PEFT Adapters:使用 LoRA 的参数高效微调
文档
如需进一步学习,你也可以浏览以下关于 Sentence Transformers 的资源:
另外还有一个进阶页面,你可能会感兴趣:
以及配套博文,涵盖了关于使用这些模型的一切: