世界卫生组织(WHO)估计,全球每年有超过25万例可预防的死亡由妊娠相关并发症导致。虽然产前超声可以改善结局并降低胎儿和孕产妇死亡率,但全球三分之二的人无法获得超声等诊断性医学影像。当前支持孕产妇健康的方法严重依赖专业临床培训,导致数百万生活在资源匮乏地区的人在 entire pregnancy 期间无法获得一次超声检查。
我们看到了一个机会,通过开发解读“盲扫”超声的机器学习系统,来开展研究以满足这一现实需求。这种扫描方式允许没有专业超声培训的一线医护人员,只需以标准化模式在腹部滑动低成本便携式超声探头即可执行扫描。
播放无声循环视频 暂停无声循环视频
取消视频静音 视频静音
盲扫序列协议图,按其在数据收集协议中出现的顺序排列。
由于许多地区面临专家严重短缺,而传统的超声技师培训既昂贵又需要多年的投入,使这些卫生工作者能够在最少培训下进行评估,有可能显著扩大产前筛查的覆盖范围。
将最低培训要求与AI解读相结合,最终可能意味着成功开发的工具,有可能提高基于超声的妊娠评估的可用性,从而改善获得更高质量孕产妇保健的机会。
在发表于JAMA Network Open的“基于盲扫超声的AI孕龄评估的泛化性”一文中,我们评估了用于孕龄评估(妊娠进展程度)的AI模型在不同临床环境和硬件上的泛化效果。虽然我们之前的研究验证了模型在其学习的同一回顾性队列中未见患者上的性能,但这项新的前瞻性研究展示了AI系统如何在真实诊所的移动设备上实时可靠运行,仅由新手操作员使用不熟悉的超声设备,并进行最少的微调。
“孕龄基本上就是女性怀孕的进展程度。我们所有的筛查、许多治疗、许多分娩指征都基于这个从孕龄获得的主时间线。”
评估不同临床环境下的性能
为了使医疗AI系统能够安全地在全球范围内扩展,它必须展示泛化性——当引入到与模型训练时不同的患者群体、临床工作流程和超声硬件差异的新临床环境时,保持准确的诊断性能。
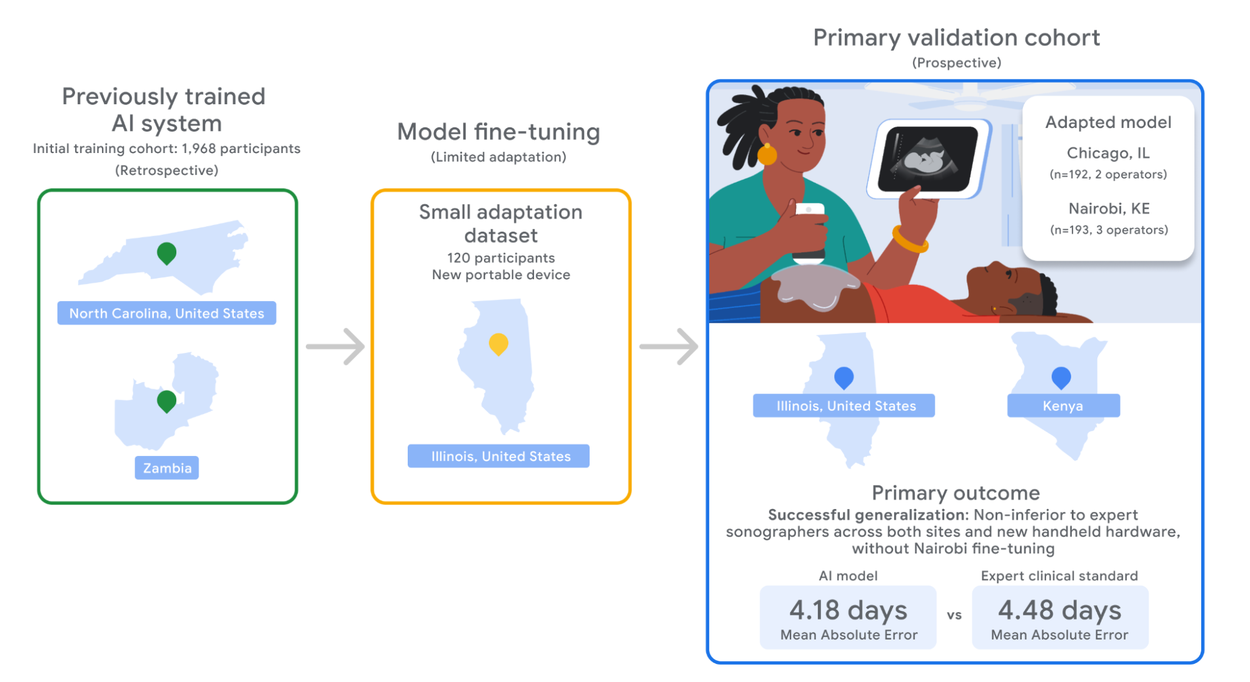
在这项研究中,我们最初的AI模型仅在我们的一个目标人群上进行了最少调整,然后前瞻性地在两个目标环境中进行了测试:
- Northwestern Medicine:位于美国伊利诺伊州芝加哥的城市高资源学术医疗中心。
- Jacaranda Health:位于肯尼亚内罗毕的城市社区诊所网络。
研究AI系统最初使用在北卡罗来纳州和赞比亚收集的超声数据进行训练,使用了一组Sonosite、GE和Butterfly Networks商用超声探头,然后与Clarius C3(一种商用便携式经腹探头)配对。所有这些站点在多个护理维度上存在差异,包括女性首次产前保健的时间、她们接受常规超声检查的次数以及孕龄通常的确定方式。
为了评估高效的系统调优,该研究利用了一个来自芝加哥的120名参与者的小型试点数据集——约为原始训练集的6%——来使模型适应新的探头硬件,并将孕龄预测范围扩展到36周以上。为了了解泛化性,没有使用内罗毕站点的数据进行微调,保持肯尼亚临床验证作为严格独立的外部测试。为了评估综合效用,该研究还包括多胎妊娠,这可能对人类操作员和自动化系统都带来跟踪和测量的挑战。
关键发现:与专家标准相匹配
我们比较了AI系统从盲扫超声估计胎儿年龄的能力与基于临床标准专家方法的公式估计。这种专家方法依赖于专家超声技师定位胎儿的多个特定横截面以进行精确的生物测量,这是一项难以扩展的任务,需要多年培训且高度依赖操作者。
评估一个主要队列,包含385名妊娠16至36周的参与者,该诊断研究展示了强大的AI系统结果:
- 临床非劣效准确性:在两个队列中,AI模型在估计孕龄方面的平均绝对误差(MAE)为4.18天,成功证明了不劣于由专家超声技师执行的标准临床程序,后者的MAE为4.48天。
- 跨场景泛化:在芝加哥,适配后的模型达到了4.10天的MAE。在内罗毕,在零本地优化的情况下,模型达到了可比的4.27天MAE。
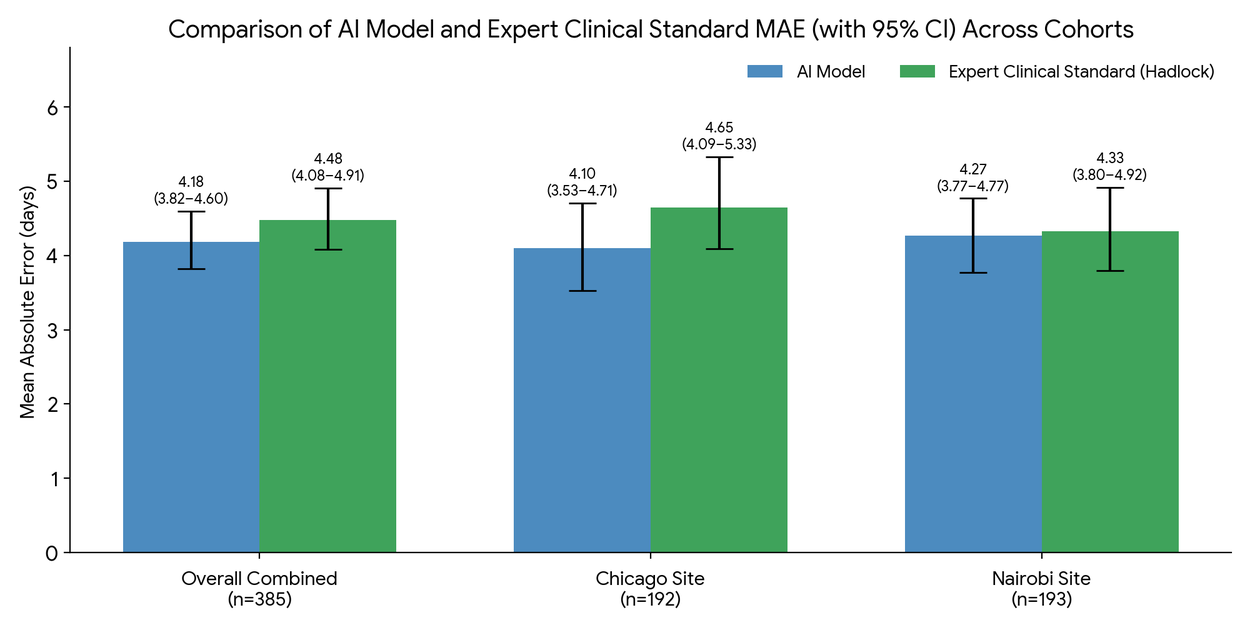
除了准确性之外,探索性指标显示,研究AI系统在复杂场景中具有韧性。例如,在胎儿体重极端(高于第90百分位)的情况下,模型优于传统的生物测量公式,展示了对胎儿大小变化的鲁棒性。
前瞻性部署中吸取的经验教训
除了强调通过AI扩大超声可及性的巨大机会外,这项前瞻性多中心研究还使我们能够主动观察和优化AI在真实临床环境中的行为。通过将我们的系统直接部署到日常临床工作流程中,我们获得了有助于为现实世界使用而设计的实用见解。例如,我们观察到可更换电池比插入式对接站对于在连续患者之间保持设备充电的重要性。
这些研究还表明,部署这样的AI系统还需要与临床医生和患者建立深厚的信任。最终实现这一目标的一个重要方法是在应用程序中构建明确的保障措施,例如我们的模型产生的模型置信度估计,以拒绝质量差的扫描并向临床医生用户传达模型不确定性。
展望未来:用AI扩大护理可及性
这些研究发现表明,基于AI的系统可以分析由未接受专业超声培训的操作员获取的标准化“盲扫”图像。AI对胎儿年龄的估计准确性可与当前专家操作员和更昂贵的传统推车式超声机器的标准护理相媲美。在不同临床环境、硬件和变化人群中展示技术通用性,标志着突出其扩大孕产妇健康这一关键能力可及性潜力的关键一步。
通过赋能经过最低限度培训的社区卫生工作者进行可靠的超声评估,这项研究展示了在资源不足地区扩大数百万产前覆盖的潜力。研究这种可扩展技术的能力为更具韧性、可及的医疗系统奠定了基础,确保每位母亲,无论身处何地,都有机会健康怀孕和安全分娩。
这项即时护理研究代表了通过AI扩大医疗可及性更广泛愿景的潜在应用。从这项研究中获得的见解为我们下一代多模态医学智能研究的开发提供了信息。通过我们的持续工作,我们努力为开发社区和科学家提供他们所需的答案,以改善临床护理并使其对所有人有益和可及。
致谢
感谢我们在Google Research、Jacaranda Health和西北大学范伯格医学院的合著者:Chace Lee、Justin Krogue、Anneka Wickramanayake、Stacey Caron、Priscah Cheruiyot、Amber Watters、Alicia Martín、Tiya Tiyasirichokchai、Akib Uddin、Yun Liu、Patricia Strachan、Sunny Jansen、Alyssa Santi、Preeti Singh、Catherine Arguelles、Kenneth Hudson、David Melnick、Mahesh Vaidyanathan、Mozziyar Etemadi、Yossi Matias、Avinatan Hassidim、Greg Corrado、Shruthi Prabhakara、Daniel Golden、Ryan G. Gomes和Shravya Shetty。感谢Pi-Chuan Chang和Dale Webster审阅这项工作。