本报告的前半部分将介绍 HBM、制造工艺、厂商之间的竞争格局、KVCache 卸载、分离式预填充解码(disaggregated prefill decode),以及宽/高秩 EP(wide / high-rank EP)。报告其余部分将深入探讨 HBM 的未来:HBM4 即将迎来的变革性变化,即 HBM 采用定制基底裸片(custom base die);包括 OpenAI、Nvidia 和 AMD 在内的各家加速器厂商在定制 HBM 上的做法;海岸线面积问题(shoreline area problem)、内存控制器卸载、中继器 PHY(repeater PHY)、LPDDR + HBM 组合,以及各种滩头(beachfront)扩展技术。我们还将讨论 SRAM 标签、存内计算(compute under memory)、供应链影响以及三星。
HBM 简介
随着 AI 模型日趋复杂,AI 系统需要容量更大、延迟更低、带宽更高、能效更好的内存。不同类型的内存各有取舍:SRAM 速度极快但密度低;DDR DRAM 密度高、价格低,但带宽不足;如今最主流的内存是片上 HBM,它在容量与带宽之间取得了平衡。
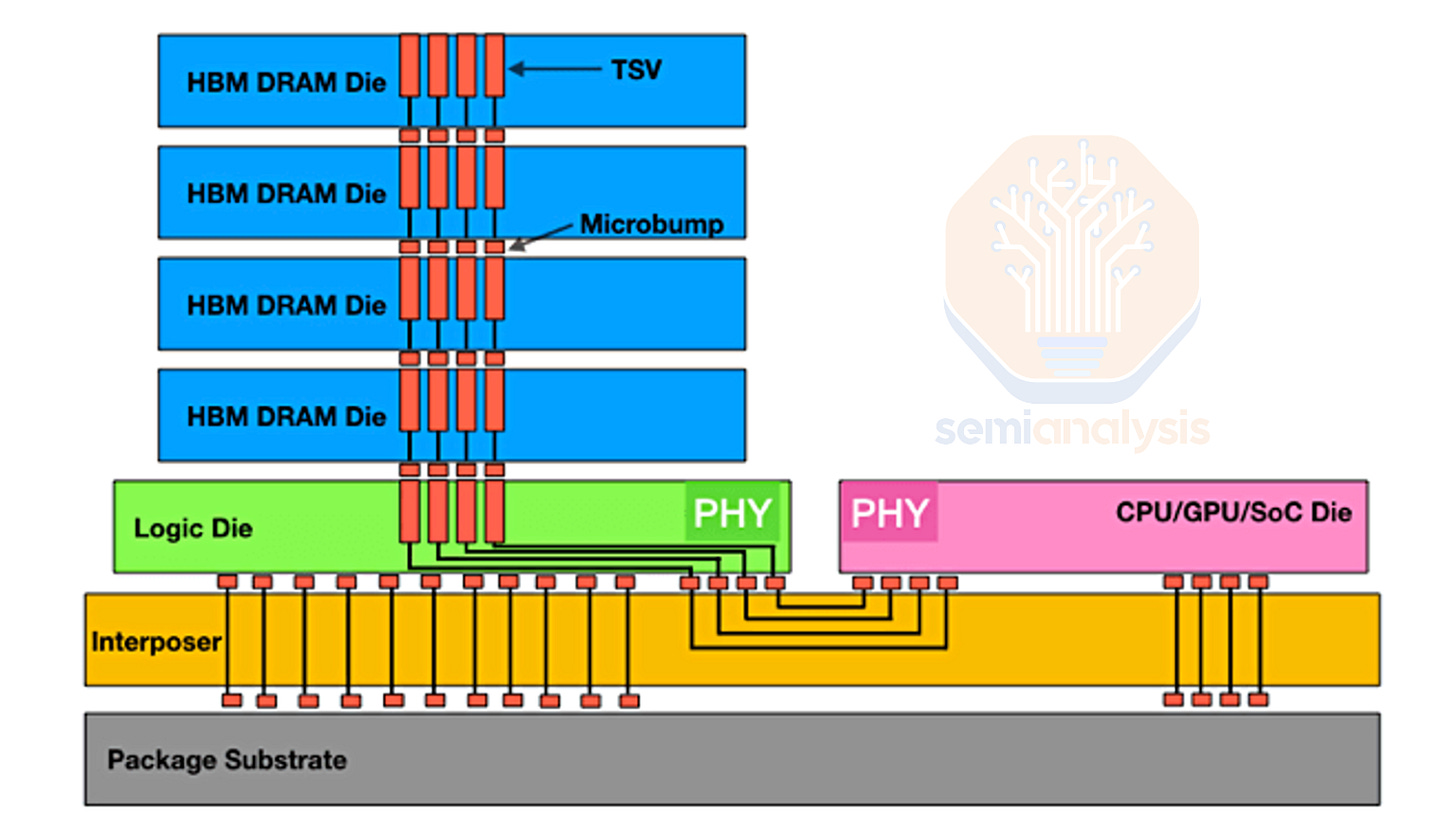
HBM 将垂直堆叠的 DRAM 芯片与超宽数据通路结合在一起,在带宽、密度和能耗之间为 AI 工作负载取得了最佳平衡。HBM 的生产成本高得多,相对 DDR5 的溢价也合情合理,但需求依然强劲。所有用于生成式 AI 训练和推理的主流 AI 加速器都使用 HBM。各家加速器路线图的共同趋势是:通过增加堆栈数量、提高层数、采用更快的 HBM 世代,来扩展单芯片的内存容量和带宽。依赖其他类型内存的架构性能欠佳,正如我们此前所论证的那样。
在本报告中,我们将审视 HBM 的现状、供应链中正在发生的事情,以及未来即将出现的突破性变化。我们将分析 HBM 在 AI 加速器架构中的关键作用、HBM 对 DRAM 市场的影响,以及它为何正在颠覆内存市场分析的方式。对于订阅用户,我们还将回答关于三星能否继续作为可行供应商的重大问题,并指出一项可能扭转 HBM 容量不断增长趋势的技术变化。
HBM 入门
首先简要介绍一下 HBM:它特别在哪里,又为何难以制造。人们通常把 HBM 与以 3DIC 方式堆叠的多颗 DRAM 裸片联系在一起,但另一个关键特征是它宽得多的数据总线,这使其即便信号速率平平,也能提升带宽。这条宽得多的总线,使 HBM 在单封装带宽上远胜任何其他形式的内存。
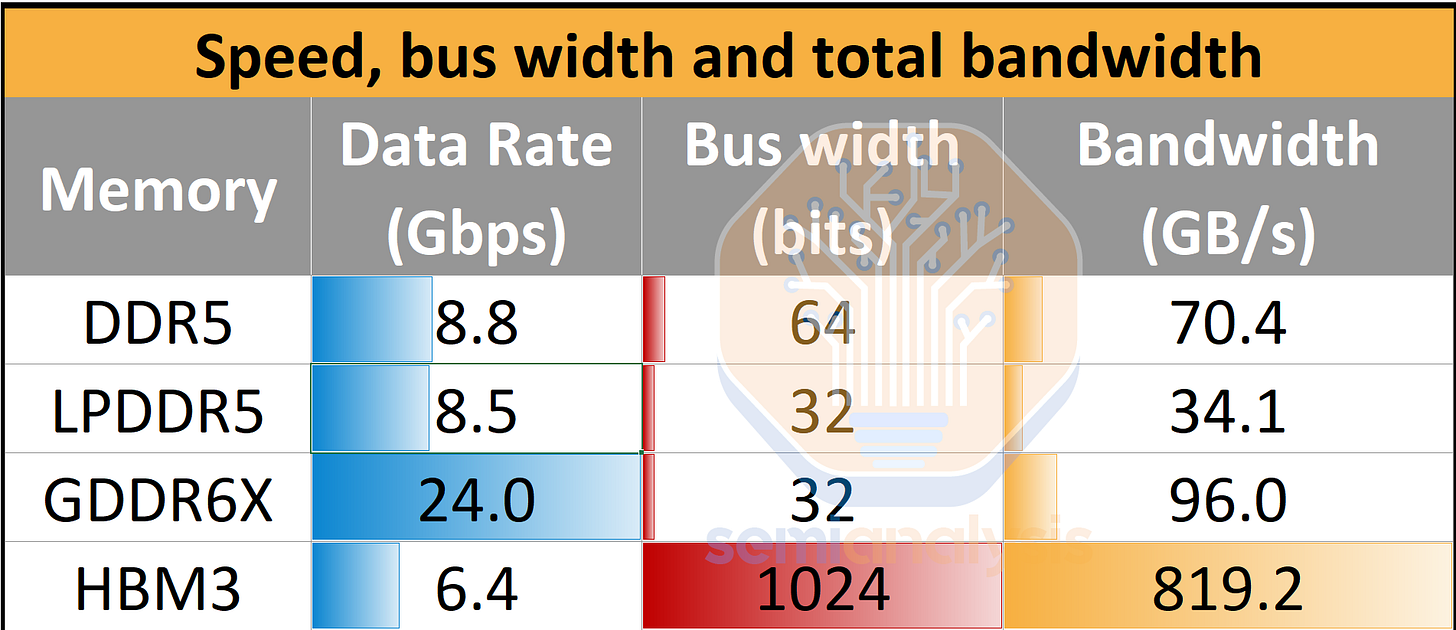
I/O 多得多的后果是布线密度和复杂度上升。每个 I/O 都需要一根独立的导线/走线,电源和控制还需要额外布线。对于一个 HBM3E 堆栈,相邻的 XPU 与 HBM 之间有超过 1,000 根导线。这样的布线密度在 PCB 或封装基板上无法实现,因此需要像 CoWoS 这样的 2.5D 封装组装中的中介层(interposer,硅或有机材料)。
为了降低数据传输的延迟和能耗,HBM 需要直接放置在计算引擎的海岸线(shoreline)旁。这使海岸线(SOC 的边缘)变得更加宝贵,因为 HBM 只能放在 SOC 的两条边上,另外两条边要留给封装外的 I/O。这限制了 HBM 可放置的面积,也就需要对内存裸片做垂直堆叠才能提供足够的容量。
为实现 3DIC 形态,堆栈的每一层(堆栈顶层除外)都需要有 TSV,用来向上一层传输电力和信号。容纳这些 TSV 所需的额外面积,使 HBM 的裸片尺寸比同等 DDR 更大:SK Hynix D1z DDR4 的位密度为 0.296 Gb/mm2,比其 HBM3 的 0.16 Gb/mm2 高出 85%。TSV 工艺是标准 DRAM 与 HBM 的关键差异之一,而相关设备是把普通 DDR DRAM 晶圆产能转换为 HBM 产能的主要瓶颈。
另一个差异在后道:HBM 需要总共堆叠 9 层或 13 层(底部是一颗逻辑基底裸片,上面是 8 或 12 层 DRAM)。与 CoWoS 一道,HBM 把封装技术带入了主流。MR-MUF 这类小众封装技术,如今已成为业内人士的常识。
爆发式的位需求
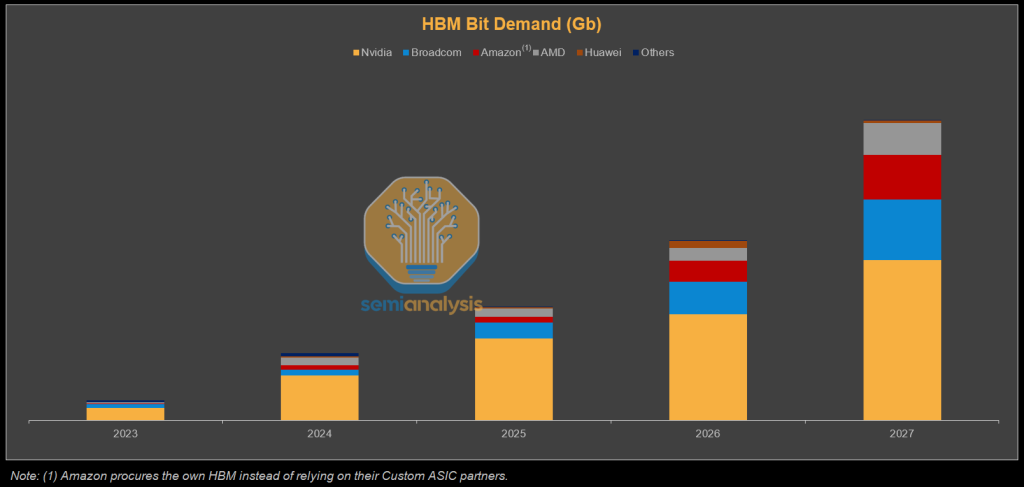
我们可以看到,伴随 AI 加速器需求而来的是 HBM 位需求的巨大增长。尽管定制 ASIC 迅速崛起,Nvidia 在 2027 年仍将占据 HBM 需求的最大份额,这得益于其激进的路线图,仅 Rubin Ultra 一款就将单 GPU 容量推高到 1 TB。随着 TPU 和 MTIA 出货量激增,Broadcom 紧随其后,而 OpenAI 和 SoftBank 的增量项目则带来规模较小但明显的拉动。Amazon 也成为最大的 HBM 客户之一:它的策略是直接采购 HBM,而不是通过设计合作伙伴,这有助于降低成本。如需逐款芯片的详细位需求预测,请参阅我们的加速器模型(Accelerator Model)。该模型包含按内存厂商划分的营收和位需求预测,以及按供应商拆分的晶圆投片量和 TSV 产能;它还追踪不同世代 HBM 的价格,并提供逐款芯片的 HBM 类型、层数、堆栈数量、容量和带宽。
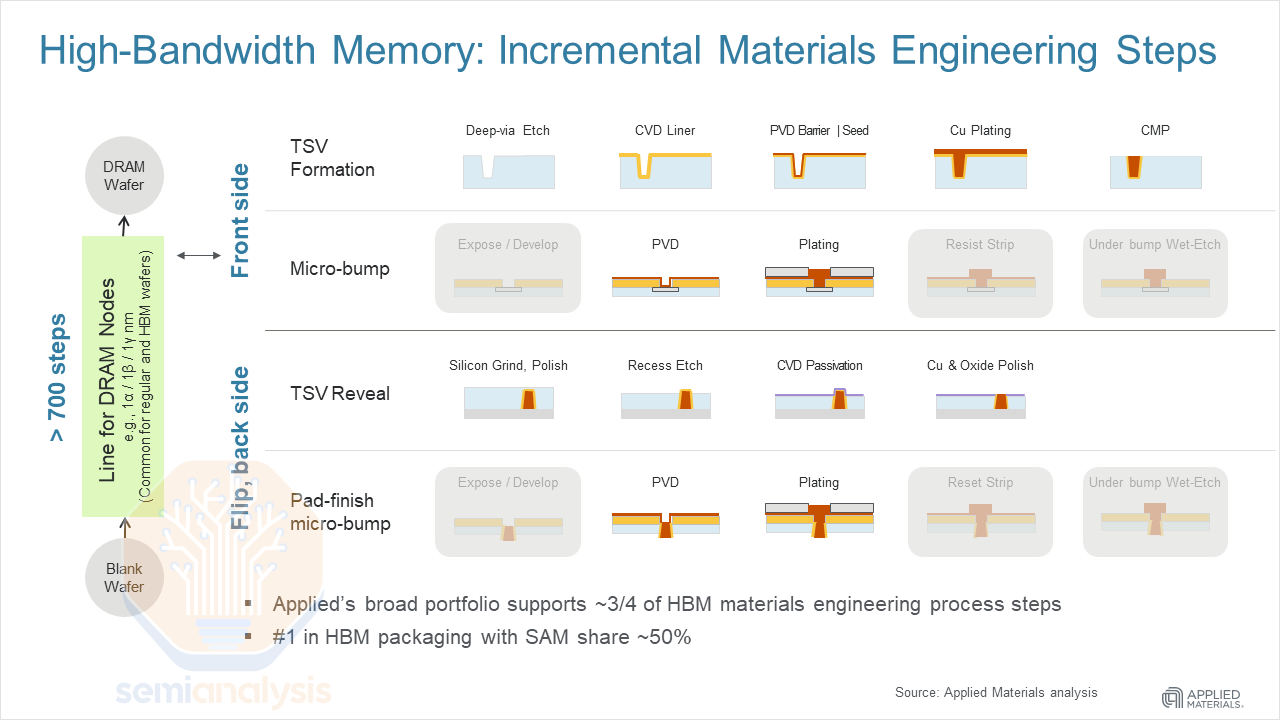
工艺流程:前道
当普通 DDR DRAM 产能“转换”为 HBM 产能时,主要变化是增加形成 TSV 的设备,以及更多的凸块(bumping)产能,因为 HBM 晶圆两面都要做凸块。这两个步骤都是为了实现 3D 堆叠;不过用于顶层裸片的晶圆不需要它们,只需单面凸块且无需 TSV。
TSV 需要刻蚀机来制作通孔,需要沉积和电镀设备来填充通孔。要露出 TSV,还需要研磨机、再一次刻蚀,以及用于贴合此工艺所用载片晶圆的临时键合机。这就是为什么 HBM 产能现在以 TSV 产能来衡量,因为这是把 DDR 晶圆变成 HBM 晶圆的主要增量工序。
凸块主要涉及沉积、电镀和去胶。此外,Camtek 和 Onto 的光学检测设备可用来检查凸块是否有缺陷、轮廓是否正确。
工艺流程:封装
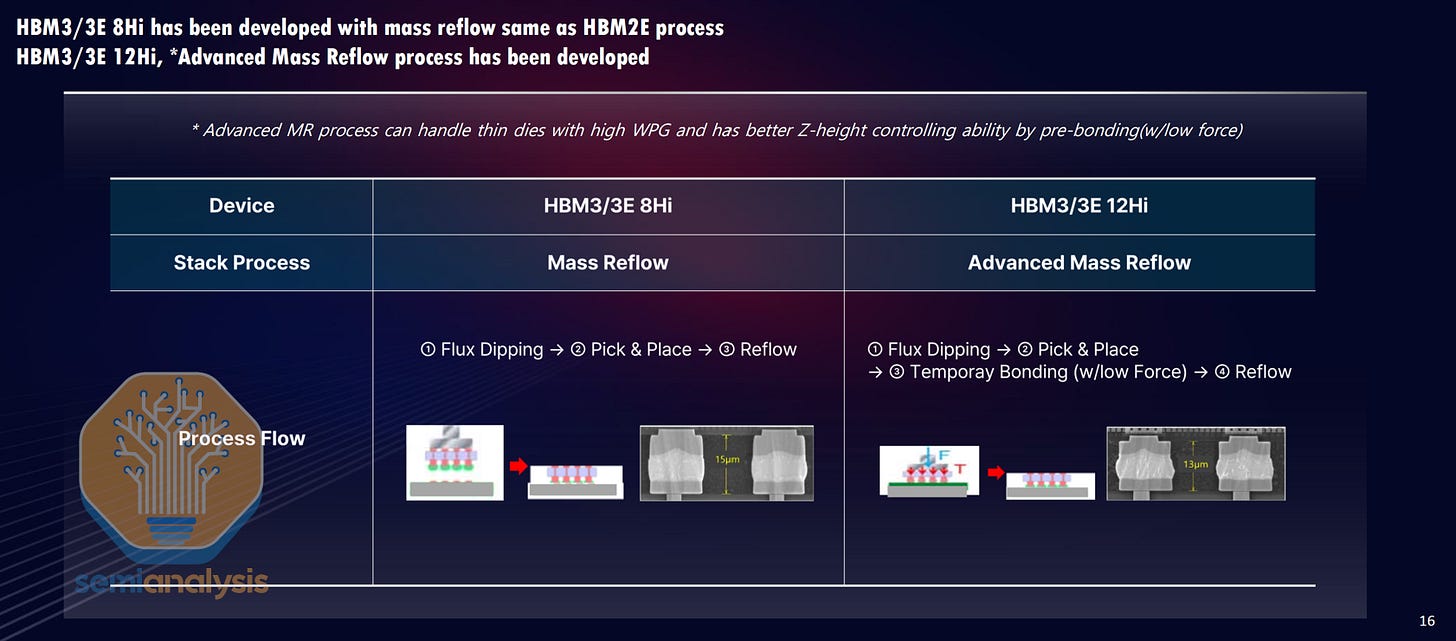
另一部分是后道封装,Hynix 继续推进 MR-MUF,我们此前已详细撰文介绍。简言之,MR-MUF 的生产效率更高,散热性能更好。Hynix 专有的(与 NAMICS 共同开发的)模塑底部填充材料,比 Micron 和三星使用的非导电膜(Non-Conductive Film)散热更好。Hynix 能够绕开热压键合(TCB),是因为他们找到了其他控制翘曲的办法。TCB 的好处之一是借助施加的力来稳定键合。
但另一方面,施力会增加损伤凸块的风险。由于凸块上承受应力,SK 还可以增加更多的虚设凸块(dummy bump),这同样有助于散热。
该工艺的生产效率也高得多。接合成形采用一次批量回流和一次整体模塑,而 TC-NCF 则需要为每一层都执行一次完整的 TCB 步骤来成形接合。
工艺流程:良率
HBM 在技术上比其他形态的 DRAM 更复杂,尤其是考虑到高层数的 3DIC 堆叠。因此,封装良率无法与厂商在更传统产品上习惯的水平相比。不过,前道的良率同样具有挑战性,我们认为良率问题更多出在前道。如前所述,HBM 对速度分档要求不高,那为什么会这样呢?
原因要追溯到 3DIC 组装和 TSV。挑战之一是供电网络(Power Distribution Network,PDN):TSV 需要能够把电力向上输送到整个堆栈。TSV 的布局与设计属于专有技术,也是各厂商之间的主要差异化领域之一。
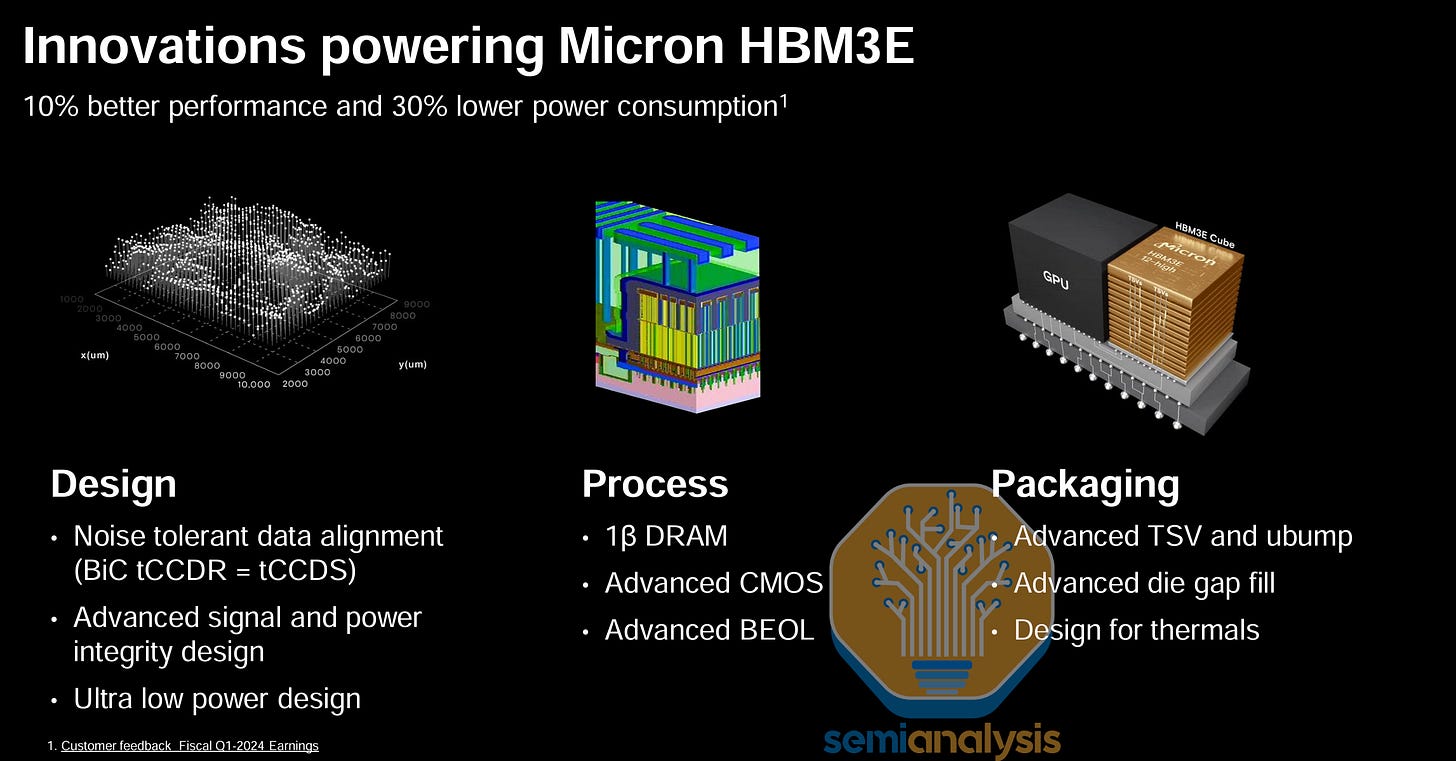
HBM 的关键挑战之一,是通过电源 TSV 向堆栈上层供电。刷新操作尤其耗电,因此供电网络的设计很重要。Hynix 的 HBM3E 缩小了外围区域,并在裸片上引入了环绕式电源 TSV,取代了两组电源 TSV,使 TSV 数量增加了近 6 倍。结果,SKH 实现了低得多的 IR 压降,VPP 最多降低 75%。
同样,Micron 在 HBM 技术上出人意料的后来居上(Micron 甚至从未提供过标准 HBM3),也源于其对 TSV 和供电网络的专注。TSV 网络似乎很可能是 Micron 能够宣称功耗降低 30% 的差异化所在,不过这一说法尚待验证。
另一件事是在功耗和散热限制内兑现承诺的速度。与任何 3DIC 组装一样,散热是个问题,而 DRAM 尤其怕热。超大规模云厂商的数据显示,HBM 故障是 GPU 故障的头号原因,而 GPU 的故障比数据中心里的其他芯片更频繁。
与传统内存晶圆相比,所有厂商的绝对良率都远低于他们习惯的水平,所以问题在于相对良率和最终的经济性。对 SK 和 Micron 来说,良率损失被高昂的定价完全抵消,因此 HBM 能增厚利润。三星的良率则更差。具有讽刺意味的是,他们的低良率收紧了 DRAM 晶圆的总供给,推高了价格。
这就引出了层数问题。层数越高越难实现。简单来说,如果单层的堆叠良率是 x%,那么每层良率会累乘,等于 x% 的 n 次方,n 为键合步骤数(即总层数减 1)。以 8 层堆栈、每层堆叠良率 99% 为例,总良率为 92%;12 层堆栈则降至 87%。当然,这过于简化了。层数越高良率下降越多,因为非关键的堆叠缺陷会累积。例如,少数几层上微小但可接受的非共面度,到更高层可能累积成不可接受的非共面度。
工艺流程:键合设备,SK Hynix 与 Hanmi 的纷争
键合(或称芯片贴装)步骤是影响良率的关键因素,因此需要精密的设备。TSV 间距约为 40 µm,键合机必须具备个位数微米甚至亚微米的对准精度。均匀的压力分布同样至关重要,以避免翘曲在多层之间累积放大。当然,吞吐量也很重要,因为它决定成本。
Hanmi 很早就押注于 HBM 的热压(TC)键合机,而这一细分市场当时被市场领导者 Besi 和 ASMPT 忽视。这一步带来了回报,使其在当前的 HBM 工艺中近乎垄断。在 SK Hynix,其份额在去年秋天之前一直是 100%,直到 Hynix 向 Hanwha 下了一笔使用竞争设备的大订单。据称,他们为这些设备付给 Hanwha 的价格更高。
这在 Hanmi 引发了轩然大波,他们心怀不满也是可以理解的:竞争对手以更高的价格拿下订单,而其设备尚未通过 Hynix 面向 Nvidia(最大也最重要的 HBM 客户)供应 HBM 的工艺认证。
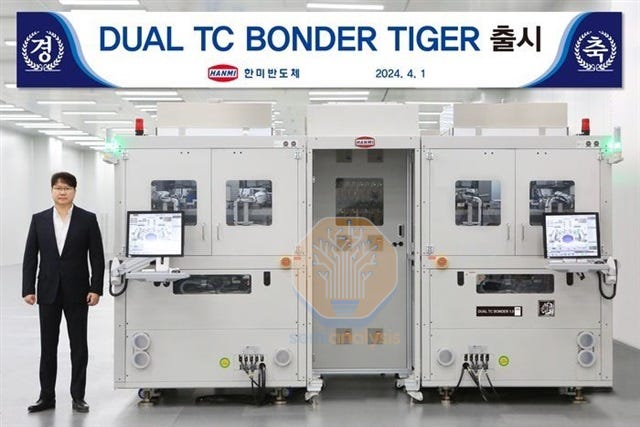
争端在 4 月初达到白热化,Hanmi 把现场服务团队撤出了 SK Hynix 的晶圆厂。没有服务,Hynix 在数月乃至数周内就将无法出货其旗舰产品。从长期看,这将威胁整个加速器供应链,因为 Micron 和三星无法迅速填补产能空缺。Hanwha 的设备尚未交付,而去年秋天订购的一批 ASMPT 键合机又不适用于 Hynix 的 HBM3E 12 层。这让晶圆厂几乎别无选择,只能向 Hanmi 低头求和。
在巨大压力下,SK Hynix 近几周向 Hanmi 下了一笔小订单。看起来这更多是为了安抚 Hanmi,而非大批量订单,但足以恢复设备的现场服务。Hanmi 凭借垄断地位恐怕已榨不出多少油水了,因为 ASMPT、Besi 等公司正竞相改进各自面向 HBM 的 TC 键合机。
中国:CXMT & 华为的 HBM
出口管制禁止将任何裸 HBM 堆栈转移到中国;不过,只要不超过 FLOPS 限制,搭载 HBM 的芯片仍可出口。目前,被禁的 HBM 仍通过一个涉及 CoAsia Electronics、Faraday 和 SPIL 的网络被再出口到中国,使中国的最终用户得以从 GPU 封装中拆焊并回收 HBM。
由于 HBM 是加速器的关键原料之一,而出口管制又有可能切断 HBM 供应,中国自然在国内研发上投入大量资源。中国计划在未来五年投入 2,000 亿美元补贴本土半导体,预计其中相当一部分会流向 HBM。国家级 DRAM 龙头 CXMT 正在积极扩大 HBM 产能,并囤积了大量设备以抵御更新的出口管制(美国在 2024 年 12 月加强了 HBM 管制,韩国则更近期跟进)。HBM2 8 层将于 2025 年上半年量产,年底前 TSV 产能将追平 Micron。
华为从来不放过任何一个高科技市场,它拥有自己的 HBM 关联企业:XMC(武汉新芯)生产 HBM 晶圆,SJSemi(盛合晶微半导体)负责封装。目前的产能处于R&D 规模,而非大批量,但计划在未来几年内提升。XMC 和 SJSemi 都已被列入实体清单,因此被限制购买含美国成分的设备(GlobalFoundries 最近因未经许可向 SJSemi 销售了超过 1,700 万美元的芯片,只受到了轻微处罚)。
HBM 堆栈层数:向高处攀登,要不要用混合键合?
HBM 堆栈层数越多,内存容量越大。每一代的层数都在增加。到目前为止,这一堆栈高度一直被控制在 720 微米高的立方体内(当前的 JEDEC 标准)。为了容纳更多层,每颗裸片(顶层裸片除外,它需要厚得多,以承受后续封装步骤中的搬运)都被做得更薄,裸片之间的凸块间隙也被做得更薄,以腾出更多空间容纳更多层。更薄的裸片越来越难处理,因此更容易翘曲和破裂,损害良率。
混合键合(Hybrid bonding,HB)用于 HBM 的主要好处是无凸块。消除凸块间隙,就为容纳更多 DRAM 核心层腾出了空间。这会带来一系列全新的良率和成本挑战,可能得不偿失,尤其是 HBM 并不需要混合键合所能提供的互连密度。如果说有什么的话,那就是厂商正在探索在混合键合中可以放宽多少焊盘密度,以降低键合精度要求,让这项技术对 HBM 更可行。HB 还能带来一次性的功耗和散热收益,但主要好处是堆栈高度。
HB 用于 HBM 一直是一项“下一代”技术,而且标准不断后移。对于 D2W 混合键合,即便只有 2 层,要把良率做到可接受也极其困难且昂贵。想象一下把这个问题扩展到 16 层乃至更高。内存厂商在混合键合技术开发上仍处于非常早期的阶段。以台积电的经验,HB 从采用到量产花了很长时间,即便在先进逻辑中性能收益更明确,采用也经历了漫长过程。
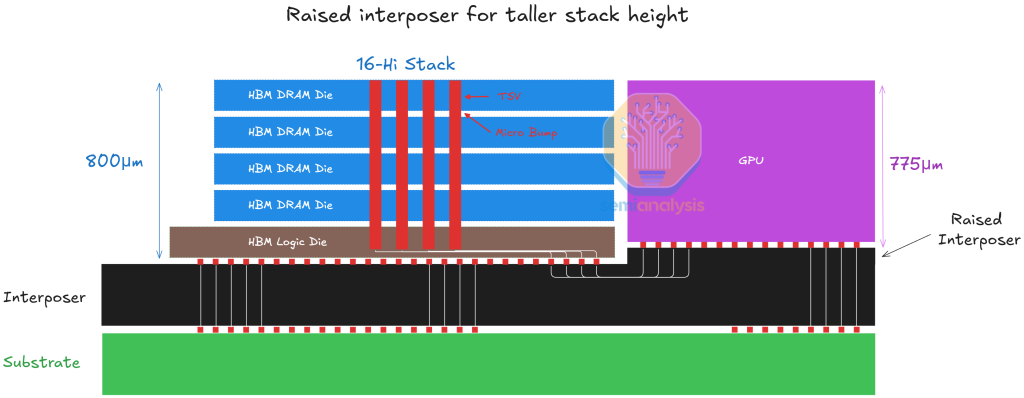
HBM3 和 HBM3E 已升至 12 层堆栈,采用基于凸块的互连时,12 层已逼近当前 720um 立方体厚度的极限。要继续增加层数,有两种办法:要么无凸块,要么把堆栈做得更高/更厚。对混合键合的采用而言是个打击,后者被选中了,JEDEC 确认将堆栈高度放宽到 775 um。
高度放宽还可以走得更远。775um 是硅晶圆的标准厚度。HBM 需要与同封装的逻辑裸片等高。要让堆栈高于 775 um,逻辑晶圆也得更厚,而现有设备并非为接受更厚的晶圆而设计。一个潜在的办法是抬高逻辑下方的中介层模塑,将其垫高,以确保与相邻 HBM 共面,但这会拉长走线,而且采用硅桥进行互连也并不容易。
尽管最初有更多关于在 HBM4 上实施 HB 的讨论,但这已被推迟到 4E。最近,Hynix 和 Micron 在 HB 的采用上都安静得多,而三星最为高调。这是三星的典型做法:为了追赶,经常鼓吹最激进的技术方案,结果不出所料地在执行上失败,导致落后得更远。
16 层问题已由更高的堆栈高度解决,而要达到 20 层及以上,很可能需要进一步缩小凸块间隙并进一步减薄晶圆,否则我们可能就停在 16 层。更高的堆栈可以带来更大的密度,而更多的堆栈则提供带宽和密度。
吞吐量优先:I/O 是 AI 加速器的生命线
AI 加速器的关键特征是高度并行,并针对吞吐量进行优化。加速器的设计目标,是通过牺牲单个运算的复杂度,来最大化每秒可执行的运算总数。大多数加速器专注于通用矩阵乘法(GEMM)中的乘法和加法运算,这类运算主导了 AI 训练和推理工作负载。相比之下,CPU 同样关注每秒能执行多少指令,但 CPU 核心要“聪明”得多,需要多得多的电路和面积。因此它们被设计用来执行范围更广、更复杂的任务,但吞吐量低得多。
这意味着 AI 加速器需要大量的片外带宽,用于内存以及纵向扩展(scale up)和横向扩展(scale out)网络。带宽既要把处理完的数据搬出芯片,又要为加速器单元送入更多待处理的数据。如果带宽不足,XPU 的计算单元就会闲置,使这些并行算力失去意义。我们先从内存需求说起
内存含量上升
为了提供更高的性能,随 FLOPs 一同提升内存容量和带宽至关重要,这在各家加速器路线图中一目了然。容量和带宽在 3 个维度上扩展:
- 新一代 HBM 通过更快的信号速率和更致密的核心裸片提供更高带宽
- 增加每个堆栈的层数以提升容量。12 层 HBM 即将成为主流配置
- 每个封装增加更多 HBM 堆栈,带来更多带宽和容量
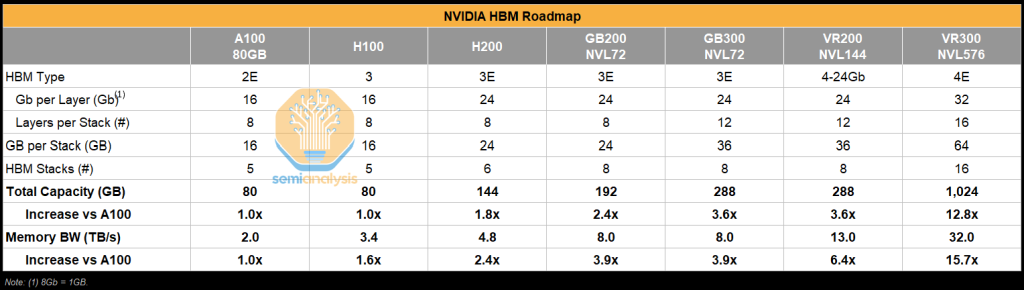
从 Nvidia 的路线图中可以看到这一点。HBM 容量从 A100 的 80 GB HBM2E,激增到 Rubin Ultra 的 1024 GB HBM4E。单芯片的内存带宽同样大幅提升。从 Ampere 到 Blackwell Ultra,物料清单中绝对值和相对值增幅最大的部分都来自额外的 HBM 含量,这让内存厂商(主要是 SK Hynix)受益。
这也与非内存 I/O 的需求有关。在单个内存一致性域中纵向扩展更多 GPU,可提供更大的聚合内存容量和带宽。这使得更大参数量模型的推理得以扩展,也能支持推理模型和复杂工作负载中日益普遍的更长上下文长度。
正如帕金森定律指出工作会膨胀到占满所有可用时间,现代 AI 也遵循一种“内存版帕金森”规律:神经网络架构会不断膨胀,占满所有可用的 HBM。HBM 容量和吞吐量每上一个台阶,无论是 H100 的 3 TB/s 下 80 GB,还是 GB200 的 8 TB/s 下 192 GB,都会很快促使设计者增加参数量、上下文长度和 KVCache 占用,抵消几个月前看似充裕的余量。曾经用来把模型塞进紧张预算的技术(激活检查点、优化器卸载、权重量化),一旦有了新的 HBM 空间就被放宽,直到再次撞上内存墙,才又不得不重新发掘各种提效手段。实际上,仅仅有更大更快的 HBM 并不能带来持续的宽裕;相反,它重置了“合理”模型规模的基线,确保容量和带宽尽管硅技术不断进步,仍然是限制因素。本质上,AI 芯片的 HBM 越多,开发者就立刻构建更大的模型去填满它,所以内存永远是下一个瓶颈。下面我们来看看 HBM 是如何被使用的,压力又在哪里。
推理中的 HBM 使用
在 LLM 推理中,所有模型权重都常驻封装内的 HBM,这样 GPU 可以毫无延迟地读取。除权重外,HBM 还存放 KVcache。每当模型被要求生成下一个 token,GPU 首先从 HBM 读取权重,同时取回整个 KV 缓存,以便在自注意力阶段将新 token 与对话历史进行比较。计算完成后,GPU 会把新生成 token 的新键(key)和值(value)追加写回 HBM,使缓存增大。这对带宽的要求非常高,因为每一步 token 解码都要反复读取静态权重和不断增长的 KV 缓存。如果内存带宽无法以每秒数 TB 的速度搬运这些数据,GPU 等待内存的时间就会多于计算的时间。现实中正是如此,因为带宽远远压过了 token 解码的计算强度,使大多数 LLM 推理工作负载受限于内存带宽而非计算。
随着模型的进步,它们的任务时程(horizon length)不断增加。这意味着模型能够更长时间地思考、规划和行动。这一增长速度是指数级的,并且已经体现在更优秀的产品中。例如,OpenAI 的 Deep Research 一次可以思考数十分钟,而 GPT-4 只能撑几十秒。
由于模型现在可以长时间思考和推理,上下文长度经常超过数十万 token,内存容量的压力急剧上升。尽管近期的进展减少了每个 token 产生的 KVCache 量,内存约束仍然快速增长。应对办法之一是用更低的批大小来服务推理模型,但这会损害经济性。
AI 进步的主要驱动力是强化学习(RL),而 RL 范式的很大一部分是推理。举例来说,RL 通常需要满足严格要求的合成数据,这意味着要进行大量 GPU 小时的推理来生成数据,之后再由另一个模型过滤。另一个重推理负载的例子,是针对创意写作这类难以验证的任务做 RL。与可以轻松检查和验证的代码不同,创意写作、法律工作和教学这类任务无法被简单验证。绕过这一点、从而获得用来强化和改进模型的信号的办法,是让另一个模型来评判答案。这个 LLM 评委(LLM-as-a-judge)会得到一份评分标准(rubric),目前由人工编写,但很快将由 LLM 自动生成,并据此给答案打分。
KVCache 卸载
有各种算法或部署上的改进,旨在缓解稀缺 HBM 的压力。一种技术是将 KVCache 卸载到更便宜、更易获得的内存层级,例如常规 DDR,甚至存储。
如今,KVCache 卸载已经被普遍使用。Nvidia 为此提供了一个名为 Dynamo Distributed KVCache Manager 的框架。从概念上讲,这与通用 CPU 中的多级内存并无太大不同:速度极快但密度低的 L1/2/3 缓存,以及较慢但密度高的 DRAM。在 AI 系统中,KV 存放在哪里是根据使用频率来管理的。一个优化良好的系统会把当前正在使用的所有 KV 放在 HBM,不常用的 KV 放在 DDR,极少使用的 KV 放在 NVMe。
就像 DRAM 不会蚕食 CPU 对 L1/L2/L3 缓存的需求一样,HBM 与 DDR/SSD 卸载之间也不直接竞争。事实上,对大多数现代 LLM 工作负载而言,预填充速度(即 KVCache 的产生速率)通常慢于向 DDR 或 NVMe SSD 的传输速率,这意味着 KV 很少会整个“常驻 HBM”。它们被产生出来后,或被逐出,或被发送到解码节点用于生成下一个 token。留在 HBM 中的,主要是每个用户都会用到的系统提示词,以及其他热点 KV,例如活跃序列窗口和一些预取缓冲区。
至于使用 DDR 还是 NVMe,取决于工作负载的需求和规模。还取决于工作负载的轮换频率,因为频繁轮换的 KV 不适合写入/重写耐受度有限的 NAND。如今,智能体用例通过工具调用,以极低延迟和高循环率拉取文档和数据,进一步把缓存从 NVMe 推向 DDR。这些是需要权衡的架构和用户体验取舍,而不是彼此的直接替代品。
随着用例的演进,不同的推理需求可能会采用不同的硬件配置。例如,查询固定的代码库或文档时,若能为每个 GPU 上的每个用户访问更大量的 KVCache,将会受益,因为这类用户行为的内存需求相比普通聊天要高得多。
预训练中的 HBM
对于传统预训练,GPU 完成一次前向加反向步骤所需的一切都要经过 HBM。首先,模型权重存放在 HBM 中,因此每一层在对一批数据做前向计算时都能快速读取。每一层处理这批数据时,会把中间激活写入 HBM,以便之后使用。前向传播结束、损失算出后,反向传播开始:GPU 重新访问这些存储的激活和权重,从 HBM 读取它们以计算梯度。得到的权重梯度,以及任何辅助的优化器统计量(例如 Adam 中的动量或方差项),也会写入 HBM。最后,优化器从 HBM 读取这些梯度和统计量,就地更新权重,为下一次迭代做好准备。不过,训练操作相对数据传输需要更多计算,这意味着训练更常受限于计算。但如上所述,RL 现在是提升模型能力的关键,所以传统上由预训练实现的东西,正越来越像强化学习形式的推理。
本文其余部分将讨论 OpenAI 的 ASIC 项目、海岸线面积挑战、HBM4 即将迎来的变革性变化(即 HBM 采用定制基底裸片)、PHY 的优势、内存控制器卸载、中继器 PHY、LPDDR + HBM 组合,以及各种滩头扩展技术。还将讨论 SRAM、存内计算、供应链影响,以及三星的困境。