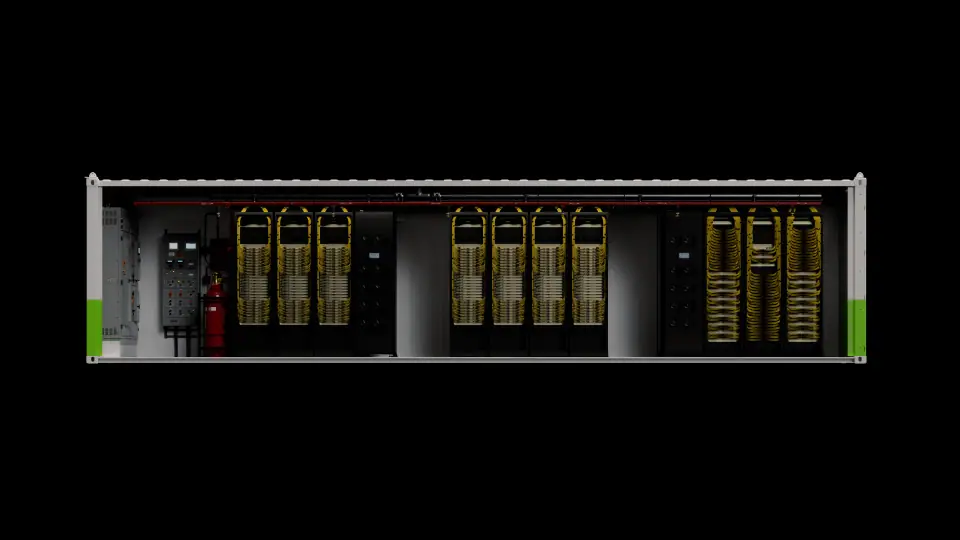
AI 工厂将能源转化为智能。但在 AI 工作负载能够生成第一个 token 之前,运营者必须将计算、网络、存储、电力、冷却和软件组成的互连系统作为一个生产单元上线。
在传统数据中心建设中,团队必须首先选择场地,为部署设计电力和冷却,规划数据中心布局,并规划和安装机架与线缆。然后他们可以逐步验证网络和集群,并使服务上线。这项工作需要协调的专业劳动力,在安装、基础设施就绪和系统测试之间存在关键依赖关系。延迟可能会推迟启动以及基础设施开始生成 token 的日期。
NVIDIA DSX POD 将更多此类工作转移到受控的工厂环境中。作为 NVIDIA DSX AI Factory Platform 支持的多种 AI 工厂实施模型之一,NVIDIA DSX POD 参考设计是标准化、工厂构建的实施方式。它使合作伙伴能够构建标准化容器,预集成 AI 基础设施,在发货前完成关键验证,并在交付后连接到准备好的站点基础设施。其结果是一种可重复的方法,旨在降低现场集成的复杂性,帮助运营者更快、更可预测地达到生产性 AI 容量。
本文介绍了 NVIDIA DSX POD 的基础、该参考设计如何与 NVIDIA Vera Rubin 平台 对齐,以及 NVIDIA 及其生态系统合作伙伴如何通过产品工程、部署和支持开展工作。
将 AI 工厂集成向上游转移的设计基础
模块化和预制数据中心已经存在。AI 工厂的工程挑战远不止于将传统 IT 设备放入外壳中。
机架级 AI 系统结合了高密度计算、高速 scale-up 和 scale-out 网络、液冷、电力输送、遥测和管理软件。这些元素作为一个系统运行。它们的机械、电气、热和网络要求必须在工厂集成、运输、安装和运行期间保持在规格范围内。
NVIDIA DSX POD 为合作伙伴提供了设计基础,以便在工厂将机架级系统安装到容器中,对集成单元进行功能测试,运输它,并通过目的地可重复的流程安全上线。NVIDIA 的投资涵盖了实现这一目标所需的工程学科,包括机架布局、结构负载、电力、冷却、布线、服务访问、可靠性和验证。
这项工作扩展了向更高工厂集成度发展的进程,以降低安装复杂性并加速部署。NVIDIA 已从芯片和板卡发展到完整的机架级系统,以及像 NVIDIA DGX SuperPOD 这样的大规模参考架构。
NVIDIA DSX POD 将这种方法带入工厂构建的 AI 工厂实施中,将大部分组件集成从客户站点转移到受控的制造环境。该参考设计并不强制要求每个 AI 工厂都采用容器化。传统数据中心建设和现场集成设计仍然是重要的选项。NVIDIA DSX POD 为大规模部署增加了一条标准化路径,在这些部署中,进度可预测性、可重复性和减少现场工作是优先事项。
与 NVIDIA Vera Rubin 平台对齐的架构
NVIDIA DSX 是协同设计 AI 基础设施的广泛设计框架。它在数据中心层面将计算、网络、存储、电力、冷却、设施控制和软件结合在一起。客户和合作伙伴可以以不同的物理形式实施该框架。
NVIDIA DSX POD 是这一更广泛设计的具体实现:一个标准化的 AI 工厂架构,由工厂构建的容器类型及其之间定义的接口组成。该架构围绕 NVIDIA Vera Rubin 平台及其机架级系统设计。
该参考设计描述了一个完整的 AI 工厂,而不是孤立的计算外壳。它考虑了计算、服务和管理功能、scale-out 网络、存储、电力、冷却、布线和其他支持基础设施。
工厂集成部署的技术要求
NVIDIA DSX POD 参考设计的核心目的是使整个部署过程可重复。这需要在以下领域协调需求:计算集成、网络和存储、布线和控制、电力输送、液冷以及机械设计和运输。
计算集成
NVIDIA DSX POD 计算容器专为 NVIDIA Vera Rubin 机架级基础设施设计。该设计定义了计算和支持机架如何在外壳内安装,以及合作伙伴如何处理结构支撑、重量分布、设备约束、服务间隙、气流和液冷访问、机架级电力和网络连接。
工厂集成还改变了验证边界。合作伙伴不再将每个机架视为独立发货并在现场组装成集群,而是将安装的计算环境作为一个部署单元进行验证。验证计划可以涵盖机架清单、固件和配置基线、上电检查、fabric 连接、传感器操作、冷却完整性和系统级功能测试,在容器离开工厂之前完成。
网络和存储
AI 工作负载依赖于模型数据、训练数据、检查点数据和推理上下文在 AI 工厂中的可预测移动。因此,该参考设计将网络和存储视为系统架构的一部分,而不是在计算到达后进行的站点特定添加。
该设计定义了计算容器内部、容器之间以及从模块化系统到客户外部网络所需的连接。它考虑了横向扩展 fabric、服务和管理网络、光纤入口点、主干布线、电缆走线、标签、弯曲半径、服务访问,以及发货前对工厂安装链路的验证。
存储需求遵循同样的原则。该架构定义了所需的容量、性能、连接性、管理和服务特性,同时允许最终设备实现反映部署规模和合作伙伴解决方案。这使得存储和网络能够作为 AI 工厂的协调组成部分一起到达,而不是必须在现场集成后期才进行协调的独立系统。
布线和控制
NVIDIA DSX POD 减少了机架级部署中现场布线的工作量,在切实可行的情况下将机架间网络布线、电源接线、控制接线和传感器集成转移到工厂中完成。
该参考设计清晰定义了电缆路径、隔离要求、端接点、标签规范、测试程序和服务性要求,以帮助合作伙伴在受控条件下轻松安装和测试这些连接,从而减少交付后所需的现场端接数量。
供电
DSX POD 通过标准的 800 VDC 输入电源设计使供电无缝衔接,该设计从核心容器的电气输入开始,贯穿保护、配电、接地、机架连接、控制和遥测。该参考设计定义了已安装 AI 基础设施所需的电源特性和接口。随后,合作伙伴为客户站点设计上游发电、转换和区域电气解决方案。
这种分离很重要,因为公用事业条件、法规、设备可用性和电网架构因地区而异。容器边界的通用接口使核心设计可重复,同时保留了生态系统合作伙伴为每个部署提供电力的方式上的灵活性。
NVIDIA 软件可以通过帮助操作员在可用功率限制内管理工作负载来补充物理设计。策略驱动的功率控制、工作负载编排和高保真遥测可以帮助 AI 工厂将固定的功率包络转化为更具生产力的计算。
液冷
Vera Rubin 机架级系统需要协调的液冷基础设施。在容器内部,该设计涵盖了将机架连接到容器冷却接口的管道,包括走线、歧管、隔离、仪表、泄漏检测、压力完整性和服务访问。
合作伙伴可以在工厂组装、冲洗、压力测试和验证内部冷却回路。在现场,他们将容器连接到准备好的水和排热基础设施,调试完整回路,并在运行条件下验证性能。
NVIDIA DSX POD 改变了集成发生的位置。它并不消除配套设施基础设施。
机械设计与运输
运输已安装在机柜中的高价值机架级系统需要一种将物流视为工程要求的设计。容器结构、设备约束、重量分布、重心、起吊和搬运点、访问路径以及运输条件必须协同工作。
该参考设计还将运输要求与工厂质量关口联系起来。合作伙伴在发货前检查集成单元,记录其配置和测试状态,确保其运输安全,并在到达后重复既定检查。此流程有助于确认交付到现场的系统与在工厂验证的系统一致。
并行化工厂集成与现场准备
工厂建造模式改变了部署顺序。现场团队可以准备土地、地基、电力和外部连接,同时合作伙伴并行制造和集成容器。
在工厂,合作伙伴安装机架级系统,完成内部布线和管道,集成控制,加载批准的配置基线,并运行功能测试。在部署现场,施工团队准备容器所需的物理和公用事业接口。
交付后,工作重点放在放置、容器间连接以及连接到外部电力、冷却和网络。然后团队确认运输完整性,验证现场连接,并完成系统调试。
这种模式并不消除现场工作。它减少了在现场执行的复杂、可重复的集成工作量,并将其转移到一个为一致的工具、质量控制和并行生产而设计的环境中。
使用标准化部署单元进行扩展
标准化的容器架构为操作员提供了一个可重复的单元,用于规划和扩展。在准备好配套站点基础设施后,操作员可以使用相同的定义接口和验证流程添加计算和配套容量。
标准化还为软件优化创建了一致的基础。当底层计算、网络、电力、冷却和遥测架构已知时,该环境的软件和操作实践可以轻松调整。合作伙伴仍然可以根据当地法规、现场条件、客户需求和区域供应链调整每个实现。
这种平衡是 NVIDIA DSX POD 的核心。参考设计提供了可复用的 NVIDIA 工程和验证。生态系统提供制造能力、现场专业知识、区域工程、定制、部署、服务和支持。
合作伙伴主导的交付模式
NVIDIA 提供经过验证的 AI 基础设施设计基础,并与生态系统合作,证明机架级系统可以作为可重复的工厂制造单元进行集成、测试、运输和部署。
OEM 和 ODM 集成计算系统。机械、电气、管道和基础设施专家根据现场情况调整电力和冷却。模块化解决方案提供商制造外壳并集成子系统。现场合作伙伴准备场地、完成安装并支持调试。这些合作伙伴共同将参考设计转变为客户特定的 AI 工厂。
该模式扩展了模块化数据中心市场,而不是取代现有产品。合作伙伴可以继续提供不同级别的集成,从客户在现场填充的模块化基础设施到完全工厂集成的部署。NVIDIA DSX POD 为生态系统提供了后者的经过验证的路径,同时在实施和服务方面保留了差异化的空间。
了解有关 NVIDIA DSX POD 的更多信息
AI 工厂的价值始于基础设施开始产出 token 之时。通过将可重复的集成和验证转移到工厂,NVIDIA DSX POD 旨在减少构建后期的进度风险,简化现场工作,并使部署更加可预测。
该参考设计将 NVIDIA Vera Rubin 计算、网络、存储、电力、冷却、布线、控制和验证整合到一个协调的架构中。NVIDIA DSX POD 提供工程基础。合作伙伴构建、定制、交付并支持由此产生的解决方案。
进一步了解 NVIDIA DSX POD 参考设计如何帮助将可用土地、电力和准备好的现场基础设施更快、更可预测地转化为生产性 AI 容量。