NVIDIA DSX AI Factory Platform 汇集了多种技术,帮助生态系统设计、构建和运营更高效的 AI 工厂,其中包括为支持多租户运营和扩展而构建的开源、模块化软件组件。
运营 AI 工厂需要对分布式工作负载有共同的理解:它们的组件、pod 模板、副本数量和状态。在 Kubernetes 上,每个框架对这些信息的编码方式各不相同。JobSet、LeaderWorkerSet 和其他自定义资源通常需要单独的适配器,工具才能解释和管理它们。
NVIDIA Workload Map 提供了 Kubernetes 工作负载结构的通用描述,用户可以在不同框架之间复用。作为 NVIDIA DSX AI Factory Platform 的一部分,Workload Map 使集成的调度器、控制器和平台能够解释支持的工作负载类型,而无需维护单独的框架特定解析代码。
本文展示如何一次性描述分布式 JobSet 工作负载,然后复用该定义进行工作负载检查、gang 调度和平台可见性。
为什么每种工作负载类型都需要自己的适配器
在 Kubernetes 上,真实的工作负载很少是单个 pod。分布式训练作业或多节点推理服务器是一棵小型资源树:pod 组,每组都有角色、副本数量、pod 模板,以及取决于工作负载类型的状态。
构建调度器、控制器、仪表板或成本工具且必须跨这些工作负载工作的团队会立即遇到这个问题。NVIDIA Run:ai 团队在创建其平台时也面临同样的挑战。对于每个新的自定义资源定义(CRD),开发人员都要在代码中回答相同的问题:
- 工作负载类型的结构是什么?
- 如何将资源的状态解释为一个阶段?
- 如何在不破坏工作负载的情况下修改 pod spec?
开发人员为每种工作负载类型回答一次这些问题,并生成一个针对每个 CRD 的适配器。客户带来的每个新框架都需要另一个适配器。这使得适配器开发成为每个框架的路线图项目,而不是一次性成本,这就是为什么对新工作负载类型的支持往往要等待一个版本。
以下清单展示了用户提交时的分布式训练作业:一个 JobSet,包含一个 leader Job 和两个 worker Job,每个都有一个请求四块 GPU 的 pod。
apiVersion: jobset.x-k8s.io/v1alpha2
kind: JobSet
metadata:
  name: demo
spec:
  replicatedJobs:
    - name: leader
      replicas: 1
      template:
        spec:
          parallelism: 1
          completions: 1

          template:
            spec:
              containers:
                - name: leader
                  image: ghcr.io/example/trainer:latest
                  resources:
                    limits:
                      nvidia.com/gpu: 4
    - name: worker
      replicas: 2
      template:
        spec:
          parallelism: 1
          completions: 1

          template:
            spec:
              containers:
                - name: worker
                  image: ghcr.io/example/trainer:latest
                  resources:
                    limits:
                      nvidia.com/gpu: 4
该清单描述了一个 leader、两个 worker,以及总共 12 块 GPU 的请求。解释该结构需要 JobSet 感知的代码;kubectl 会分别列出这些资源。
图 1。 kubectl 将演示 JobSet、它的三个 Job 及其 pod 列为单独的资源条目
$ kubectl get jobset,jobs,pods
NAME                      TERMINALSTATE   RESTARTS   COMPLETED   SUSPENDED   AGE
jobset.jobset.x-k8s.io/demo               0                                  3m46s

NAME                      STATUS   COMPLETIONS   DURATION   AGE
job.batch/demo-leader-0   Running  0/1           3m46s     3m46s
job.batch/demo-worker-0   Running  0/1           3m46s     3m46s
job.batch/demo-worker-1   Running  0/1           3m46s     3m46s

NAME                          READY   STATUS    RESTARTS   AGE
pod/demo-leader-0-0-ksb4l     1/1     Running   0          3m47s
pod/demo-worker-0-0-qv955     1/1     Running   0          3m47s
pod/demo-worker-1-0-5smfn     1/1     Running   0          3m47s
Owner reference 将 Job 连接到它们的 JobSet,但平台仍然需要一个定义来解释它们的角色并聚合资源请求。
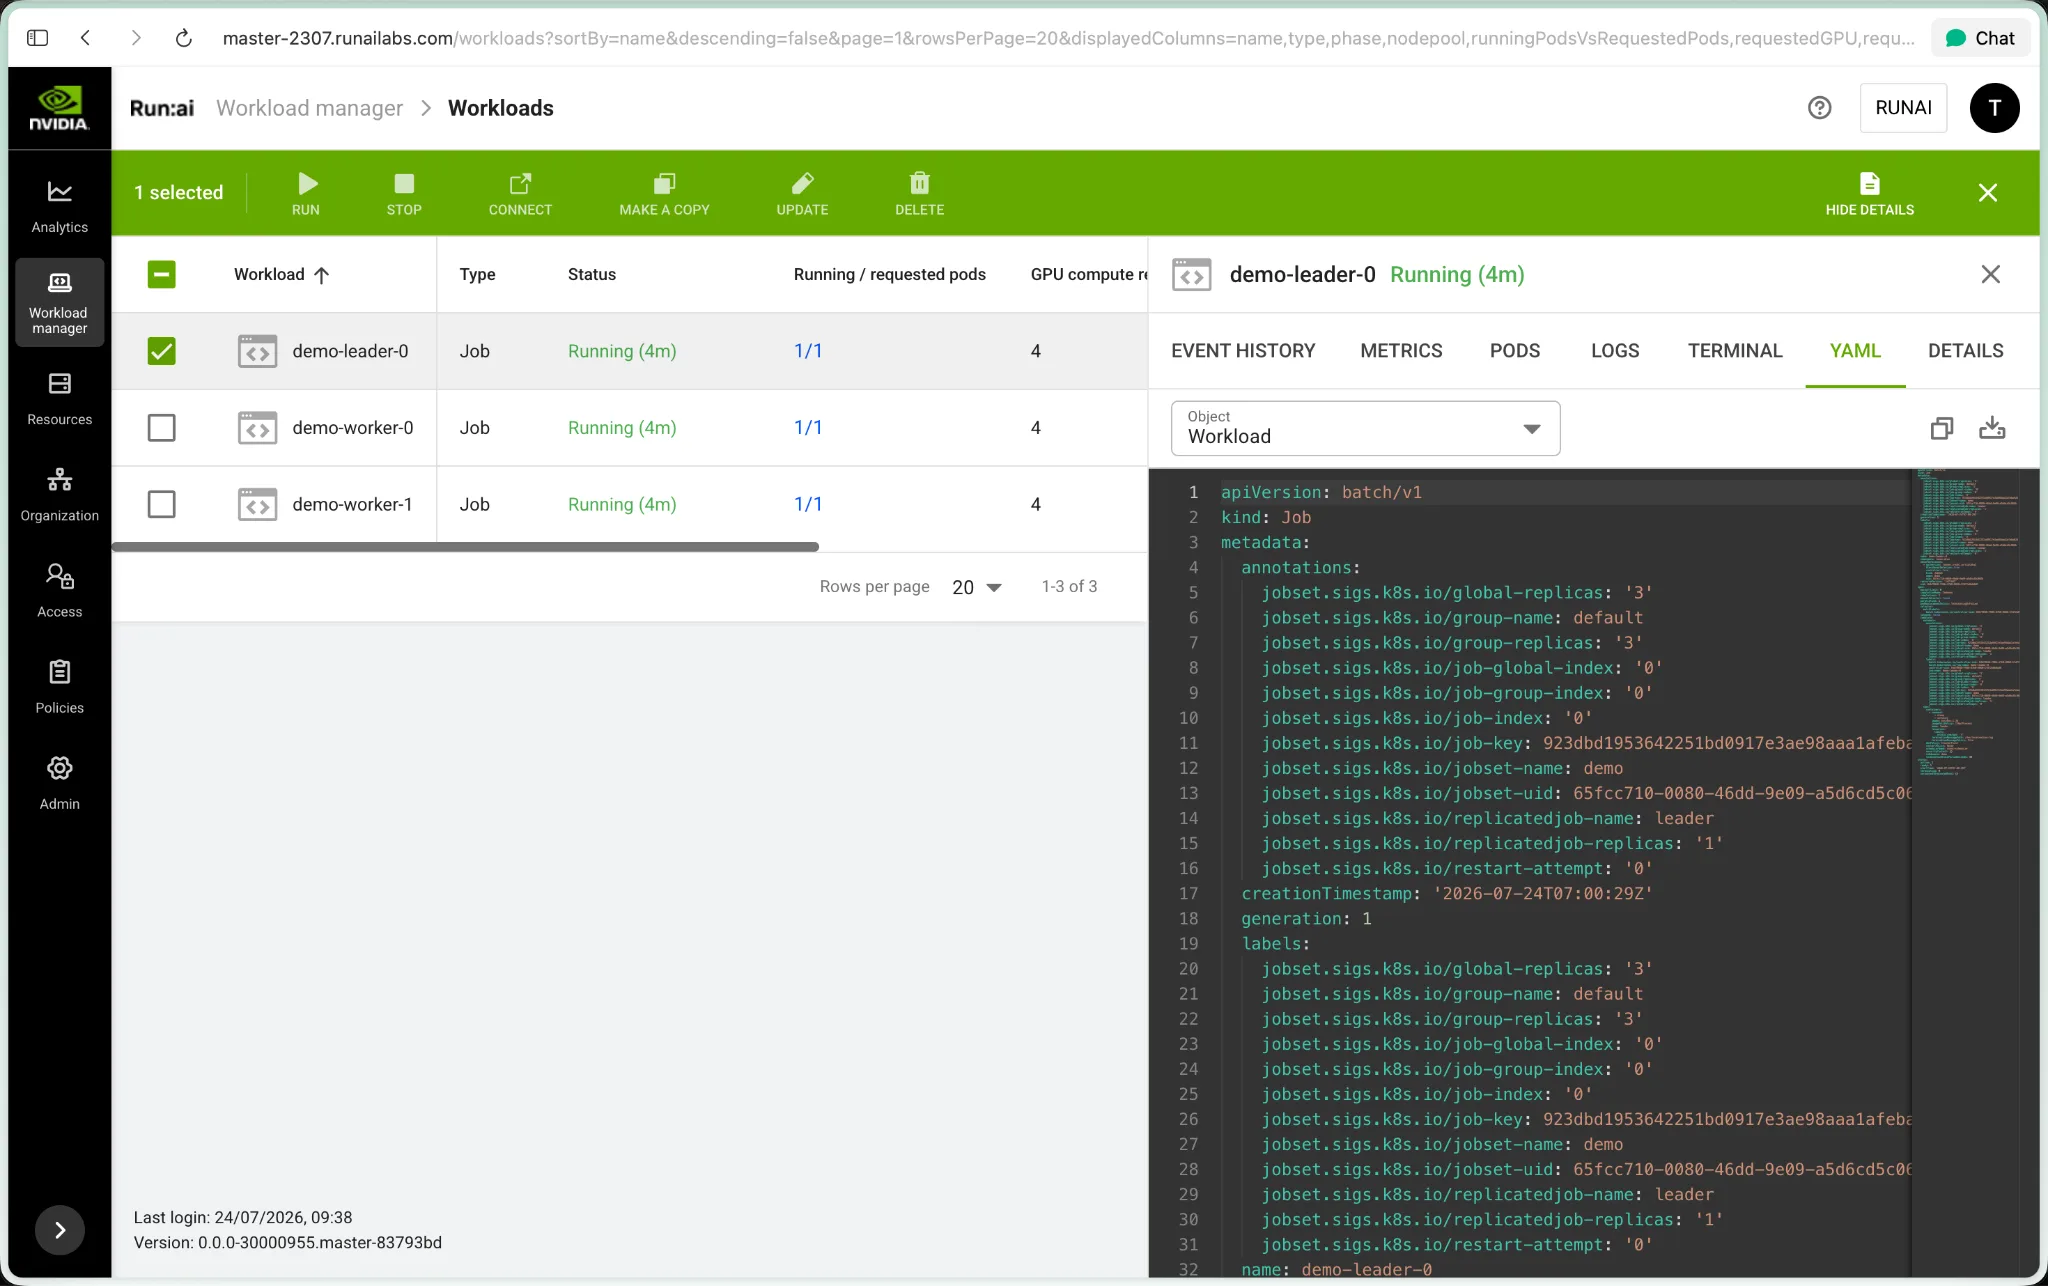
如果没有共享的工作负载描述,用户必须自己重建工作负载并汇总其 GPU 请求。
Kubernetes 工作负载结构的通用描述
Workload Map(原名 Karta;该 CRD 的资源 kind 仍为 Karta)以 Kubernetes CRD 加一个解释工作负载定义的 Go 库的形式提供。每个定义指定了在哪里找到其工作负载类型的 pod 模板、副本数量和状态字段。
Workload Map 为调度和平台消费者提供共享的结构视图。KAI Scheduler 使用其定义来解释 pod 分组和 gang 调度指令,而 NVIDIA Run:ai 使用它们进行工作负载管理和可见性。每个消费者都基于相同的描述进行操作,减少了对单独的框架特定解析器的需求。
Go 库将活动对象解析为统一的结构视图。有了工作负载定义,消费者可以:
- 提取 pod 模板、副本数量、状态和元数据。
- 跨每个实例更新 pod spec、标签和注解。
- 理解工作负载层次结构,例如,JobSet 的复制 Job 及其 pod。
Workload Map 包含一个 catalog,其中包含针对 JobSet、PyTorchJob、RayCluster、RayJob、RayService、KServe、Knative、MPIJob、NVIDIA NIM、LeaderWorkerSet、Milvus、Grove PodCliqueSet 和 NVIDIA Dynamo 的预构建、经过测试的定义。可以通过编写描述其结构和状态的 YAML 定义来添加其他工作负载类型。
关键在于,工作负载知识从编译的适配器转移到开发人员可以编写、审查并像任何其他清单一样应用到集群的数据中。本文的其余部分描述了 JobSet 示例,然后展示了相同的定义如何支持工作负载检查、gang 调度和平台可见性。
为 JobSet 编写工作负载定义
以 Workload Map 资源表示的工作负载定义描述了这种形态。以下摘录展示了 JobSet 定义的关键部分。完整版本随 repository 提供。
根组件定义了工作负载自身的 kind 以及如何读取其状态。
apiVersion: run.ai/v1alpha1
kind: Karta
spec:
  structureDefinition:
    rootComponent:
      name: jobset
      kind:
        group: jobset.x-k8s.io
        version: v1alpha2
        kind: JobSet
      statusDefinition:
        conditionsDefinition:
          path: .status.conditions
        statusMappings:
          running:
          - byExpression:
              expression: "(.status.replicatedJobsStatus // []) | any(.ready > 0 and .active > 0) and all(.failed == 0)"
              expectedResult: "true"
          completed:
          - byConditions:
            - type: Completed
              status: "True"
          failed:
          - byConditions:
            - type: Failed
              status: "True"
statusMappings 是转换层。JobSet 不报告简单的“Running”条件,因此该定义通过 replicatedJobsStatus 上的 jq 表达式(任何 Job 就绪且活跃,没有失败)推导出它,并将原生的 Completed 和 Failed 条件映射到消费者已经使用的共享词汇表上。当描述 RayJob 或 LeaderWorkerSet 时,其非常不同的状态会映射到相同的类别。
下一个摘录定义了子组件:工作负载内部的结构。
    childComponents:
    - name: replicatedjob
      kind: { group: batch, version: v1, kind: Job }
      ownerRef: jobset
      specDefinition:
        podTemplateSpecPath: .spec.replicatedJobs[].template.spec.template
      scaleDefinition:
        replicasPath: .spec.replicatedJobs[] | .replicas * .template.spec.parallelism
      instanceIdPath: .spec.replicatedJobs[].name
JobSet 将其角色声明为一个列表,因此 .spec.replicatedJobs 为每个角色保留一个条目。这些路径中的 [] 表示“对该列表中的每个条目”,而每个条目就是 Workload Map 所称的一个实例。podTemplateSpecPath 指向每个 Job 的 pod 模板。scaleDefinition 使用 jq:每个复制 Job 的 pod 数量等于 replicas 乘以 parallelism,这就是示例清单显式设置 parallelism 的原因。instanceIdPath 从 .spec.replicatedJobs[].name 获取每个实例的名称,这就是“leader”和“worker”作为不同角色出现、而不是三个匿名 Job 的原因。
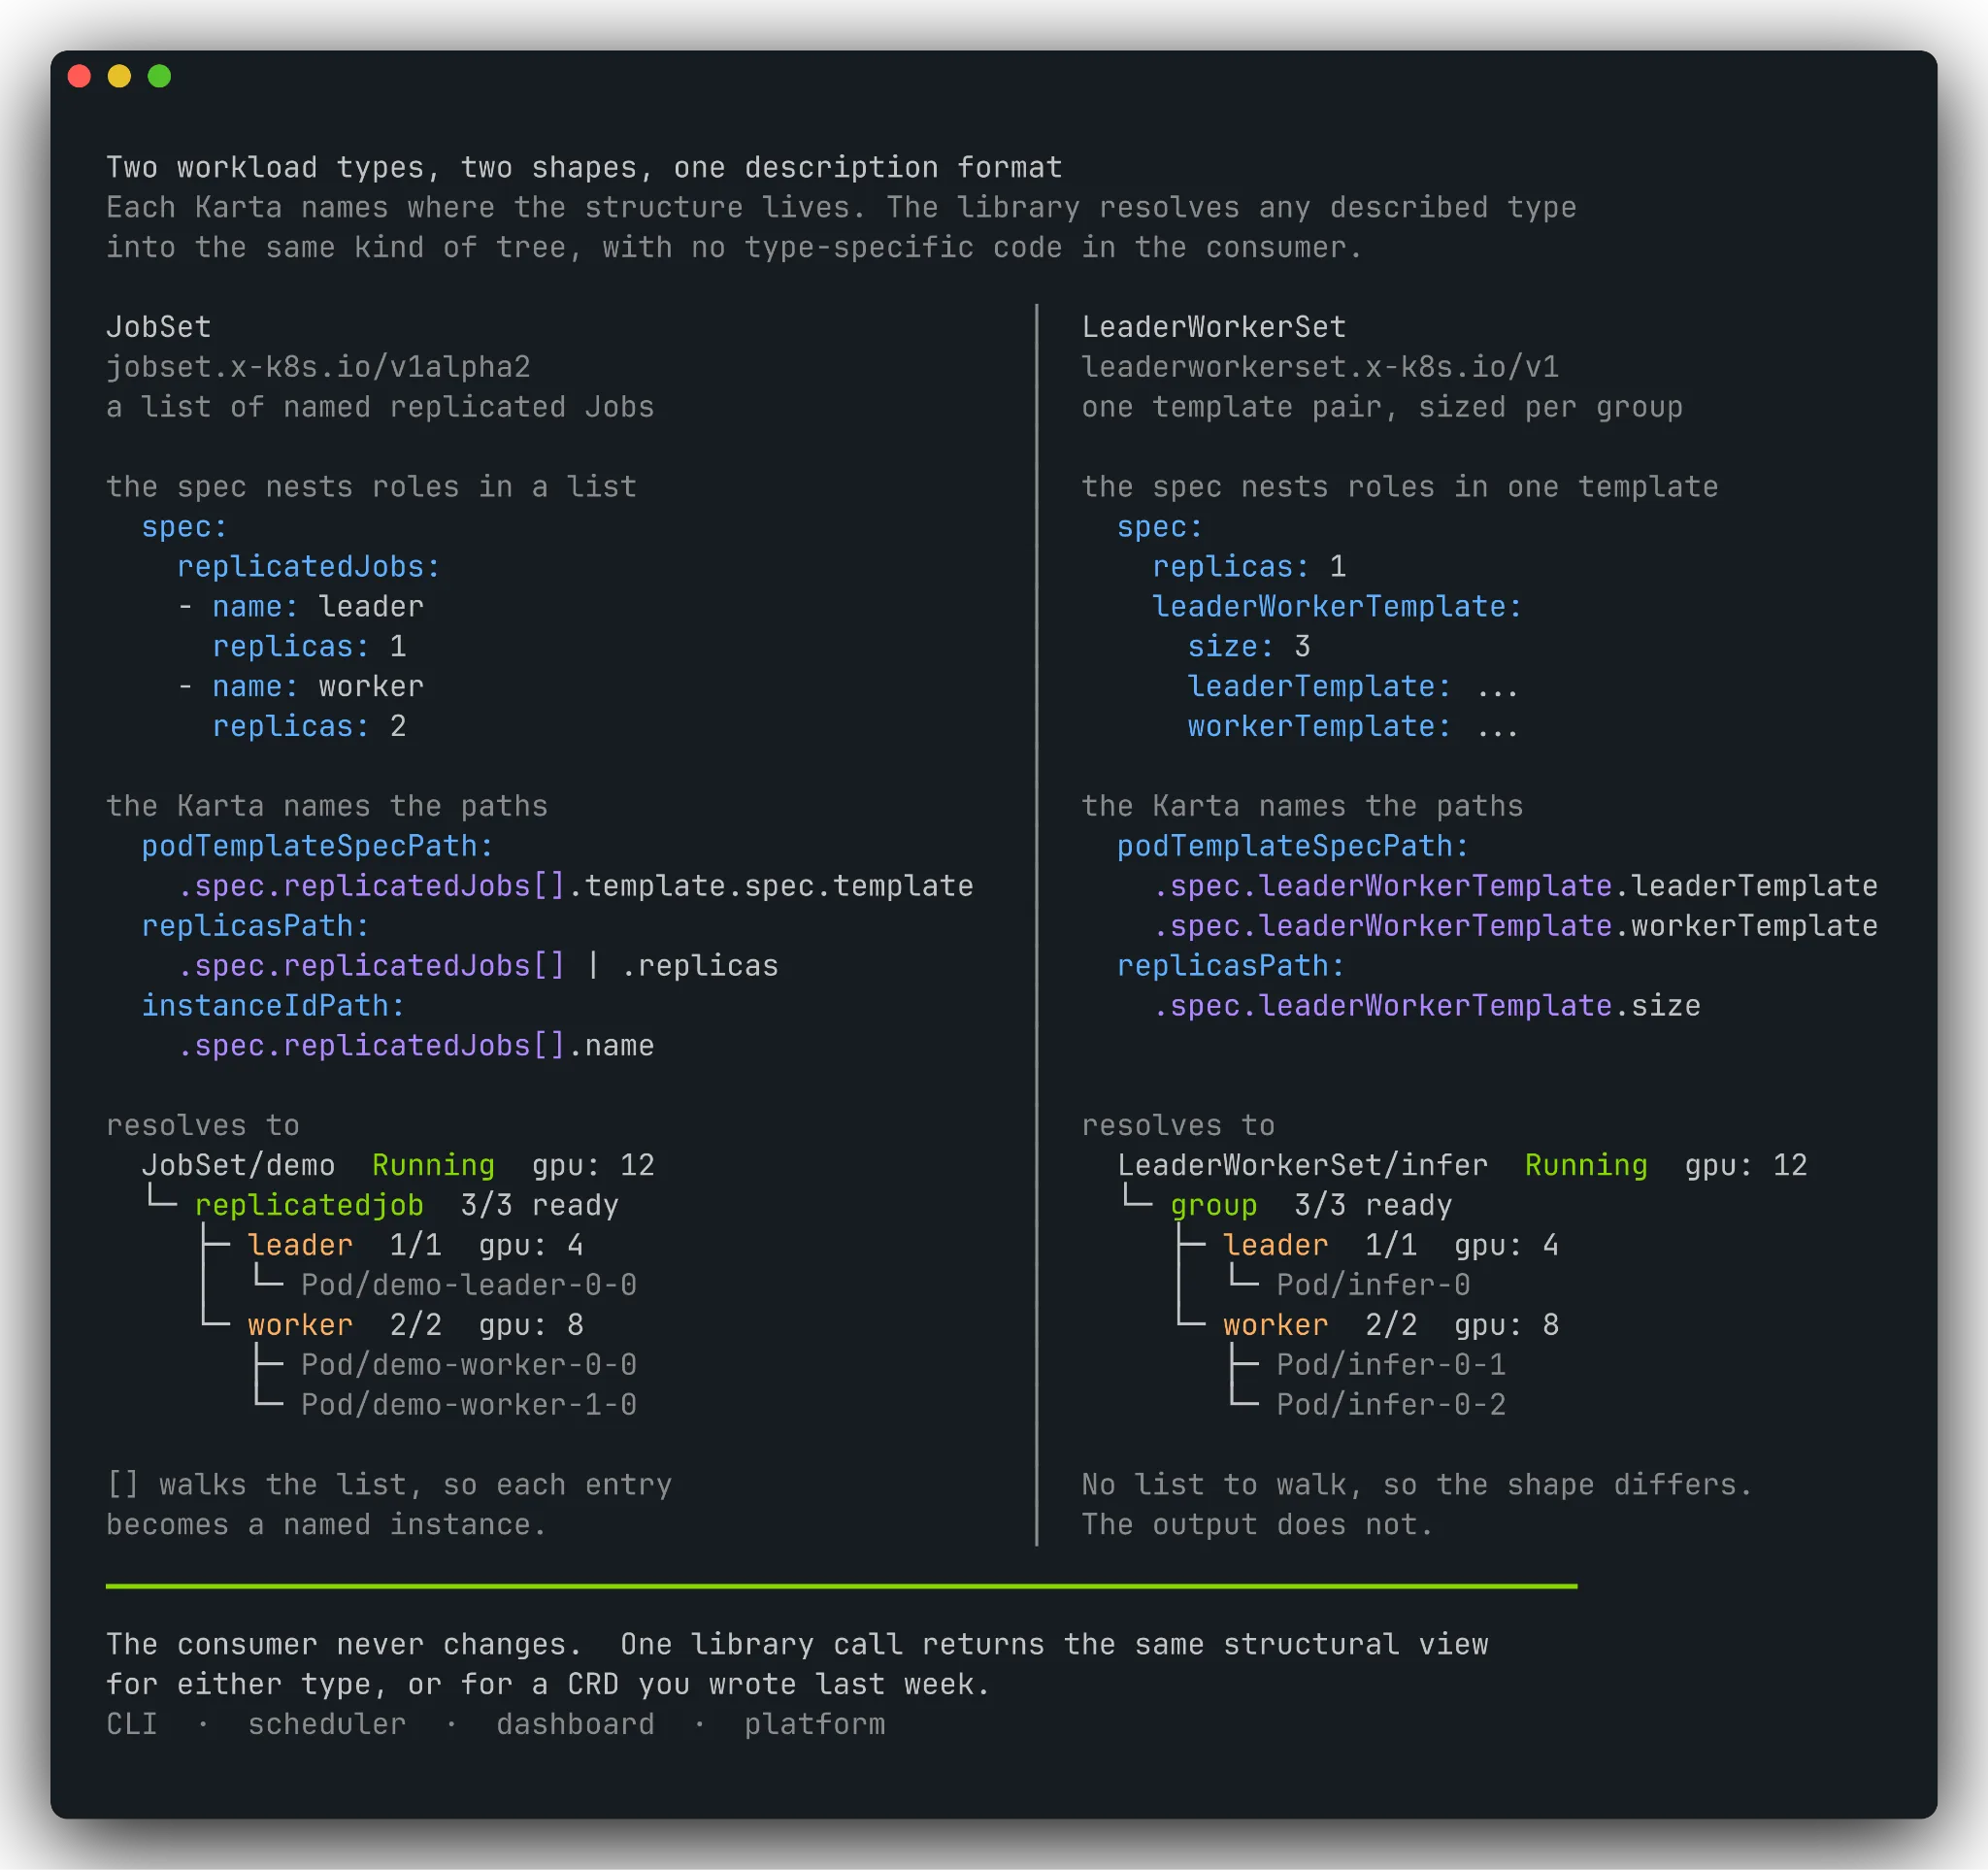
框架特定的结构现在被捕获在一个可复用的定义中。下一节展示不同的消费者如何使用它。
跨工具使用同一份描述
同一个 JobSet 定义支持三种工作流:检查工作负载、将它们一起调度,以及将它们作为一个工作负载进行管理。
使用 Workload Map CLI 检查工作负载
Workload Map CLI 从集群读取工作负载,并通过其工作负载定义渲染它们。对于演示 JobSet,CLI 加载 JobSet 描述,解析活动对象及其 pod,并打印树。CLI 使用 kubeconfig 访问集群,并包含内置的工作负载定义。此检查工作流不需要将 Workload Map 安装到集群中。
以下命令在 macOS 或 Linux 上使用 Homebrew 安装 CLI,并确认可执行文件位于 PATH 上。
brew tap dsx-ai-factory/kli https://github.com/dsx-ai-factory/workload-map
brew install dsx-ai-factory/kli/kli
kli --version
在当前 Kubernetes 上下文中运行演示 JobSet 后,以下命令会检查它。<namespace> 占位符必须替换为包含该工作负载的命名空间。
kli describe jobset/demo -n <namespace>
JobSet/demo   namespace: default   definition: jobset-x-k8s-io-jobset-v1alpha2 (catalog)   age: 20s

`-- replicatedjob                   3/3 ready   gpu: 12   runai-cluster-worker-0-0
    |-- leader                      1/1 ready   gpu: 4    runai-cluster-worker-0-0
    |   `-- demo-leader-0-0-ck6kg   Running     gpu: 4    runai-cluster-worker-0-0
    `-- worker                      2/2 ready   gpu: 8    runai-cluster-worker-0-0
        |-- demo-worker-0-0-j9pdc   Running     gpu: 4    runai-cluster-worker-0-0
        `-- demo-worker-1-0-rrsxz   Running     gpu: 4    runai-cluster-worker-0-0

Phase: Running

Resources:
COMPONENT   REPLICAS   GPU   CPU   MEMORY
leader      1          4     0     0
worker      2          8     0     0
TOTAL       3          12    0     0
输出标识了 leader 和 worker 角色,并显示示例工作负载的总请求为 12 个 GPU。
图 4. 早期 Karta CLI 视图将 JobSet 解析为 leader 和 worker 角色,显示就绪状态、GPU 总数和节点放置
$ karta workload tree demo
JobSet/demo [Running]
└─ replicatedjob  (3/3 replicas)  3/3 ready  gpu: 12  runai-cluster-worker-0-2,runai-cluster-worker-0-5,runai-cluster-worker-0-7
   ├─ leader  (1/1 replicas)  1/1 ready  gpu: 4  runai-cluster-worker-0-7
   │  └─ Pod/demo-leader-0-0-ksb4l  Running  gpu: 4  runai-cluster-worker-0-7
   └─ worker  (2/2 replicas)  2/2 ready  gpu: 8  runai-cluster-worker-0-2,runai-cluster-worker-0-5
      ├─ Pod/demo-worker-0-0-qv955  Running  gpu: 4  runai-cluster-worker-0-5
      └─ Pod/demo-worker-1-0-5smfn  Running  gpu: 4  runai-cluster-worker-0-2

$ karta workload list
NAMESPACE   NAME  KIND    PHASE    COMPONENTS           GPU  AGE
karta-demo  demo  JobSet  Running  leader(1), worker(2)  12   3m
该定义提供了 JobSet 特定的结构,因此 CLI 无需专用解析器即可检查该工作负载。
使用 KAI Scheduler 启用 gang 调度
对于调度工作负载的消费者,定义还可以包含可选的 gang 调度指令。
  optimizationInstructions:
    gangScheduling:
      podGroup:
        name: job
        subGroups:
        - componentName: replicatedjob
该定义提供分组信息;KAI Scheduler 强制执行 gang 准入并做出放置决策。KAI Scheduler 在其 pod grouper 中将 Workload Map 用作没有原生插件的工作负载类型的回退方案。匹配的定义提供结构和分组信息,而无需新的框架特定插件,同时原生插件保持优先。
在 NVIDIA Run:ai 中管理同一工作负载
在 NVIDIA Run:ai 中,一次 API 调用即可使用相同的目录定义注册该工作负载类型,无需额外代码。然后平台使用该描述将 JobSet 作为一个工作负载进行管理。
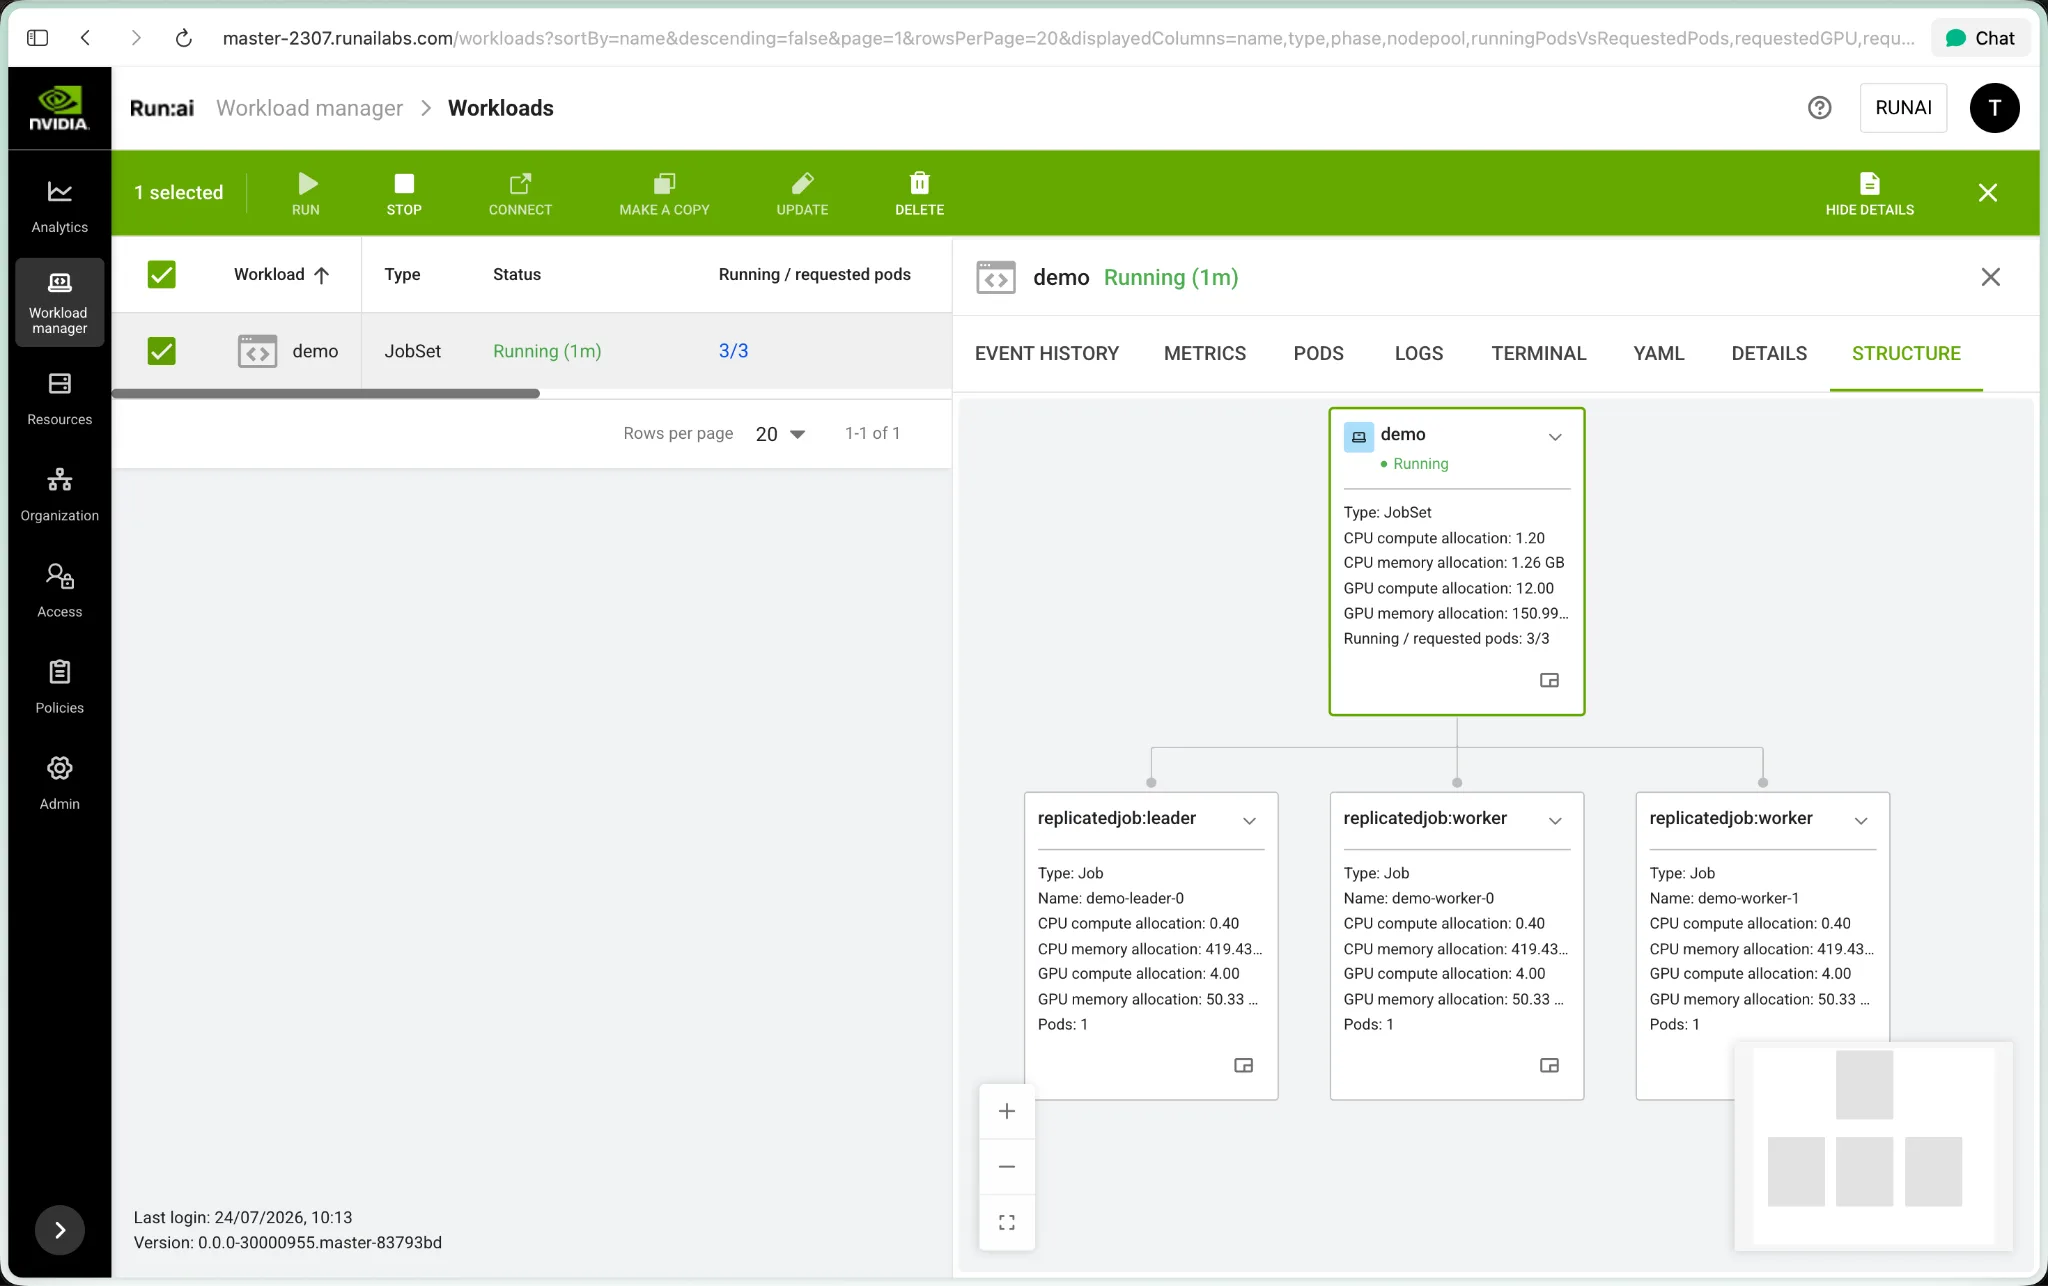
CLI、KAI Scheduler 和 NVIDIA Run:ai 将同一份定义用于不同目的:检查、调度和平台可见性。对于另一种受支持的工作负载类型,相应的目录定义通过相同的接口提供其结构。
Workload Map 在调度器和平台中的采用
NVIDIA Workload Map 在 Apache 2.0 许可证 下提供,并已在 NVIDIA Run:ai 中投入生产使用。其声明式定义支持在受支持的 Kubernetes 工作负载类型之间实现工作负载可见性、状态解释、提交和变更。
采用范围还扩展到多集群调度。Elotl 的 Nova 使用 Workload Map 在为分布式工作负载选择集群时解释工作负载结构和资源需求。通过使用预构建的定义,Nova 减少了维护框架特定解析逻辑的需求,展示了同一工作负载描述模型如何支持不同的调度和平台消费者。
开始使用
NVIDIA Workload Map 是一个开源组件,可通过 NVIDIA DSX AI Factory GitHub 组织 获取。如果您在 Kubernetes 上运行 AI 工作负载,并需要一种跨框架一致解释其结构的方式,Workload Map 有助于弥合这一差距。
从 工作负载目录 开始,为您已经使用的框架找到定义,或调整一个定义以支持自定义工作负载类型。使用 Slack 邀请链接 加入 NVIDIA DSX AI Factory Slack 工作区的对话。我们迫不及待想看到您构建的内容。