四块 GPU 不是一块四倍大的 GPU。它们是四个独立的内存空间、四个处理器;一块卡上的内核要用另一块卡上的权重或 KV 缓存,必须先把数据搬过去。所以分布式推理的第一个问题不是"用几张卡",而是"把什么放在哪张卡上"。
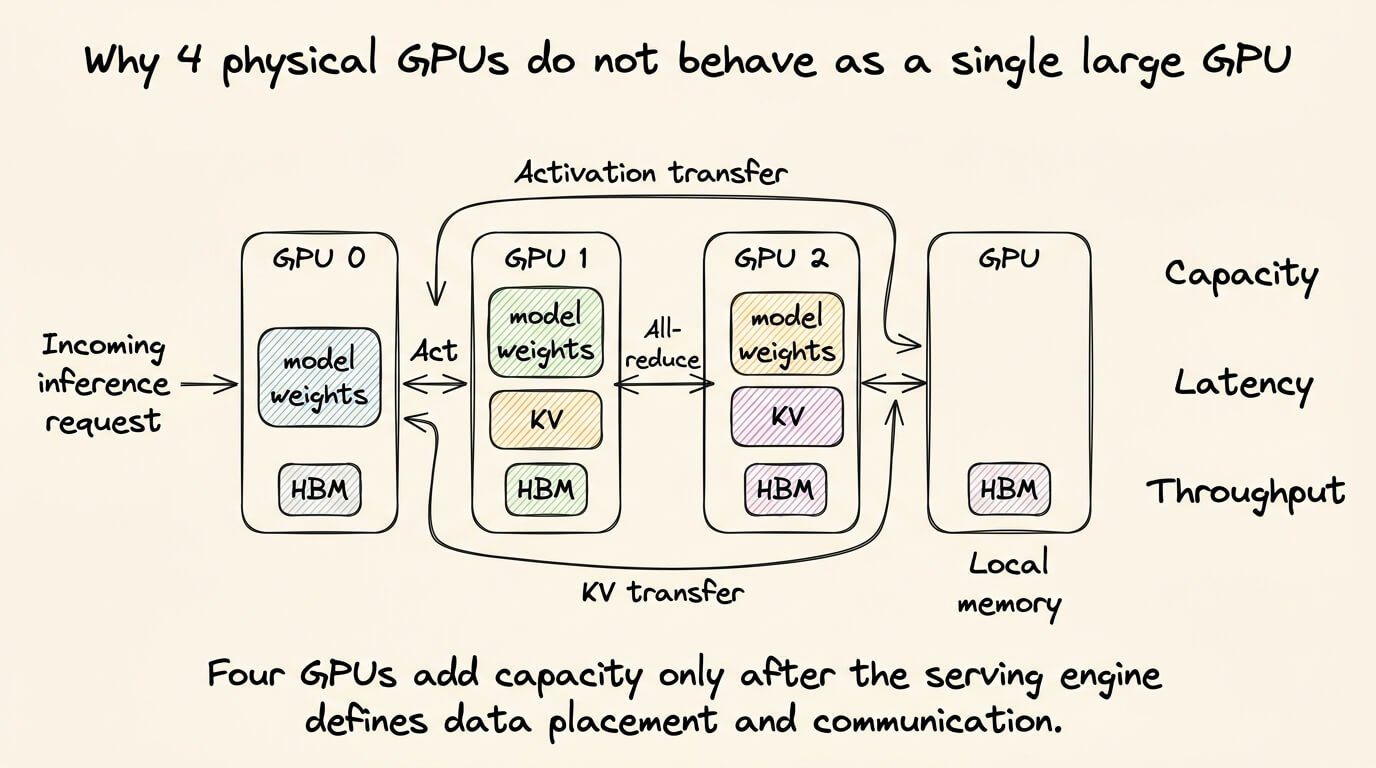
权重、激活、请求、缓存的 K/V——服务引擎把它们分配到具体的设备上。任何跨设备的依赖,都会在请求路径上加一次传输或一次集合通信。工程问题就变成:选一种布局,既解掉当前的瓶颈,又不把通信量加到硬件扛不住。
这篇文章把 Avi Chawla 的原文重新组织了一遍:先讲怎么判断瓶颈在哪,再用同一张"卡片"逐个过数据、张量、流水线、上下文、专家五种并行,最后给一条从上往下走的决策流程。全文假设同一台四卡服务器:模型至少要两张卡,流量里既有短对话也有长上下文请求;模型、流量、硬件都不变,只变推理工作在卡之间怎么分。
先约定一个词:集合通信(collective)。 多块 GPU 作为一个群体交换或合并数据的操作。比如两块 GPU 各算出层输出的一部分,all-reduce 把两部分相加,并让两块 GPU 同时拿到完整结果。每个参与的 GPU 都做完自己那份,集合通信才算完成——所以一块慢卡或一条慢链路会拖住整个组。这和"一块 GPU 直接发给另一块"的点对点传输不一样。
一、先弄清楚你在为什么买单
推理的两个阶段
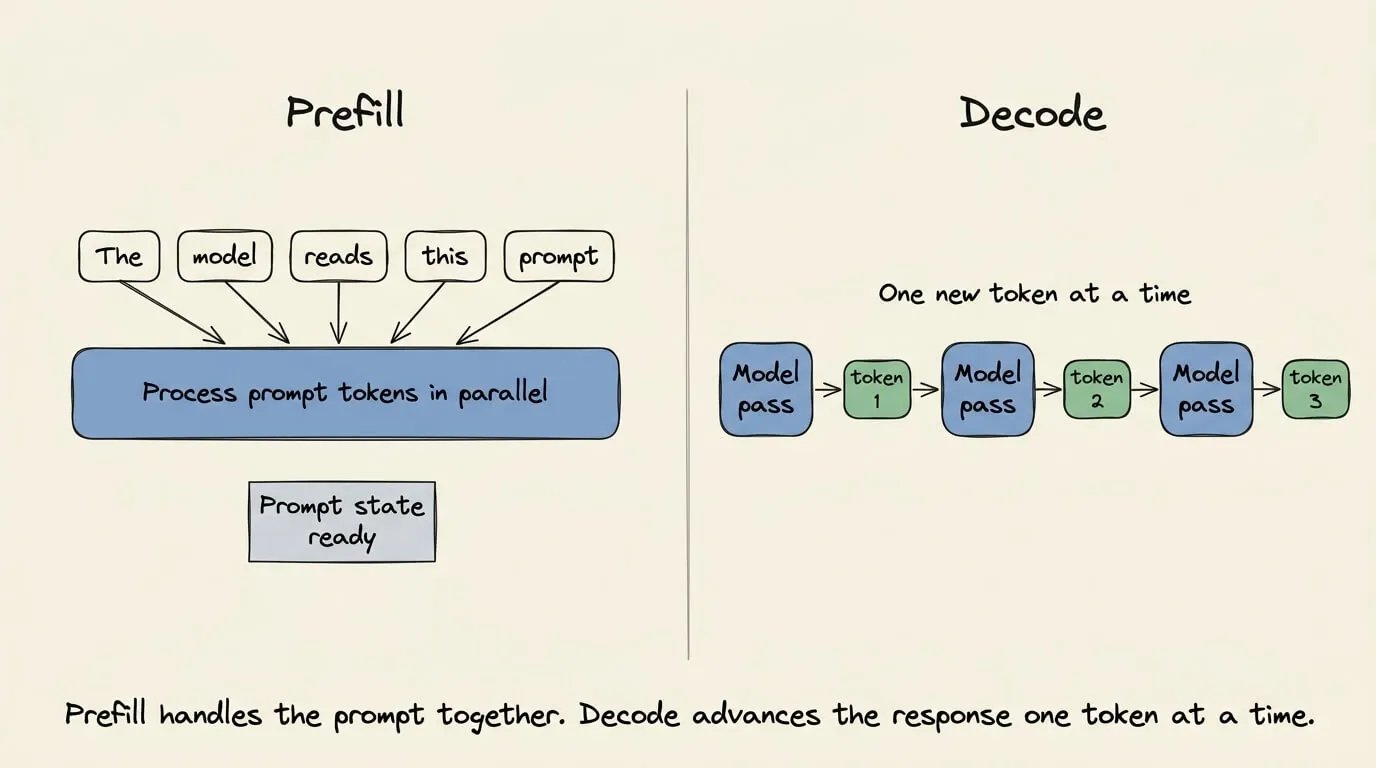
- 预填充(prefill) 处理提示词并建立它的 KV 缓存。它一次处理大量提示词 token,通常是大矩阵乘。预填充决定首 token 时间(TTFT)。
- 解码(decode) 一步一个 token 地往后生成。每一步都要读模型权重和不断变长的缓存。解码决定每个输出 token 的时间(TPOT);有些系统报的是 token 间延迟。
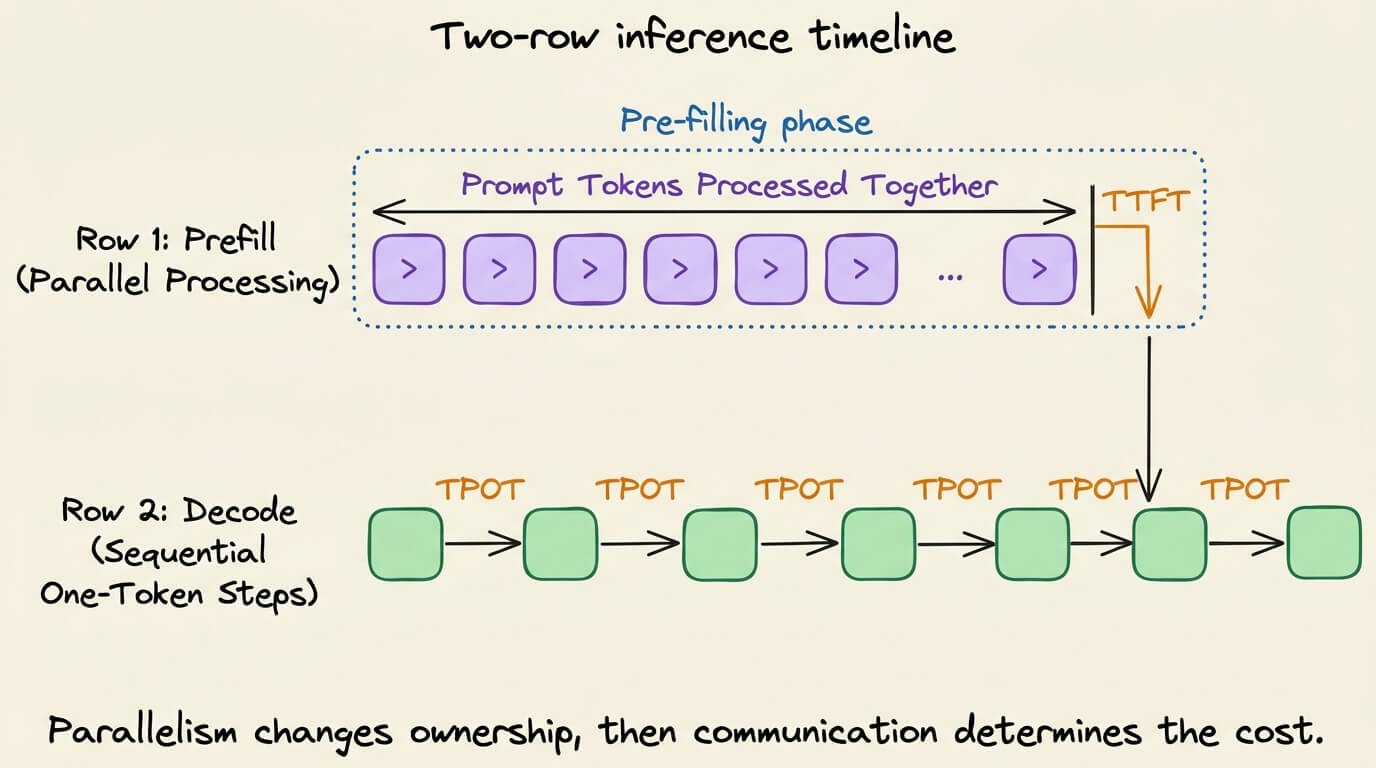
两个阶段用硬件的方式不同:预填充是跨大量 token 的大矩阵乘;解码是小操作,反复读权重和 KV 缓存。一种缩短预填充的布局,完全可能因为给每个生成 token 多加了一次同步而拖慢解码。 这是后面每种并行都要回答的问题。
四种资源、五个指标
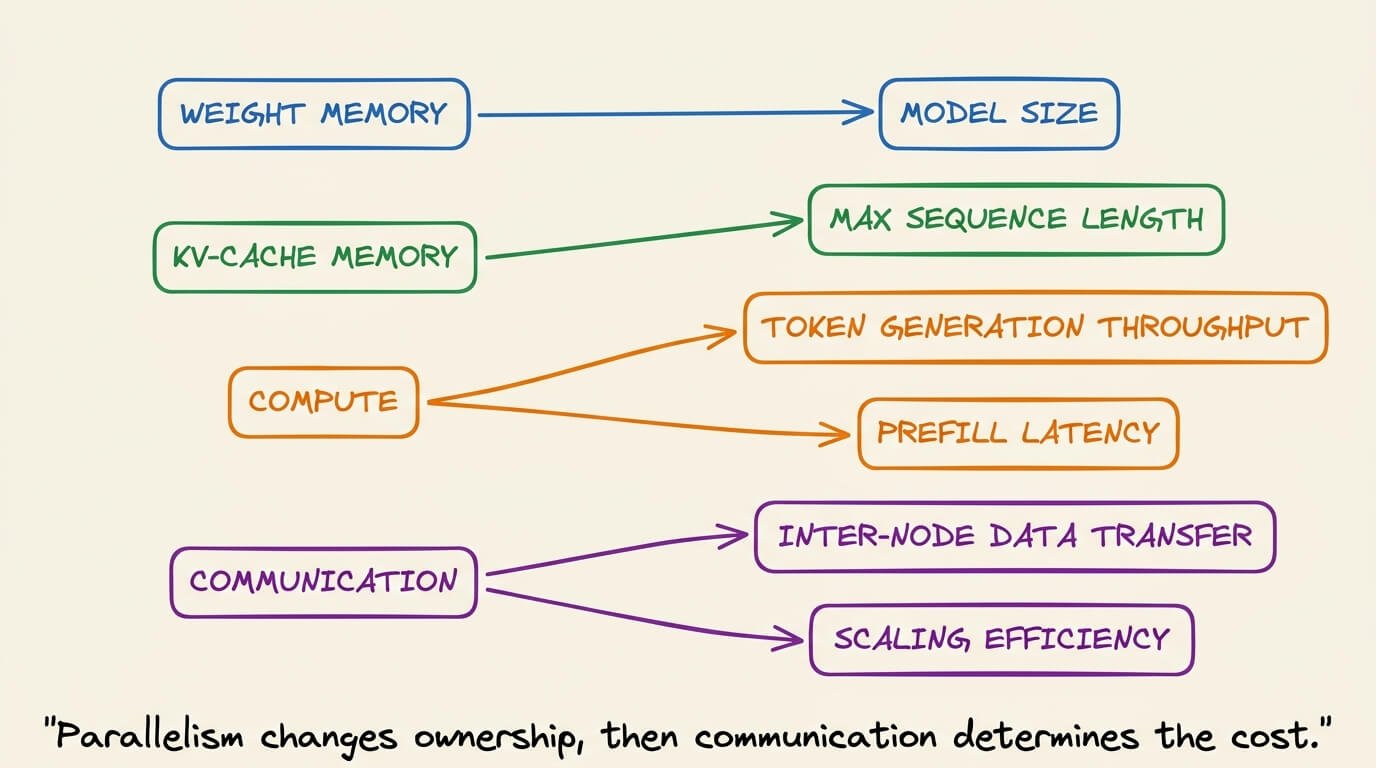
限制一次部署的通常是四种资源:
- 参数内存:模型放不放得下。
- KV 缓存内存:能常驻多少 token、同时服务多少请求。
- GPU 计算时间:本地矩阵运算。
- 通信时间:设备之间的传输和集合通信。
服务指标要对应产品目标:
- TTFT 衡量首次响应。
- TPOT 衡量流式输出的节奏。
- 请求吞吐统计完成的请求数。
- Token 吞吐区分输入和输出的工作量。
- 有效吞吐(goodput) 只统计满足服务级别目标的请求。
任何指标取平均都会掩盖尾部延迟,所以必须报中位数和高分位数。p95 TTFT 是 95% 的请求都能达到的阈值,要在同样的请求分布下和服务目标比。
没有延迟约束的"每秒 token 数"会误导:一台打满的服务器可以一边报出很高的吞吐,一边违反尾部延迟目标。
诊断链
指标告诉你哪个服务目标没达成;资源测量告诉你是内存、算力还是通信导致的。接下来的决定才是"怎么在 GPU 之间分配推理工作,去对付这一项限制"。这就是并行化的角色:每种方法切的是工作负载的不同部分,带来的也是不同的通信负担。
二、用同一张卡片看每一种并行
对每种策略都问同样五个问题:
- 哪些状态被切分了?
- 哪些状态仍然是复制的?
- 什么数据要跨互连传输?
- 传得多频繁?
- 这种布局改善的是内存容量、单请求延迟,还是吞吐?
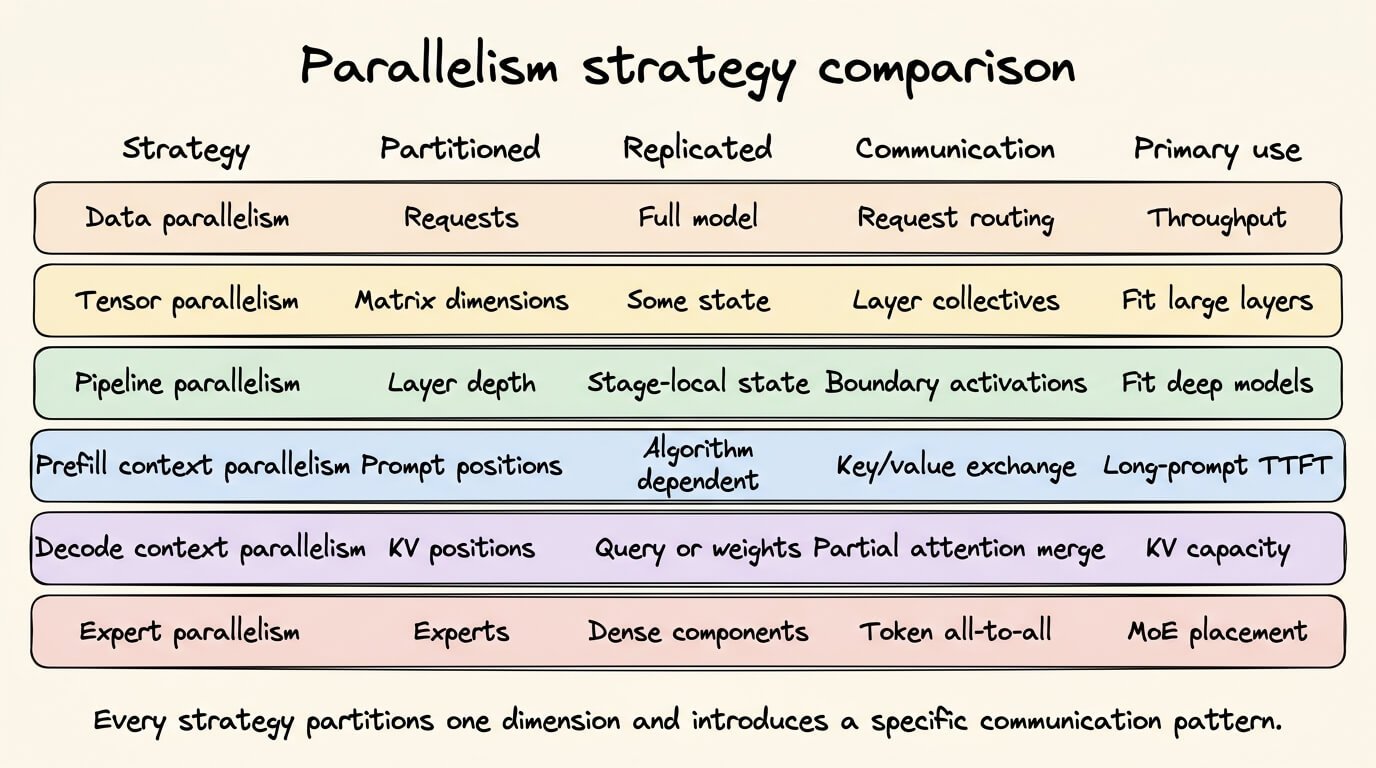
对比表里的"通信"一列最重要。传输大小要紧,传输频率同样要紧:每个解码层里重复一次的小集合通信,代价可能超过流水线阶段之间一次较大的激活传输。
下面从数据并行开始,因为它让每次前向传播留在一个副本内部;其他方法都把一次前向传播拆到多块 GPU 上,通信直接落在执行路径里。
三、五种切法
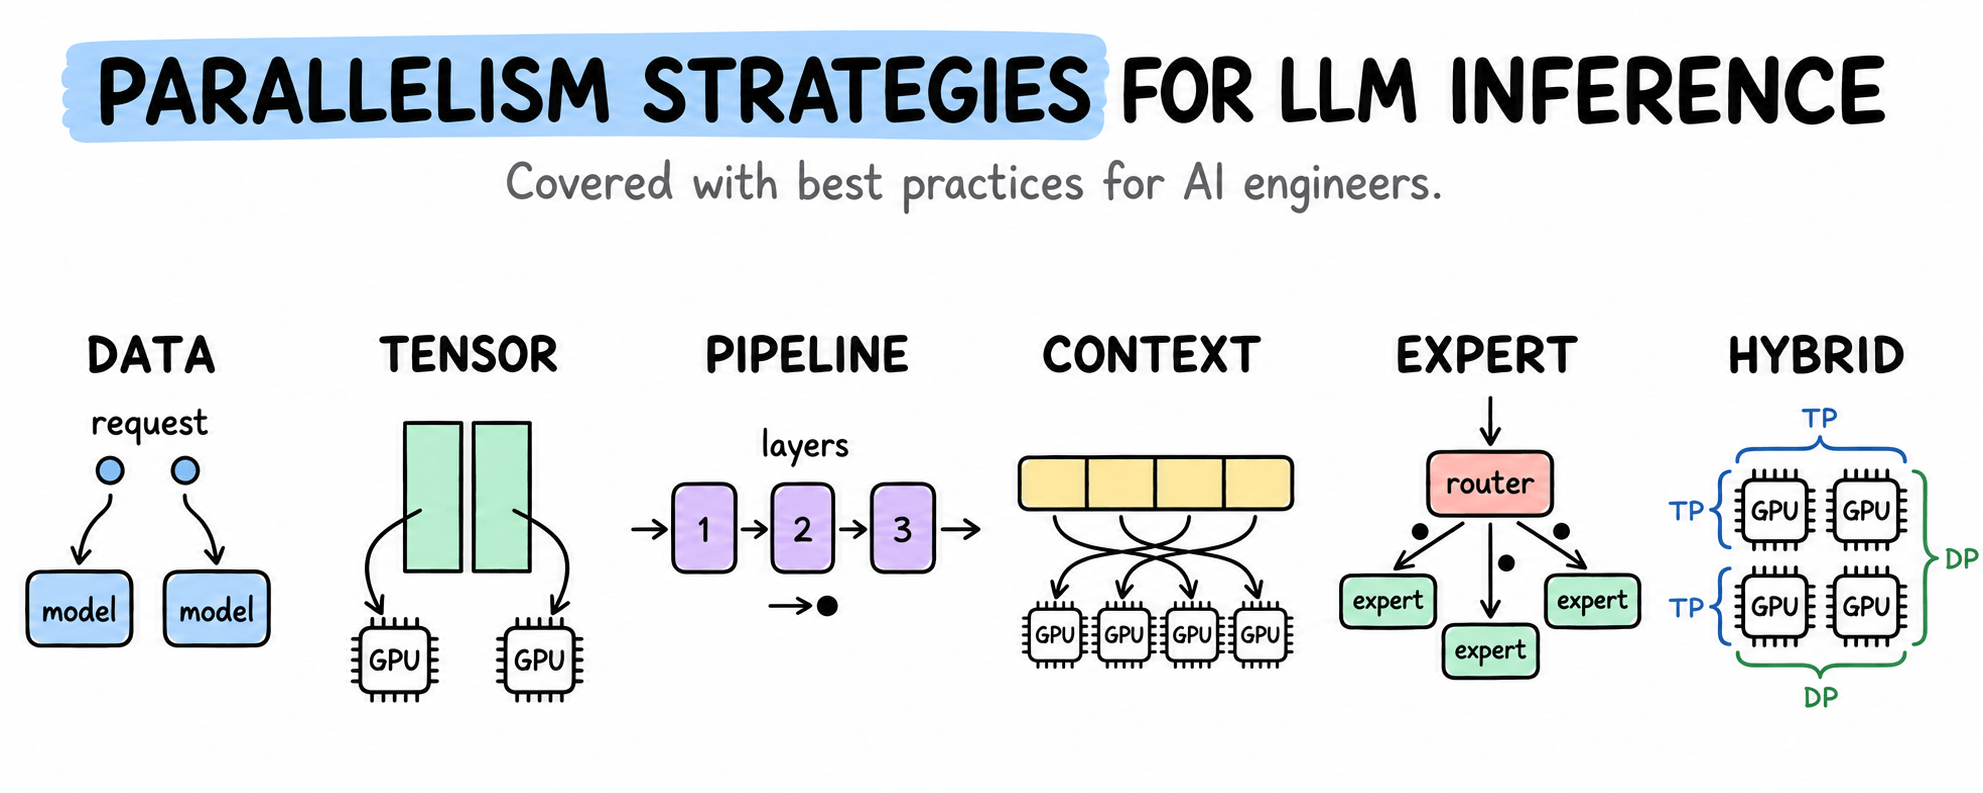
1)数据并行(DP):切请求
卡片
- 切分的:请求。
- 复制的:完整模型,每个副本自带调度器和 KV 缓存。
- 跨互连的:没有——请求在被选中的副本内部处理完。
- 频率:每次前向传播都不需要跨副本通信。
- 改善的:吞吐,不是单请求延迟。
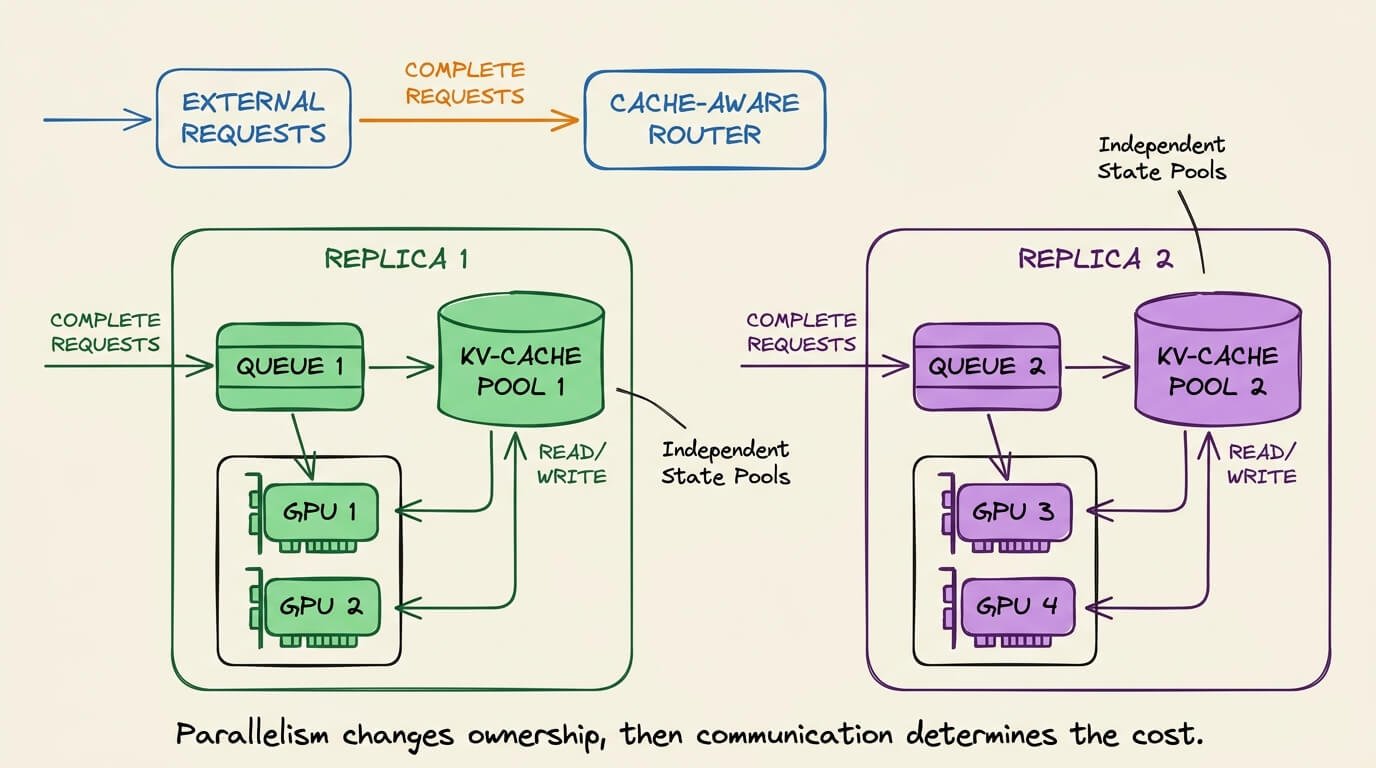
这和训练时的数据并行不同:推理没有梯度要同步,一个请求始终留在它的副本本地。
假设一个双卡副本能满足延迟目标,但吃不下请求速率。四卡服务器上,数据并行让我们跑第二个双卡副本,两个副本并发处理不同请求。
部署检查
- 内存。 每个副本都要装下完整的双卡布局,四卡服务器要存两遍模型。所以数据并行只在"一个完整副本已经放得下"之后才可用,它本身解决不了模型放置问题。
- 请求路由。 两个副本都活着之后,路由器决定每个请求进哪个队列、哪个 KV 池。轮询把两个副本当成一样可用——即使其中一个队列更长、空闲 KV 更少,或者已经缓存了可复用的前缀。
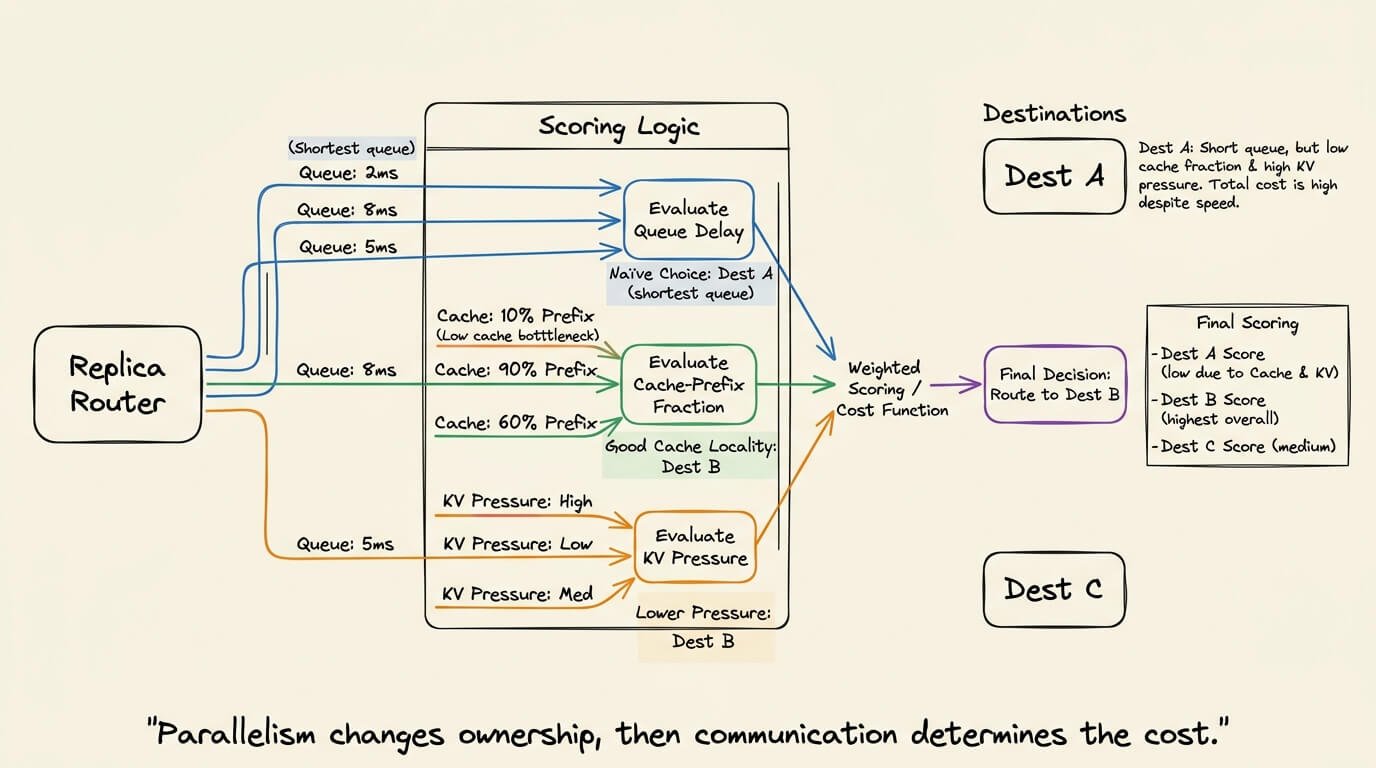
- 准入容量。 请求刚到时占的 KV 很少,解码往后生成才越占越多。路由器必须为这个增长预留容量,否则一个副本可能接下一个预填充时放得下、生成到一半 KV 不够的请求。
工程规则: 加了副本之后,按队列延迟、可用 KV 容量和前缀缓存命中来路由;接受请求之前,为预期的解码长度预留 KV。
什么时候不要用: 流量低的时候,第二个副本闲着,而且降不了单个请求的延迟。只在完整副本放得下、并发高到能让多个副本都忙起来时用它。
2)张量并行(TP):切一层里的矩阵
卡片
- 切分的:同一层里的大权重矩阵,多块 GPU 共同处理同一个请求。
- 复制的:部分参数、临时缓冲区、CUDA 图、KV 缓存分配——不要假设 TP2 把所有分配都减半。
- 跨互连的:各 rank 的部分结果,靠 all-reduce 合并。
- 频率:很多层内部都有,预填充和每一个解码步都会发生。
- 改善的:首先是放置(模型放得下);其次是大算子的计算时间,但前提是省下的算力超过通信开销。
假设模型放不进一张卡,但把最大的几个权重矩阵拆到两张卡上就能放下。数据并行帮不上忙——每个副本仍然需要完整布局;张量并行可以。
它是怎么切的。 Megatron-LM 论文解释了常见的"两次投影"结构。看一个前馈块:第一个投影生成中间激活,第二个投影把它变回隐藏宽度。
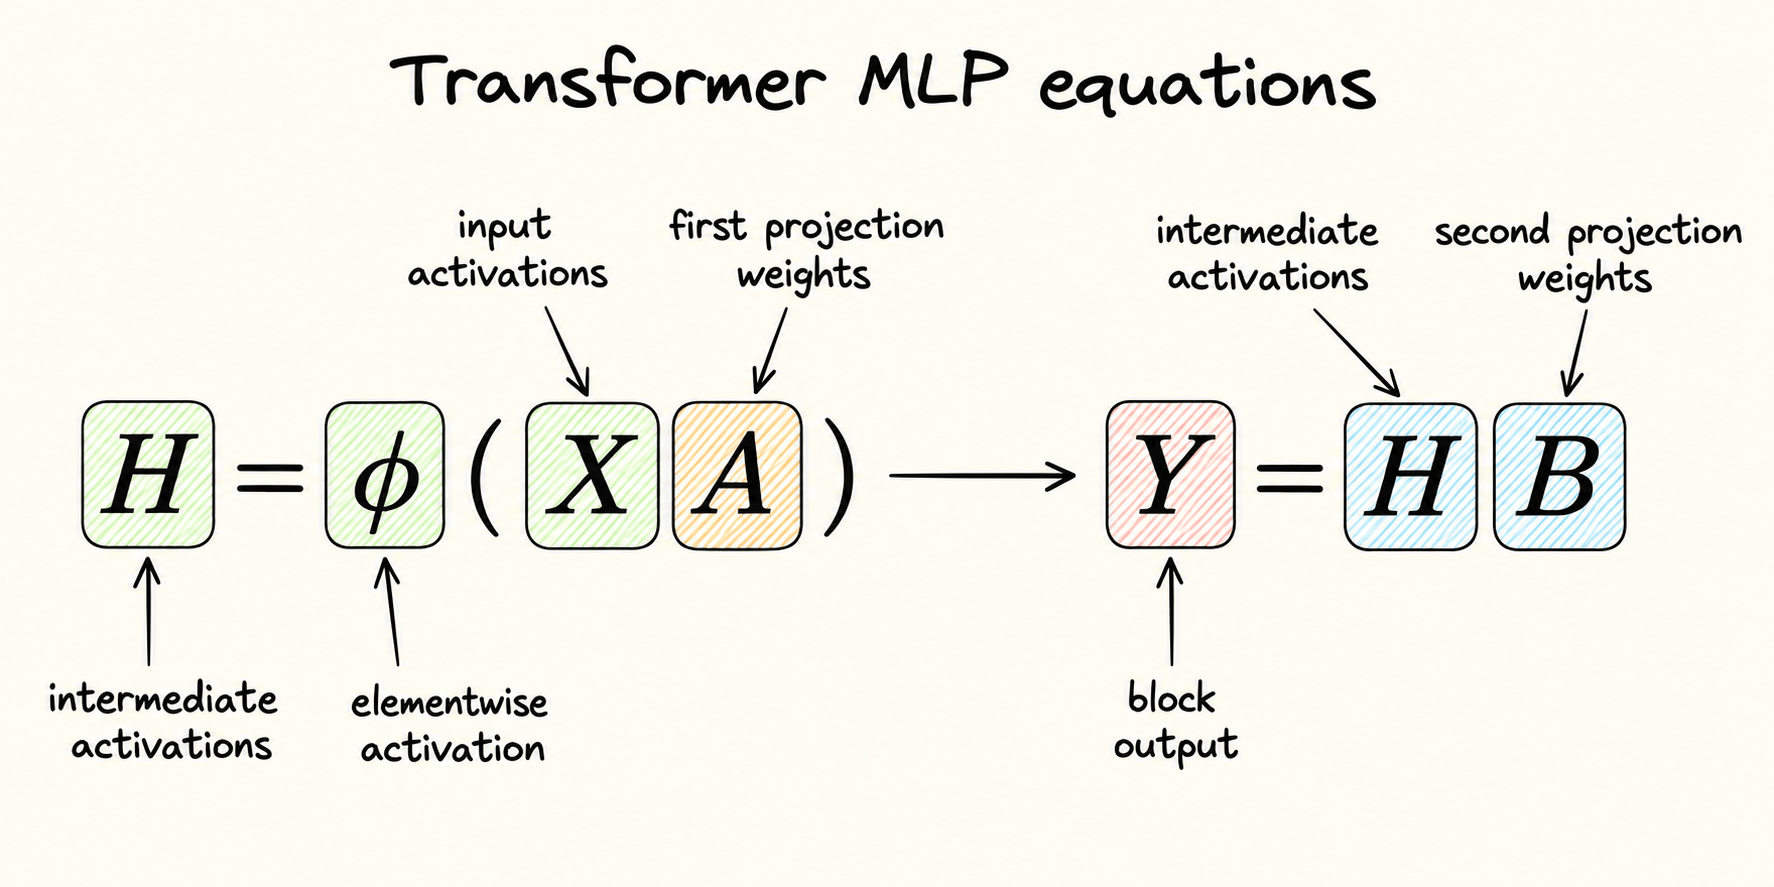
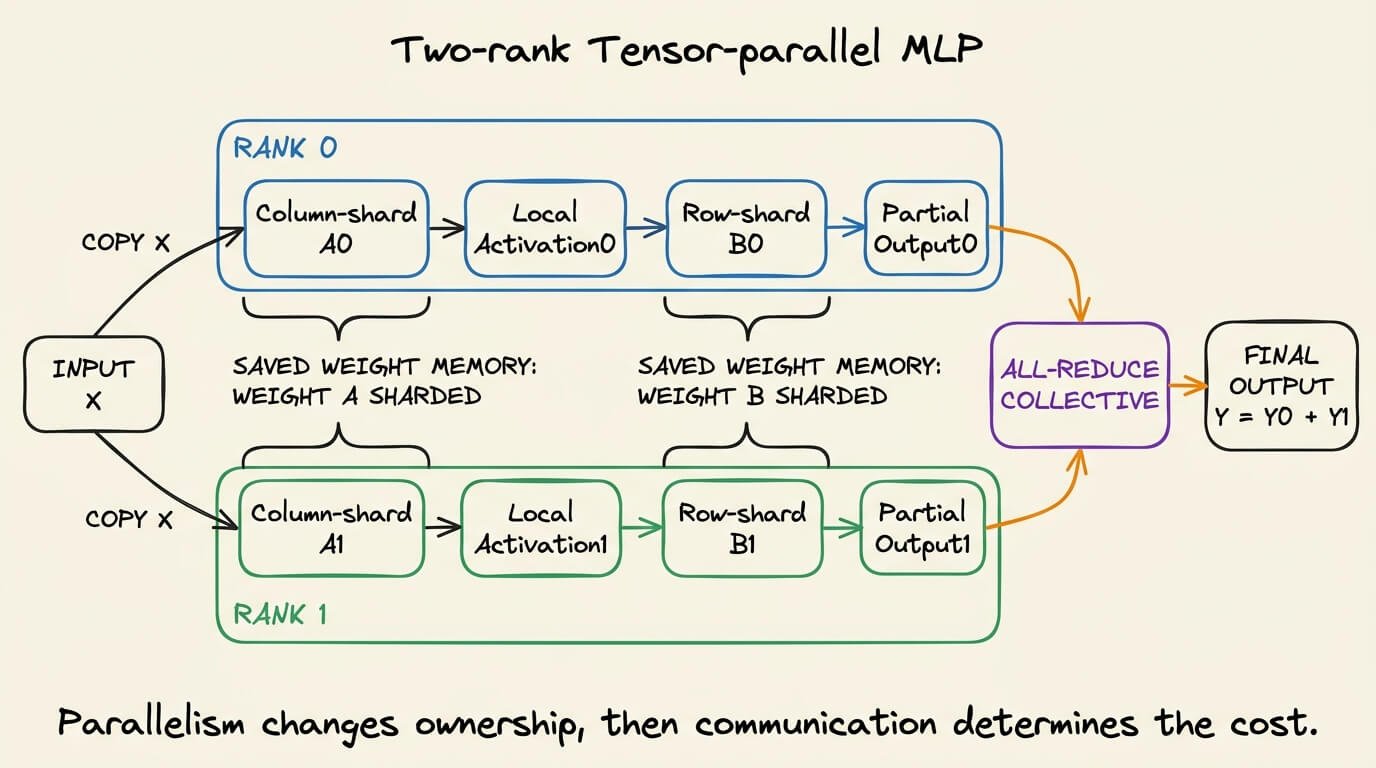
两个 rank 时,第一个权重矩阵按列切,每个 rank 算出不同的中间特征;第二个矩阵按行切,每个 rank 消费自己对应的那一片特征,各自产生部分输出张量。
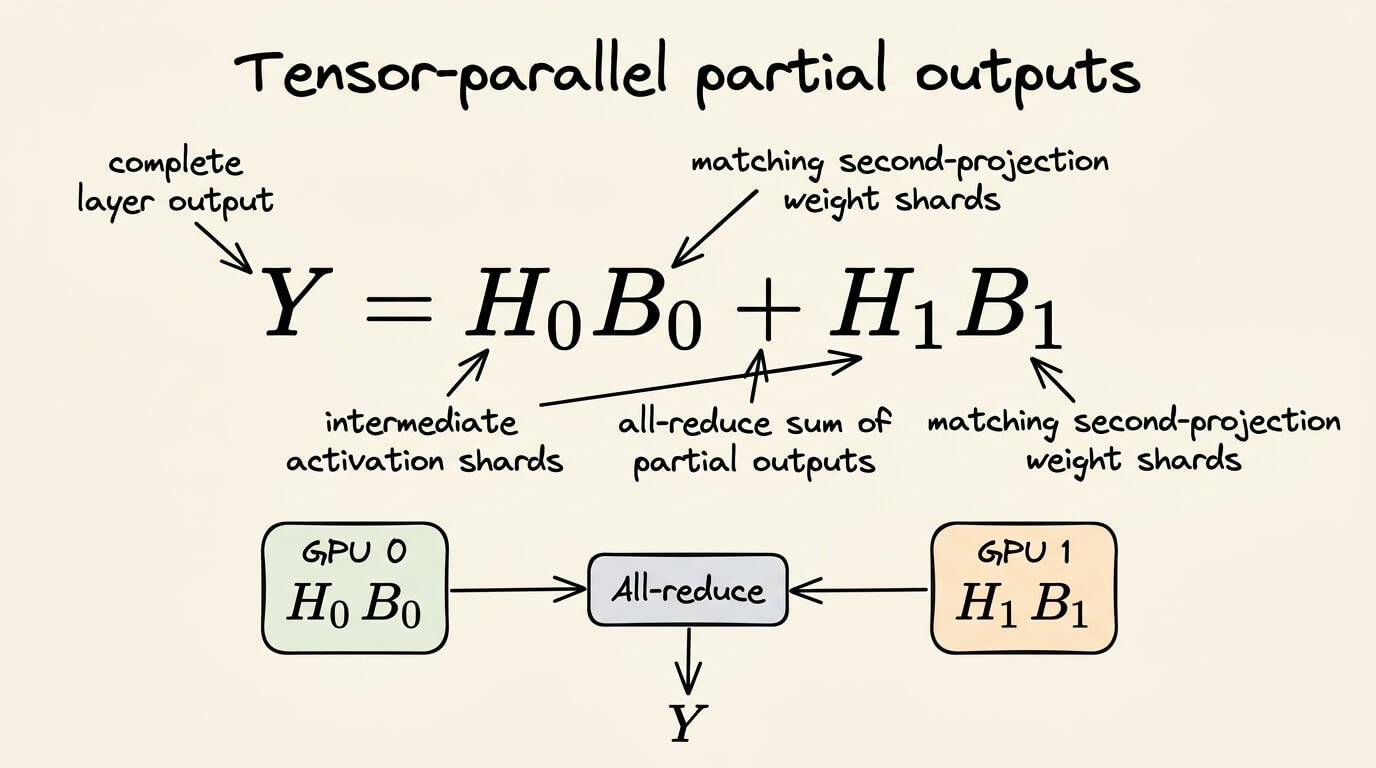
每块 GPU 用本地分片各算一个矩阵乘;all-reduce 把部分张量求和。在这次集合通信完成之前,哪块 GPU 都没有正确的层输出。
import numpy as np

def tensor_parallel_output(x, a_shards, b_shards, activation=np.tanh):

    partials = []

    for a_shard, b_shard in zip(a_shards, b_shards, strict=True):
        hidden_shard = activation(x @ a_shard)
        partials.append(hidden_shard @ b_shard)

    return np.sum(partials, axis=0)
这个函数就是两 rank 的数据依赖:每个 rank 用配对的矩阵分片,每个本地结果只含输出的一部分,所以必须归约。运行测试样例:
tensor_parallel_output = [[-3.294438, 1.406896]]
未切分的 MLP 产生同样的两个值,测试在 NumPy 浮点容差内逐元素核对。
注意力用的是同一个思路:Q、K、V 投影可以按注意力头切,输出投影再合并部分结果;具体布局取决于多头注意力、分组查询注意力和模型专用的核函数。
两个术语。 张量并行组是共同服务一个请求的一组 GPU;rank 是组里的一个 GPU 进程。TP2 有两个 rank,TP4 有四个。
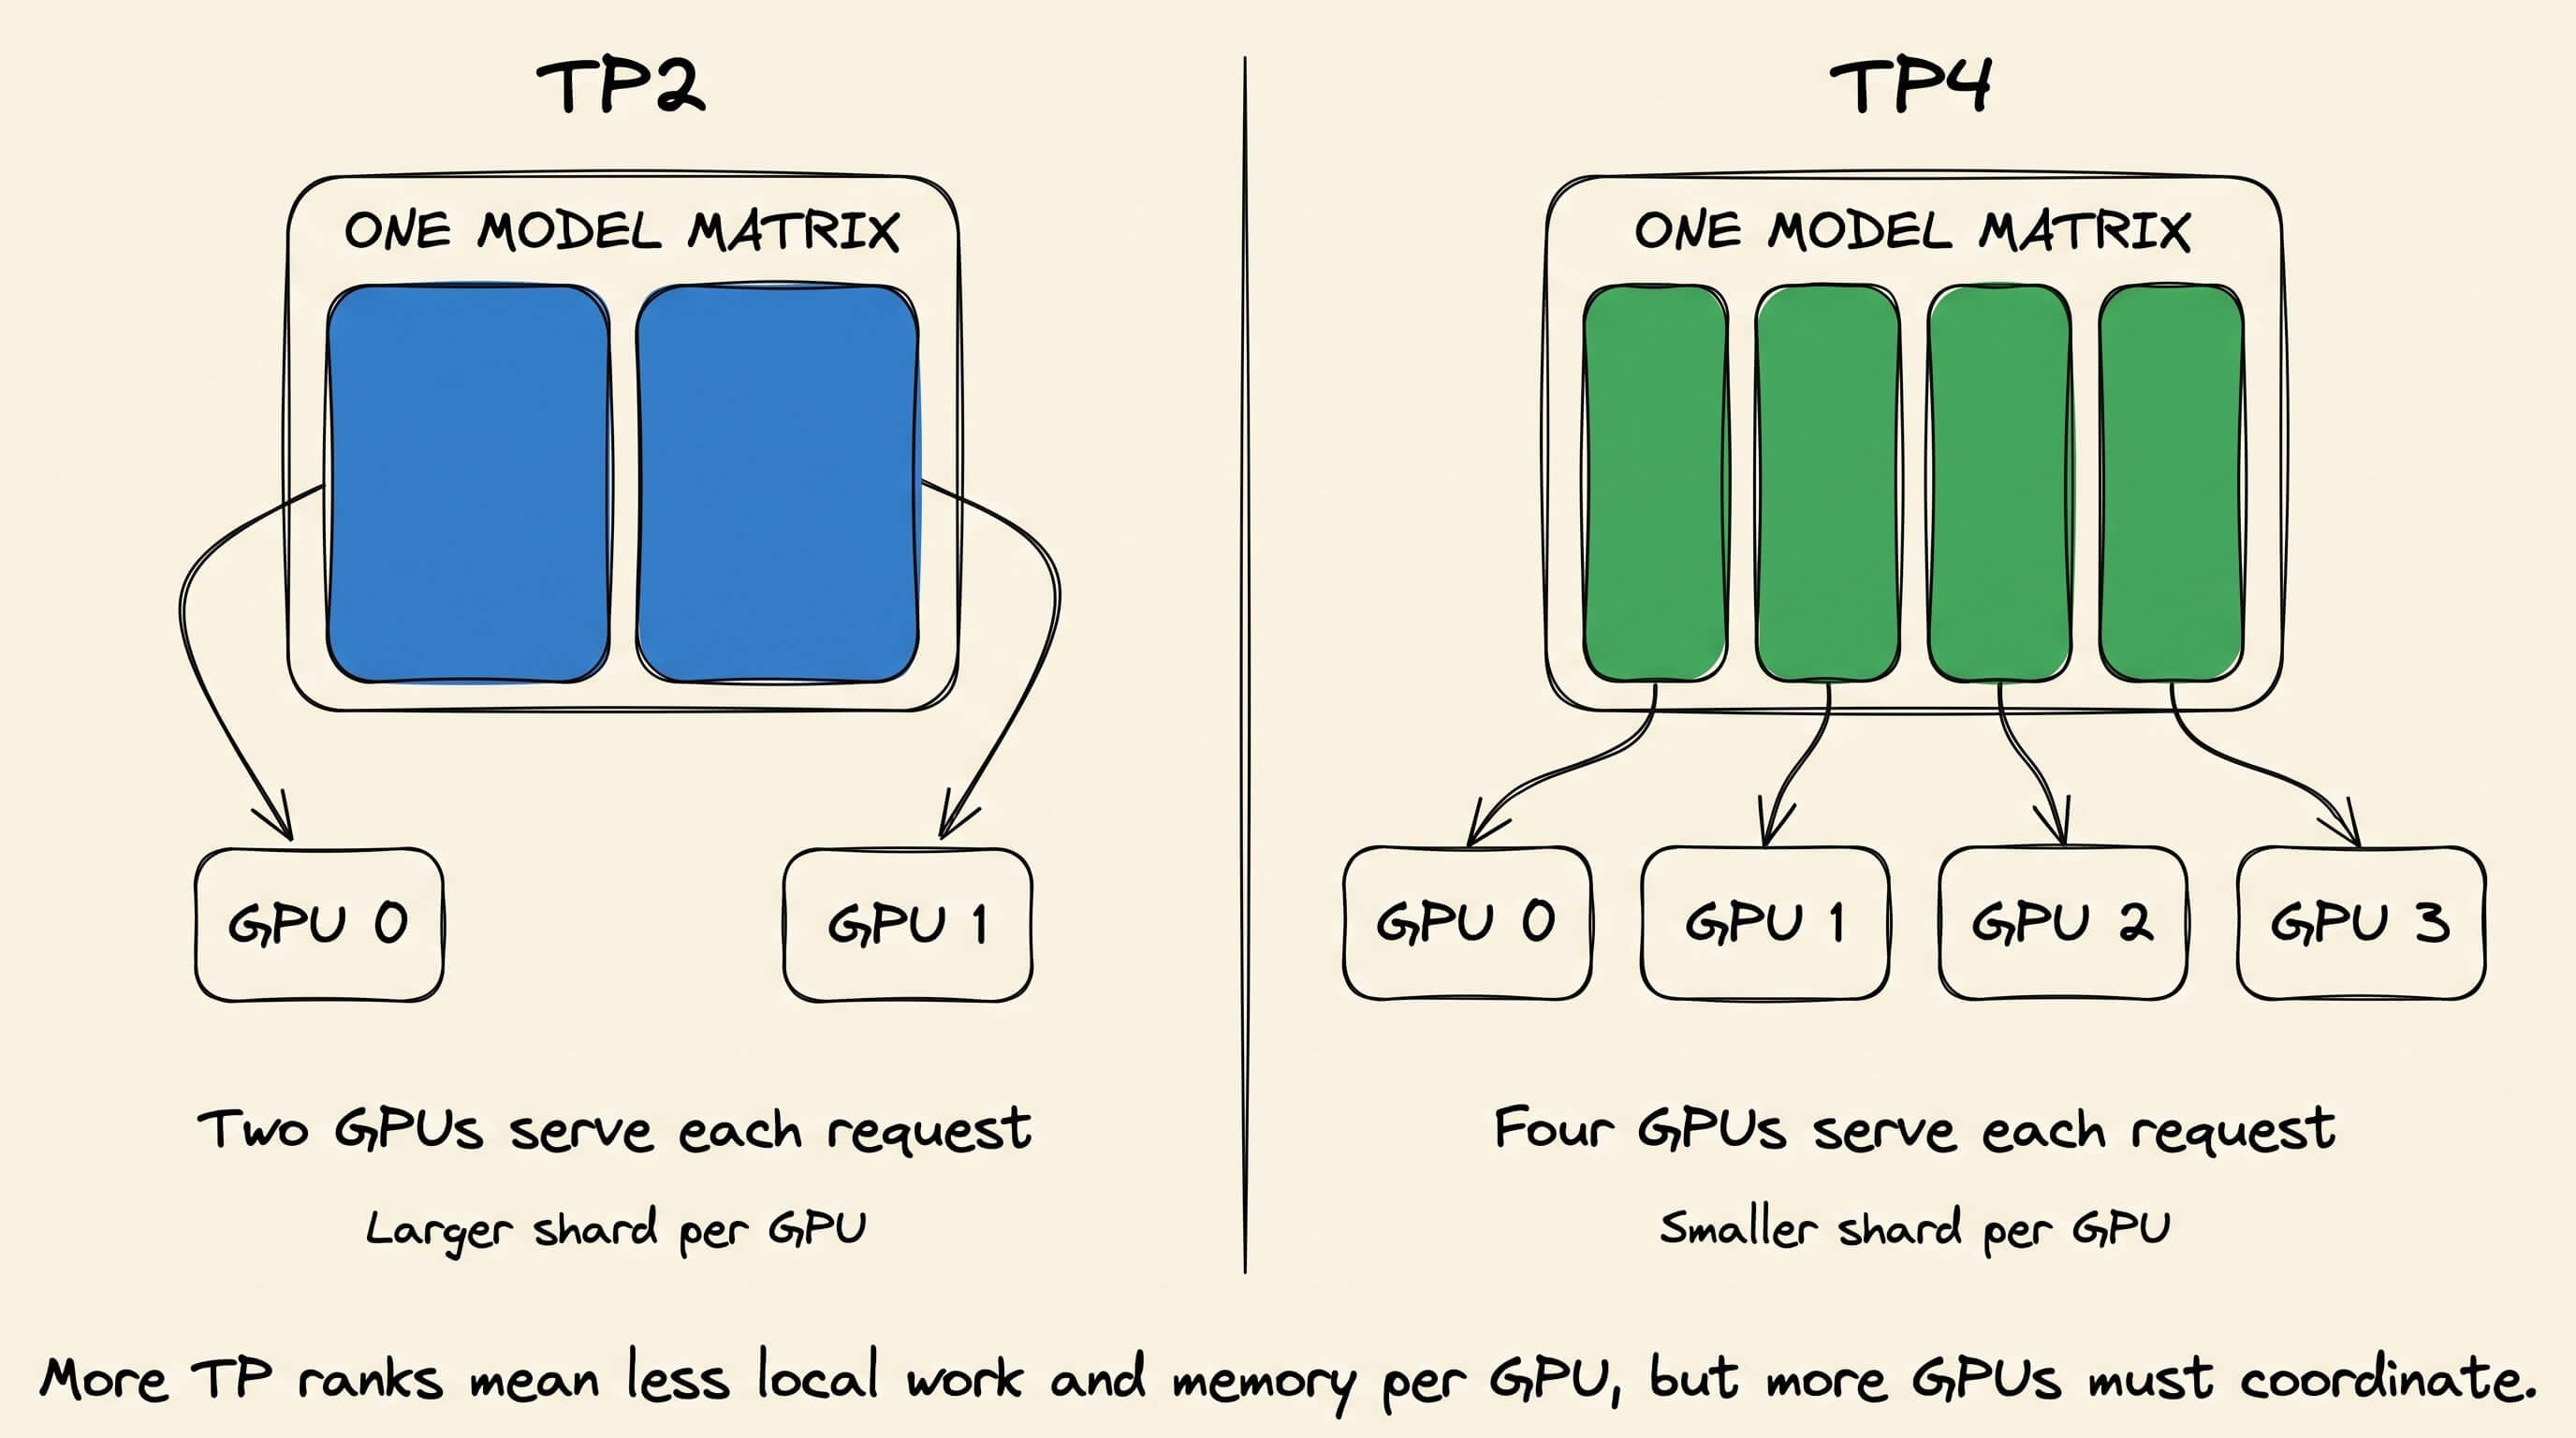
提高 TP 度数意味着什么。 一个有 8192 个输出列的矩阵:TP2 每个 rank 分到 4096 列,TP4 分到 2048 列。每块 GPU 存的权重更少、算的矩阵乘更小——听起来是纯收益,但这一层不能拿着分离的部分结果继续往下走,各 rank 必须交换或合并它们。TP4 每个 rank 的本地工作更少,参与的 rank 却是 TP2 的两倍;快不快,取决于省下的计算和多出的通信之间的平衡。
部署检查
- 模型是不是真的放下了。 切分只减少被切的那些权重矩阵的内存,其他分配可能在每个 rank 上保持复制。测每块 GPU 的峰值内存。
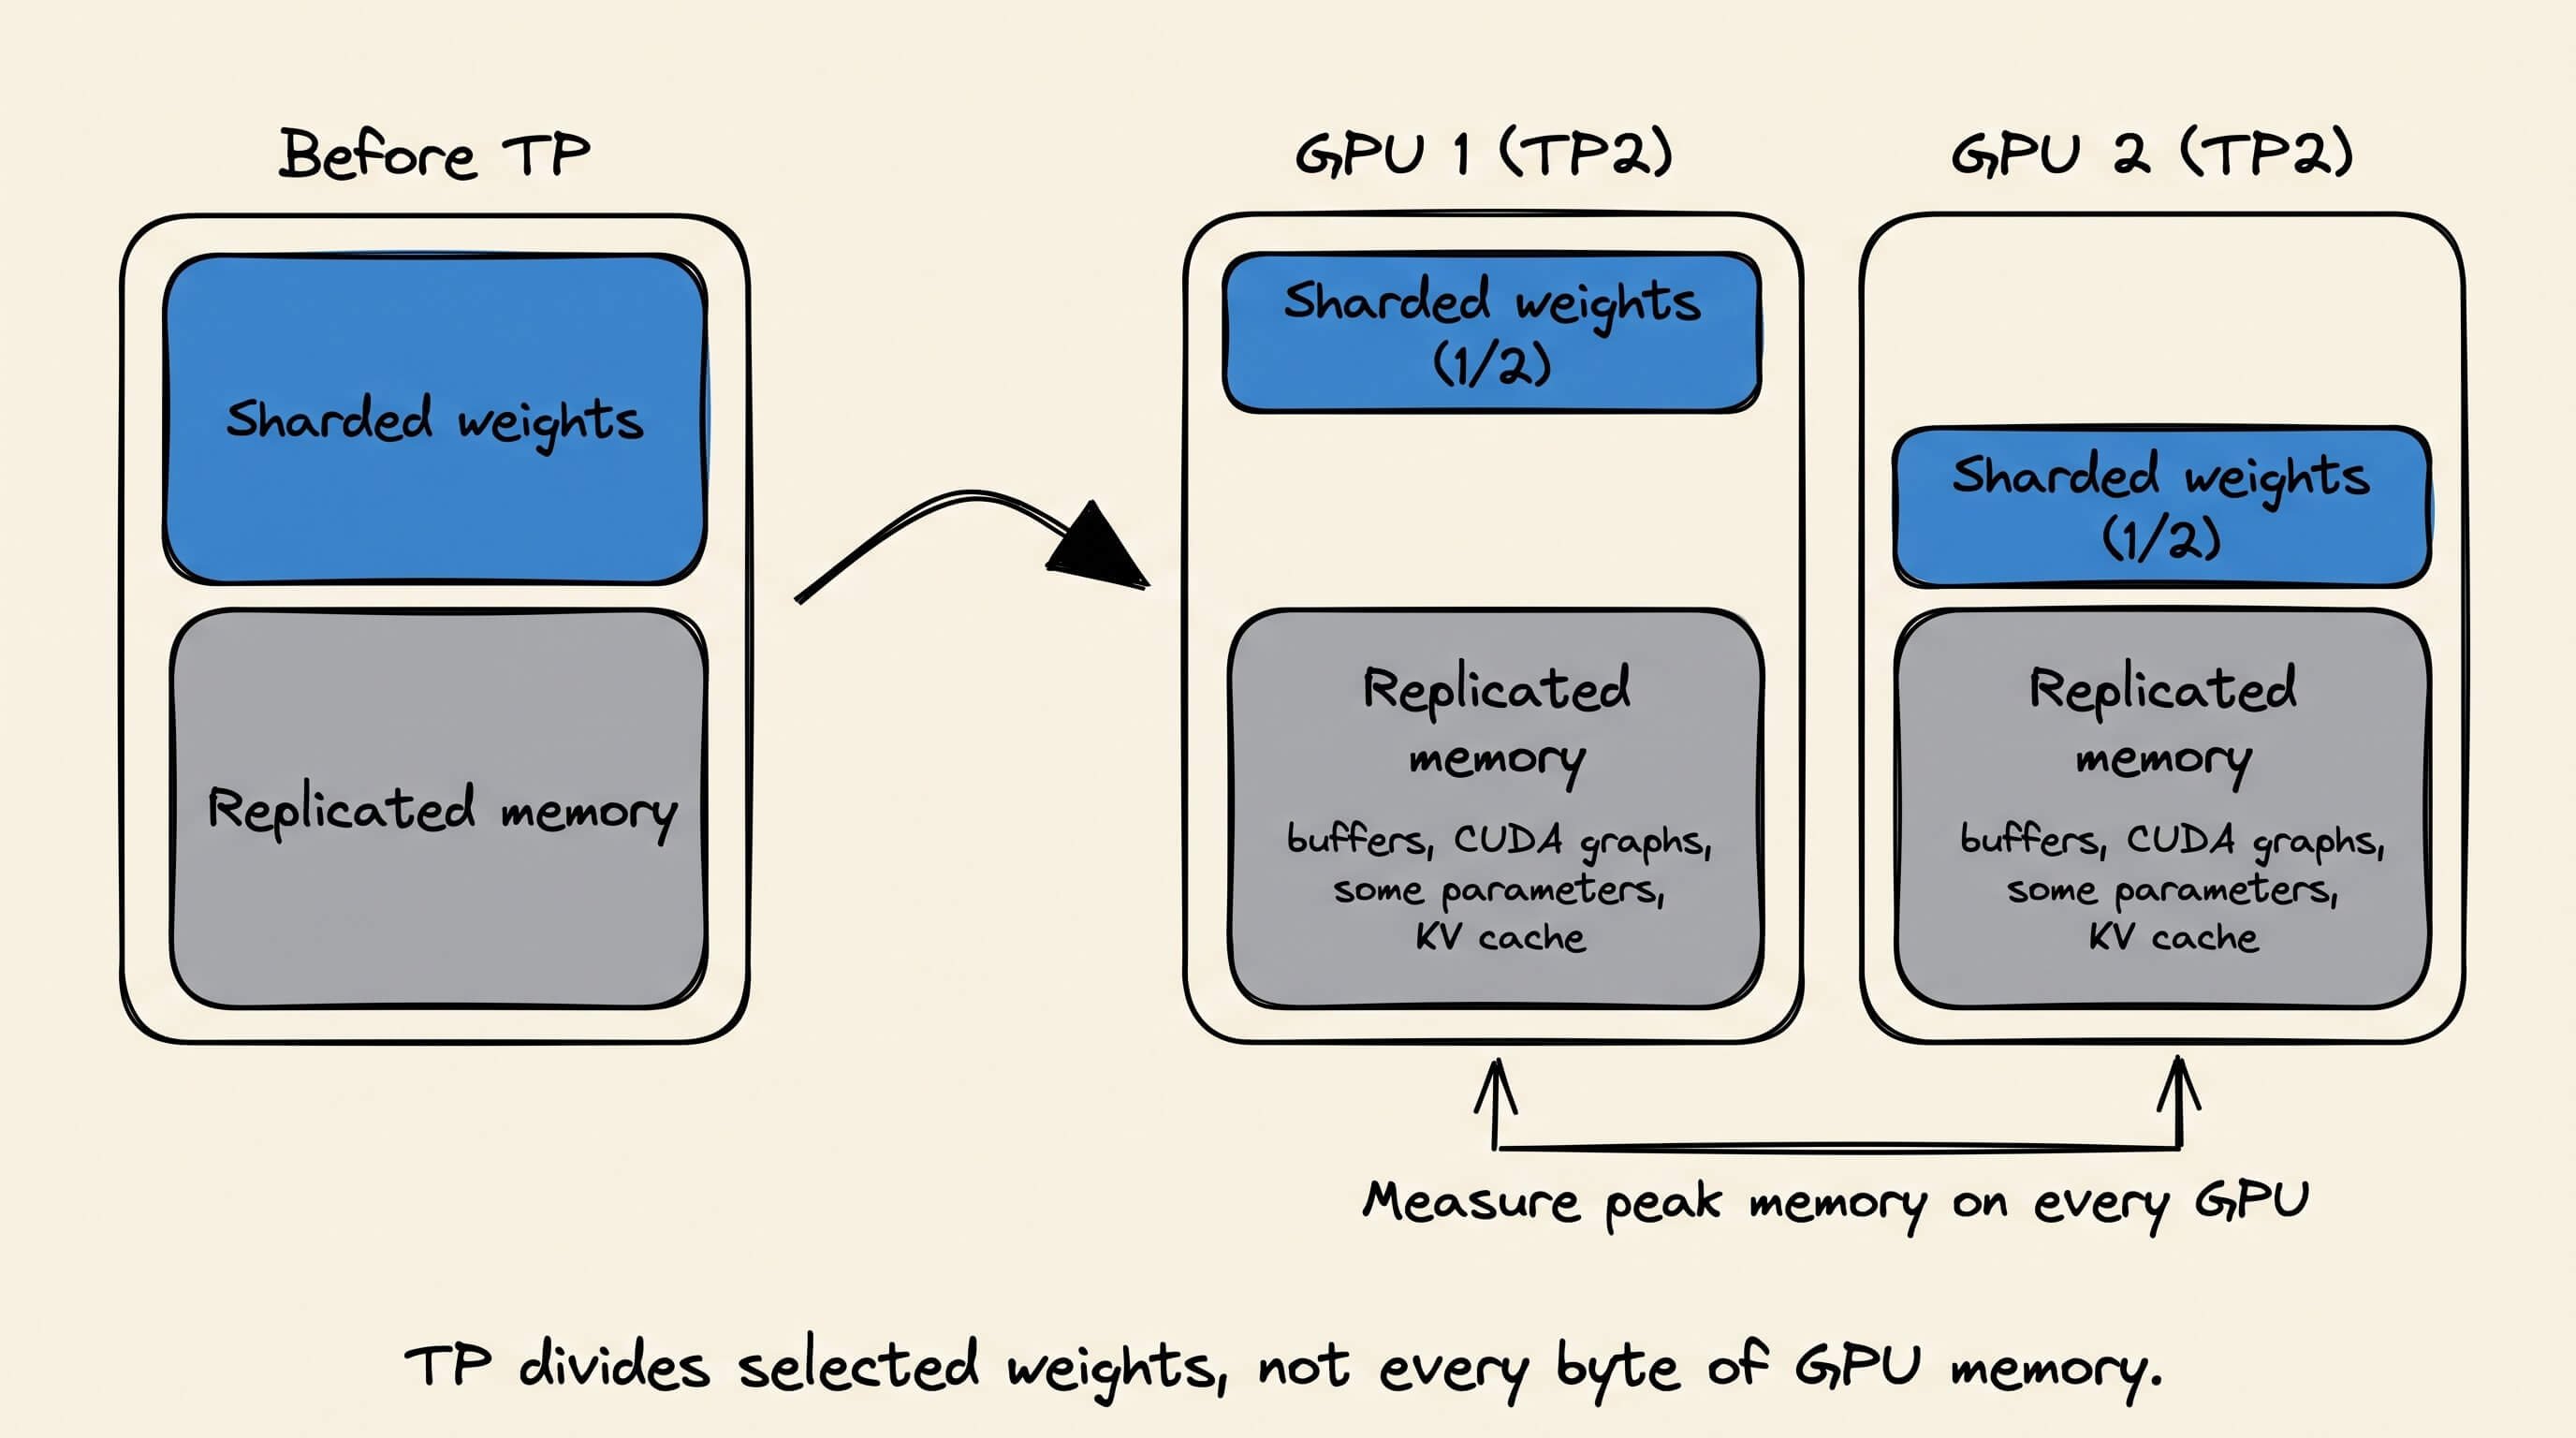
- 各 rank 花在通信上的时间。 张量并行的集合通信在很多 Transformer 层内部合并部分结果,慢链路会让 GPU 在每次本地计算之后等待——预填充和每一个解码步都会等。
- 每个 rank 是否还有足够的工作。 GPU 之所以高效,是因为大矩阵乘天然暴露大量并行工作。TP 度数越高,每个本地矩阵越小;到某个点,更小的计算用不满 GPU,而集合通信照样发生。注意力头和量化布局还有额外约束——一个头或一个量化组可能必须完整留在一个 rank 上,所以模型形状和服务引擎决定了哪些 TP 度数是合法的。
TP2 在大预填充上可以胜过单卡,因为两个 rank 都拿到了大量工作;TP4 在计算仍占主导时可能进一步帮忙,但当更小的本地算子不再能覆盖增加的通信时也可能更慢。解码会更早到达这个点,因为一个 token 提供的矩阵工作比一段长提示词少得多。
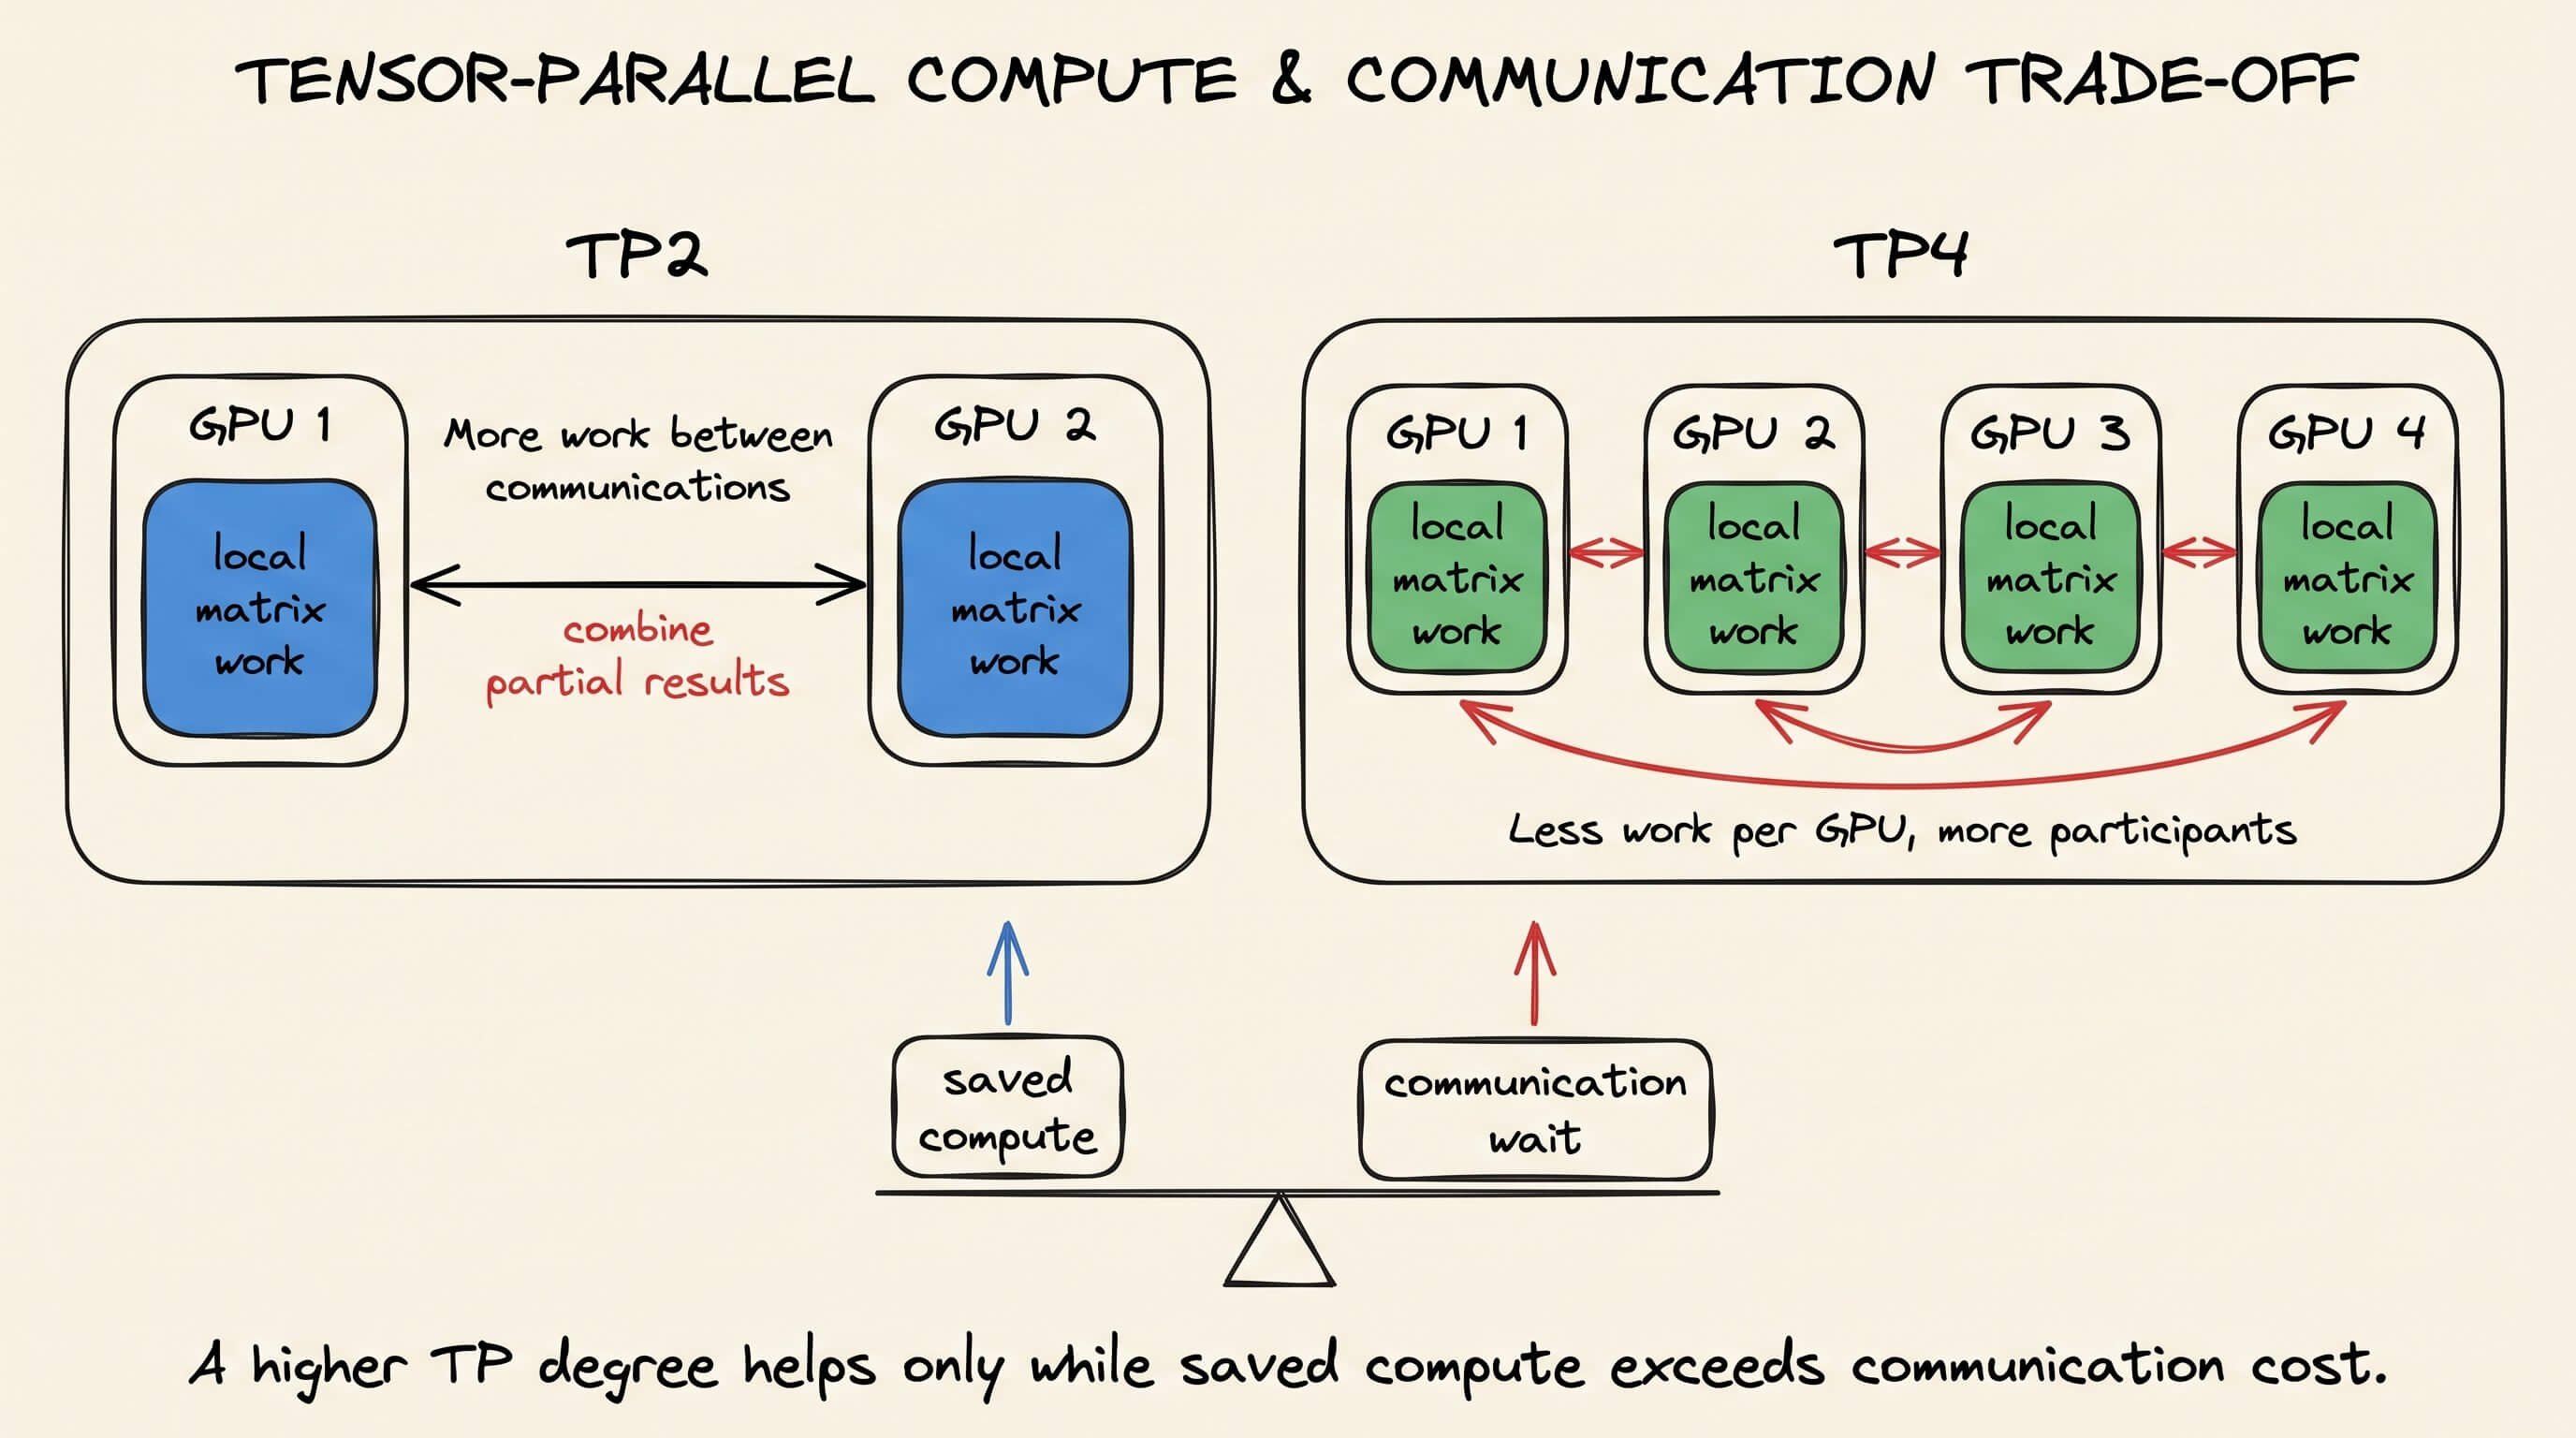
工程规则: 用满足内存和延迟要求的最小张量并行度,每升一级都重新测。rank 之间的链路决定通信成本——NVLink/NVSwitch 和跨节点网络在延迟和带宽上差别很大。
在四卡服务器上: 模型需要两张卡,所以从 TP2 开始。如果 TP2 满足延迟目标,剩下两张卡组成第二个 TP2 副本来提吞吐;只有 TP2 仍然过不了内存或单请求延迟的要求时才升到 TP4——TP4 把四张卡全花在每个请求上,也就失去了跑第二个副本的选项。
什么时候不要用: 不要仅仅因为"还有卡空着"就加度数。张量并行解决的是单副本放不下、或者实测的单请求算力瓶颈。
3)流水线并行(PP):按深度切层
卡片
- 切分的:模型按深度切成连续的层组,每组一个阶段。
- 复制的:权重不复制,每个阶段的权重留在自己的 GPU(或张量并行组)本地。
- 跨互连的:阶段边界上的隐藏状态(激活)。
- 频率:只在执行从一个阶段移到下一个阶段时传,比张量并行低得多。
- 改善的:跨慢链路的放置;不会自动降低单请求延迟,因为请求仍要依次走完所有阶段。
当张量并行每层的集合通信要跨一条慢链路时,它就贵了。如果模型必须横跨连接较弱的 GPU,流水线并行给出另一种放置:阶段 0 跑第一组层,把隐藏状态发给阶段 1;最后一个阶段跑最后一组层并产出 logits。
这和训练里的流水线不同:推理没有反向传播,连续批处理可以让多组请求同时在流水线里移动——但一个自回归序列仍然依赖它前面的 token。
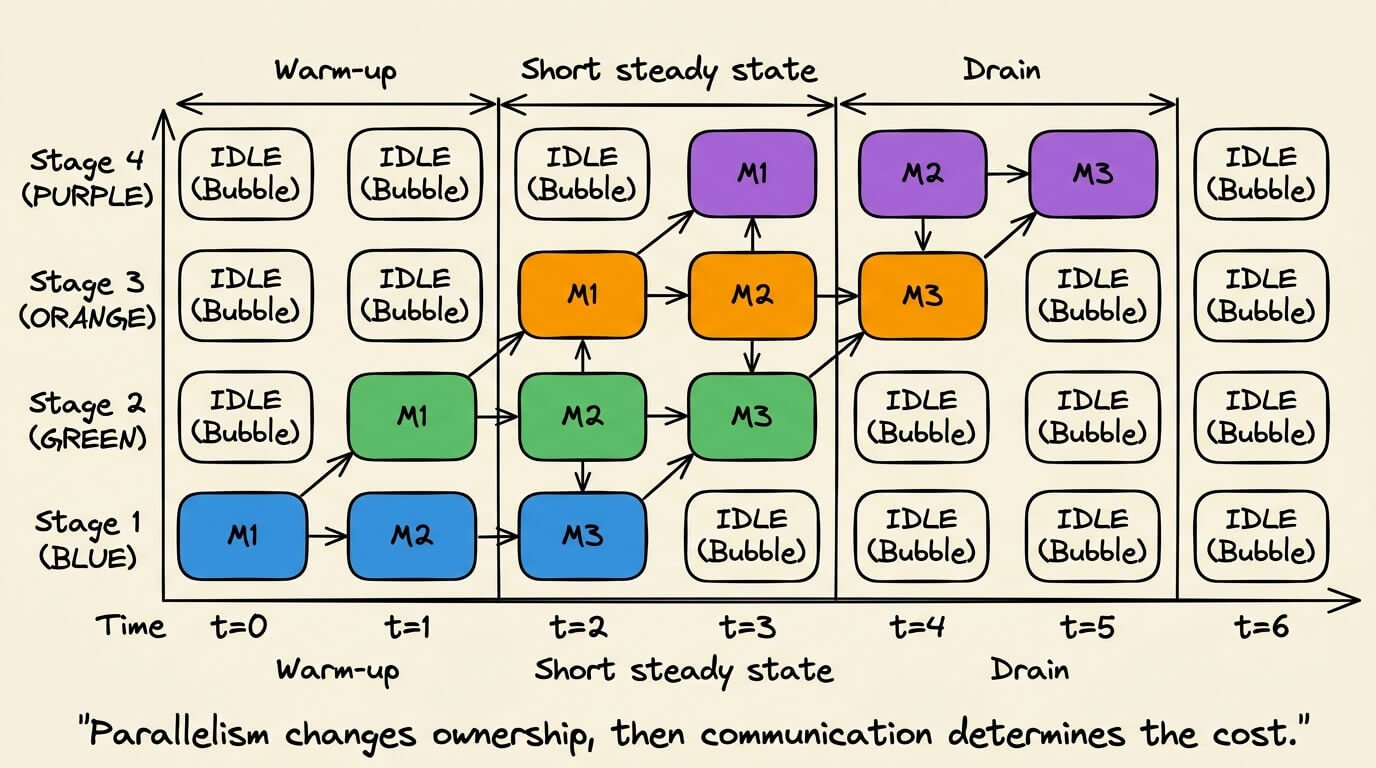
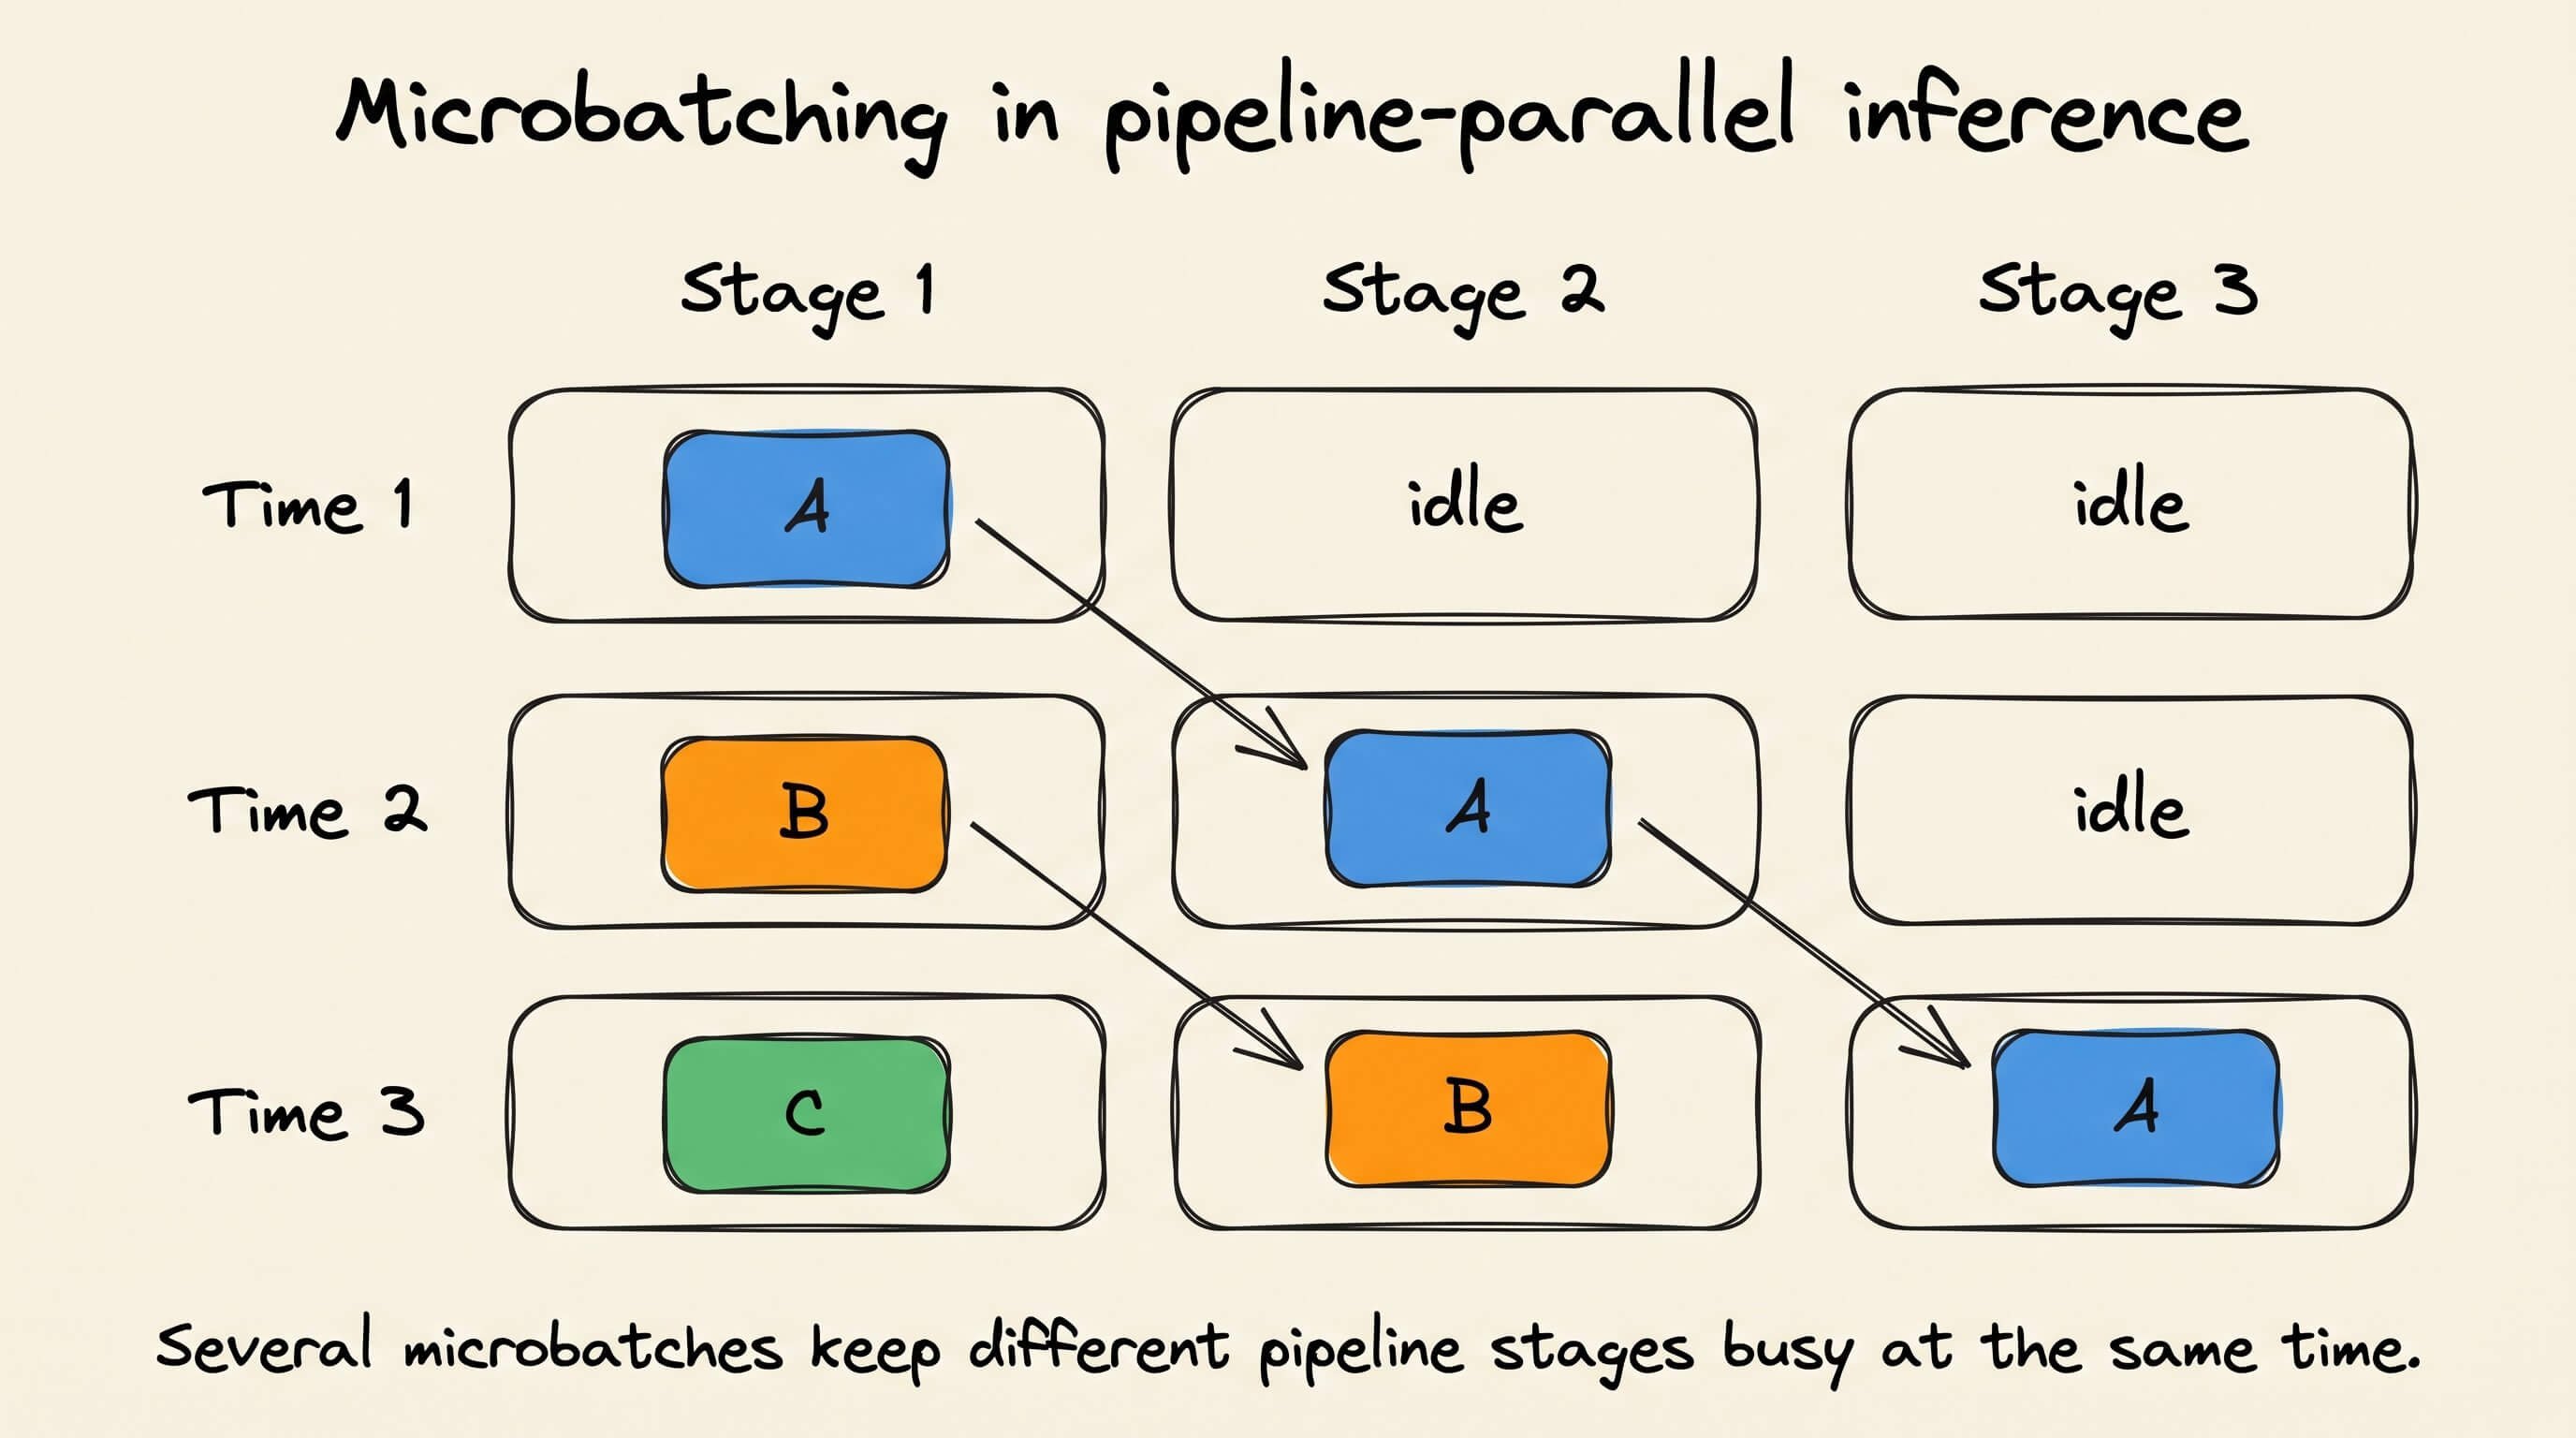
微批次给各阶段提供独立的工作。在线服务时,微批次里可能是不同的请求;连续批处理随着请求完成而改变成员,调度器要在填补空位的同时维持流水线顺序。
部署检查
- 工作负载能不能提供足够多的独立请求,让各阶段都忙起来。 预热和排空期间阶段是空闲的;微批次太少会放大这个空闲比例,轻负载的在线服务可能一次只有一个阶段在干活。
- 阶段平衡。 80 层的模型在 PP4 下"每阶段 20 层"看起来均匀,但层数相等不代表执行时间和内存相等——嵌入层、输出层、异构块都会扭曲这个切分。最慢的阶段决定吞吐,快的阶段在等。工程规则:用实测的执行时间和内存来平衡阶段,等层数只是初始放置。
- 激活缓冲和运维成本。 请求在流水线里移动时激活一直活着;调度器要维持顺序;一个阶段挂掉影响整个模型实例。
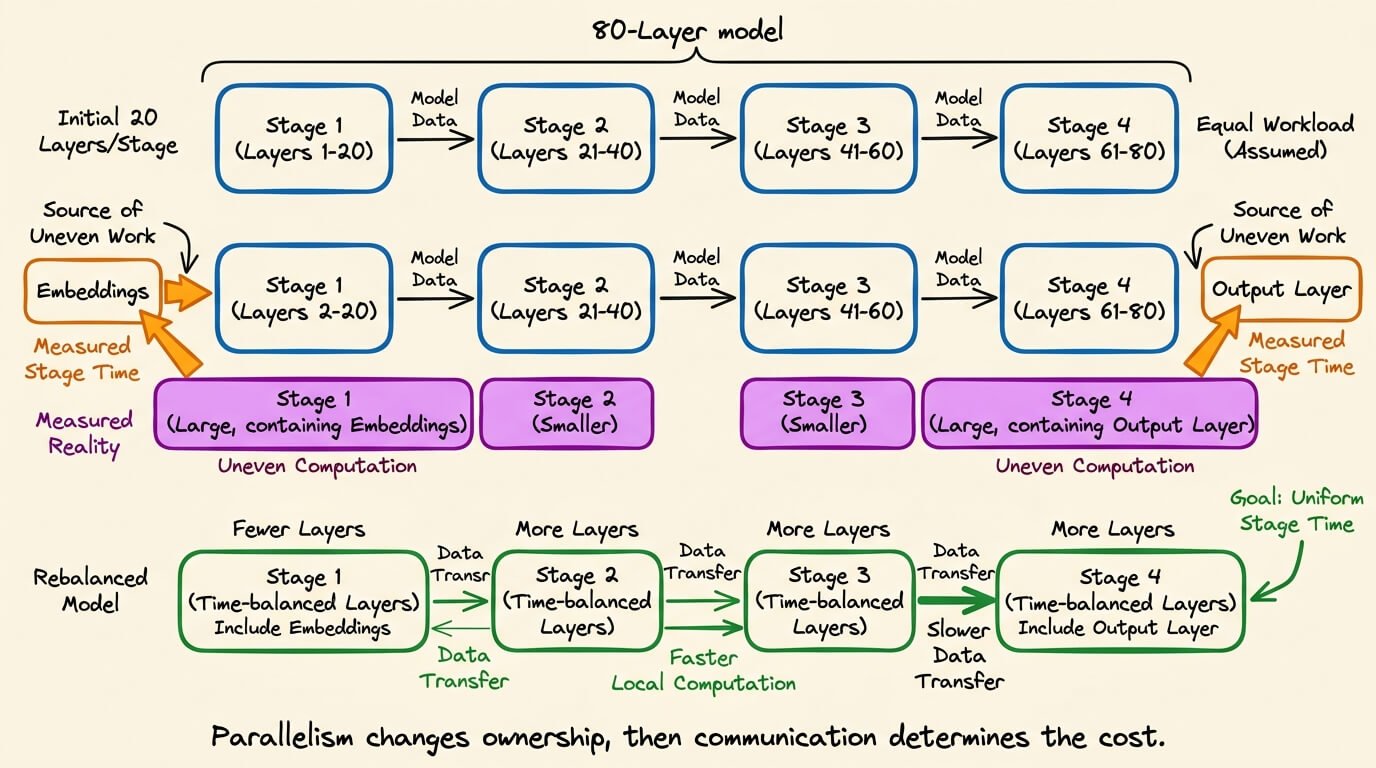
在四卡服务器上: 只有当模型需要全部四张卡、而且在途请求多到能填满四个阶段时,PP4 才合理。如果硬件是两对快速互联的 GPU、中间一条慢路径,那么 PP2 + 每阶段内部 TP2 可以把频繁的张量集合通信留在每一对内部,只让激活穿过慢边界。
什么时候不要用: 低并发流量,除非模型放置别无选择。
4)上下文并行(CP):切序列位置
卡片
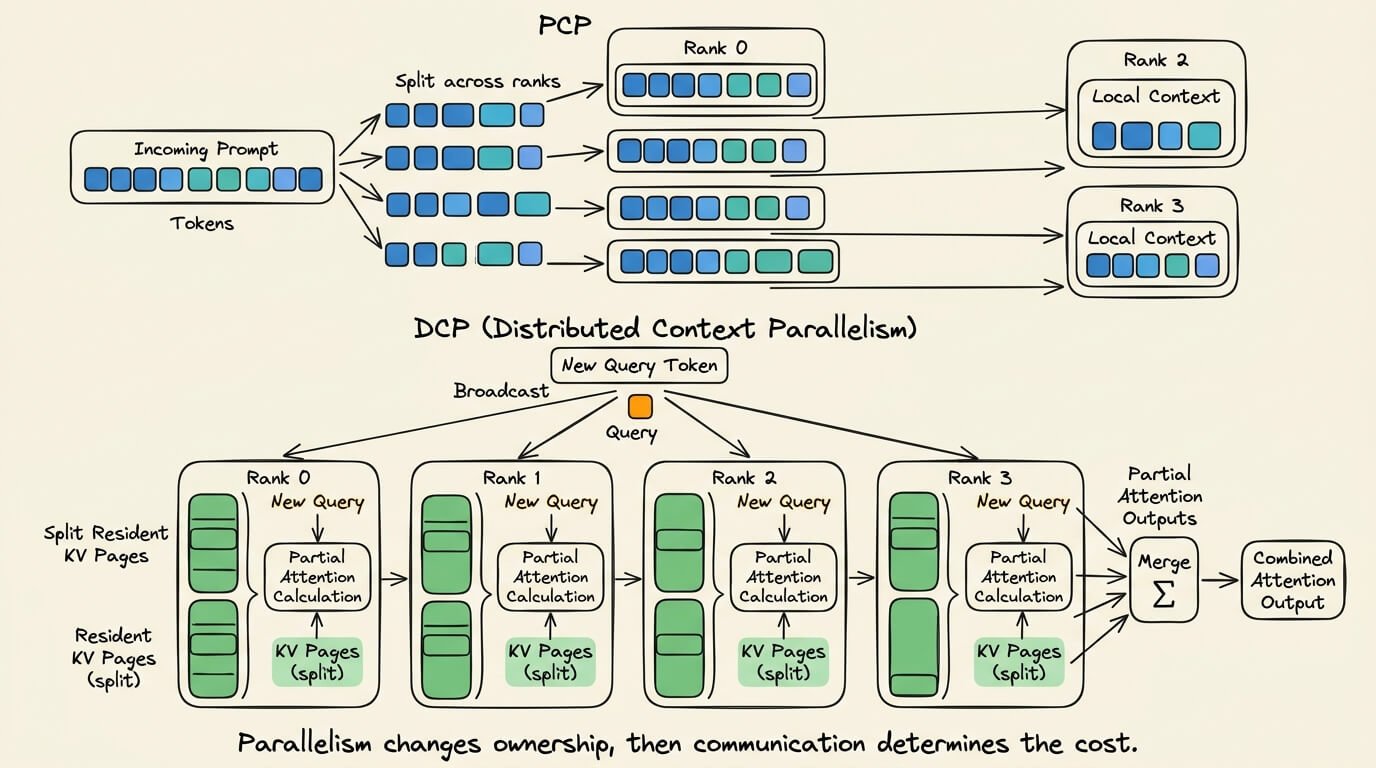
- 切分的:序列位置——预填充切的是提示词 token(PCP),解码切的是已存储的 KV 历史(DCP)。
- 复制的:模型权重。
- 跨互连的:PCP 传 K/V 块(收集或环形传递);DCP 传部分注意力输出和 softmax 统计量。
- 频率:PCP 在预填充阶段要几轮通信;DCP 在每个解码步的每个解码层都要合并一次。
- 改善的:PCP 改善长提示词的 TTFT;DCP 改善 KV 容量(能常驻的 token 和并发)。
假设权重已经放下了,但长上下文请求仍然过不了两项测试之一:大提示词在预填充阶段错过 TTFT 目标,或者它的 KV 缓存吃掉太多内存,解码时活跃请求太少。上下文并行切的是序列位置而不是权重,而这两种失败需要不同的机制。
预填充上下文并行(PCP) 把提示词 token 分到各 rank,每个 rank 为自己那段 token 计算 Q、K、V;但注意力仍然要让每个查询看到它需要的所有键和值。一种实现是在每个 rank 上收集完整的 K/V,用本地查询对完整历史求注意力——只在收集后的张量放得进内存时可行。另一类是环形传递部分 K/V 块:Ring-attention 风格的算法增量地合并部分注意力结果,不必在每处物化完整序列,代价是多轮通信。
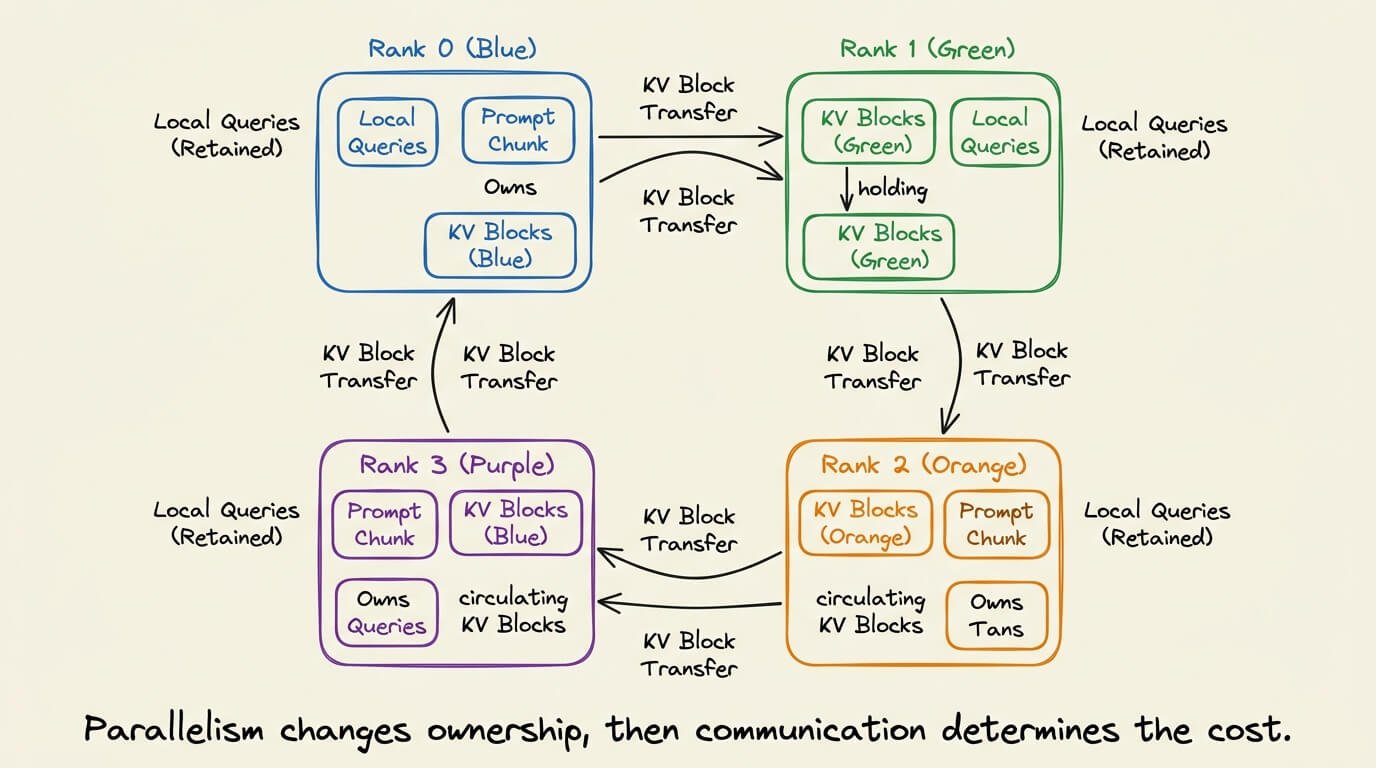
实际问题是 PCP 在哪个点从"开销"变成"收益"。按提示词长度分桶测 TTFT,不要只测最大上下文长度:长提示词可能有足够的注意力工作来抵消交换开销,短提示词通常没有,所以混合服务可以只把长上下文请求路由到启用 PCP 的 worker。
解码上下文并行(DCP) 按序列位置切存储的 KV 缓存。每个 rank 只对自己的本地历史求注意力,然后各 rank 合并部分注意力输出和 softmax 统计量:
import numpy as np

def merge_attention_partials(partials):
    global_max = max(part.maximum for part in partials)
    scales = [np.exp(part.maximum - global_max) for part in partials]
    denominator = sum(
        scale * part.exponential_sum
        for scale, part in zip(scales, partials, strict=True)
    )
    numerator = sum(
        (
            scale * part.weighted_value
            for scale, part in zip(scales, partials, strict=True)
        ),
        start=np.zeros_like(partials[0].weighted_value),
    )
    return numerator / denominator
每个 rank 报告本地最大值、指数和、加权值之和;全局最大值在最终归约前重新缩放每一份贡献,保证跨 KV 分片的 softmax 稳定。需要最大值是因为指数可能溢出——减去全局最大值让每个指数最多为 1。本地运行得到:
merged_attention_output = [0.769627, 0.779901]
完整注意力计算给出同样的结果:切分 KV 历史不改变测试输入上的注意力输出,缩放后的分母和加权值之和在正常浮点容差内重建了未切分的结果。
DCP 的部署检查
- 内存。 记录切分前后的常驻 KV token 数和最大并发。
- 解码成本。 每个解码层都要合并部分注意力结果,TPOT 可能上升。只有多出来的 KV 容量或支持的上下文长度值得这次反复合并,DCP 才划算。
序列并行是相关但不相同的概念:Megatron 风格的序列并行通常围绕归一化等操作切激活,上下文并行切的是注意力的上下文位置。各框架对这两个标签的用法并不一致。
在四卡服务器上: 普通聊天留在基线的 TP2 副本上;如果提示词长度测试显示 TTFT 有改善,把偶发的长提示词路由到启用 PCP 的组。只有当限制活跃请求数量或长度的是 KV 内存——而不是权重内存或算力——才加 DCP。
什么时候不要用: PCP 解决长提示词的算力问题,DCP 解决长历史的存储问题。把它们当作两个独立决定;没有提示词长度或 KV 容量的测量支持,两个都别开。
5)专家并行(EP):切专家
卡片
- 切分的:MoE 层里的专家,不同专家放在不同 rank 上。
- 复制的:模型的稠密部分(注意力、嵌入等)——EP 不决定它们怎么放,它们可以另外用 DP 或 TP。
- 跨互连的:token 表示发给拥有对应专家的 rank,再把输出送回来,是依赖数据的 all-to-all。
- 频率:每个 MoE 层都有,传多少字节取决于路由器选了哪些专家。
- 改善的:专家权重的内存。
专家并行只适用于含混合专家层的模型。那种情况下,即使每个 token 只用少数几个专家,把每个专家都存在每张 GPU 上也可能占掉大部分参数内存。
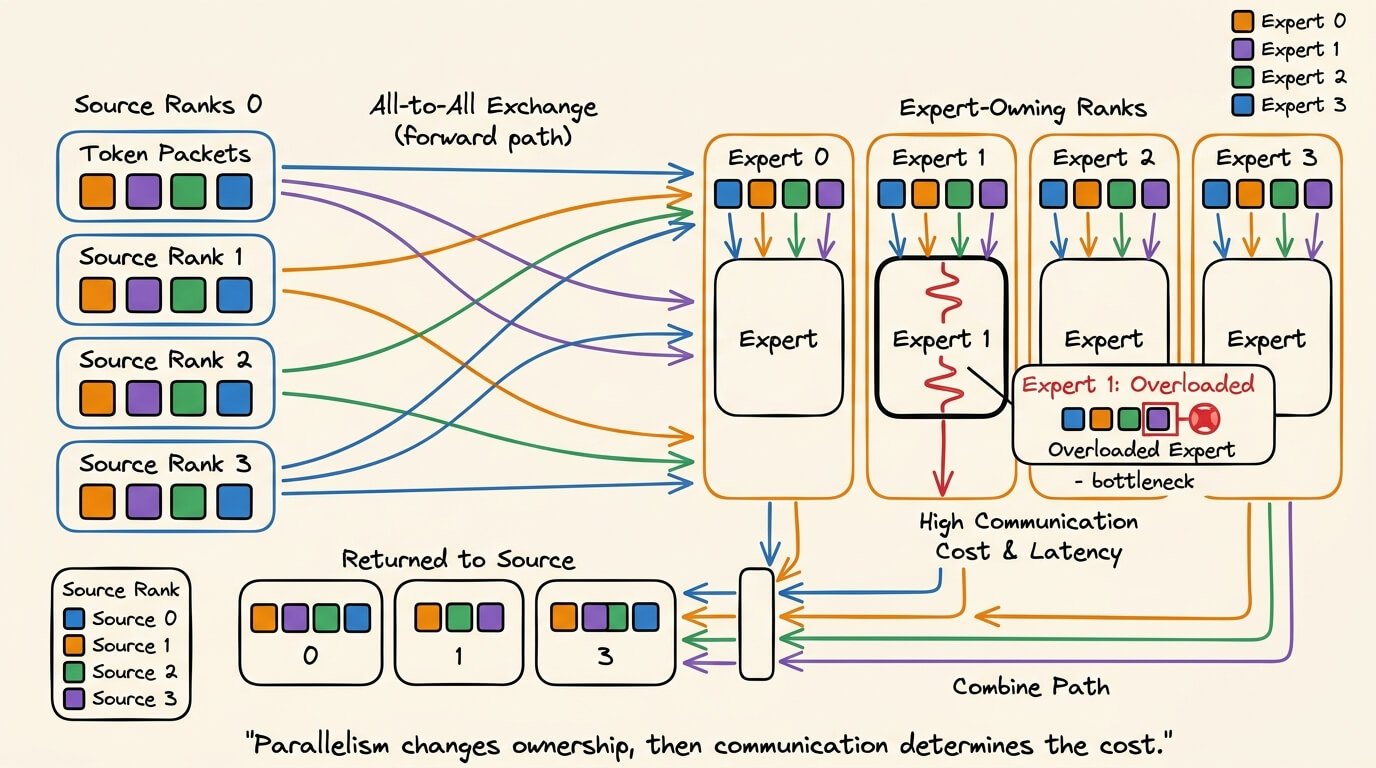
运行时路由器为每个 token 选专家,系统把 token 表示发到拥有这些专家的 rank,跑本地的专家网络,再把输出送回。放置省了内存,但在请求路径上放进了依赖数据的 all-to-all 流量。
部署检查
- 放置。 数每个 rank 的专家权重内存,并验证共享的注意力、嵌入、缓冲区和 KV 缓存仍然放得下。
- 路由流量。 和稠密的张量并行不同,传输的字节数取决于路由器选了谁。用真实的提示词分布测每个 rank 发出的字节数和 all-to-all 时间。
- 不均衡。 token 数在专家之间可能倾斜,而集合通信要等最忙的 rank 做完才结束——平均负载会掩盖这个掉队者。测每个专家的最大 token 数、本地专家时间和算完之后的等待时间。专家容量、填充和负载均衡策略既会改变运行时间,也会(在丢 token 的时候)改变模型行为。
在四卡服务器上: MoE 模型可以把四分之一的专家分到每张卡,注意力和其他稠密运算用 TP 或 DP。注意力层和专家层不必用同一种切法。
什么时候不要用: 专家集合本来就轻松放得下,或者 all-to-all 已经主导层时间。验证 EP 要看每个 rank 的路由和不均衡测量,不能只看平均 token 吞吐。
四、组合起来:混合并行的叠加顺序
单一方法往往只解决部署问题的一部分:张量并行让模型在节点内放下,流水线并行把它扩到跨节点,数据并行再加够副本去接请求速率。混合布局把这些选择组合起来,但每多一个维度,就多一套调度器或通信路径。对独立的稠密模型组,worker 数是数据、流水线、张量并行度的乘积。
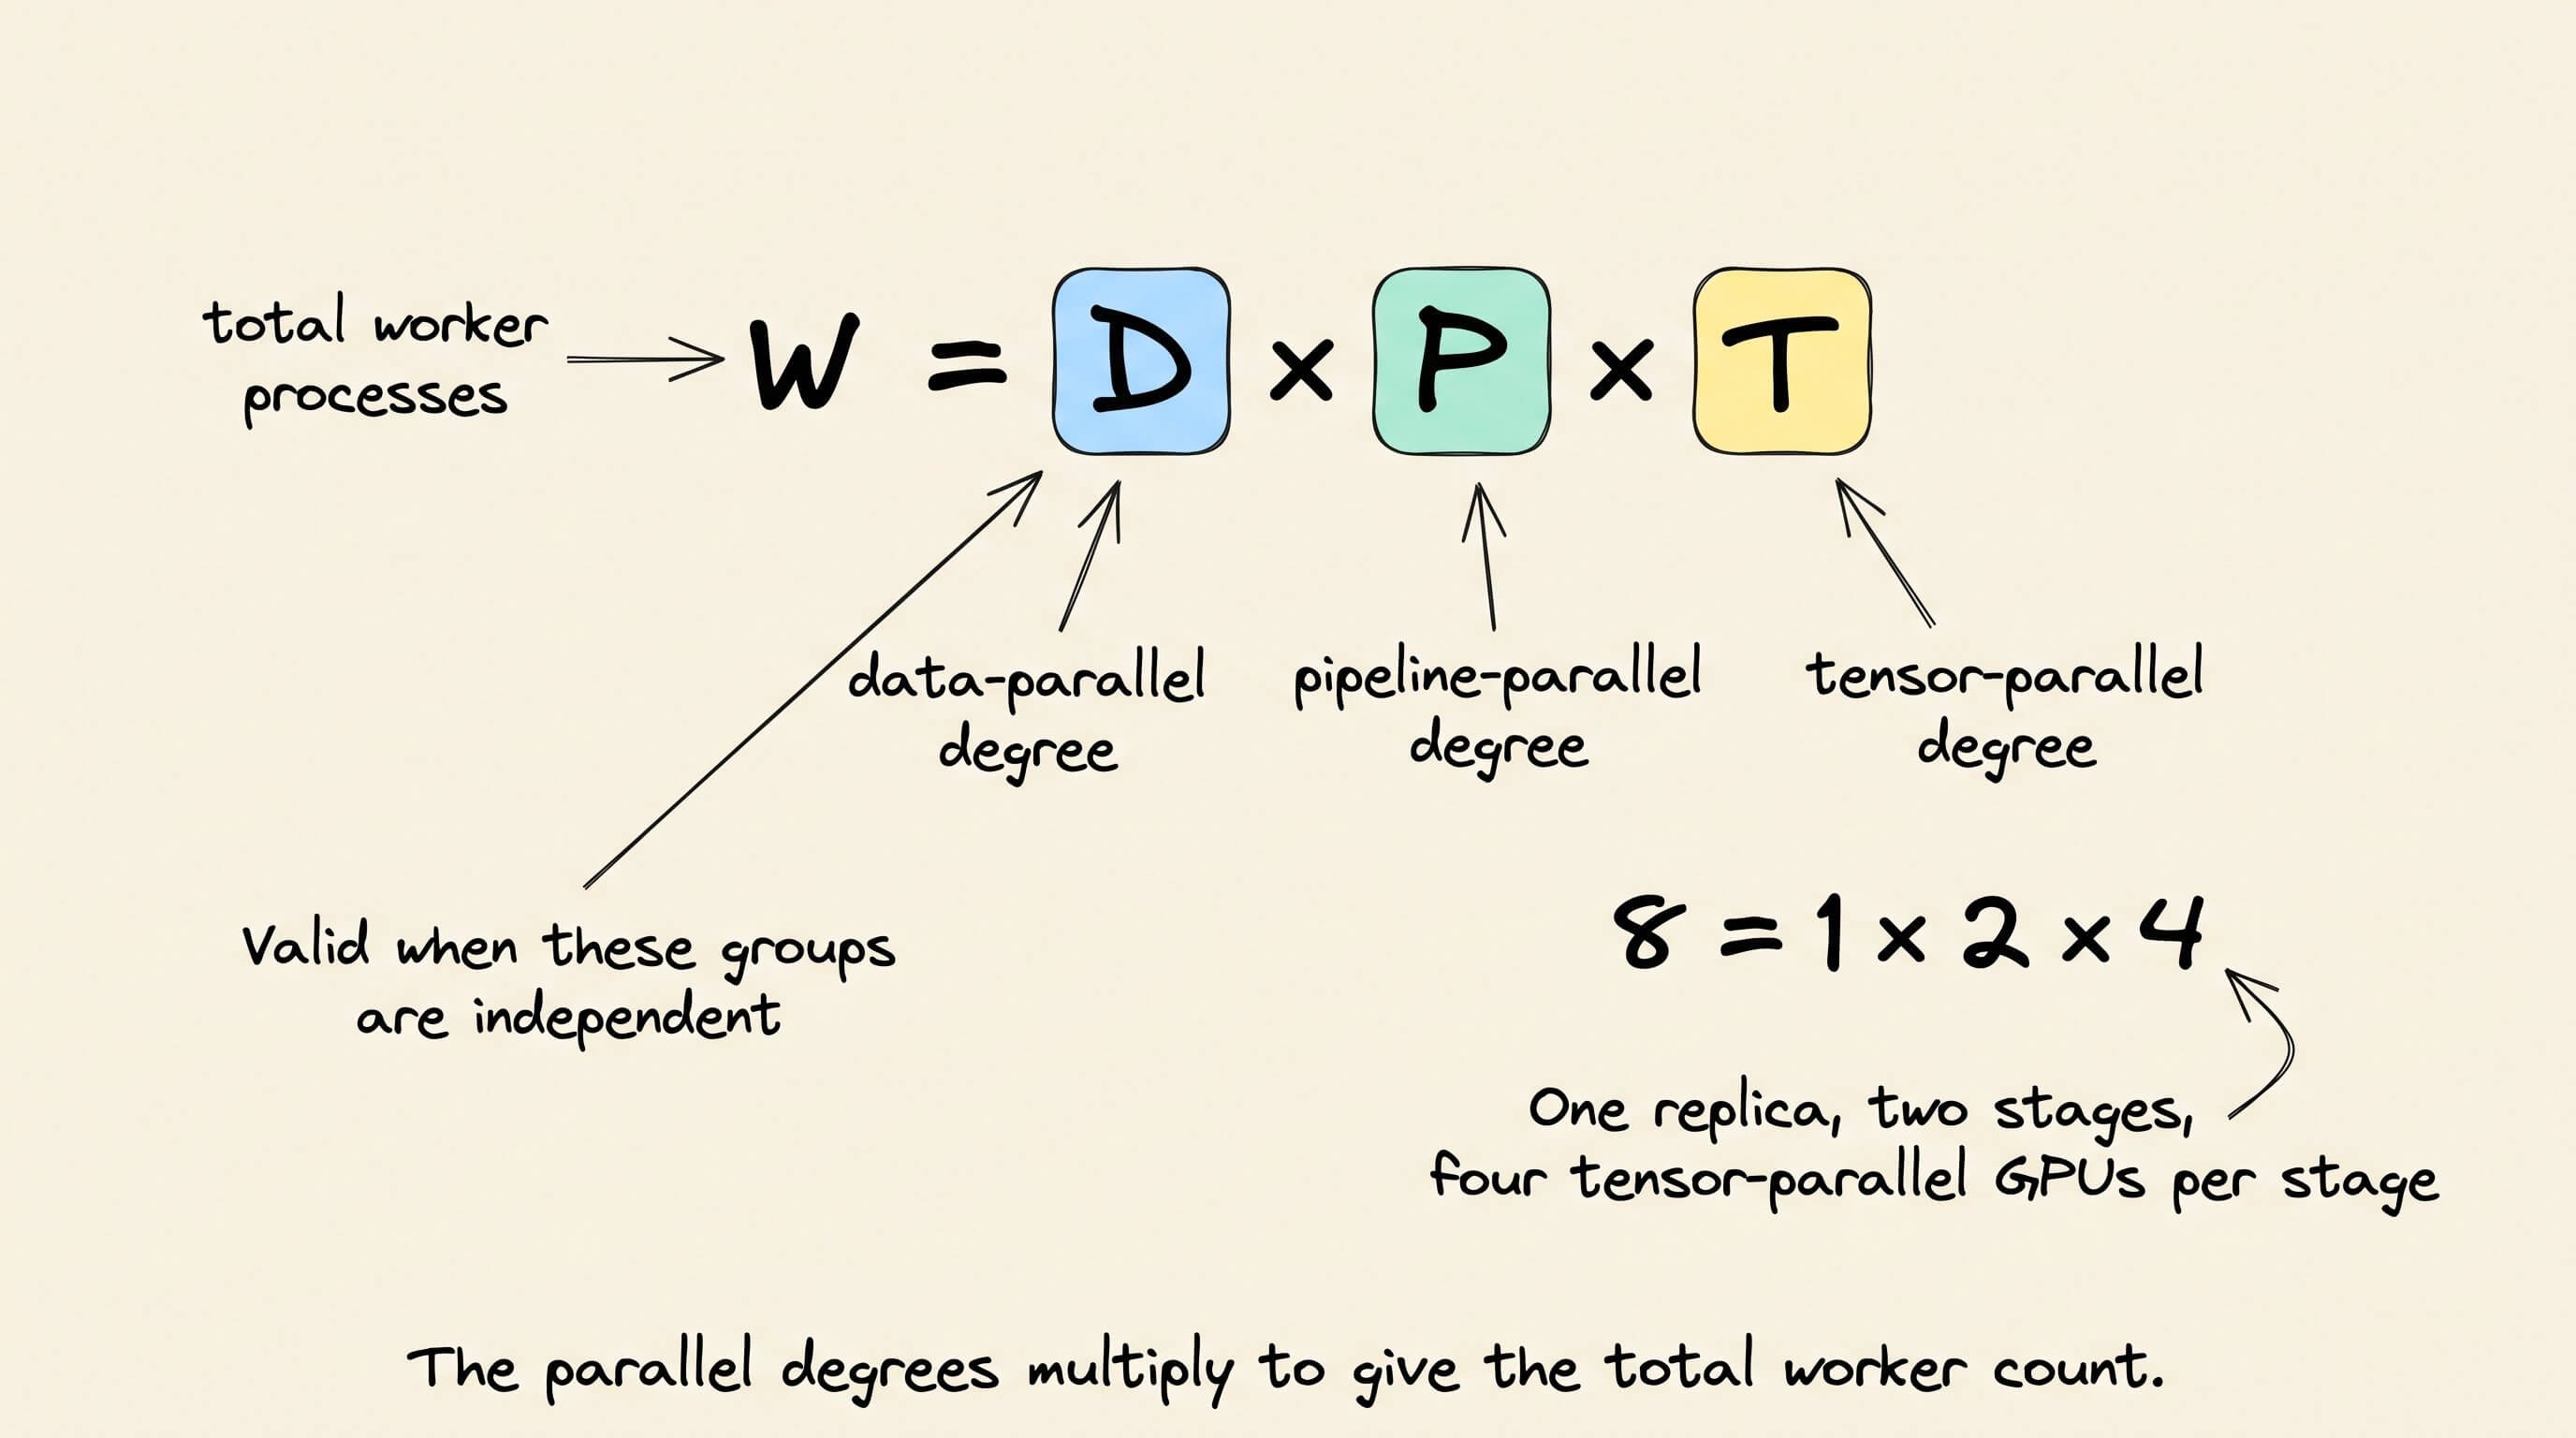
(有些上下文并行方法复用已有的 rank;专家组和数据组的交互方式也可能不同。)
一个八卡的例子。 两个四卡节点,节点内链路带宽更高、延迟更低。
- 候选布局一:节点内 TP4,节点间 PP2。频繁的层内集合通信留在本地,只有阶段边界的激活穿过慢网络,八张卡扩成一个模型实例。
- 候选布局二(模型在四张卡上放得下时):节点内 TP4,节点间 DP2,两个副本,请求不再依赖跨节点路径。
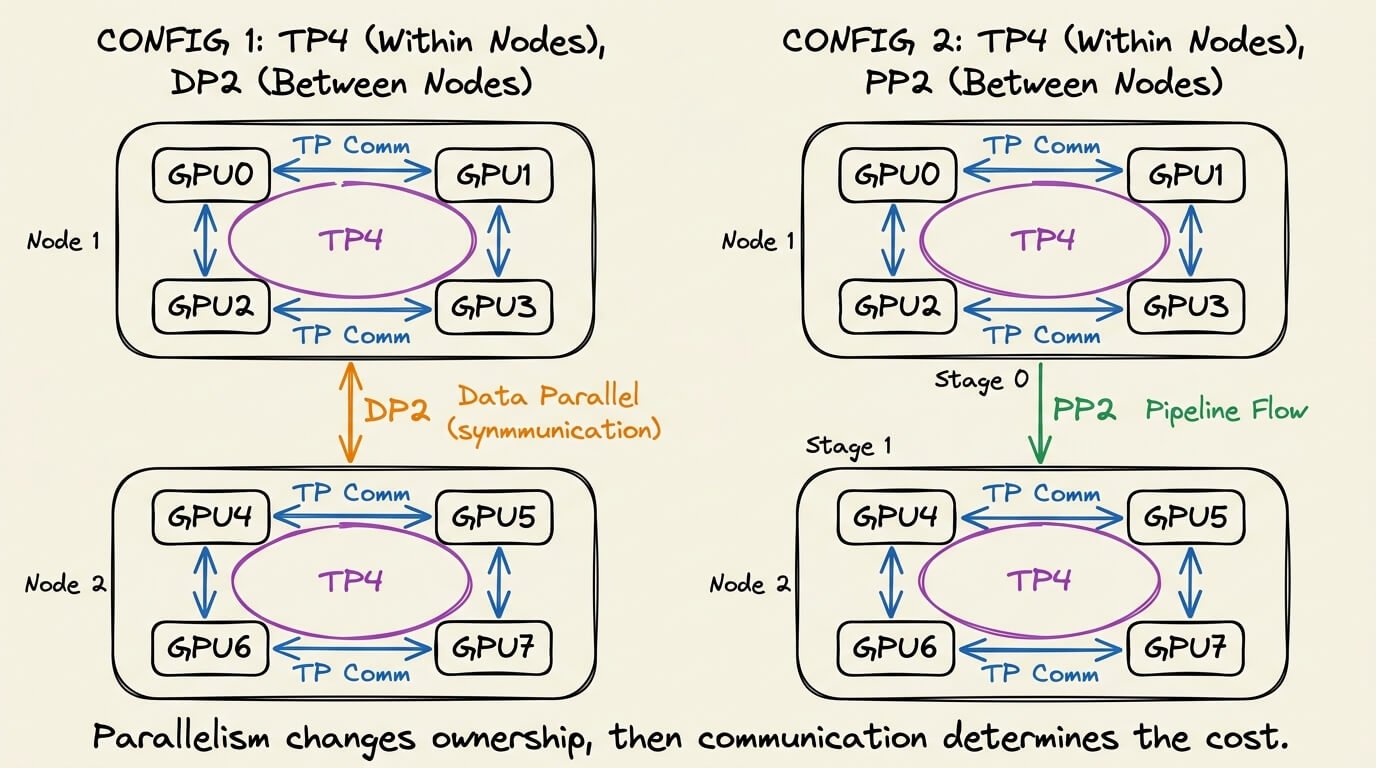
按这个顺序搭混合布局:
- 先选能让每个阶段放下的最小 TP 组,把它放在最快的链路上。
- 只有模型必须跨过更慢的边界时才加 PP。
- 一个完整的模型实例放下之后再加 DP。
- 针对实测的长上下文问题加 CP。
- 只为 MoE 的专家放置加 EP。
这个顺序防的是一个常见错误:还没想清楚每个维度解决哪种资源问题,就先把并行度乘起来。每个新加的维度都应该有一个明确的任务,和一个验证它的测量。
预填充 / 解码分离。 当两个阶段需要不同的硬件或不同的扩展比例时有用:各自独立的 worker 池,预填充池偏向大提示词运算,解码池偏向 KV 容量和稳定的 token 生成。它引入了 KV 状态传输和一道协调边界。
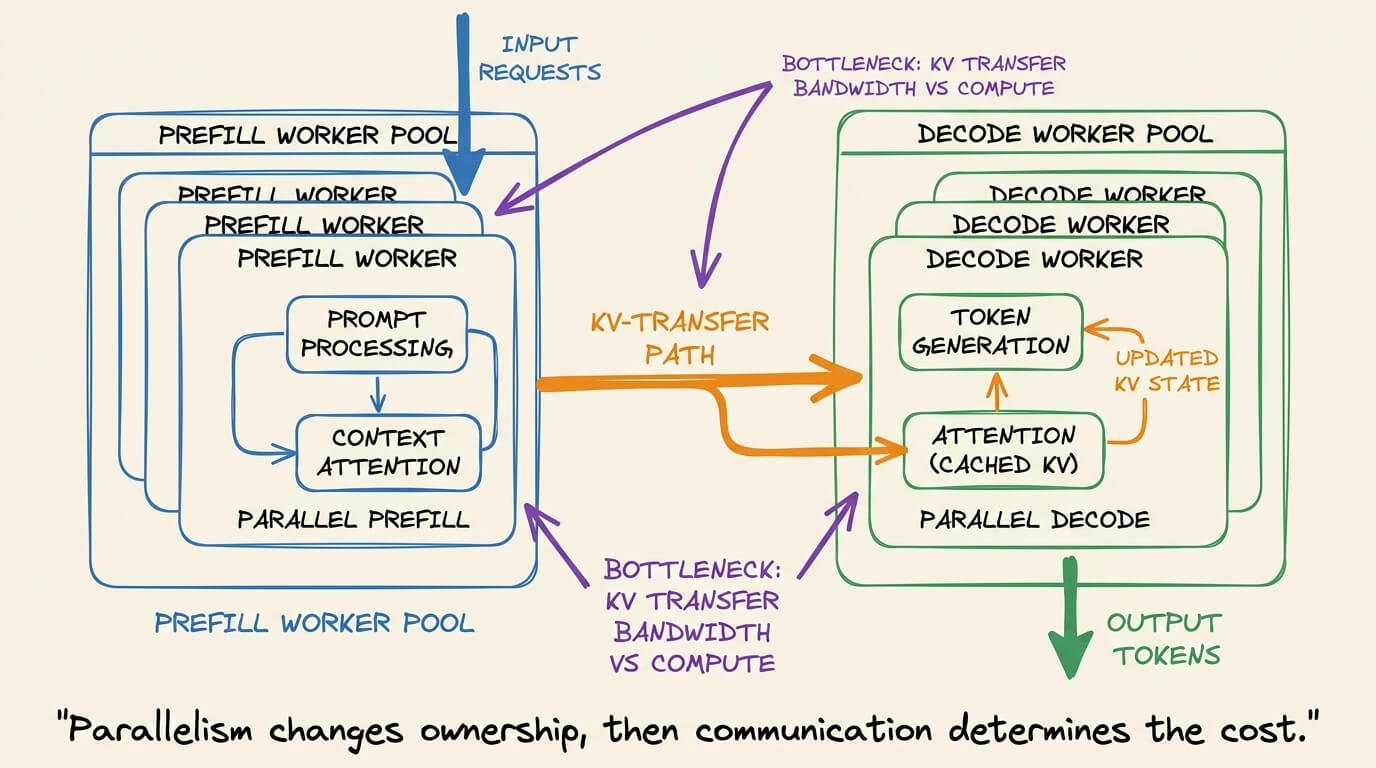
分离不能替代 TP、PP 或 CP:每个 worker 池仍然各自需要一份模型放置方案。
混合布局成功的唯一标准,是每一种通信模式都和物理网络对得上:最频繁的集合通信放在最快的链路上,然后在生产请求组合下验证完整布局。
五、决策流程:从上往下走一遍
从上往下用。选出能解决已测量到的那个限制的最小改动,停下来做基准测试;只有另一个限制仍然存在时才回到流程里。把所有可用的并行模式都叠上去,会让归因变难,而且可能只增加了通信、没解决问题。
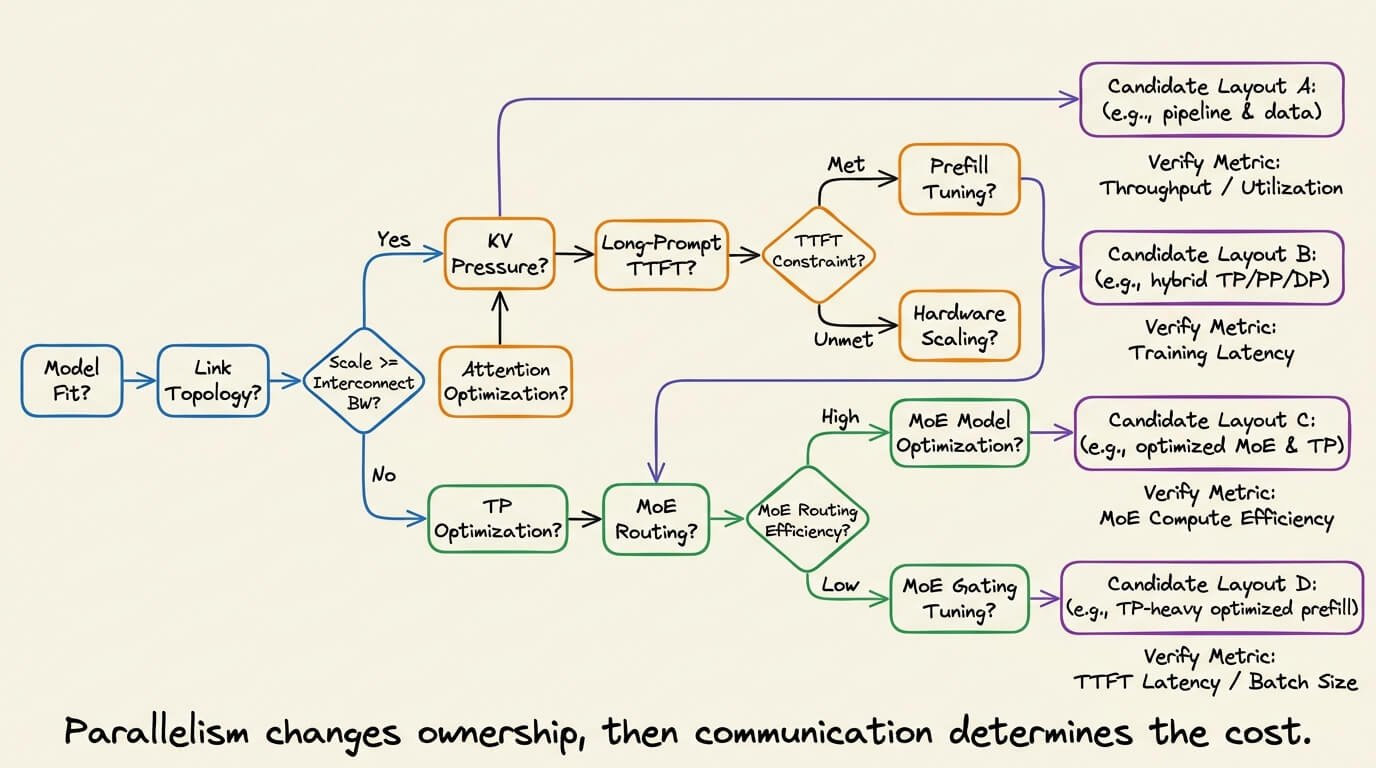
第 1 问:一个完整副本能不能放进一张 GPU,同时给目标并发留出 KV 缓存容量?
- 能:从一个副本开始。流量能用上另一个调度器时加数据并行,并在路由器里保留前缀局部性。
- 不能:找到可用的最小张量并行度,在这个度数下测解码延迟。层组执行时间相近、或对等链路较慢时,考虑流水线并行。
第 2 问:模型必须跨节点吗? 把 TP 留在更快的节点内链路里,跨节点测 PP;加负载之前先测阶段平衡。
第 3 问:长提示词是独立的问题。 大输入长度下 TTFT 不达标,评估 PCP;KV 容量限制并发或长上下文解码,评估 DCP。
第 4 问:MoE 模型多一个分支。 如果是专家权重导致放不下,测 EP,并分别跟踪 token 不均衡和 all-to-all 时间。不要给稠密模型加 EP,也不要从总的 GPU 利用率推断它的收益。
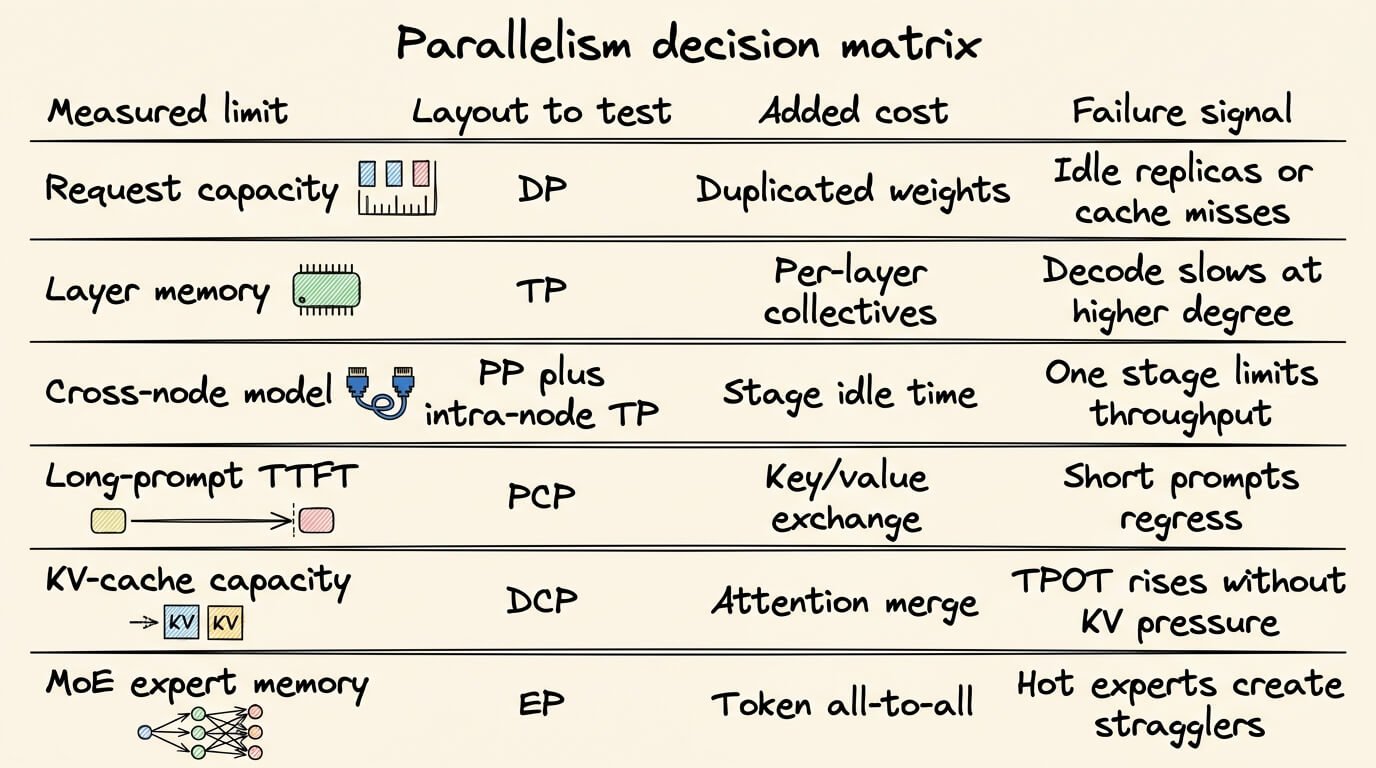
只有当测量指认了某种并行模式所针对的资源限制时,才启用它。先确定受约束的资源,再选一种通信方式和现有互连匹配的切分。
六、三句话收尾
- 并行通常是放置决定,不是 GPU 数量设置。 从阻止服务达标的那个资源入手,选最小的布局改动去解决它。
- 每一次切分都引入通信、同步或调度开销。 省下的内存或算力,必须在真实硬件和真实请求分布上盖过这个成本。
- 最好的布局是满足延迟和吞吐目标的最简方案。 其他一切都还需要测量。
---本文依据 Avi Chawla 发表在 X 上的长文《Parallelism strategies for LLM inference, clearly explained》(2026-10-06)重新组织成中文:章节顺序、每种策略的"卡片"和决策清单是编辑整理,技术事实、数字、代码与配图均来自原文。