NVIDIA 宣布了两个开源项目,用于在 GPU 基础设施上构建和运营托管 Kubernetes 服务——NVIDIA Kubernetes Engine (NVKE) 和 NVIDIA Kubernetes Recipes (NVKR)。这两个新项目均以公开预览版形式提供。
AI 工厂客户通常希望通过他们已经在使用的 Kubernetes API、工具和生态系统来使用 GPU 容量,并由工厂运营他们的集群。交付此服务需要 API 驱动的配置、租户隔离、升级和恢复,并以服务承诺为后盾。还需要对跨 GPU 代际和 Kubernetes 版本的 GPU 硬件、网络、驱动程序和运行时软件进行资格认证。
NVKE 和 NVKR 将这项工作划分为集群管理和可复现软件构建两部分。NVKE 提供运行托管 Kubernetes 服务的软件,安装在工厂的基础设施上,并提供用于配置和管理集群的 API。NVKR 构建这些集群所需的操作系统镜像、容器镜像和软件包,使用定义已验证的软件版本和 GPU 代际组合的配方。AI 工厂保留对其软件、运营、服务和客户体验的控制权。团队可以一起或独立采用 NVKE 和 NVKR 项目。
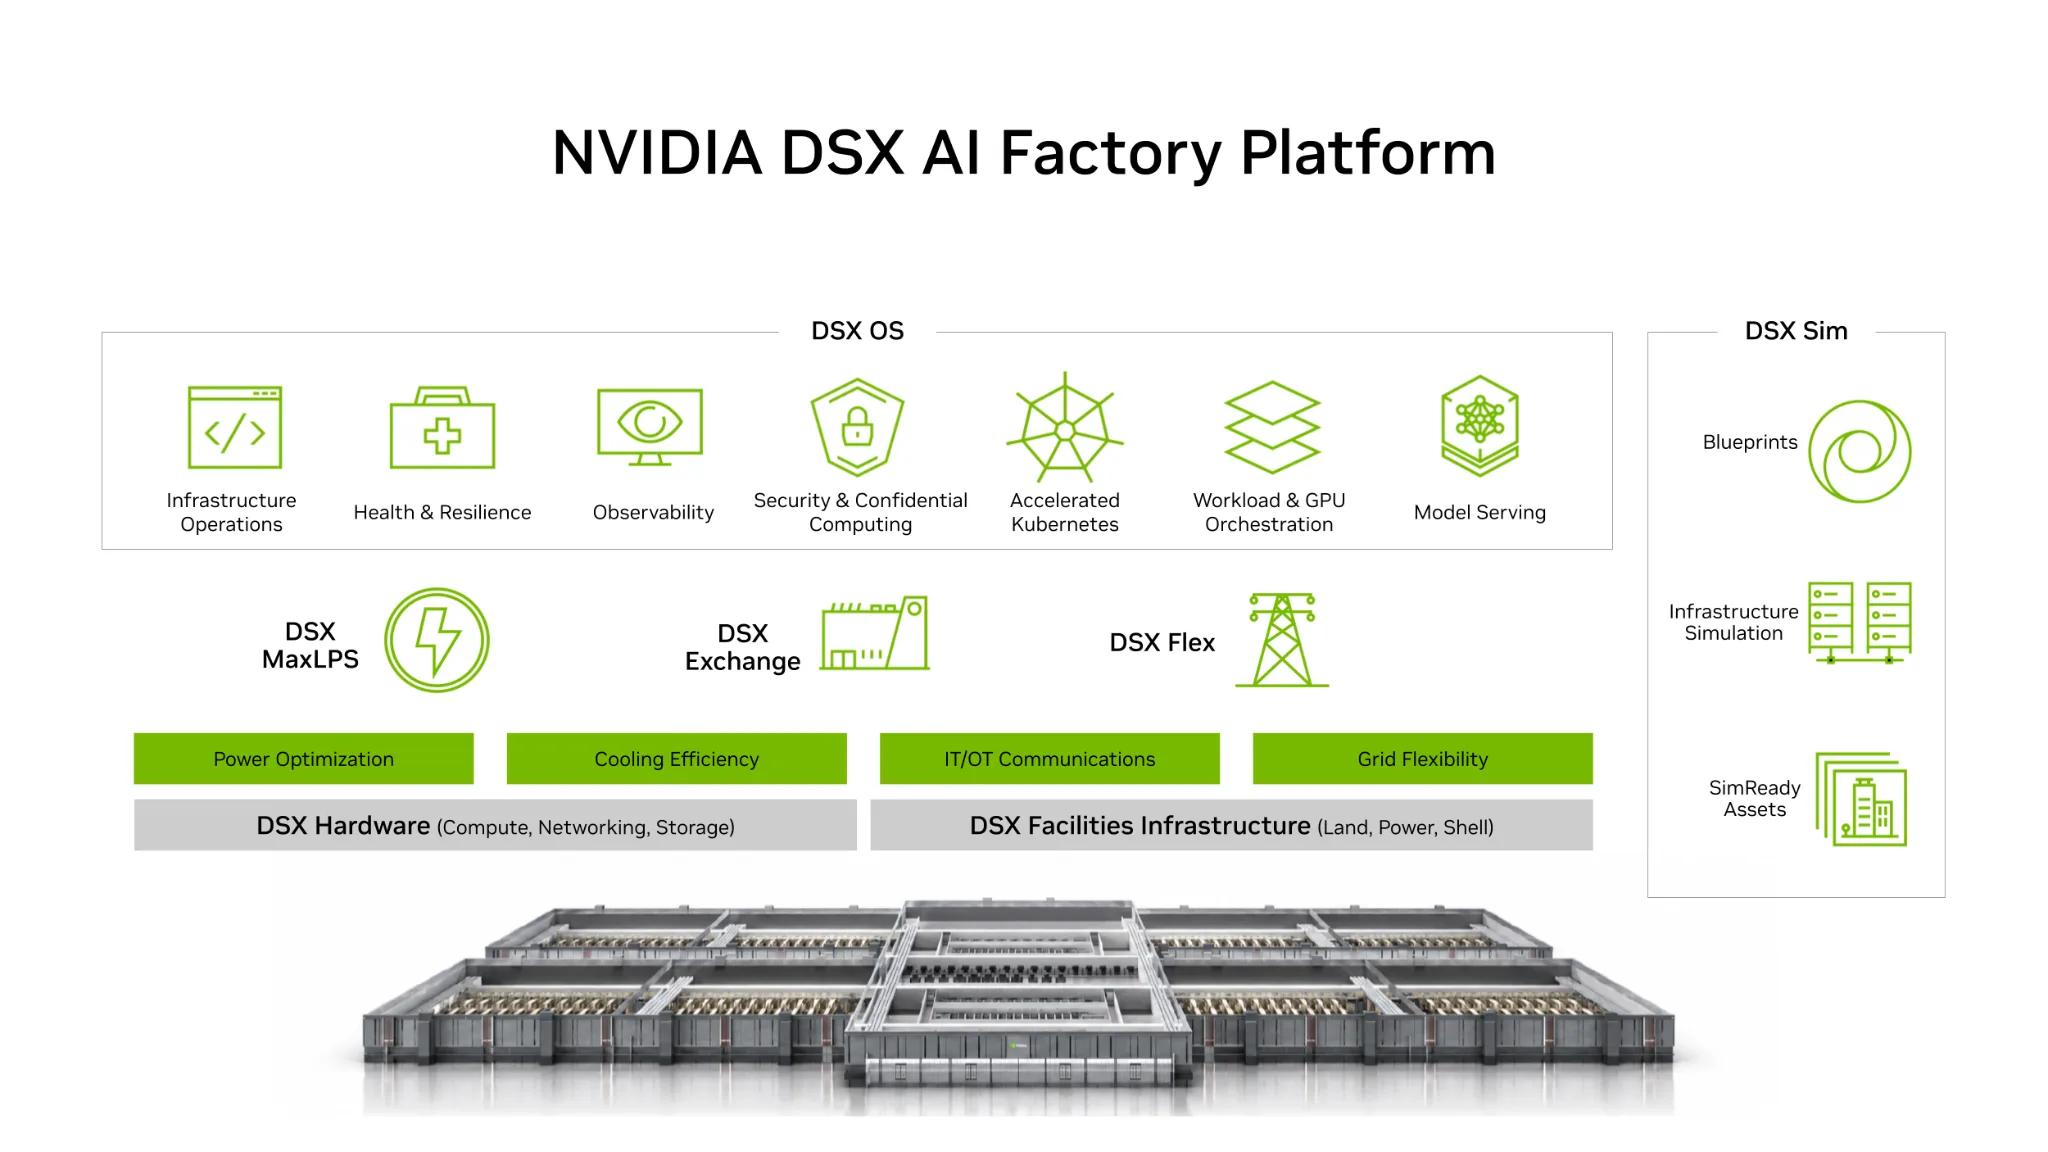
NVKE 和 NVKR 都是 NVIDIA DSX AI Factory Platform 的组件,该平台帮助 AI 工厂设计、构建和运营 GPU 基础设施。两个项目均在 GitHub 上以 Apache 2.0 许可证提供,因此团队可以检查代码、并行开发并贡献改进。在公开预览期间,API、配置和行为可能因版本而异。NVKE 和 NVKR 目前尚不建议用于生产工作负载。请参阅预览状态和已知限制。
本演练涵盖使用 NVKR 构建节点镜像、部署 NVKE 管理平面以及配置客户 Kubernetes 集群。
NVKE 和 NVKR 如何协同工作
- NVKR 构建软件:它从特定源版本生成节点镜像、二进制文件、容器镜像和 Helm chart,并记录构建输入。
- NVKE 管理集群:它使用这些工件来配置和运营 Kubernetes 集群。
团队可以一起或单独使用这些项目。NVKE 对 NVKR 没有运行时依赖,NVKR 可以为其他 Kubernetes 管理系统构建工件。
nvkectl 在引导主机上启动一个临时种子集群,并使用它来形成管理集群。NVKE 管理平面(包括 REST API 和控制器)运行在管理集群上。管理平面为 AI 工厂客户创建工作负载集群,每个集群都有自己的 Kubernetes 控制平面、etcd 和节点池。机器来自 NVIDIA Infra Controller (NICo),它通过 CAPNICo(NICo 的 Cluster API 基础设施提供程序)管理裸金属生命周期。
节点在获得加入凭证之前必须提供经过认证的 SPIFFE 身份。NVKE 遥测管道(基于 OpenTelemetry 的 Helm chart)收集日志、指标和跟踪,并通过 OTLP 导出到监控后端。
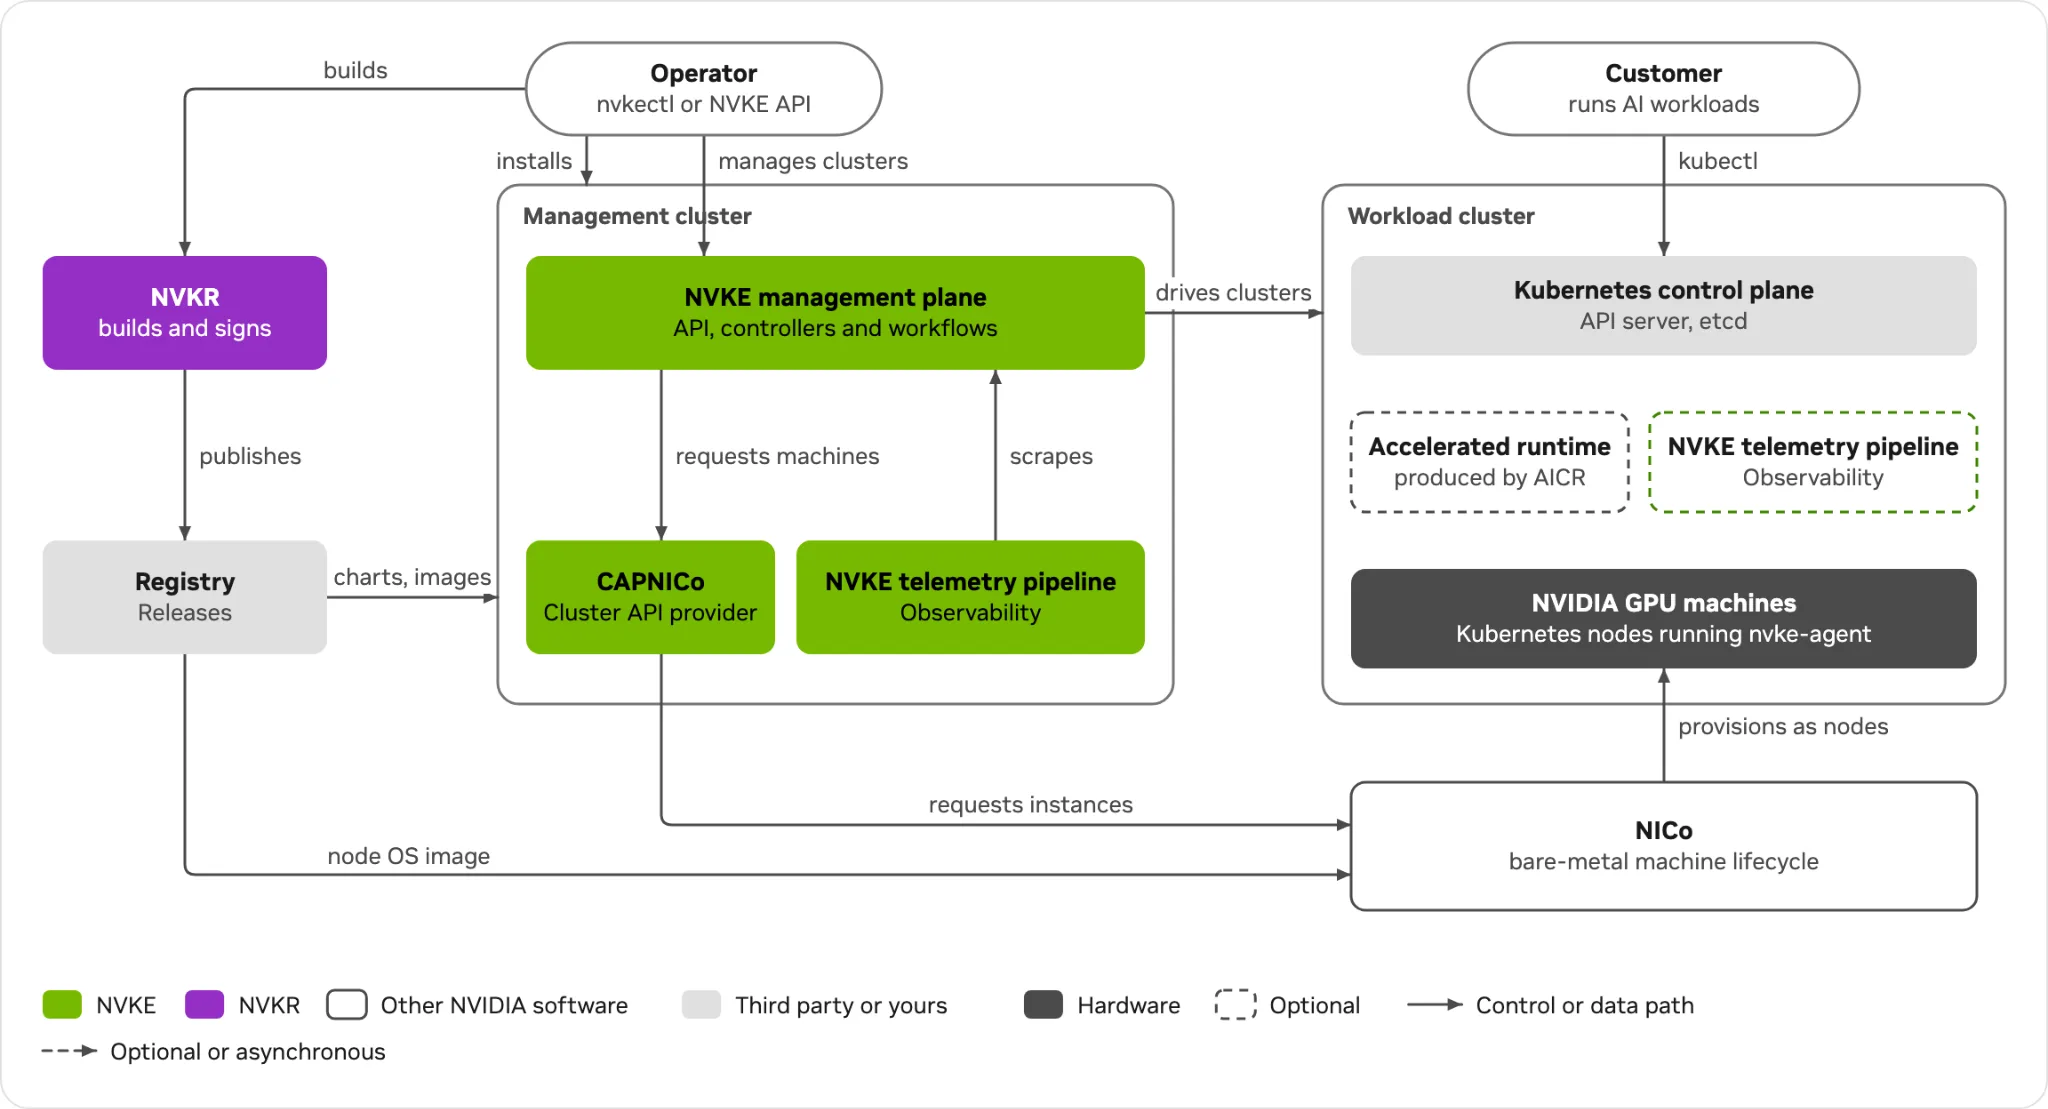
在每个工作负载集群内部,团队使用 AI Cluster Runtime (AICR) 添加 GPU 加速运行时,使用 NodeWright 添加节点包,并使用 NVSentinel 添加故障修复自动化。
NVKE 是 Certified Kubernetes AI Platform 和 Certified Kubernetes Installer,已在 Kubernetes 1.36 上通过一致性测试。
从裸金属到客户集群
本演练描述了如何从机架中安装的服务器开始配置客户 Kubernetes 集群:使用 NVKR 构建节点镜像,使用 nvkectl 部署 NVKE 管理平面,并通过 NVKE API 创建客户集群。NVKE 文档列出了每个标志和选项,以及最新的步骤。
演练先决条件:
- 三台用于管理集群的 CPU 服务器,以及一台位于站点网络上的独立 Linux 引导主机,需安装 containerd、nerdctl、kind、Helm 和 kubectl
- 三台用于工作负载集群控制平面的 CPU 服务器
- 一组用于工作节点的 GPU 服务器
- 已注册容量的 NICo 安装
- 支持 Docker 和 KVM 的 Linux 构建主机
- 用于节点镜像的 HTTP 服务器、用于控制器镜像的容器注册表,以及访问互联网以下载安装期间使用的开源镜像和 Helm chart
构建节点镜像
NVKR 定义了 NVIDIA 为 NVKE 验证的 Kubernetes 软件配置,并提供了将该定义转化为可部署工件的可复现管道。NVKR 从版本固定的源构建节点镜像并记录每个输入,因此团队可以识别每个镜像中包含的软件,并可以在以后重新构建它。管理集群和每个节点池可以运行不同的镜像,例如每个 CPU 架构或 GPU 代际一个镜像。
团队在构建主机上克隆 NVKR 仓库。然后运行快速启动脚本构建 nvkectl、NVKE 控制器镜像及其 Helm chart,以及第二个脚本构建节点镜像,在本演练中命名为 node-image-01。
$ git clone https://github.com/dsx-ai-factory/nvkr.git && cd nvkr
$ bash scripts/nvkr-quickstart.sh
$ NVKE_OS_ARCH=amd64 scripts/nvke-os-local.sh node-image-01
节点镜像构建从源代码编译 NVKE 节点代理和 OVN-Kubernetes,并添加校验和固定的上游发行版 Kubernetes 1.36 软件包和 SPIRE 代理。然后从 Ubuntu 安装程序启动虚拟机,安装代理,并将 Kubernetes 和网络软件包暂存到磁盘上。结果是 QCOW2 磁盘镜像。团队将控制器镜像推送到注册表,将 nvkectl 复制到引导主机,并将 QCOW2 放在 HTTP 服务器上。
部署 NVKE 管理平面
NVKE 管理平面运行在称为管理集群的 Kubernetes 集群上。团队在引导主机上运行以下命令开始创建管理集群:
$ nvkectl bootstrap site -f site-a.yaml \
    --nvke-controller-image registry.example.com/nvke/nvke-controller:<tag>
站点规范文件 site-a.yaml 包含 NICo 为管理集群配置三台服务器所需的输入。引导命令在引导主机上启动一个临时 Kubernetes 集群。此临时集群使用 kind 运行单个 Kubernetes 节点,并托管设置所需的 NVKE 软件。
NVKE 控制器向 NICo 请求三台服务器,NICo 从先前构建的节点镜像启动这些服务器。当所有三个节点加入后,引导过程删除临时集群,留下管理集群。然后团队在管理集群上安装 NVKE 管理平面,并运行 nvkectl config set-site 将命令行工具连接到 NVKE API。
发布客户将运行的发行版集合
客户从 AI 工厂发布的发行版中按名称选择发行版。他们不直接使用操作系统镜像或 cloud-init 配置。
发行版集合包含三个组件:
- 机器镜像包含 NICo 为启动服务器而运行的 iPXE 脚本。
- 集群发行版将机器镜像与 cloud-init 配置配对,该配置准备控制平面节点并记录 cloud-init 安装的 Kubernetes 版本。
- 节点池发行版为工作节点提供相应的镜像和配置。
$ nvkectl create machineimage -f machineimage.yaml
$ nvkectl create clusterrelease -f clusterrelease.yaml
$ nvkectl create nodepoolrelease -f nodepoolrelease.yaml
创建客户集群
客户集群请求包含与站点规范相同的 NICo 输入,外加一个 Kubernetes 版本。控制平面和每个节点池都有自己的实例类型、VPC 前缀和发行版。在此示例中,控制平面和 GPU 节点池引用名为 k8s-1.36.3-amd64 的发行版。
name: customer-a
controlPlaneKubernetesVersion: 1.36.3
etcdEncrypted: true
controlPlaneVIP: 10.0.20.10
nico: {orgID: <org-id>, siteID: <site-id>, vpcID: <vpc-id>}
controlPlaneConfig:
  desiredCount: 3
  nico: {instanceTypePreference: [<cpu-instance-type>], vpcPrefixIDs: [<prefix-id>], release: k8s-1.36.3-amd64}
nodePools:
  - name: gpu
    nodeNamePrefix: gpu
    desiredNodeCount: 4
    nico: {instanceTypeID: <gpu-instance-type>, vpcPrefixIDs: [<prefix-id>], release: k8s-1.36.3-amd64}
团队将请求保存为 customer-a.yaml,然后运行以下命令通过 nvkectl 将其提交到 NVKE REST API。
$ nvkectl create cluster -f customer-a.yaml
集群状态保持为 Provisioning,直到第一个控制平面节点运行了 kubeadm init 并且 NVKE 安装了 OVN-Kubernetes 和 NodeLocal DNSCache。然后状态变为 Provisioned。
授予客户访问权限
客户通过 kubeconfig 访问集群的 Kubernetes API,而 AI 工厂继续通过 NVKE API 管理它。为了授予客户访问权限,团队从管理集群检索集群的 kubeconfig 并安全地共享它。
$ nvkectl get kubeconfig customer-a --output-file customer-a.kubeconfig
kubeconfig written to customer-a.kubeconfig
使用 NVKE 和 NVKR 构建的 AI 工厂和合作伙伴
NVIDIA 云合作伙伴 Firmus 和 SK Telecom 正在将 NVKE 和 NVKR 集成到他们的 AI 工厂中,以构建和部署托管 AI 工作负载的 Kubernetes 集群。
此外,NVIDIA 合作伙伴 Mirantis、Rafay、Spectro Cloud、OpenNebula Systems 和 vCluster 正在将 NVKE 和 NVKR 的组件集成到他们的托管 Kubernetes 产品中,以帮助他们的 AI 工厂客户在 Kubernetes 上运行 AI 工作负载。Netris 正在为其网络自动化解决方案启用 NVKE。
现已提供公开预览版
NVKE 和 NVKR 处于公开预览阶段,尚不建议用于生产工作负载。这些项目正在快速发展,NVKE API 可能会在版本之间发生变化。预览版状态页面列出了当前的限制。
团队可以根据其基础设施需求评估这些项目,并在公开的 NVKE 和 NVKR 路线图上查看计划的工作。反馈和贡献可以帮助塑造 NVKE、NVKR 以及 DSX AI Factory 堆栈的其余部分。
开始使用
NVKE 和 NVKR 是通过 NVIDIA DSX AI Factory GitHub 组织 提供的开源组件,与 CAPNICo 一起提供。从 NVKE 文档 开始,或在单台机器上尝试 本地快速入门——无需 GPU 或 NVIDIA 账户。
使用 Slack 邀请链接 加入 NVIDIA DSX AI Factory Slack 工作区中的
#nvke对话。与社区分享您构建的内容。访问 KubeCon 上的 NVIDIA 展位 #170,了解更多 Kubernetes 深入探讨和现场演示。