如果你在 Mac 上运行模型,或者使用 MPS 作为主要的计算加速工具,那么 PyTorch 2.15 有很多值得期待的地方!FP8 登陆 MPS,语言模型解码通过线性层和 softmax 获得更快的路径,新的 Metal 内核解决了音频、视频和训练工作负载中一些出奇昂贵的部分。
先简单介绍一下我们是谁:我们是 Hugging Face 的 PyTorch 团队。我们在 PyTorch 各处都有贡献,其中一个重点领域是 MPS 后端,目标是让你的 Mac 成为运行和训练 PyTorch 模型的一流场所。在 2026 年初,在 MPS 上运行即使很小的模型也常常意味着要绕过不支持的操作、性能悬崖和意外的内存增长。因此,我们运行来自 Hugging Face Hub 的语言、图像和视频领域的真实模型,找出 MPS 的不足之处,并在 PyTorch 上游修复它,越来越多地通过用专用的 Metal 内核替换 MPSGraph 来实现。本文的大部分内容就是这项工作的成果,是与 PyTorch 维护者和社区贡献者共同完成的。
TL;DR
- FP8 来到 Mac:以 BF16 一半的空间存储
float8_e4m3fn值,并使用缩放矩阵乘法以及 CUDA/CPU 上支持的所有其他操作! - MoE 模型解码比 2.14 快 5–6.5 倍:在 M3 Ultra 上,Qwen3.6-35B-A3B 从 9.4 提升到 61.3 tokens/s,这得益于带有专用解码路径的原生分组 matmul、更少的 GPU-CPU 同步以及更快的 top-k 路由。
- 每个 LLM 的每 token 时间更少:单行线性层使用专用的矩阵-向量内核,词汇表上的 softmax 快了约 8 倍。
- GPU 上更多的线性代数:复数 LU 和三角求解、更快的小矩阵求逆以及更快的 QR 分解。
- 音频、视频和训练也受到关注:卷积、填充、dropout、插值反向和归约的更快路径。Wan2.2 的视频 VAE 解码现在峰值内存为 8 GiB,而不是 270 GiB。
- 从 Python 获得更多控制:公开的 MPS 流和更可靠的事件计时。
- 更新的要求:MPS 现在需要 macOS 15 或更高版本;PyTorch 2.15 需要 Python 3.11 或更高版本。
- 2.16 预览:注意力完全在 Metal 上、更多 MPSGraph 到 Metal 的迁移以及更快的 LLM 解码。
这对你意味着什么
如果你在 Mac 上使用 transformers、diffusers 或 ComfyUI 等工具运行模型,以下是 2.15 在实际中的变化:
- 本地 LLM 快得多。混合专家模型解码比 2.14 快 5–6.5 倍:在配备
torch.compile的 M3 Ultra 上,Qwen3.6-35B-A3B 从 9.4 提升到 61.3 tokens/s,LFM2.5-8B-A1B 从 23.6 提升到 123.6 tokens/s。密集模型也受益于更快的线性层和用于采样的快 8 倍的 softmax。(更多) - 适合内存的视频生成。使用 Wan2.2 的分块 VAE 解码视频过去会将驱动内存推到 270 GiB;现在峰值约为 8 GiB。(更多)
- 使用 Qwen-Image-2.1 进行正确的图像编辑。在 2.14 上,Qwen-Image-2.1 VAE 编码器在 MPS 上静默损坏图像,破坏了图像编辑工作流(在 ComfyUI 中报告)。相同的填充更改修复了它:编码-解码往返现在与 CPU 匹配,PSNR 为 29.95 dB,高于之前的 10.06 dB。
- 在你的 Mac 上使用 FP8 权重。FP8 张量占用的内存是 BF16 的一半,并且
F.scaled_mm直接在 GPU 上对它们进行乘法运算。(更多)
目录
- 入门
- FP8 登陆 MPS
- 更快的语言模型解码
- 线性代数得到提升
- 卷积、填充和训练
- Softmax 和归约
- 视频解码的内存占用大幅减少
- 使用 MPS 流获得更多控制
- 更多操作在 MPS 上工作
- PyTorch 2.16 抢先看
- 总结
入门
你需要一台配备 macOS 15 或更高版本和 Python 3.11 或更高版本的 Apple 芯片 Mac(参见 2.15 兼容性矩阵)。如果你的操作系统太旧或没有可用的 Metal GPU,MPS 可用性检查现在会告诉你原因。
要在单独的环境中尝试候选版本:
uv pip install torch==2.15.0 --index-url https://download.pytorch.org/whl/test/cpu
FP8 登陆 MPS
FP8 为你提供了另一种在 Mac 上节省内存的方法。PyTorch 2.15 在 MPS 上添加了 torch.float8_e4m3fn 张量:每个值一个字节,是 FP16 或 BF16 存储空间的一半。
你可以使用 F.scaled_mm 对这些张量进行乘法运算,它支持逐张量和逐行缩放。以下是一个每个张量一个缩放因子的小例子:
import torch
import torch.nn.functional as F

def quantize_fp8(x):
    limit = torch.finfo(torch.float8_e4m3fn).max
    scale = x.abs().amax().clamp_min(1e-12) / limit
    return (x / scale).to(torch.float8_e4m3fn), scale

x = torch.randn(1, 1024, device="mps", dtype=torch.float32)
weight = torch.randn(1024, 1024, device="mps", dtype=torch.float32)
x_fp8, x_scale = quantize_fp8(x)
w_fp8, w_scale = quantize_fp8(weight)

y = F.scaled_mm(
    x_fp8,
    w_fp8.t(),
    scale_a=x_scale,
    scale_recipe_a=F.ScalingType.TensorWise,
    scale_b=w_scale,
    scale_recipe_b=F.ScalingType.TensorWise,
    output_dtype=torch.bfloat16,
)
print(y.shape, y.dtype)
更快的语言模型解码
每个 LLM 都有一个预填充阶段和一个解码阶段。在解码期间,每个新 token 作为单行通过模型,因此大型矩阵乘法变成了矩阵-向量乘积。PyTorch 2.15 加速了主导此步骤的两种层:密集线性层和混合专家层。
线性层
MPS 自 2.14 起就为 torch.mm 提供了 GEMV 内核,但 F.linear 仍然通过 MPSGraph。PyTorch 2.15 将它们连接到 F.linear,因此常见的 [1, 1, hidden_size] 解码输入直接使用它们,符合条件的偏置加法被融合在内。在来自真实模型的 96 个 BF16 层形状上,这带来了 1.23 倍的几何平均加速。最大的收益落在小型投影上,例如 MoE 模型中的门控,旧路径在那里留下了大部分内存带宽未使用。大型层和 LM 头已经接近带宽瓶颈,因此它们保持在 1 倍附近。
混合专家层
混合专家层将不同数量的 token 发送给每个专家。分组 matmul 在单个操作中处理这些不均匀的组,2.15 为 MPS 提供了原生实现。
在 2.14 中,分组 matmul 将组偏移复制到 CPU 并循环遍历组。新的 Metal 内核直接在 GPU 上读取偏移,在可用时使用 Metal Performance Primitives,在其他地方使用单独的 Metal 路径。小分组(解码期间的常见情况)也获得了自己的内核。
例如,64 个 token 可以分成 16、32 和 16 的组:
import torch
import torch.nn.functional as F

tokens = torch.randn(64, 64, device="mps", dtype=torch.bfloat16)
weights = torch.randn(3, 128, 64, device="mps", dtype=torch.bfloat16)
ends = torch.tensor([16, 48, 64], device="mps", dtype=torch.int32)

out = F.grouped_mm(tokens, weights.transpose(-2, -1), offs=ends)
print(out.shape)  # torch.Size([64, 128])
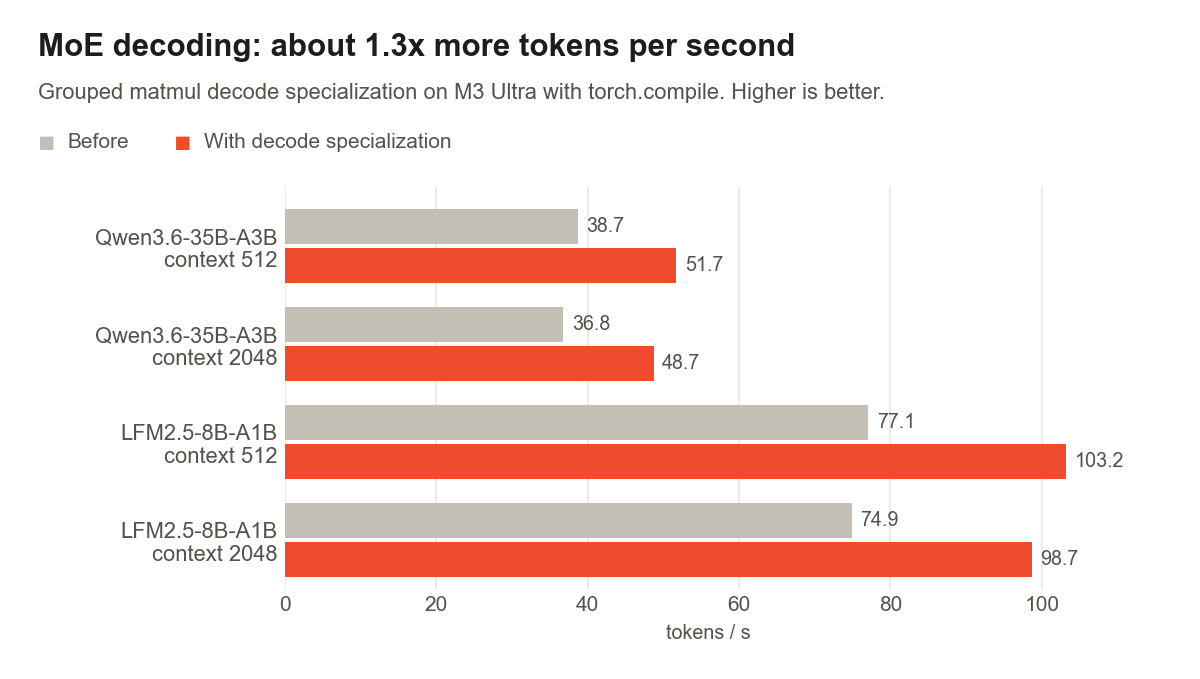
解码内核直接体现在 token 吞吐量上。在配备 torch.compile 的 M3 Ultra 上,MoE 模型每秒生成的 token 数约提升 1.3 倍:
线性代数获得提升
Complex-valued computations
处理复数张量变得更加容易。complex64 LU 分解、LU 求解 和 三角求解 现在可在 MPS 上运行,这也解锁了基于它们的运算和梯度,例如复数行列式。以下是一个直接在 GPU 上求解的小型方程组:
import torch

a = torch.randn(8, 8, device="mps", dtype=torch.complex64)
a = a + 8 * torch.eye(8, device="mps", dtype=torch.complex64)
b = torch.randn(8, 2, device="mps", dtype=torch.complex64)

lu, pivots = torch.linalg.lu_factor(a)
x = torch.linalg.lu_solve(lu, pivots, b)
print((a @ x - b).abs().max().item())
小矩阵与更大规模的求解
小矩阵也获得了快速内核。对于相机几何和图像变换,最多 4 × 4 的 FP32 矩阵批次可在单个 Metal 内核中求逆,该内核将分解与求解结合在一起。更大规模的问题也受到关注:QR 使用分块更新,三角求解 将其大部分工作转化为高效的矩阵乘法。
Gated DeltaNet 工作负载获得了专用快速路径,适用于至少八个右端项的 16 × 16、32 × 32 和 64 × 64 FP32 三角系统批次。
SVD 在数值极端情况下也更加稳健。它现在能正确处理非常小的奇异值、非常大或非常小的输入量级 以及使用 full_matrices=True 的基补全,进而使伪逆和最小二乘结果更加可靠。
卷积、填充与训练
音频模型、视频解码器和训练循环都有各自昂贵的运算。此版本为其中若干运算提供了通过 Metal 的新路径:
| 运算 | 2.15 中的变化 |
|---|---|
conv1d 前向 |
专用内核取代 MPSGraph,并为短输出提供 im2col 加 matmul 路径。适用于音频和流式模型的形状。 |
| 常量填充 | 迁移到 Metal 内核,修复了分块视频 VAE 解码中驱动程序内存失控增长的问题(详见下文)。 |
| 反射与复制填充 | 新的 Metal 实现,速度更快并修复了反向正确性。 |
| 非原地 dropout | nn.Dropout 和 F.dropout 现在使用现有的融合内核。 |
| 上采样反向 | Metal gather 内核取代 MPSGraph 的 resize-gradient 路径。 |
Channels-last conv2d 反向 |
保持在高效的 channels-last 路径上,而不是使用具有昂贵跨步访问的 NCHW 图。 |
Softmax 与归约
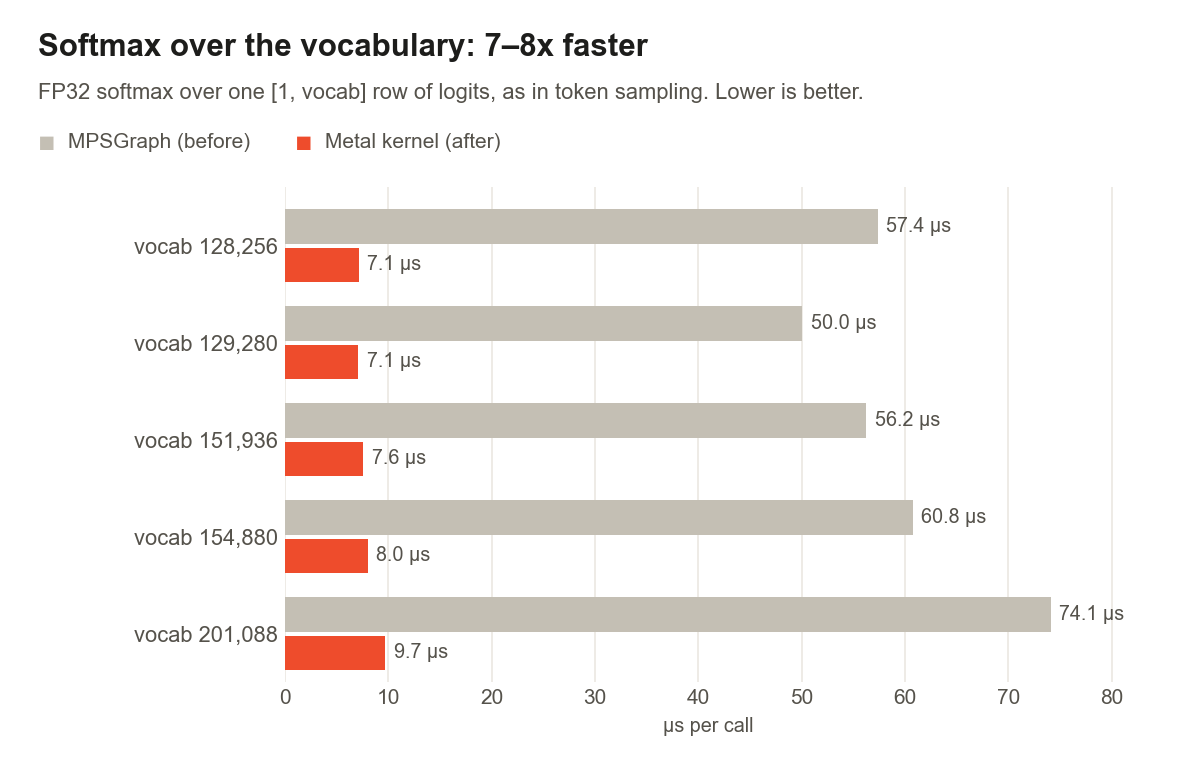
token 采样在 2.15 中也变得更快。softmax 和 log_softmax 现在运行在专用 Metal 内核上,大词表受益最大:对 [1, 128256] 行 logits 的 FP32 softmax 从 57 µs 降至 7 µs,比 MPSGraph 版本快约 8 倍。这一加速在其他常见词表大小上同样成立:
视频解码的内存占用大幅降低
此版本中最引人注目的结果之一来自常量填充的改动。Wan-AI/Wan2.2-TI2V-5B-Diffusers 中的 VAE 解码在完整的 28 分块解码过程中进行了 8,764 次填充调用。使用 Metal 填充后,驱动程序内存峰值从约 270 GiB 降至 8 GiB:
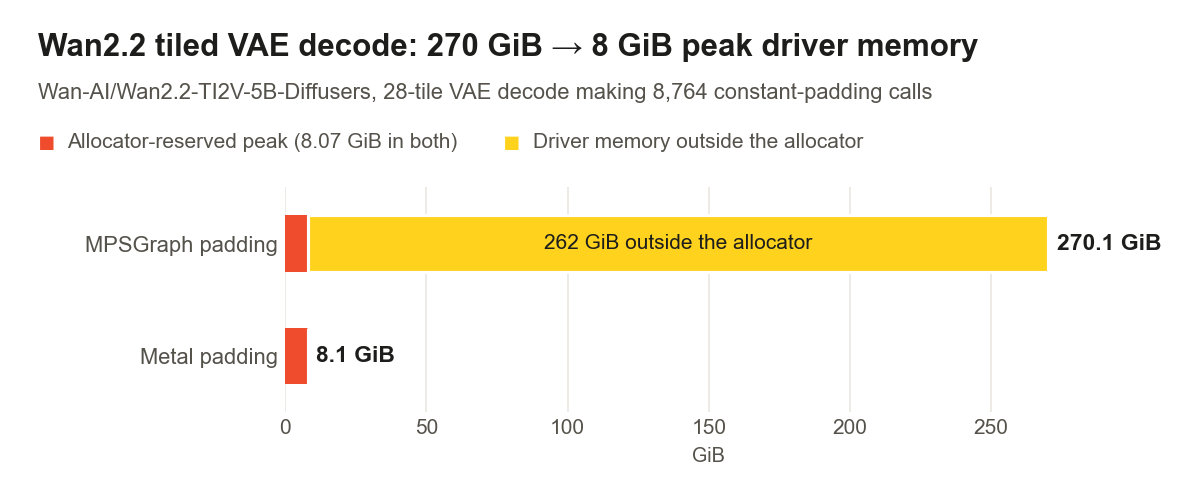
| 内存指标 | MPSGraph 填充 | Metal 填充 |
|---|---|---|
| 当前张量分配峰值 | 4.422 GiB | 4.095 GiB |
| 分配器保留峰值 | 8.070 GiB | 8.070 GiB |
| 驱动程序内存总峰值 | 270.135 GiB | 8.108 GiB |
通过 MPS 流获得更多控制
你现在可以直接从 Python 选择运行工作的 MPS 流。torch.mps.Stream 和 torch.mps.stream 上下文管理器 提供了接口,Tensor.record_stream 让分配器跟踪张量在另一条流上的使用。
以下是一个小示例,将工作发送到单独的流,并在读取结果前进行同步:
import torch

x = torch.randn(1024, device="mps")
torch.mps.synchronize()
worker = torch.mps.Stream()

with torch.mps.stream(worker):
    y = x.square()
    x.record_stream(worker)

del x
worker.synchronize()
print(y.cpu().shape)
更多运算可在 MPS 上运行
更多运算现在可在 MPS 上运行:torch.frexp、torch.logspace、torch.take 和 Tensor.put_、torch.heaviside、torch.special.laguerre_polynomial_l 以及无符号整数比较。logspace 尚不支持多于一个元素的整数或布尔输出。
注意力也获得了正确性修复:缩放点积注意力的 MPS 数学实现现在能正确处理批次和头广播。
PyTorch 2.16 抢先看
2.16 的工作已在顺利推进。以下部分改动已合入 main 并可在 nightly 版本中使用;其他改动仍在审查中,因此细节可能在发布前发生变化。
更快的 LLM 解码
一旦模型的解码路径不再包含任何 MPSGraph 运算,GPU 只有在 CPU 完成其所有内核的编码后才会开始处理一个 token。PyTorch 2.16 每 16 个内核提交一次命令缓冲区,因此 GPU 在 CPU 仍在编码其余部分时就能开始工作。对于 2048 token 上下文下的编译 BF16 解码:
| 模型 | 之前 | 之后 | 变化 |
|---|---|---|---|
| LFM2.5-8B-A1B | 108.8 tokens/s | 126.0 tokens/s | +16% |
| Qwen3.6-35B-A3B | 52.9 tokens/s | 62.8 tokens/s | +19% |
| Qwen3.8-27B | 12.1 tokens/s | 12.6 tokens/s | +4% |
注意力完全在 Metal 上运行
缩放点积注意力完全弃用 MPSGraph:所有形状都将在 Metal 内核上运行,解码使用专用向量内核,在较新的 macOS 版本上,半精度预填充使用 Metal Performance Primitives。过去会回退到 MPSGraph 的形状受益最大。在 M5 Pro 上,使用分组查询注意力(32 个查询头、8 个 KV 头、头维度 80、4K 上下文)进行解码,耗时从 465 µs 降至 65 µs;头维度为 40 的 4K × 4K 预填充则从 42 ms 降至 6 ms。
更多从 MPSGraph 到 Metal 的迁移
弃用 MPSGraph 的进程仍在继续。批归一化的前向和反向正在进行中,而MSE 损失(在小输入上最高快 12 倍)、std_mean 和 var_mean(最高快 4 倍)以及bincount已经完成。其中 bincount 最为显著:当大多数值落入同一个分箱时,统计 400 万个整数过去需要 6.8 秒,现在只需半毫秒。
更小的安装包
捆绑的着色器将默认按 Metal 3.1 构建,仅为需要的内核编译 Metal 4 版本。这使 libtorch_cpu.dylib 缩小约 25%,从 384 MiB 降至 287 MiB,并为采用更快矩阵乘法和原生 FP8 矩阵乘法的 Metal 4.1 着色器奠定基础。
总结
PyTorch 2.15 将 FP8 带到 Mac,为稠密模型和 MoE 模型带来更快的 LLM 解码,在 GPU 上提供更多线性代数运算,并将一长串运算从 MPSGraph 迁移到专用 Metal 内核。快来试试候选发布版吧!
我们的下一步计划
- 更多 MPS:2.16 将完全在 Metal 上运行注意力,我们也会继续将运算从 MPSGraph 迁移出去。
torch.compile:我们正在努力消除图中断(graph breaks),让更多模型能够端到端编译。- 你的想法:我们还应围绕 PyTorch 做些什么?如果有任何地方运行缓慢、缺失或损坏,无论是在 MPS 还是其他地方,请在 GitHub 上提交 issue告诉我们。
非常感谢 Nikita Shulga、Kurt Mohler 和 Aaron Gokaslan 审阅了本项工作的许多内容,也感谢本版本中所有为 MPS 做出贡献的人。