在数千个 GPU 上训练大规模 AI 模型是一项高风险操作,必须内置监控和自动化,以在规模化场景下优化集群韧性和正常运行时间。对于数据中心运营者来说,这个概念并不新鲜,他们早在 AI 工厂出现之前就已经在衡量平均修复时间(MTTR)和平均故障间隔时间(MTBF)。
如今风险更高。现代 AI 工厂 在数百个节点上运行分布式训练作业,持续数天或数周,在这种规模下运营模式发生了变化:硬件异常、软件错误、网络超时和资源争用必须被主动管理,以保证工作负载按计划推进。当组织在共享基础设施上运行数十个此类并发多节点工作负载时,依赖人工干预、静态检查点和被动监控的传统方法根本无法扩展。
这就是为什么像 NVIDIA Mission Control 中提供的自主恢复引擎这样的软件服务,对于扩展生产级 AI 至关重要。此前,该自主恢复引擎能够检测、诊断并恢复整个堆栈中的异常,但仅限于利用 Slurm 的高性能计算(HPC)工作负载。作为 Mission Control 2.5 的一部分,该服务现已扩展到使用 NVIDIA Run:ai 管理的基于 Kubernetes 的工作负载。
本文演示了最新版本的 Mission Control 如何将其集成韧性框架引入 Kubernetes 工作负载,帮助 AI 工厂运营从被动的运维维护转向主动的、自愈的基础设施。
内置韧性服务
Mission Control 自主恢复引擎背后的愿景很简单:AI 工厂应该是自愈系统,故障被即时检测,恢复决策基于工作负载上下文和故障类型智能做出,作业以最小的中断或计算浪费自动恢复。
目标是理解什么失败了,隔离异常并标记以便维护,并以尽可能少的时间浪费让工作负载回到有效计算中。
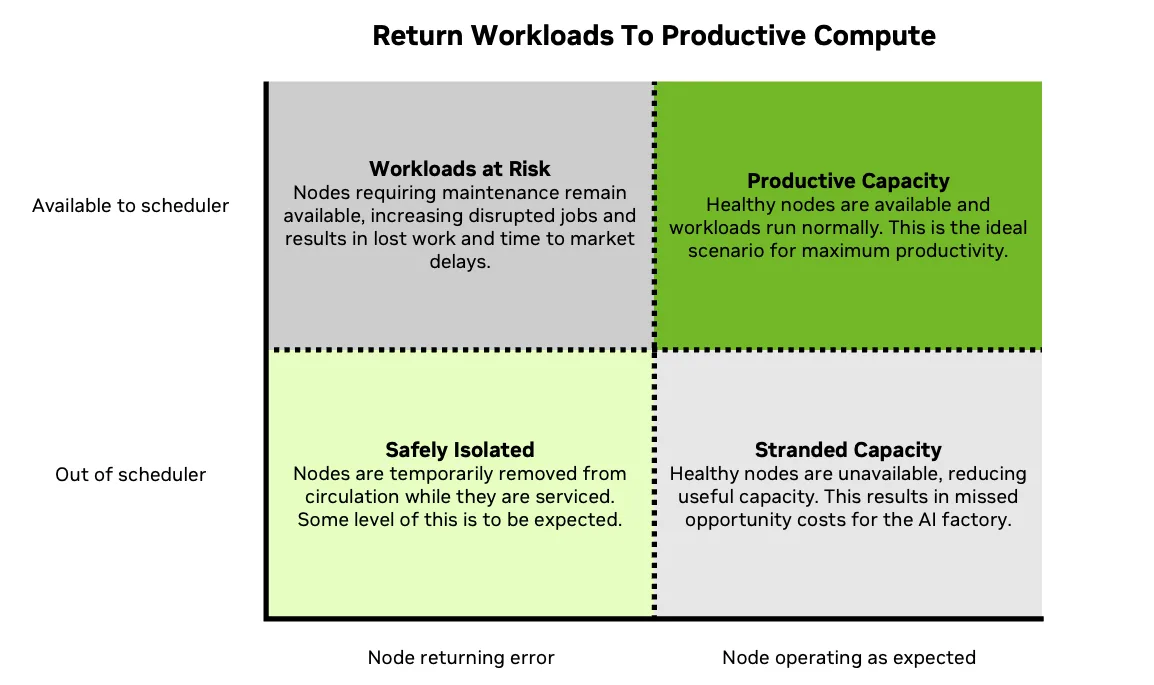
自主恢复引擎由两个服务组成:
- 自主作业恢复
- 自主硬件恢复
由于真正的自治韧性最好被理解为一个控制循环而非单一的恢复功能,自主恢复引擎随后与工作负载调度器(HPC 或 Kubernetes)协同工作,提供一个集成的三层框架,其中每个组件扮演不同但协调的角色。
在本文中,我们将重点关注调度基于 Kubernetes 的工作负载。
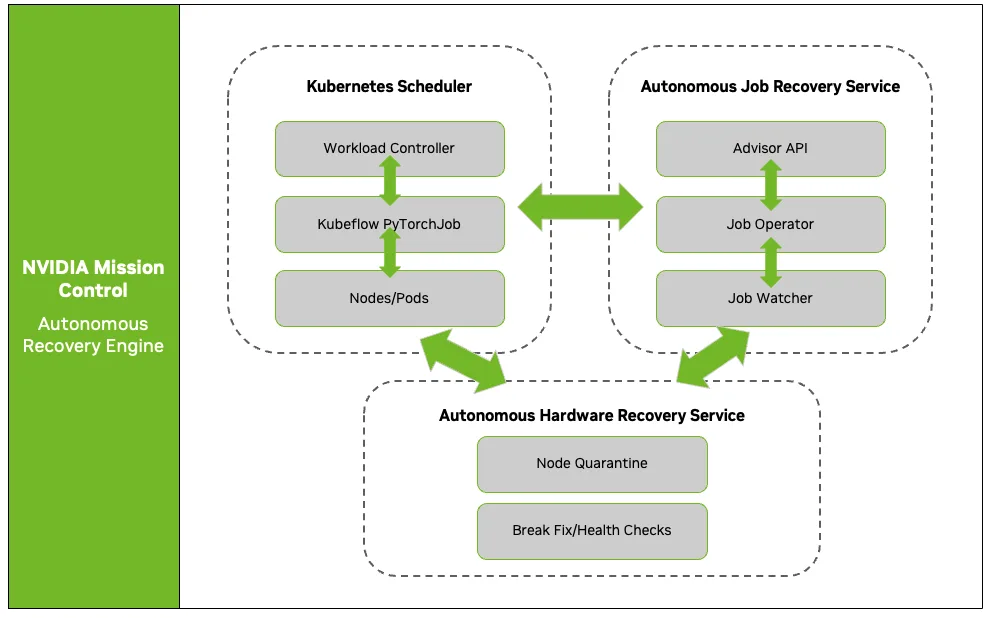
循环中的三个角色
让我们从 Kubernetes 工作负载放置层开始。在 Mission Control 中,NVIDIA Run:ai 是 Kubernetes 默认调度器,并作为软件的一部分包含在内。它管理基于 Kubernetes 的 AI 工作负载、队列、策略,并将作业调度到可用容量上。
自主作业恢复服务提供工作负载上下文层。它监视运行中的作业,跟踪每个作业的执行位置,并利用故障历史记录和作业拓扑来分类哪种恢复路径是合理的。资源管理器集成决定该指导如何转化为重启、重试、重新排队或放置操作。
自主硬件恢复服务是基础设施健康层。它监控节点和 GPU,在需要时从调度中移除异常,并运行诊断或修复,使硬件问题不会继续蔓延到新作业中。
保持这些职责分离正是该模型可移植的原因。自主作业恢复服务不需要修复硬件,硬件恢复服务也不需要理解每个训练框架。最后,调度器可以将工作负载引导到就绪容量,而无需等待根因诊断。
故障路径实战
以下场景展示了在 Mission Control 中,控制循环如何根据其自主恢复引擎检测到的故障信号而表现出不同的行为。
场景 1. 训练期间的硬件故障
一个分布式训练作业正在一组 GPU 上运行,此时一个 GPU 开始出现故障。症状可能首先表现为 ECC 错误、工作进程挂起或作业中的通信超时。
重要的是接下来会发生什么:恢复分为两条并行轨道。自主作业恢复服务捕获作业上下文并识别可疑节点或 GPU。Kubernetes 调度器集成随后通过重启或重新调度作业来推进工作负载恢复。
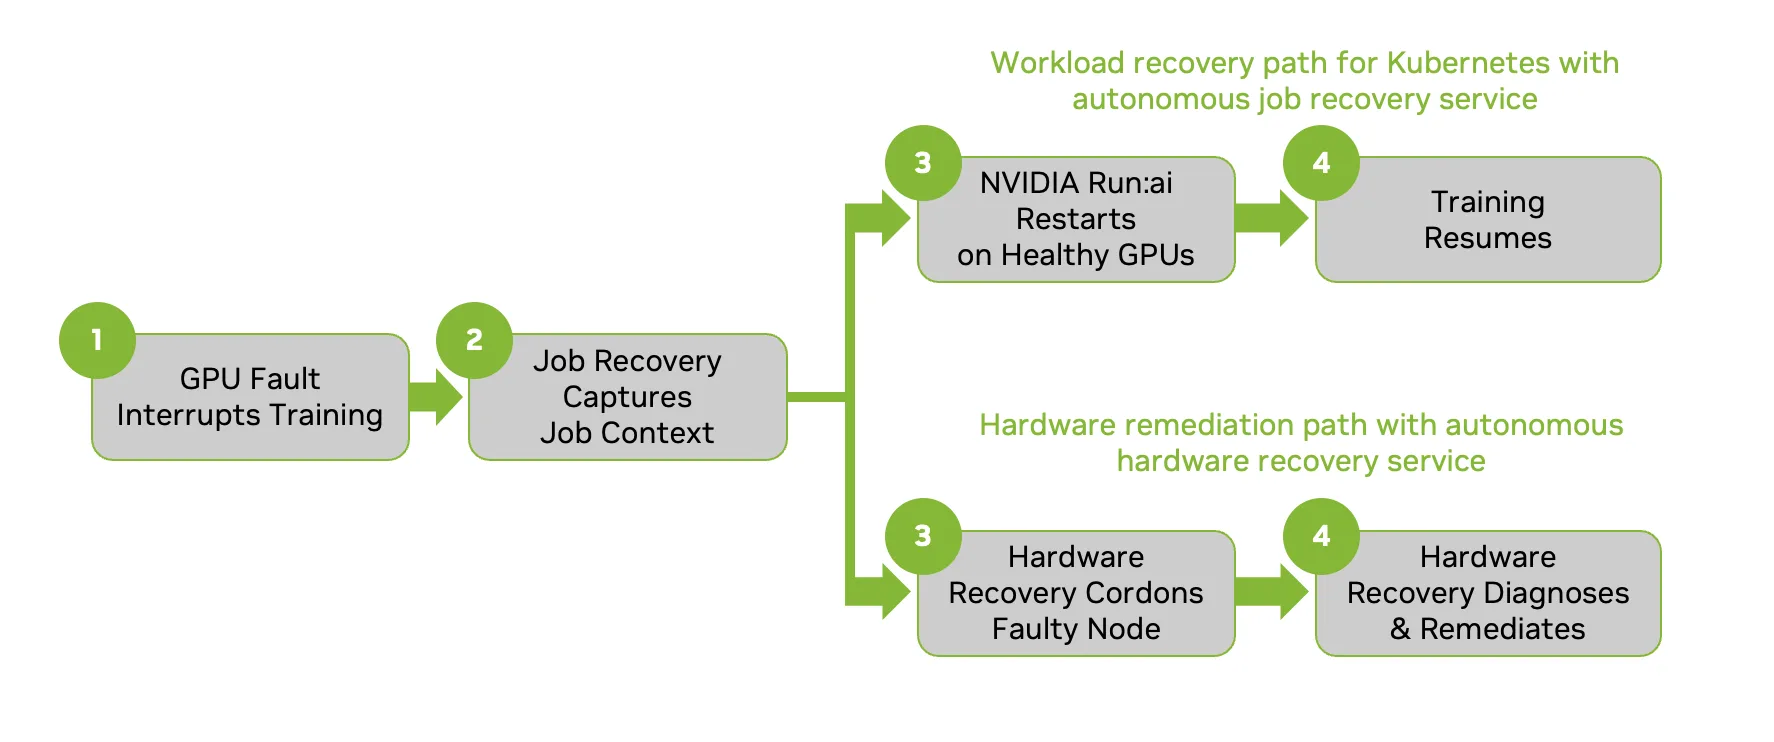
与此同时,自主硬件恢复服务隔离问题节点、记录原因并启动诊断。即使工作负载已经重新开始运行,该硬件路径仍可继续。
图 4. NVIDIA Mission Control 中的自主硬件恢复服务使节点不可调度且可审计。随后轮询锁定分诊并启动诊断
该路径的价值在于减少停机时间。工作负载无需等待根因分析即可开始恢复,故障节点也不会被意外交给下一个作业。
场景 2. 瞬时软件故障
并非所有作业失败都应触发硬件修复。训练工作进程可能退出、遇到可恢复的超时,或短暂失去协调,即使底层节点是健康的。
在此路径中,自主作业恢复服务利用作业上下文来避免过度反应。如果故障历史看起来是瞬时的,系统会按照调度器策略重试,而不是隔离不需要修复的硬件。
虽然 NVIDIA Run:ai 表达恢复的方式可能与 Slurm 的处理方式不同,但意图相同:让工作负载恢复有效执行,而不进行不必要的硬件修复。自主硬件恢复服务在后台持续监控,但除非有新证据指向硬件,否则它不介入恢复路径。
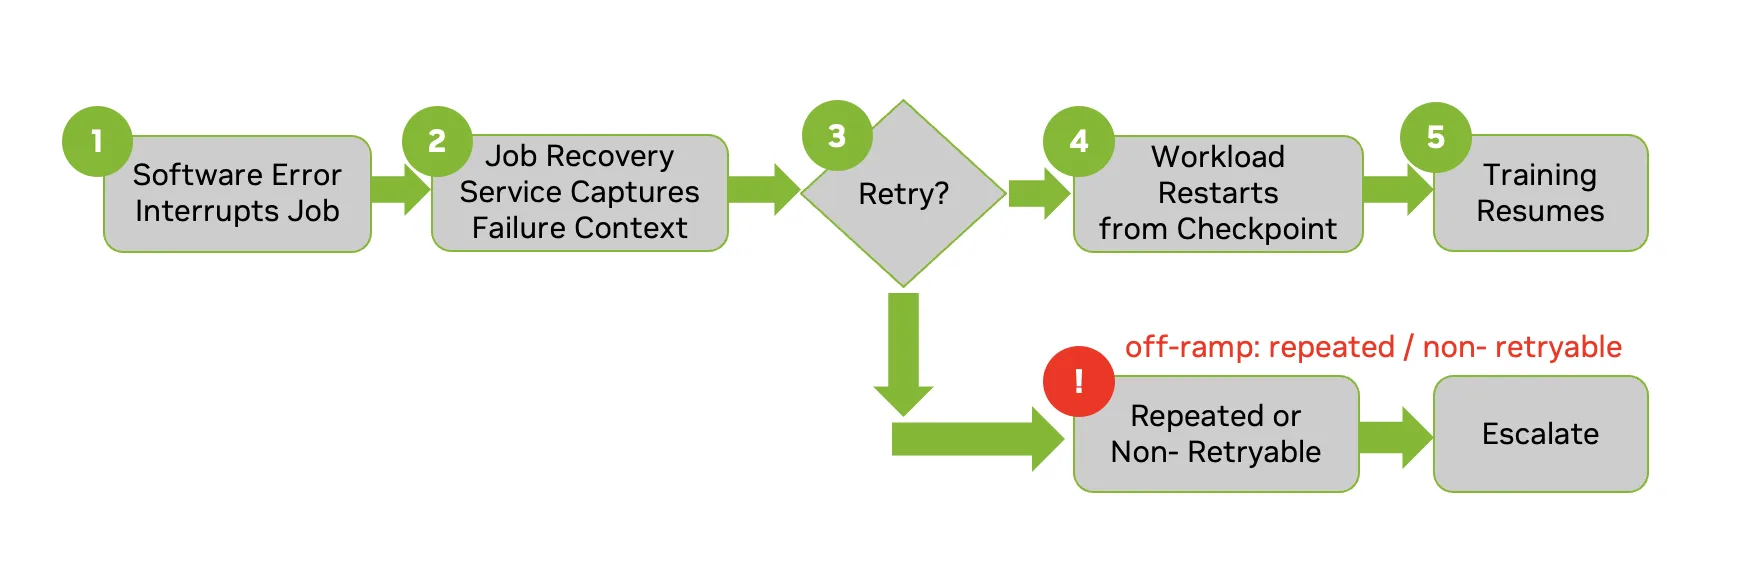
该路径的价值在于克制。系统恢复工作负载,而不会产生不必要的运维噪音或缩小调度池。
场景 3. 及早发现硬件退化
Mission Control 中的自主硬件恢复服务还可以在基础设施退化演变为作业失败之前将其检测出来。节点可能开始显示重复的 GPU 健康警告、连接问题或其他信号,使其在未来调度中存在风险。
在此路径中,自主硬件恢复服务可以主动将节点从调度器可用性中移除,并在 AI 训练作业落到该节点之前启动诊断。自主作业恢复服务可能永远不需要响应,因为故障容量在干扰工作负载之前已被移出流通。
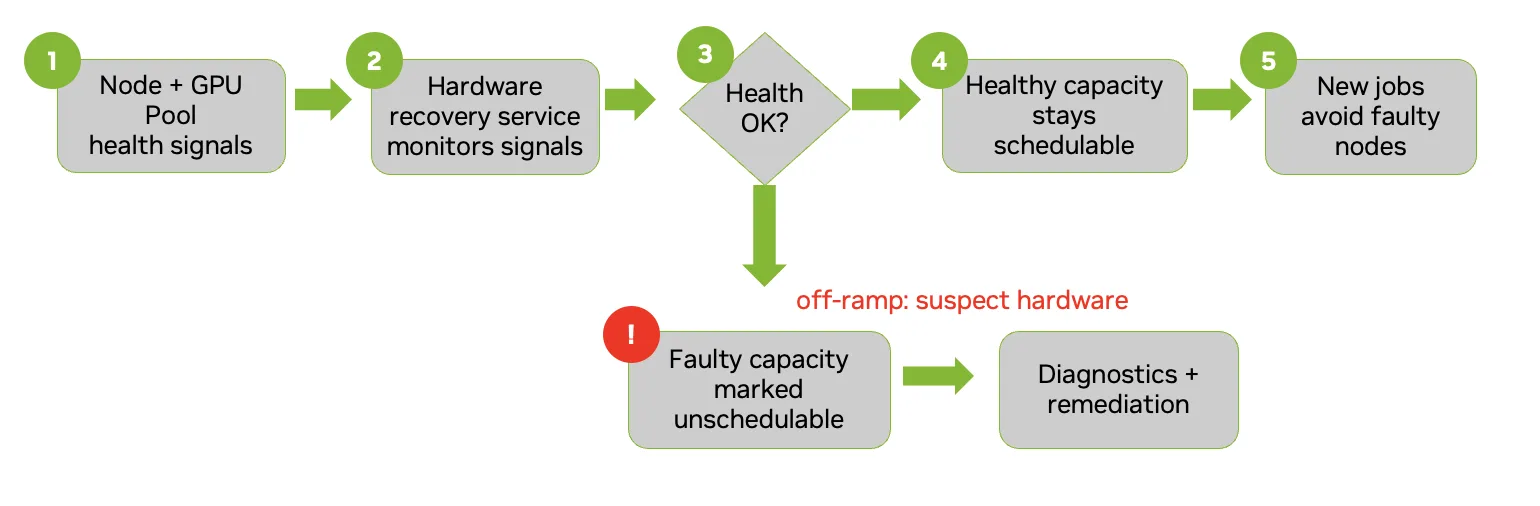
在这种情况下,Mission Control 基于 Kubernetes 的调度器受益于更干净的可使用资源池。它可以避免将 Kubernetes 工作负载放置在疑似容量上,这与 Mission Control 使 Slurm 能够将故障节点排除在分配之外直到其再次通过验证的方式类似。
该路径的价值在于预防。系统降低了已知风险节点成为明天 AI 训练中断的可能性。
运营影响
将 Mission Control 的自主恢复引擎扩展到 NVIDIA Run:ai,标志着向实现自愈 AI 工厂又迈进了一步。这一结构将弹性从特定于调度器的事件工作流转变为调度器感知的运营模式。
对于平台团队,Mission Control 2.5 在其 Kubernetes 和 Slurm 环境中提供一致的恢复模型。故障节点被隔离、标注或记录、诊断,并且仅在准备就绪后才恢复服务。
对于 AI 从业者,现在 Slurm 和 Kubernetes 用户都能受益于更简单的恢复。作业可以根据他们已在使用的调度器进行重启、重试或重新排队,而自主恢复引擎提供必要的上下文,以避免在需要维护的基础设施上重复失败。
对于企业,好处是更有效地利用宝贵的加速器容量。系统在模糊状态中停滞的时间更少,保持训练工作负载高效运行的时间更多。
▶ https://www.youtube.com/watch?v=qEMTqXBa9Tw
视频 1. NVIDIA Mission Control 针对基于 Kubernetes 的工作负载的自主弹性演示
开始使用 Mission Control 2.5
Mission Control 2.5 现已可用。现有的 NVIDIA Mission Control 用户可以访问文档中心,了解有关如何迁移到最新版本的更多信息。除了将自主恢复引擎扩展到基于 Kubernetes 的工作负载之外,其他版本亮点包括:
- 新的支持 AI 的网络异常检测服务(仅限测试版)
- 使用中央 keycloak 改进跨服务身份验证的用户体验
- 额外的安全性和 Kubernetes 加固更新
- NVIDIA Vera Rubin NVL72 的早期访问
在此处阅读完整发行说明,或阅读解决方案概述以了解更多关于 NVIDIA Mission Control 如何通过企业级软件简化 AI 工厂运营的信息,该软件涵盖工作负载编排、端到端监控和自主恢复。