在分布式 AI 工作负载中,单个错误可能引发一连串症状。一个 GPU 或网络结构事件可能在其他 rank 上表现为 NCCL 错误、调度器状态变化以及数千条下游消息。报告的异常显示工作负载在哪里停止,而不是故障从哪里开始。
在本文中,您将学习如何在示例工作负载证据上运行 NVIDIA Attribution、检查诊断结果,并探索归因规则如何识别故障模式。
NVIDIA Attribution 关联工作负载范围内的日志、指标、遥测数据和调度器状态,并返回结构化诊断:结果、根本原因、受影响节点、支持症状和证据链。以工作负载为中心意味着在上下文中分析故障,而不是将其视为孤立的节点事件。确定性规则使结果可复现且可定制,而结构化输出支持与现有健康和恢复系统集成。
NVIDIA 健康与弹性软件帮助团队保持 AI 工作负载运行。NVIDIA Attribution 解释工作负载失败的原因,并提供证据以指导下一步行动。它补充了就绪检查、持续健康监控以及修复基础设施和重启工作负载的系统。
NVIDIA Attribution 是 NVIDIA AI 基础设施中使用的以工作负载为中心的故障归因系统,现已开源。
NVIDIA Attribution 已在 NVIDIA AI 基础设施的生产环境中使用多年,每周分析数十万个 GPU 上的数百万个工作负载。在一个大型 RDMA 支持的集群中,它关联端口错误、连接重置和调度器事件,以识别特定主机和交换机端口周围的模式,帮助团队有针对性地进行网络结构修复和拥塞调优。
它包括两个可部署组件:NVIDIA Attribution Service 和 NVIDIA Attribution Blueprint;两个组件都使用核心归因引擎。Service 通过 RESTAPI 提供归因;Blueprint 将集群调度器和遥测源连接到 Service 并写入结果。
将工作负载证据转化为一个诊断
NVIDIA Attribution Service 一次分析一个工作负载尝试。Blueprint 收集工作负载上下文和证据,Service 提取并关联事件,Blueprint 返回结构化结果。
该路径有四个阶段:
- 确定工作负载范围。 Blueprint 根据调度器标识符或显式执行窗口和节点分配来识别工作负载尝试。
- 收集观察结果。 日志和指标连接器从应用程序日志、系统日志、GPU 驱动和 Fabric Manager 消息、调度器历史、节点和网络指标中生成工作负载范围的
Observation记录。 - 提取并关联事件。 Service 调用归因引擎来识别重要事件,例如 GPU XID、NCCL 故障、调度器转换和指标条件。确定性规则评估它们的时间和交互,将下游症状与导致故障的事件分开,并识别根本原因。
- 返回结构化结果。 Blueprint 将判定与工作负载结果(
terminal_state)、归因域(sub_domain)、症状、受影响节点以及收集器覆盖和错误记录相结合。
从应用日志到归因
以下是一个示例,展示如何提取证据、解释事件并保留解释分布式工作负载故障的症状。
考虑一个多 rank 训练工作负载,其中一个 GPU 遇到硬故障,例如:XID 149,随后其他 rank 出现 NCCL 错误。NVIDIA Attribution 关联跨节点的事件,将 XID 识别为根本原因,将 NCCL 故障保留在症状链中,并指出责任节点。工作负载被报告为硬件故障,而不是一组独立的通信错误。
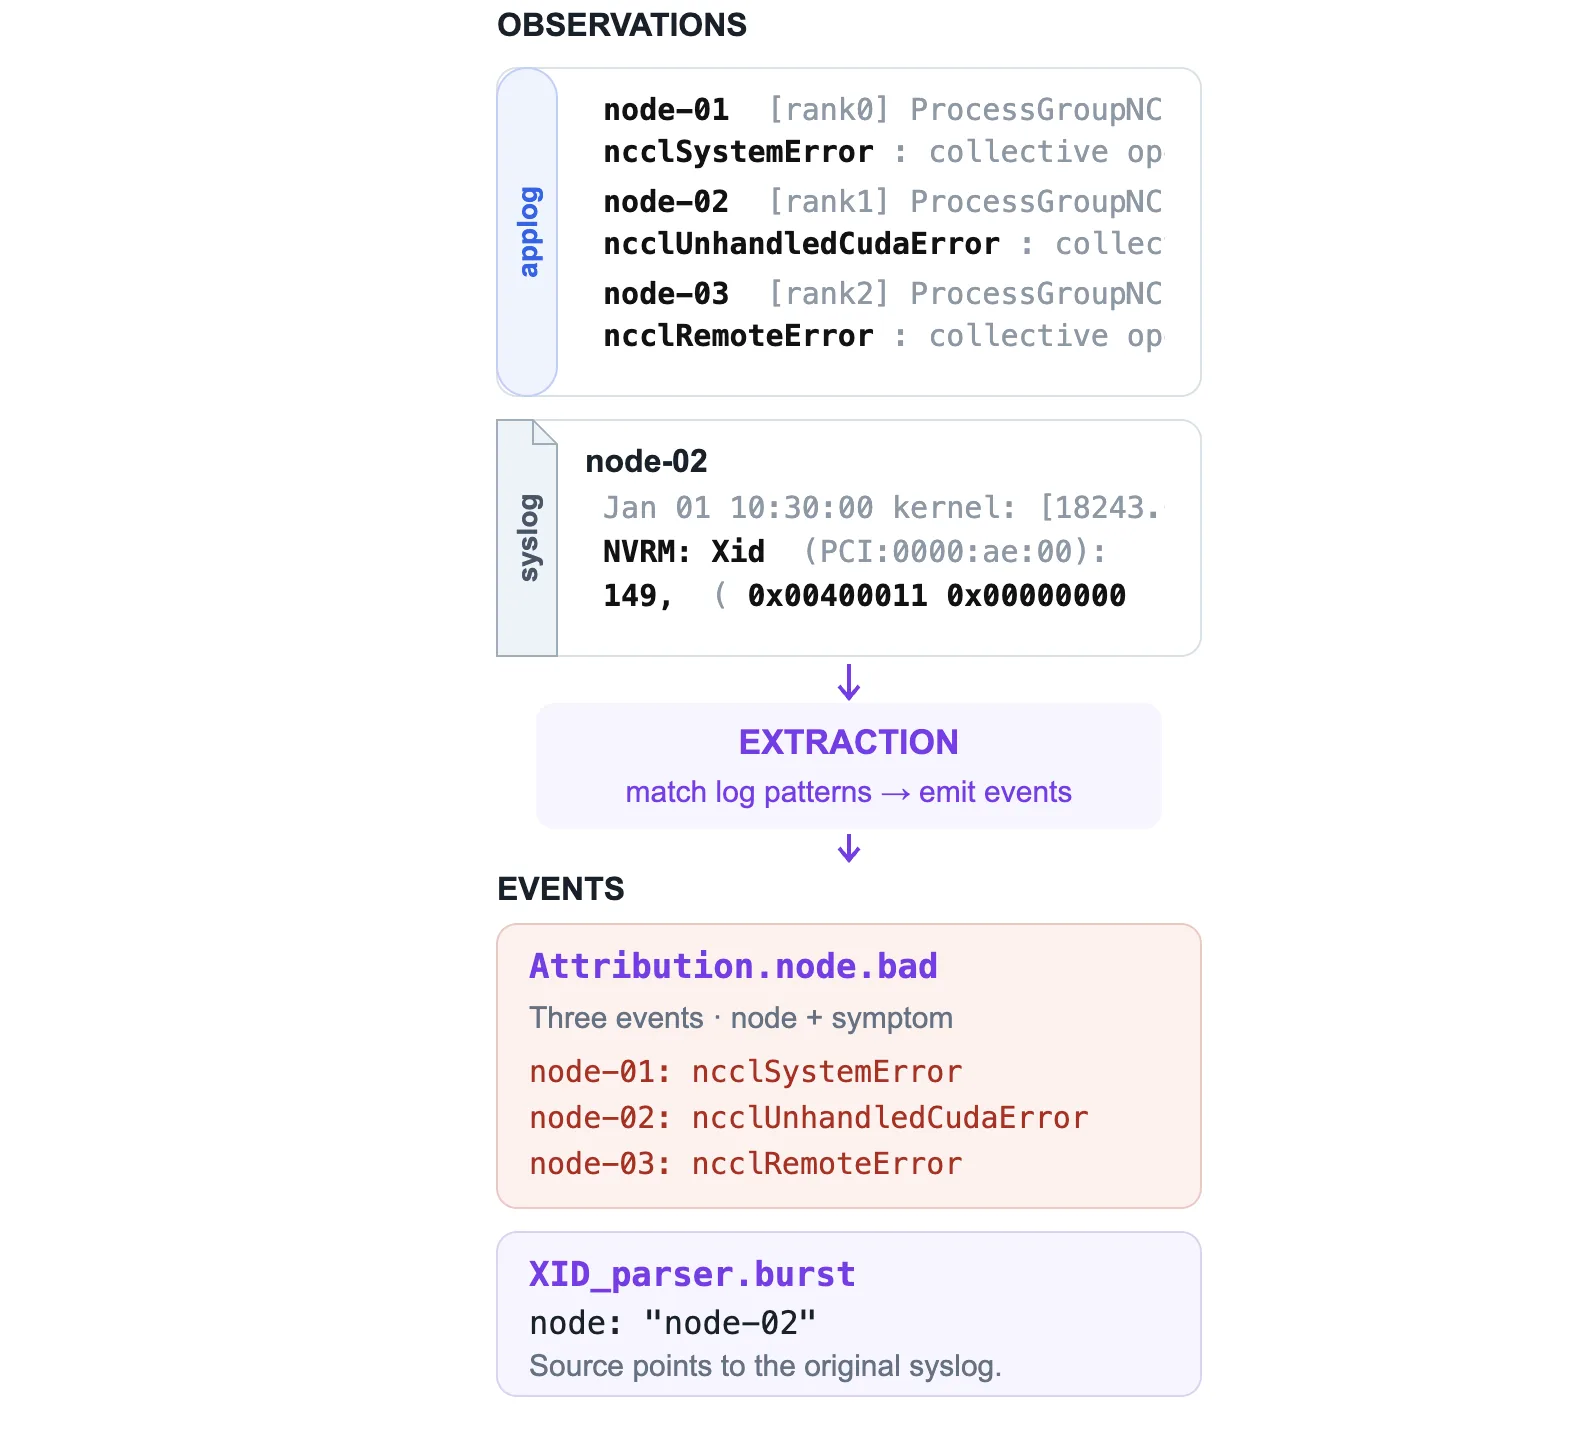
失败的集合通信可能在多个节点上留下错误报告。这些报告告诉我们工作负载在哪里注意到问题。为了解释故障,NVIDIA Attribution 将它们与其他来源的证据结合,并一起评估症状。
在这个合成工作负载中,应用程序日志包含三个不同的 NCCL 错误。node-02 上的系统日志包含 XID 149,其错误字解码为 NVLink 信号完整性问题。我们将沿着该证据通过规则管道。
通过提取解释日志
提取阶段首先运行;它在原始输入日志上运行,并生成结构化事件以供后续阶段处理。
在过滤期间解码 NVLink 证据
过滤规则读取和写入事件流。EARLY 阶段的 HandleXidBurstEvents 规则读取 XID 突发证据,解码错误字,并为 node-02 上的信号完整性问题发出归因事件。三个 NCCL 事件在此步骤中保持不变。
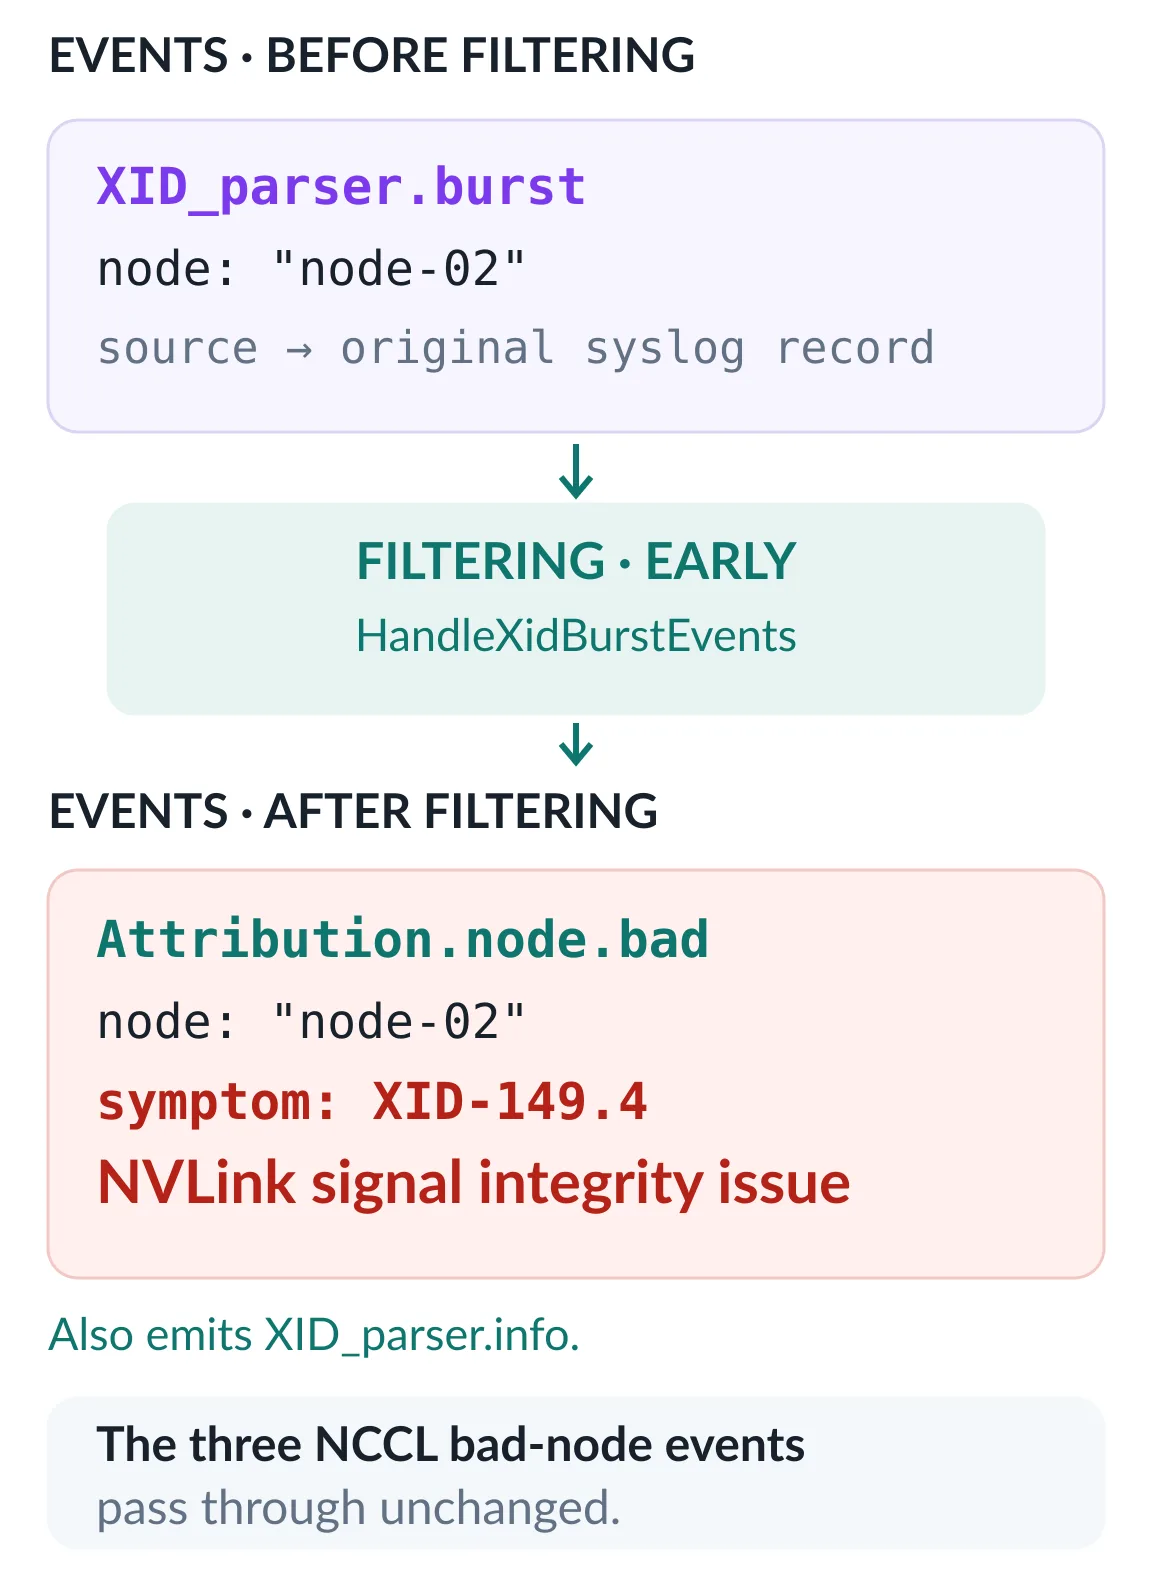
上图 2 中,该图将解码后的症状缩写为 XID-149.4 信号完整性问题。过滤器还发出解析器信息以供检查。
将症状提炼为单一归因
该框架将事件具体化为每个节点的症状,运行逐节点清理,并将存留的症状聚合为作业范围的集合。在此示例中,全部四个候选都进入 FINAL 精炼。
Xid149AndNvlinkFiltering 保留信号完整性症状并降级其他节点症状。Gb200PriorityRootCause 缩减活跃的作业范围症状集。随后结果映射产生硬件故障归因。
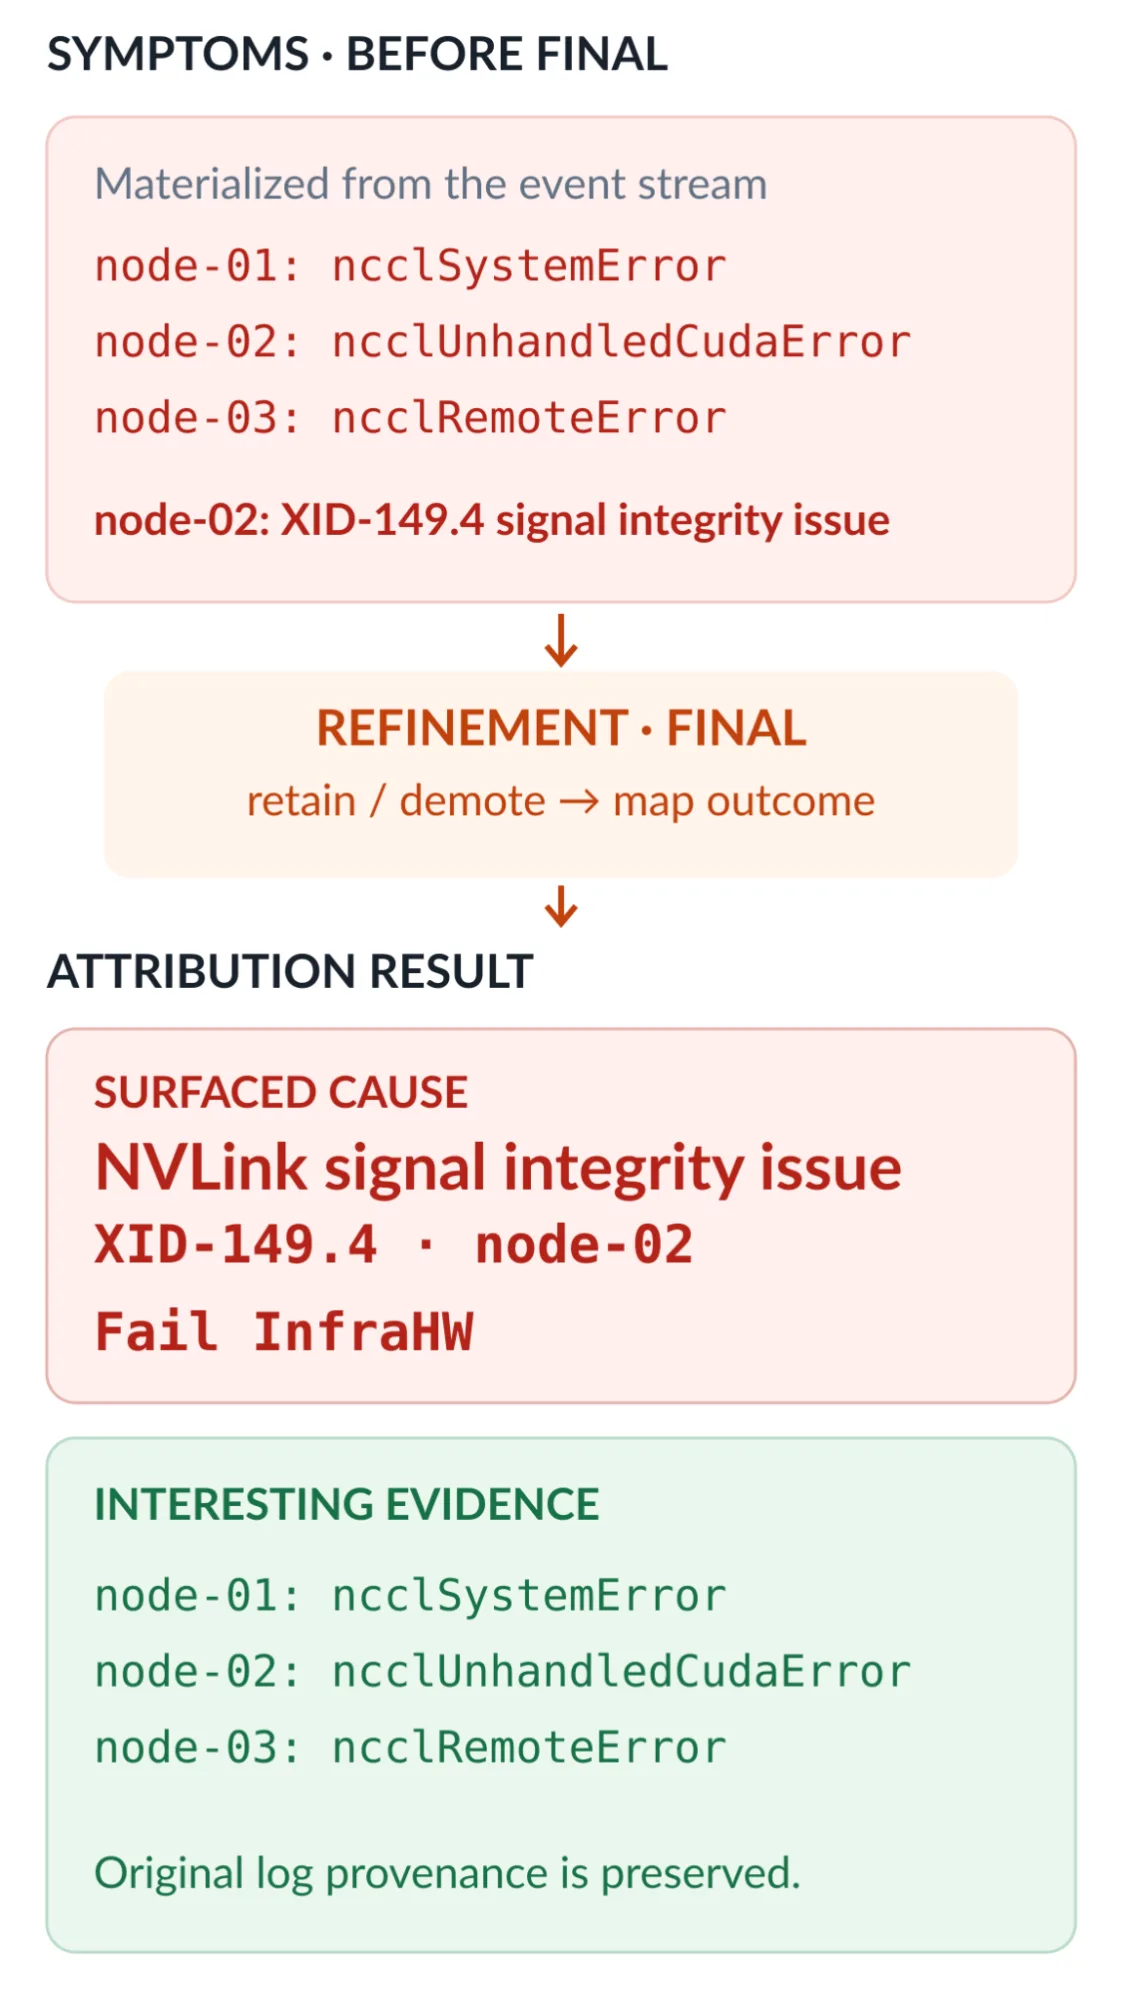
归因浮现 node-02 和信号完整性问题。NCCL 报告仍是有用证据:降级将其原始来源保留为“值得关注”,因此仍可检查。
当多个原因符合证据时,sub_domain 存在歧义。归因质量取决于底层遥测的质量和完整性。诊断记录了这一区别,正确反映不确定性,而不是将不完整的证据转化为确定性诊断。
服务与 Blueprint 架构
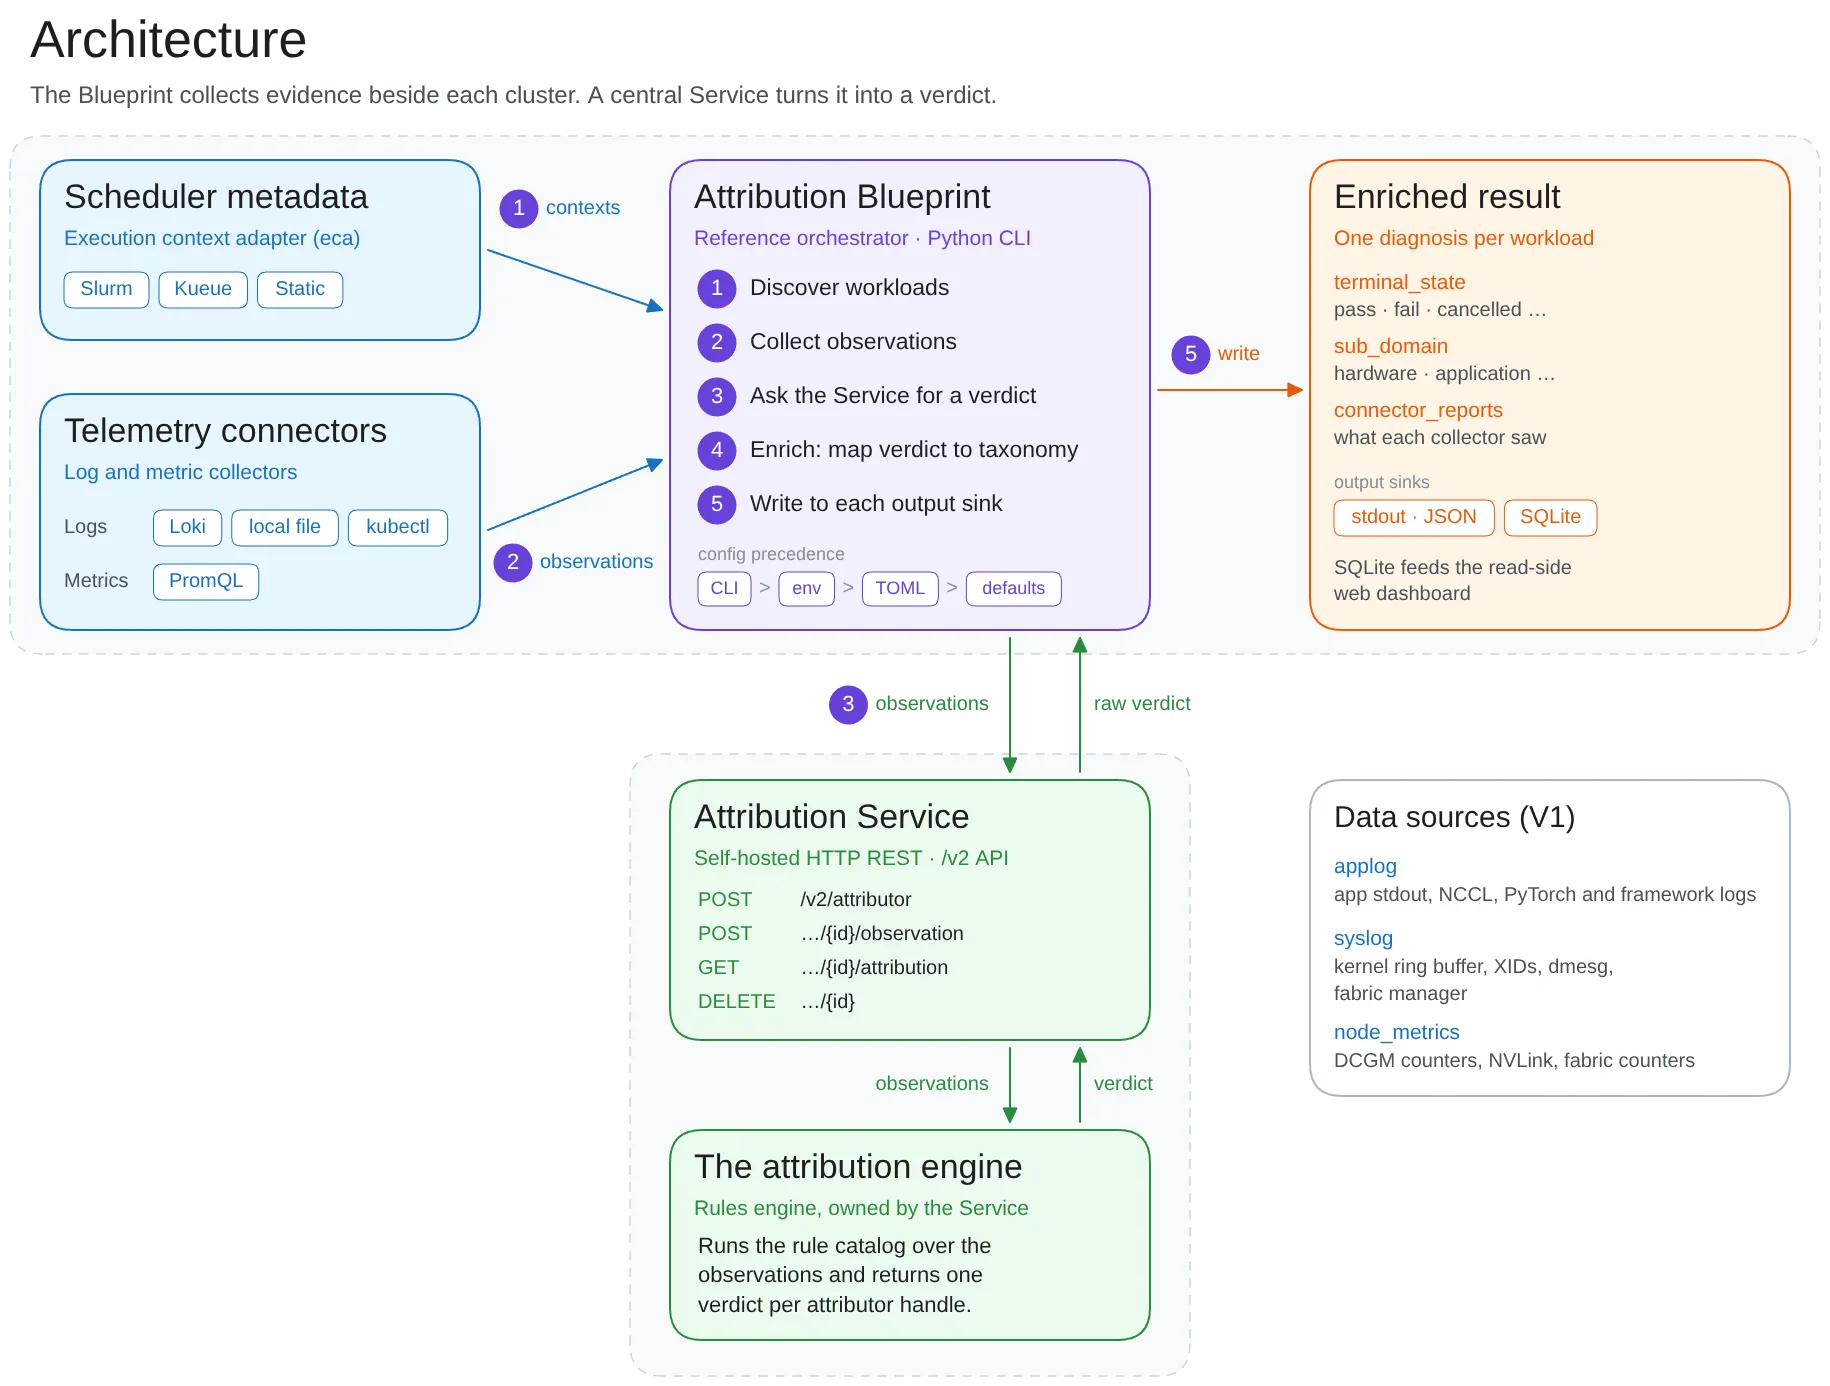
归因引擎包含规则引擎和核心归因逻辑。Attribution Service 通过 HTTP API 暴露该逻辑,Blueprint 处理集群特定的集成。这种分离让团队可以在各集群间应用相同的归因逻辑,同时为每个环境适配调度器、遥测和输出连接器。
Attribution Service: 围绕核心归因引擎的自托管 HTTP 封装,接收规范化观测并为每个工作负载返回一个判定。
Attribution Blueprint: 一个 Python 参考编排器,负责发现工作负载、解析 ExecutionContext、运行收集器、调用 Service、丰富判定、写入 AttributionBlueprintResult,并提供只读仪表板。它旨在作为参考实现,供从业者根据自身环境定制解决方案。
Blueprint 附带:
- 用于 Slurm、Kueue 和静态输入的执行上下文连接器
- 用于 Loki、本地文件、Kubernetes pod 日志和 PromQL 指标的日志与指标连接器
- 用于 stdout 和 SQLite 的输出连接器
Blueprint 可以运行在每个集群的数据源附近,既可为每个 Blueprint 使用专用的 Attribution Service,也可为多个 Blueprint 使用共享的 Service。定制部署方式具有灵活性,例如:一对一或一对多。下游系统消费 terminal_state 和 sub_domain,而不是解析产品特定的日志。
将归因扩展到你的基础设施
开源 NVIDIA Attribution 使基础设施团队能够一次编码故障模式,并将其应用于工作负载和集群。开发者可以为新的故障模式添加规则,为其调度器和遥测后端实现连接器,并将 AttributionBlueprintResult 记录路由到事件、恢复和集群管理系统。由于扩展使用相同的 ExecutionContext、Observation 和结果契约,新的集成会馈入相同的诊断流水线。
演练
前面的示例说明了 GPU 故障如何导致各 rank 上的 NCCL 错误。在本演练中,你将使用 NVIDIA Attribution 分析来自一个已记录训练工作负载的 NVLink 错误证据。你将运行附带的示例,检查诊断和源证据,并检查缩小所报告症状的规则。然后你将使用 NVIDIA 恢复指南来确定受影响节点的下一步操作。
该演练使用两个组件:
- Attribution Service 运行分析规则。
- Attribution Blueprint 读取工作负载上下文和日志,调用 Service,并将结果存储到本地仪表板以供检查。
示例证据随仓库提供,因此你可以在连接实时集群之前先跟随分析过程。
运行示例工作流
NVIDIA Attribution 快速入门 在 Docker 中构建 Attribution Service 和仪表板,然后使用 Blueprint 处理提交到仓库的示例工作负载证据。你需要 Docker 和 uv 包管理器。
克隆仓库并运行示例工作流:
git clone https://github.com/dsx-ai-factory/attribution.git nvidia-attribution
cd nvidia-attribution


docker build \
  -f blueprint/docker/Dockerfile \
  -t attribution-blueprint-web:quickstart \
  "$PWD"


mkdir -p .attribution-sample


docker run -d --rm \
  --name attribution-blueprint-web-local \
  -e ATTRIBUTION_DB=/data/attributions.db \
  -p "127.0.0.1:8000:8000" \
  -p "127.0.0.1:8080:8080" \
  -v "$PWD/.attribution-sample:/data" \
  attribution-blueprint-web:quickstart


uv run --project blueprint --frozen nvidia-attribution-blueprint \
  --configs blueprint/examples/static/configs \
  --connector attribution service_url http://127.0.0.1:8000 \
  --connector output db sqlite path .attribution-sample/attributions.db
打开 http://127.0.0.1:8080 以检查每个工作负载的诊断、受影响节点、支持症状和证据轨迹。
规则引擎使用已检入的声明式规则和 Python 规则。这条生产规则识别应用程序日志中的无效 Pyxis 参数,并包含一个同位置测试用例:
[[extractor]]
name     = "SrunInvalidPyxisArgument"
match_re = "srun: error: Invalid --(?:no-)?container-\\S+ argument:"
emit     = { type = "bad_node", symptom = "srun: invalid pyxis argument" }


[[extractor.cases]]
expect  = "bad"
line    = "srun: error: Invalid --container-mounts argument: /nonexistent"
symptom = "srun: invalid pyxis argument"
启动时,Service 加载捆绑的规则目录并评估内联用例。规则变更通过提交并随 Service 一起发布;规则不会通过 HTTP API 动态上传。仓库的 规则编写指南 说明了如何选择合适的规则形式、注册新症状、添加测试并验证完整目录。
开始使用
克隆 NVIDIA Attribution 仓库 并按照 快速入门 运行示例并检查其诊断。要将 Attribution 用于你自己的基础设施,请参阅 Blueprint 配置参考 了解调度器和遥测连接器,并学习如何为新的证据模式 添加提取器规则。
致谢
Aaron Blakeman、Ajay Hotchandani、Alex Shaposhnikov、Ashwin Poojary、Ben Gueret、Chunyang Sheng、Dorrin Poorkay、Gargi Prasad、Felix Abecassis、Grace Tan、Jason Sewall、Mayuri Gupta、Pasha Shamis、Pavan Kumar Gondhi、Piero Orderique、Rahul Kandu、Rakesh Konda 和 Sirshak Das 为 NVIDIA Attribution 及本文做出了贡献。