蛋白质设计是一个搜索问题。为一个八残基的蛋白质序列选择氨基酸,可能有超过250亿种组合。为一个100残基的蛋白质序列选择氨基酸,其可能性数量超过可观测宇宙中的原子数量。在这个空间的某处,存在一种蛋白质,能为新疗法开辟道路。组合太多,无法穷举搜索,因此找到它取决于知道该去哪里寻找。
RFD4-Proteina 是 NVIDIA BioNeMo 开放模型,由 NVIDIA 与华盛顿大学医学院蛋白质设计研究所共同开发,它利用从自然中学到的模式来导航该空间。它共同设计蛋白质序列和全原子结构,并使用奖励引导的推理时搜索将计算集中在最有希望的候选者上。
本教程向计算生物学家、机器学习工程师和药物发现研究人员展示如何使用奖励引导的推理时搜索,针对肿瘤靶点 PD-L1 设计蛋白质结合剂候选物,并介绍跨设计任务的实验验证结果。
您可以通过两种方式访问 RFD4-Proteina:
基于 Proteina-Complexa 的部分潜在方法,RFD4-Proteina 将显式主链坐标与潜在表示、学习到的序列和原子变量相结合。其自编码器解码器同时生成序列和全原子结构,消除了向 ProteinMPNN 等模型单独进行逆折叠交接的步骤。
先决条件
- 开放模型
- 支持的 Linux GPU 主机和 Python 3.12;遵循仓库设置指南并使用受支持的 NVIDIA GPU。
- 模型缓存: 设置会自动下载 Hugging Face 包;仅当您想要不同的缓存目录时才设置 HF_HOME。
- NIM
- 自托管: 满足NIM 先决条件的 x86_64 或 arm64 Linux、Docker、NVIDIA 驱动、NVIDIA 容器工具包以及 NGC API 密钥。
- NIM API 端点(不推荐用于生产运行): 通过 Shell 和 Python 脚本,经由 NVIDIA build.nvidia.com 进行 HTTP 访问,无需本地 GPU 或模型安装。
关于 RFD4-Proteina
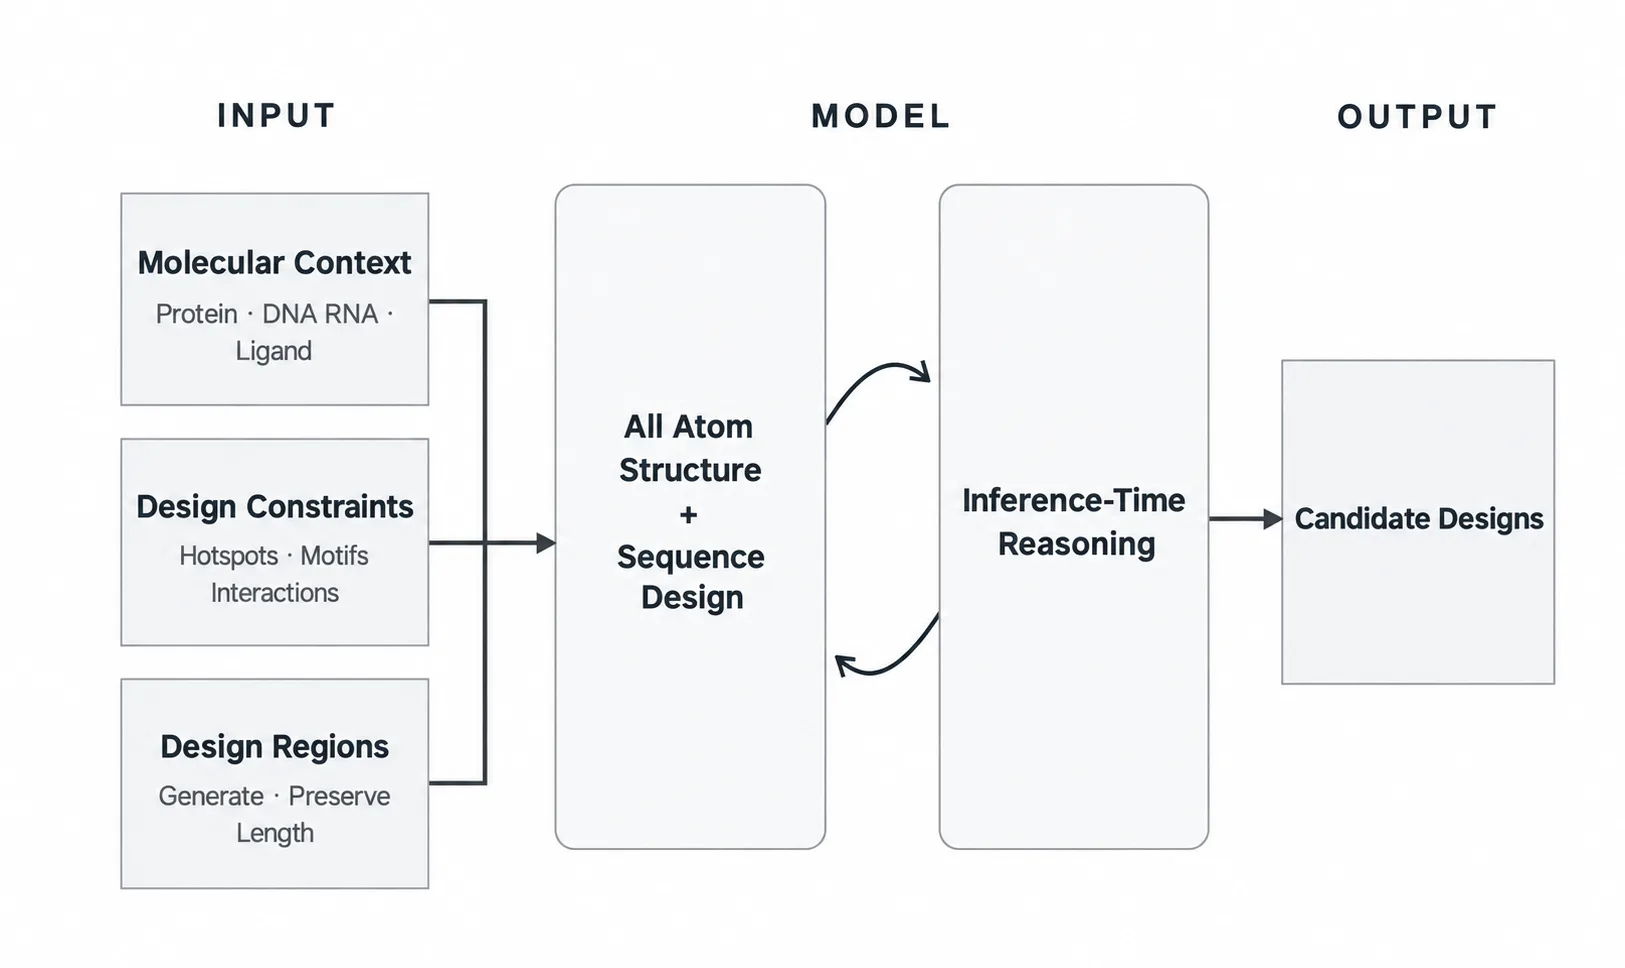
上图 1 中所示的搜索循环是 RFD4-Proteina 集中计算的地方。
在推理时推理搜索期间,模型对生成轨迹去噪以获得结构,对这些设计进行评分,保留并分支有希望的部分状态,并继续直到达到生成标准。
奖励可以衡量几何、相互作用或独立预测置信度。这种额外搜索针对指定目标优化设计,以产生评分更高的设计。在本教程后面,您将看到用户如何通过开放模型和 NIM 启用此功能。
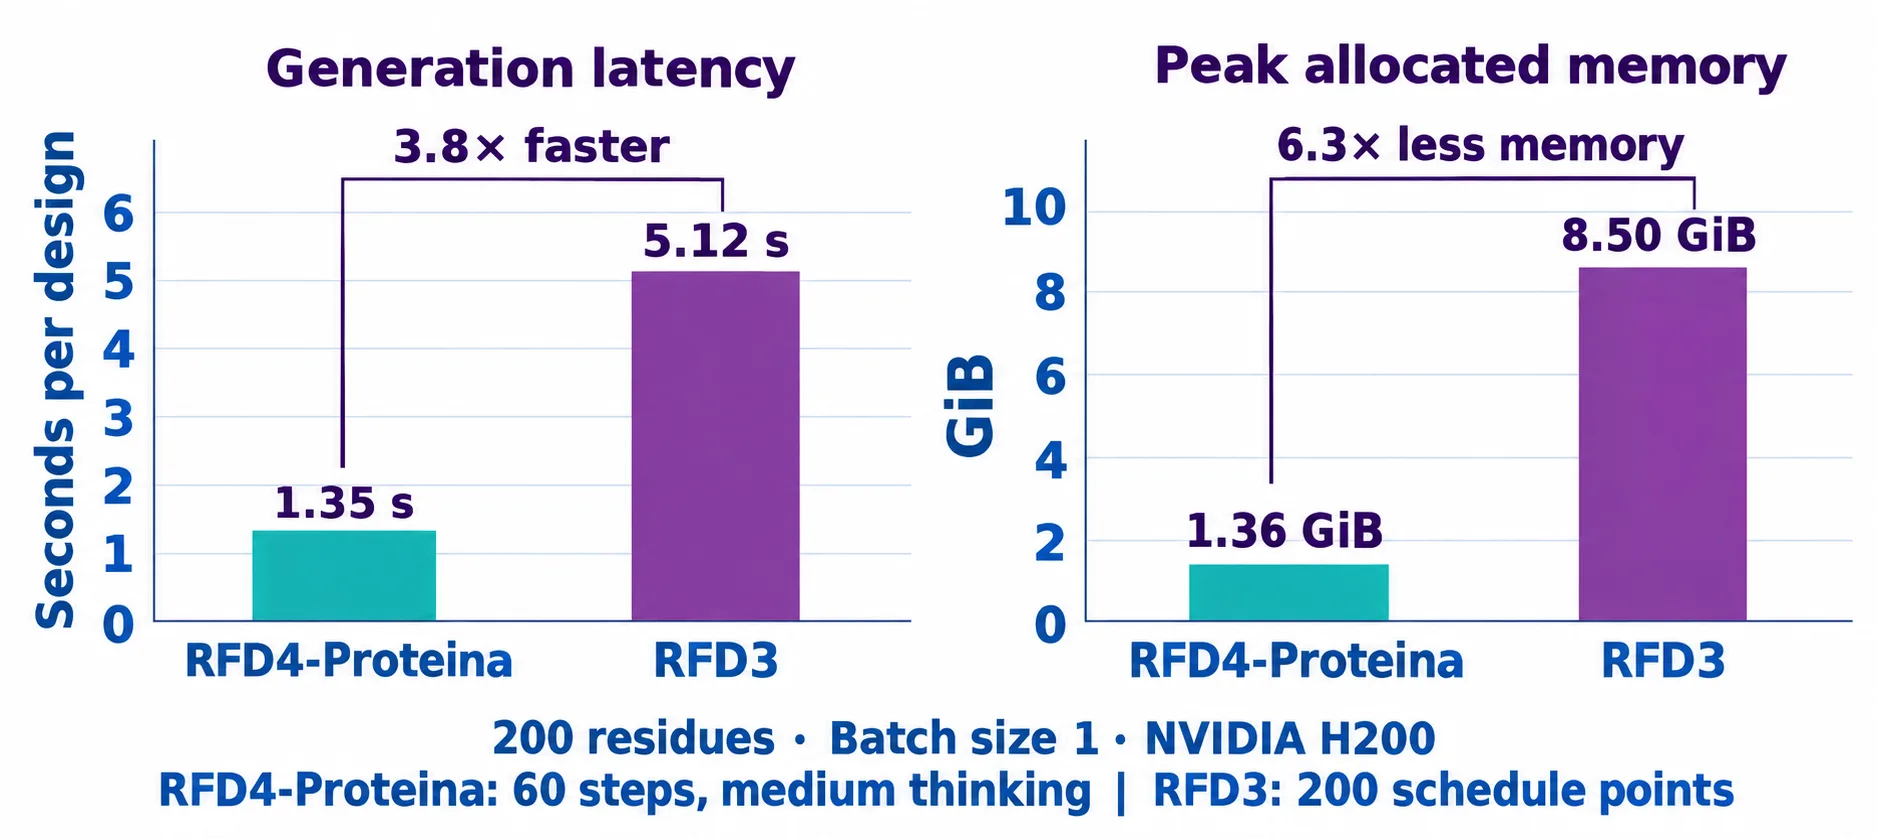
RFD4-Proteina 比 RFD3 更快且使用更少内存,原因有几个:
- 它在残基级潜在表示上工作,而不是原子级,从而避免了内存爆炸。
- 扩散过程的工程化将采样从 Proteina-Complexa 中的约 400 步减少到 60 步,并且由于模型中的推理能力,计算集中在过程中最重要的部分。
- 推理时搜索也更快,因为预言机(OF3 和像 tmol 这样的物理方法)是 CUDA 加速的。
- 模型和内核与 cuEquivariance 和 BioNeMo 推理运行时(BIR)团队共同设计,以实现速度和可扩展性。
从分子设计想法到候选设计
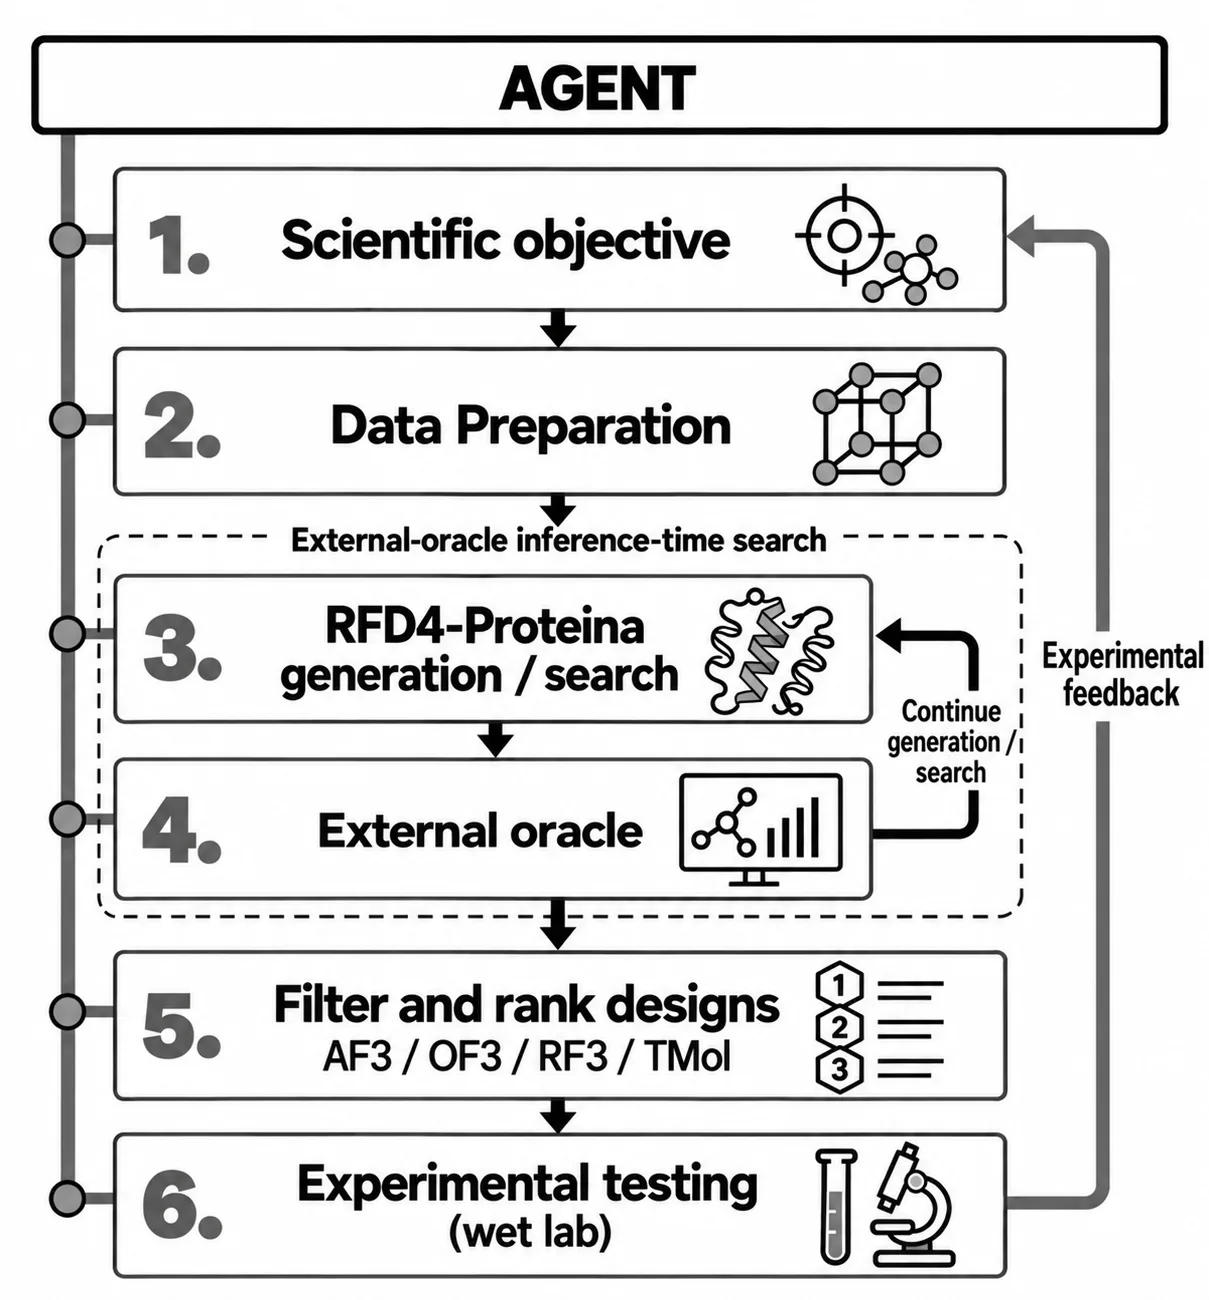
上图 3 中的工作流演示了如何使用 RFD4-Proteina 从科学目标到候选物进行实验测试。代理可以协调这些工具并跟踪结果,而科学家定义目标并使用实验证据指导下一轮。
准备分子输入和环境
首先定义生成的标准和要求。例如,RFD4-Proteina 期望用户定义什么可以改变、什么必须保持不变,以及计算和实验成功标准。
使用 AtomWorks 生成/操作输入数据。AtomWorks 是用于为 RFD4-Proteina 准备结构和设计注释的分子数据层。其 Python 和 PyMOL 工作流准备固定原子、可设计残基、热点和分子上下文。在设计周围蛋白质时,保留提供的配体或基序化学。
开放模型和 NIM 都接受带注释的 CIF 或条件规范及其源结构。下面的规范固定目标并定义新的结合剂。
仓库中来自 PDB 5O45 的裁剪 PD-L1 结构作为目标。固定目标的序列和主链坐标,允许其侧链重新堆积,并将结合剂生成引导至 Tyr56、Met115 和 Tyr123 上的热点原子。新结合剂有 100–150 个残基,序列和坐标自由。
克隆仓库,然后在其根目录运行示例。这会写入 pdl1.json;两个路径使用相同的目标 CIF 和条件。
git clone https://github.com/RosettaCommons/RFD4-Proteina.git
cd RFD4-Proteina

cat > pdl1.json <<'JSON'
{
  "pdl1_binder": {
    "input": "docs/examples/inputs/5o45_cropped.cif",
    "contig": "100-150, /0, A17-131",
    "conditions": {
      "C_CRD": {"true": [{"select": "sel('A') and is_protein_backbone"}]},
      "C_SEQ": {"true": [{"select": "sel('A')"}]},
      "C_HOT": {"true": [
        {"select": "sel('A/*/56/[CG,OH]')"},
        {"select": "sel('A/*/115/[CG,SD]')"},
        {"select": "sel('A/*/123/[CD2,OH]')"}
      ]}
    }
  }
}
JSON
开放模型设置
在受支持的 Linux/CUDA 系统上,使用当前 uv 版本(已用 0.12.24 验证)安装仓库环境。如果已安装 uv,请先更新它,以便识别 CUDA 13.2。设置过程会缓存 Hugging Face 模型包,包括配对的自动编码器。当模型仓库为私有时,使用具有访问权限的账户通过 hf auth login 进行身份验证。
bash setup.sh --native
source .venv/bin/activate
NIM 环境设置
要托管 NIM,请在已安装 Docker 和 NVIDIA Container Toolkit 的受支持 GPU 主机上,于 Bash 中运行此代码块。
read -rsp 'NGC API key: ' NGC_API_KEY; echo
export NGC_API_KEY
printf '%s' "$NGC_API_KEY" | docker login nvcr.io \
  -u '$oauthtoken' --password-stdin
image=nvcr.io/nim/ipd/rfd4-proteina:latest
docker pull "$image"
export RFD4_NIM_IMAGE="$(docker image inspect \
  --format '{{index .RepoDigests 0}}' "$image")"
printf '%s\n' "$RFD4_NIM_IMAGE" > nim-image.txt
export LOCAL_NIM_CACHE="$HOME/.cache/nim"
mkdir -p "$LOCAL_NIM_CACHE"
docker run -d --rm --name rfd4-proteina \
  --runtime=nvidia --gpus 'device=0' -p 8000:8000 \
  -e NGC_API_KEY -v "$LOCAL_NIM_CACHE":/opt/nim/.cache \
  --shm-size=16g "$RFD4_NIM_IMAGE"
生成序列和结构
开放模型生成
将以下内容保存为仓库根目录中的 design.py。同一脚本支持生成和搜索。Proteina.from_pretrained("nvidia/RFD4-Proteina") 加载当前 Hugging Face 模型和配对的自动编码器检查点。
import hydra
from rfd4_proteina import Proteina
from rfproteina.generate import run_generation


@hydra.main(config_path="configs", config_name="inference", version_base="1.3")
def main(cfg):
    model = Proteina.from_pretrained("nvidia/RFD4-Proteina")
    run_generation(cfg, model=model)


if __name__ == "__main__":
    main()
从仓库根目录生成一个候选:
python design.py inputs=pdl1.json out_dir=runs/pdl1-open seed=42 compile_lengths=null
输出保存在 runs/pdl1-open/inference_samples/ 下。添加 num_replicates=10 可生成十个候选,并为每次运行选择新的 out_dir。Hugging Face 会缓存下载;在 from_pretrained 中添加 revision=”<commit>” 以复现特定模型版本。
NIM 生成
将此保存为 nim_client.py。它将 PD-L1 条件规范和目标 CIF 发送到 NIM,然后保存生成的结构和响应指标。
import json
from pathlib import Path
import requests

spec = json.loads(Path("pdl1.json").read_text())["pdl1_binder"]
target = Path(spec["input"])
spec["input"] = target.name
payload = {
    "task": "motif_scaffolding",
    "input": {"format": "condition_spec", "example_id": "pdl1_binder",
              "spec": spec, "files": [{"filename": target.name, "content": target.read_text()}]},
    "sampling": {"num_replicates": 1, "seed": 42},
    "metrics": {"tags": ["design", "hotspot_conditioning"]},
}

def submit(payload, out):
    out.mkdir(parents=True, exist_ok=True)
    response = requests.post("http://localhost:8000/biology/ipd/rfd4-proteina/generative",
                             json=payload, timeout=1800)
    response.raise_for_status()
    result = response.json()
    (out / "response.json").write_text(json.dumps(result, indent=2))
    for i, design in enumerate(result["designs"]):
        dest = out / f"design-{i}.cif"
        dest.write_text(design["structure"]["content"])
        print(design["design_id"], dest)

if __name__ == "__main__":
    submit(payload, Path("runs/pdl1-nim"))
安装 requests 并从仓库根目录运行客户端。将 pdl1.json 放在目标 CIF 旁边。
python -m pip install requests
python nim_client.py
跨开放模型和 NIM 的性能优化
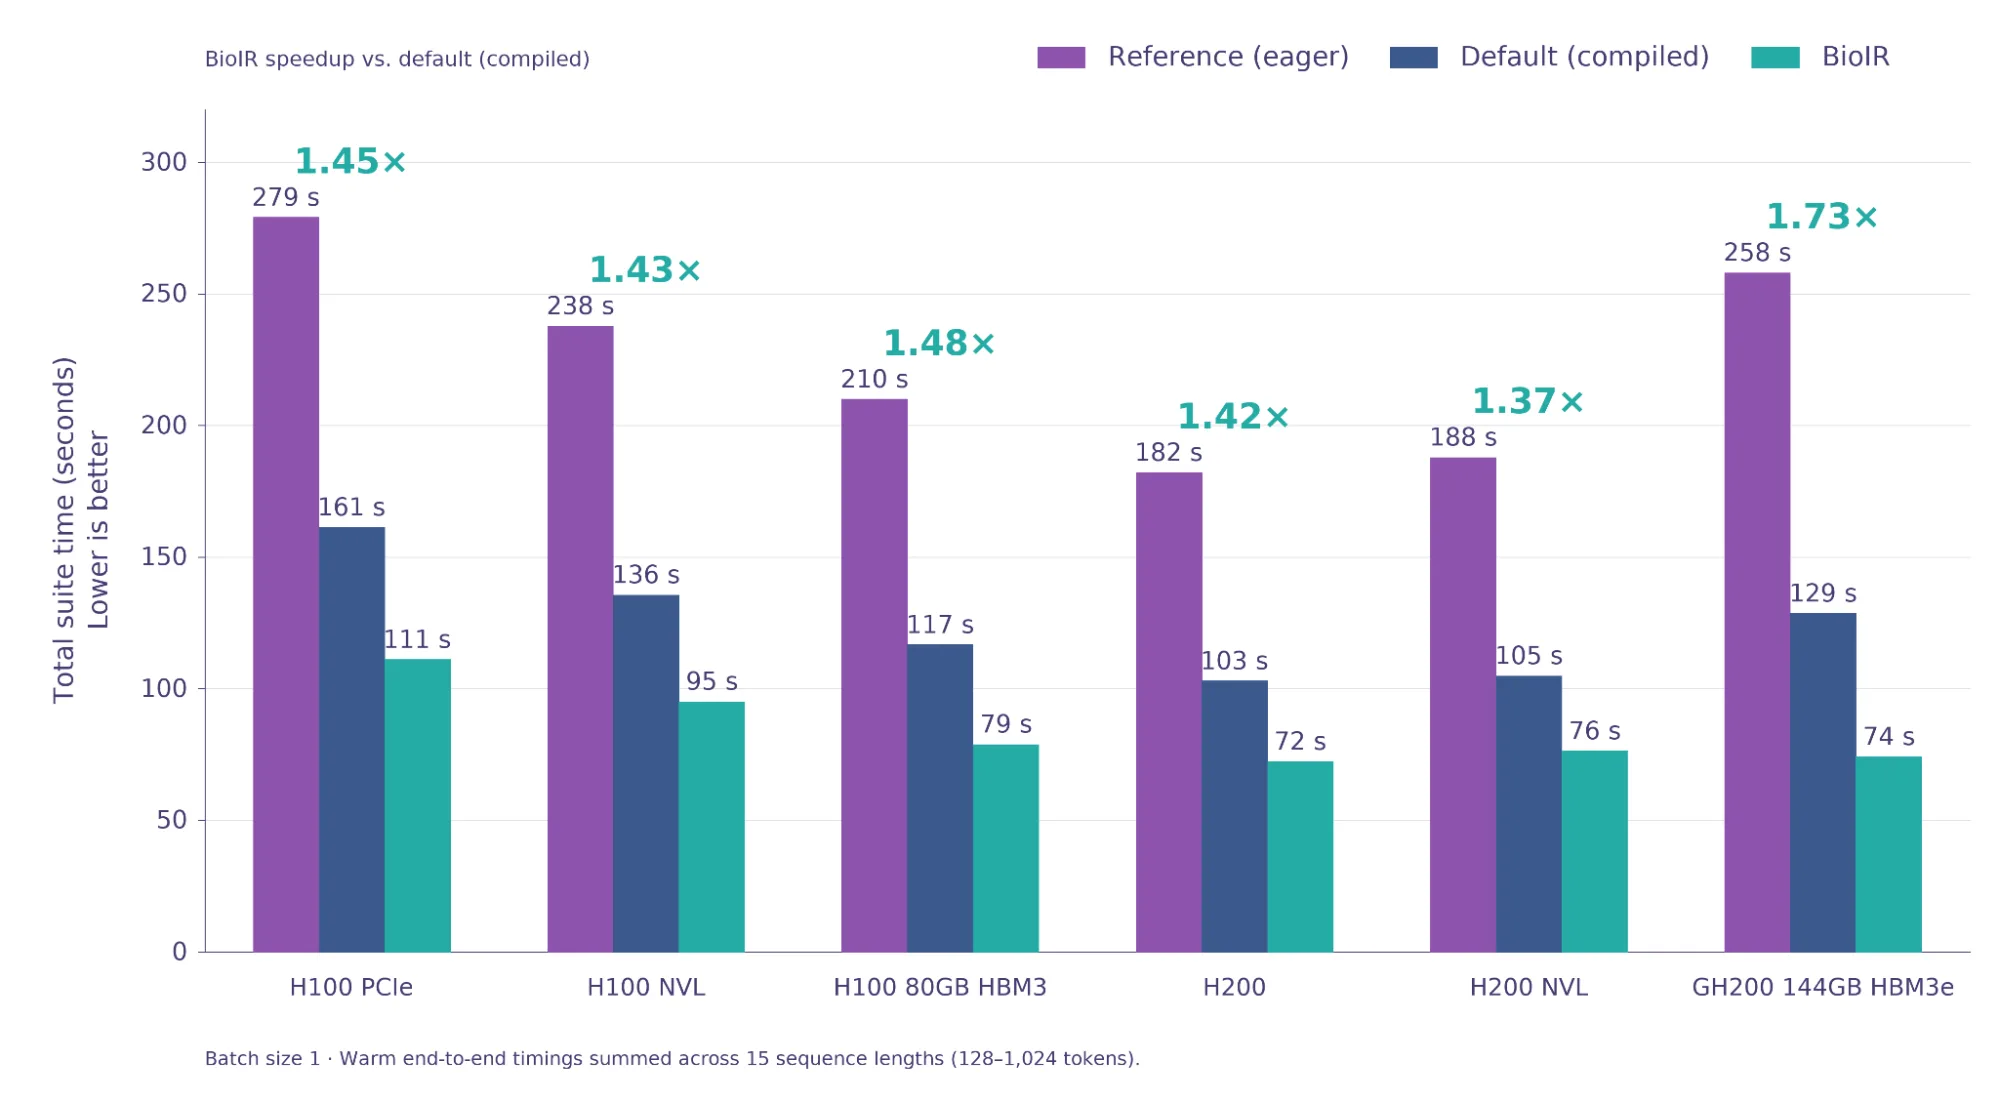
为了加快设计迭代,BioIR 后端 在六种测试的 Hopper GPU 配置上,将 RFD4-Proteina 相比默认编译后端加速 1.37–1.73 倍(见下方图 4)。在 H100 PCIe 上,套件总时间从 161 秒降至 111 秒,运行时间减少约 31%。基准测试使用批大小 1,并对 15 个序列长度(128–1,024 个 token)的预热端到端时间求和。
使用外部 oracle 进行推理时搜索
使用 OpenFold3 进行开放模型搜索
使用 ./scripts/download_example_data.sh ./data_path 安装可选的 OpenFold3 运行时和权重。将 OF3_IMAGE、OF3_MODEL_DIR 和 OF3_JAX_CACHE_DIR 设置为其打印的路径,然后运行 mkdir -p "$OF3_JAX_CACHE_DIR"。GPU 主机上必须可用 Apptainer。
此示例使用 AlphaFold3 代码库(以开源 Apache 2.0 许可证发布)和 OpenFold3 模型权重(同样以 Apache 2.0 许可证发布)。
使用搜索预设复用 design.py:
python design.py inference_experiment=inference_beam_example \
  metrics/refolding_oracles=of3 inputs=pdl1.json subset_to_examples=null \
  num_replicates=1 out_dir=runs/pdl1-open-search seed=42 compile_lengths=null
该预设使用两个分支、束宽为三,并在步骤 20、40、50 和 60 进行评分。它奖励设计链的 OpenFold3 pLDDT(oracle.plddt_coi),下限为 50,并在奖励 80 时保存合格的 rollout。这衡量的是对结合剂的置信度,而非结合的证据;请单独检查界面和重折叠指标。输出位于 runs/pdl1-open-search/ 下。
使用 OpenFold3 进行 NIM 搜索
将此保存为 nim_search_request.py。它复用 PD-L1 输入并提交奖励引导的 OpenFold3 搜索。
from pathlib import Path
from nim_client import payload, submit

key = "oracle_of3_nvcf.overall_plddt"
payload["sampling"]["num_steps"] = 60
payload["search"] = {
    "step_checkpoints": [0, 20, 40, 50, 60],
    "n_branch": 2, "beam_width": 3,
    "reward_metrics_tags": ["unconditional_refolding"],
    "weights": {key: 1.0}, "clip_values": {key: {"min": 50.0}},
    "intermediate_save_min_reward": 80.0,
}
payload["metrics"] = {"tags": ["design", "unconditional_refolding"]}
submit(payload, Path("runs/pdl1-nim-search"))
启用 NIM oracle
按照oracle 指南中的说明挂载 OpenFold3 reward.py 回调。它报告整个复合物的 oracle_of3_nvcf.overall_plddt;请单独评估结合剂界面。
将 oracle 指南中的 OpenFold3 NVCF 回调保存为 reward.py,并使用 NVCF 调用凭据导出 OF3_NIM_API_KEY。使用此回调重新启动服务:
docker stop rfd4-proteina
docker run -d --rm --name rfd4-proteina \
  --gpus 'device=0' -p 8000:8000 --shm-size=16g \
  -e NGC_API_KEY -v "$LOCAL_NIM_CACHE:/opt/nim/.cache" \
  -v "$PWD/reward.py:/opt/nim/reward.py:ro" \
  -e NIM_ALLOW_ORACLE_PLUGIN=true -e OF3_NIM_API_KEY \
  "$RFD4_NIM_IMAGE"
运行搜索脚本。它将设计和响应指标保存在 runs/pdl1-nim-search/ 下。
python nim_search_request.py
此请求使用两个分支、检查点 [0, 20, 40, 50, 60] 和束宽三。它设置奖励下限为 50,并保存分数至少为 80 的中间设计。这些是 OpenFold3 整体 pLDDT(整个复合物的预测置信度指标)的示例阈值。搜索时奖励标签和最终报告标签是分开的。
搜索输出数量会有所不同。在选择候选之前,检查生成的 CIF 和保留的指标。在计算比较中包括重折叠和评分。
过滤和排序候选
检查约束、基序保留、冲突、界面、重折叠一致性和结构多样性指标。OpenFold3 和 RoseTTAFold3 提供预测选项;TMol 提供受 Rosetta 启发的全原子评分和优化。
常见指标包括来自 OpenFold 3 等蛋白质结构预测模型的 ipTM(界面预测模板建模)、ipSAE(基于对齐误差的相互作用预测分数)和 RMSD(均方根偏差)分数,以及来自 TMol 等基于物理的模型的相互作用能。
进行实验测试并改进
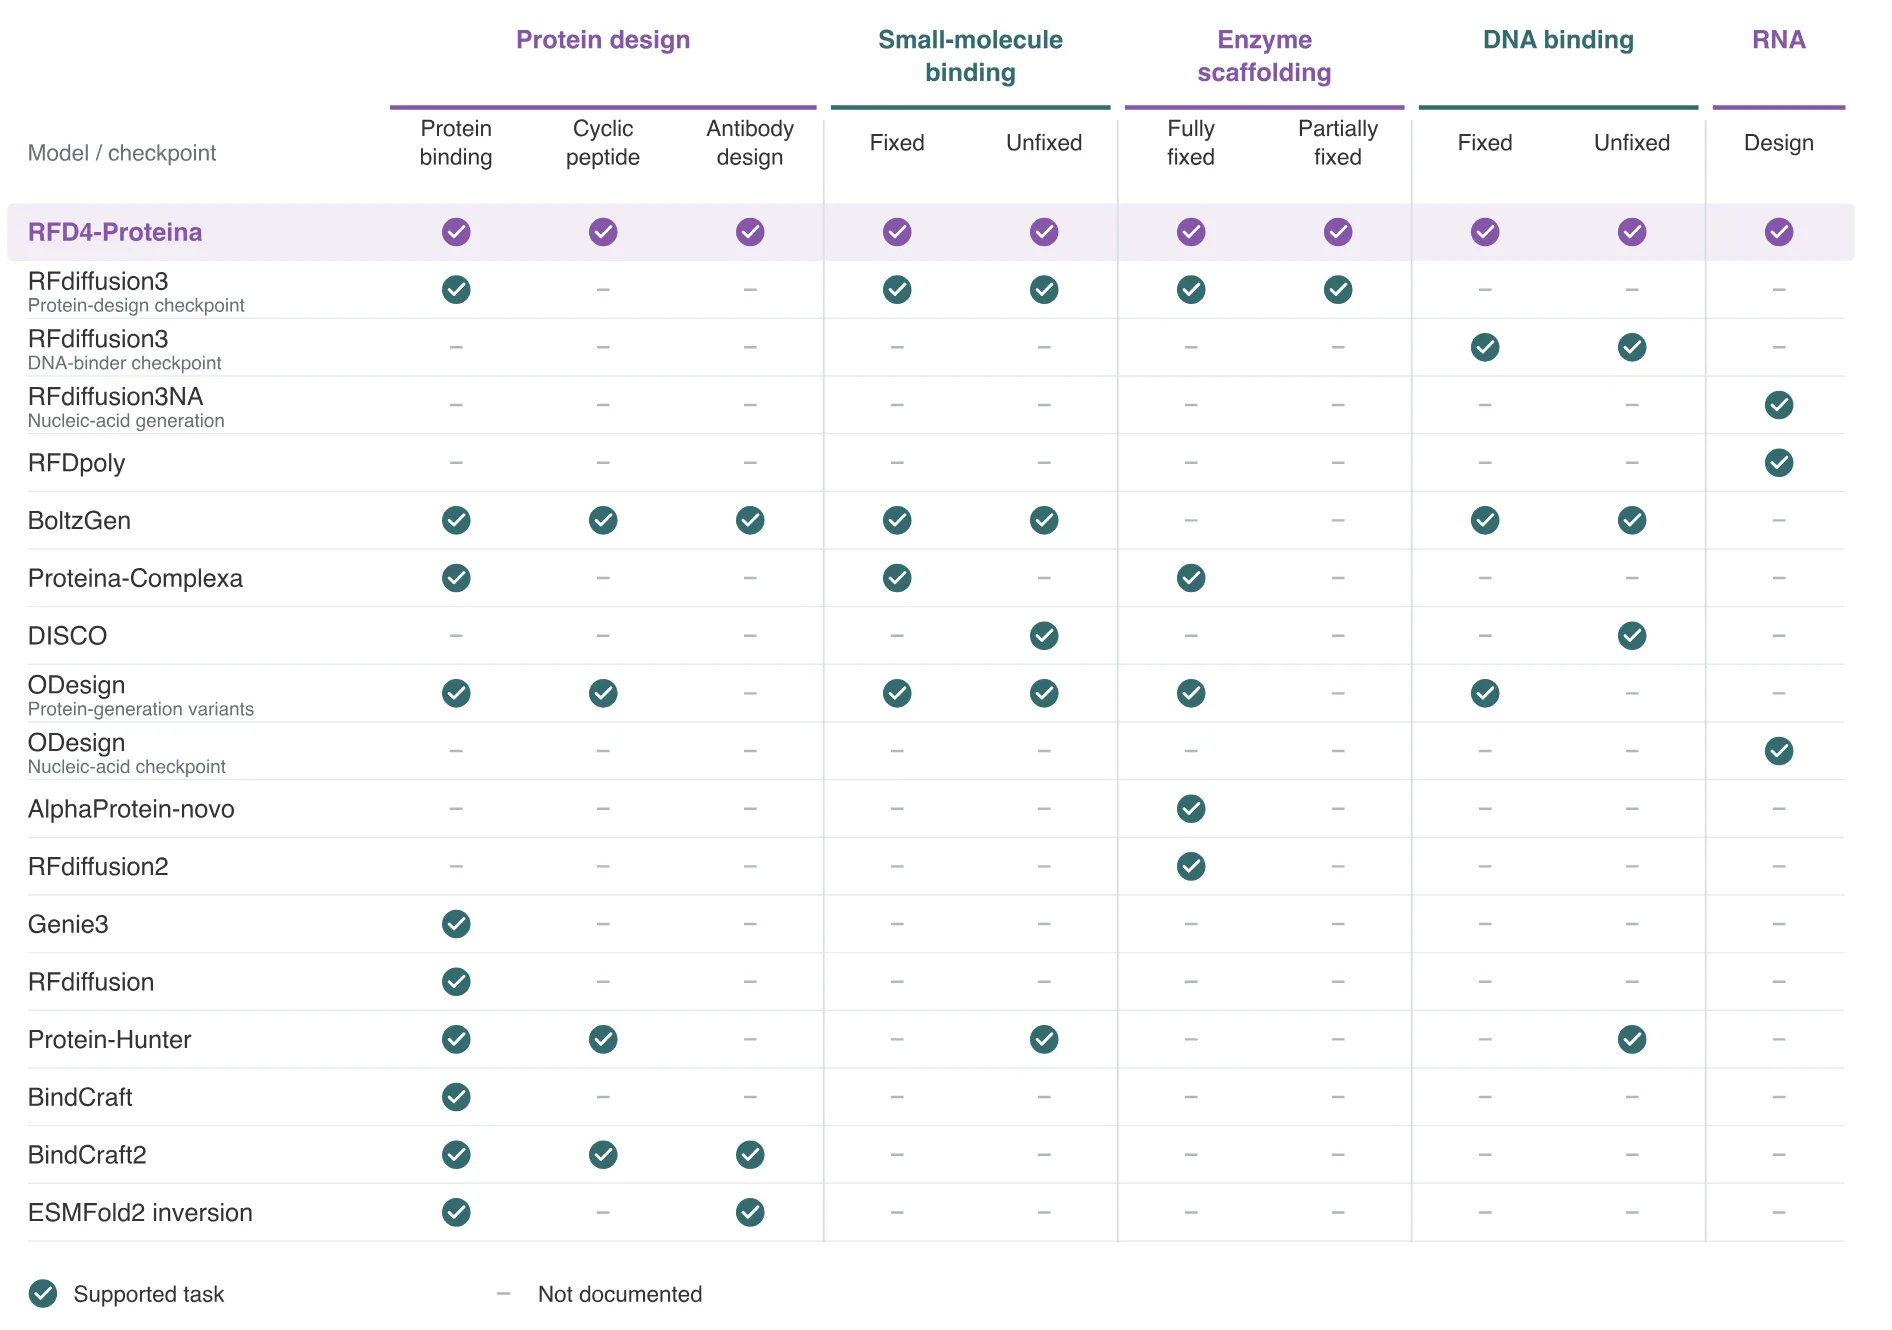
上表 1 突出了 RFD4-Proteina 在分子任务中的广泛能力。它不仅支持这些多样化的任务,在随附的手稿中还证明,该模型在这一广泛的分子任务范围内,无论在输出质量还是吞吐量方面,都是最先进的模型。
通过选择多样化的候选分子用于合成、表达和任务特异性检测,将这种吞吐量转化为科学进展。将实验结果反馈到下一轮的目标、约束和排序标准中。
使用 AI 智能体开展一轮设计活动
使用 rfd4-proteina-campaign 技能来协调生成、搜索和评估,并记录输入、模型版本和计算资源使用情况。rfd4-proteina-package 技能会生成一个结果归档,其中包含结构、指标和过滤报告。
Use rfd4-proteina-campaign to design 100–150-residue PD-L1 binders from pdl1.json, preserving its target and hotspot constraints. Use the Hugging Face model via from_pretrained and OpenFold3. Agree on criteria and a compute budget, then compare generation with reward-guided search and run a campaign via rfd4-proteina-campaign. Return up to ten diverse candidates with scores and compute usage; package the results with rfd4-proteina-package.
将工作流应用于你的设计问题
RFD4-Proteina 将快速生成、智能搜索和智能体可编程性整合到一个工作流中。联合序列与全原子结构生成简化了候选分子的创建,而奖励引导的搜索将计算资源集中在任务特异性目标上。共享的条件规范将两种形态连接到通用评估工具,NIM 的 HTTP API 则让智能体能够提交请求并检查结果。
使用开放模型进行方法开发,使用 NIM 进行应用集成,并可选配 BioIR 加速,将计算探索和实验反馈带入迭代式设计活动。
从 RFD4-Proteina NIM 微服务 开始,在 GitHub 上探索开放模型,或将你的智能体指向 BioNeMo Agent Toolkit 技能。