今天,我们宣布推出一类新的 System One 风格模型的预览版:提取模型。我们的第一个模型 Clairic 已在 Workers AI 上托管,地址为 @cf/cloudflare/clairic.。我们计划很快发布该模型的开源权重。Clairic 是一个提取模型,能够从非结构化输入中提取、计算、估计和预测值——所有这些都以比传统 LLM 显著更高的准确度、更低的延迟和更低的成本实现。
背景
一个月前,TypeSafe 发布 System One 模型时,在业界引起了轰动。正如 TypeSafe 在其博客中 所提及、并由 Daniel Kahneman 的著作 《思考,快与慢》 所定义的那样,System One 模型应当快速而精确,这与具备审慎推理能力(如 LLM)的 System Two 模型形成对比。借此,TypeSafe 推出了 Jev——一款针对特定用例量身定制、并因其细分领域而定价亲民的模型。它在 LLM 表现不佳的地方表现出色,帮助用户基于概率和类型良好的输出做出决策。Jev 的推出促使人们开始思考一类不同于 LLM 的新型模型,以及如何将它们集成到自己的工作流中。
我们受到 System One 模型概念的启发,开始思考 LLM 效率低下的其他任务。如今,有许多结构化输出调用以相同的形状一次又一次地发送给前沿 LLM:发票总额是多少?什么时候送达的?延迟了多少天?这次维修要花多少钱?未来 24 小时的交通状况会怎样? 这些问题的答案都无法提前列出,而决策模型需要这些答案来给出概率。这引导我们推出了今天介绍的模型类别:System One 提取模型。
推出 System One 提取模型
到目前为止,每个 System One 模型都是决策模型:Jev 和 Clef 接收一个输入状态和一组问题,并针对输入和你列出的问题给出概率。Clairic 是新类别中的第一个模型:System One 提取模型。它依然快速、类型化且成本低廉,但它直接以从输入中提取、由输入计算得出或基于输入预测出的值作为回答。
大多数模型任务要求三种输出之一:一个数字、从固定集合中的选择,或开放式文本。Clairic 处理第一种,返回带有 80% 范围的数字,并且还从输入中提取类型化的值,如名称、日期和列表。Clef 处理第二种:它在选项中进行选择,并为每个选项返回概率。LLM 处理第三种。我们称 Clairic 和 Clef 为 System One 模型,因为它们在一次传递中回答,无需推理或生成 token。它们仅对输入收费,通常在一秒内响应,而通过相同步骤进行推理的 LLM 需要几秒钟。
提取模型可以返回:
- 提取值: 从输入中复制的文本,例如名称、订单 ID 或描述。每个值都作为带有字符偏移量和置信度分数的片段返回。
- 包括,计算值: 数字、日期、时间、日期时间、持续时间和列表,从输入中读取或从中计算得出。它们遵循其类型的规则(例如,以分为单位保留两位小数),并附带置信度分数。
- 估计值: 输入未明确说明但提供证据的值。每个值都作为分布返回,位于你声明的边界内,在你指定的网格上,带有中位数和 80% 区间。
- 预测值: 序列的未来值,每一步向前一个估计,每个都有自己的 80% 区间。
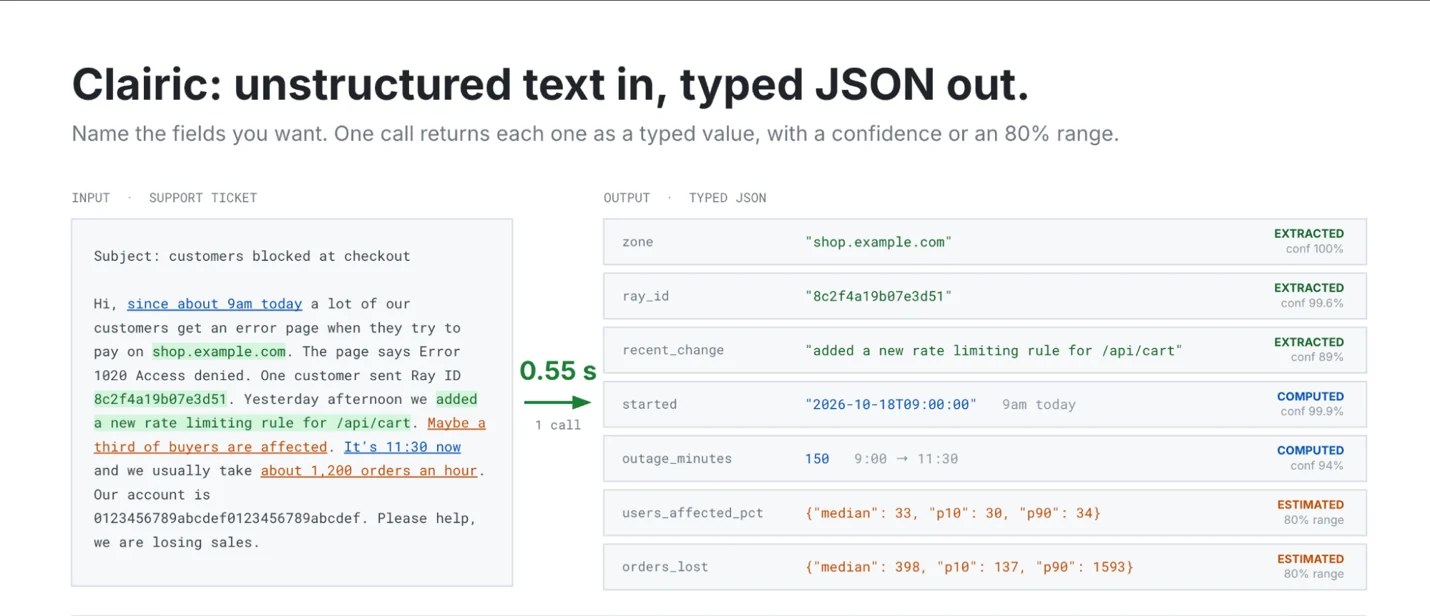
由于它不生成 token,因此不会产生类型错误的答案,也不会像 LLM 那样“产生幻觉”(当然,它也可能犯错)。输出是你所要求类型的值,或者当模型无法在输入中找到答案时为 null。它还附带针对输出的置信度分数,以帮助你评估是否适合信任模型或需要再次检查。
以下是提取模型在 System One 和 System Two 模型格局中的位置:
| System One:提取 | System One:决策 | System Two | |
| 示例模型 | Clairic | Jev, Clef | GPT, Claude, Gemini, DeepSeek |
| 采样 | 一次并行传递 | 一次并行传递 | 一次一个 token |
| 目的 | 预测值 | 做出决策 | 写作和推理 |
| 机器学习框架 | 回归和提取 | 分类 | 生成 |
| 思考模式 | System 1:快速,一次传递 | System 1:快速,一次传递 | System 2:缓慢,审慎 |
| 输出 | 类型化值:片段、数字、日期、时间、列表、分布,带有校准的概率 | 类型化决策:带有校准概率的选项 | 自由格式字符串 |
| 输出空间 | 连续,但类型化并受你的模式限制 | 你列出的有限选项集 | 任何内容 |
| 它回答什么 | 金额是多少?何时发生?会是多少? | 它属于哪个类别?它合法吗?我们应该采取哪个行动? | 为什么会发生?我们应该如何处理?你能修复它吗? |
| 输出总是有效响应吗? | 是的:每个答案都是其声明类型的值(或 null),在你的边界内 | 是的:答案总是你的选项之一 | 否:字符串必须被解析和检查 |
这些模型可以协同工作,帮助你更接近解析现实世界数据、基于输入做出决策,然后采取行动。提取模型将原始输入转化为类型化值,决策模型将值转化为决策,LLM 将决策转化为文字。
请求如何工作
Clairic 的设计与 LLM 不同。与决策模型类似,它仅通过一次前向传递处理输入 token,因此不收取输出 token 的费用。对于某些用例,它比 LLM 更快、更便宜、更准确。
一个请求由一个 state(要读取的文本,外加最多四张可选图片)和一张类型化 fields 的映射组成。你为每个字段命名、指定类型并可选地给出自然语言 instructions,然后每个字段都会返回一个类型化答案,全部来自一次并行处理。没有推理,也没有输出 token——所有计算都在一次前向传递中完成,这意味着它既快又便宜。
| 类型 | 返回 |
text | 输入中的特定片段,及其偏移量 |
number | 读取或计算出的数字,遵循 integer 和 decimals |
date, time, datetime | 日历日期和有效时间,采用 ISO 格式 |
duration | 以你选择的单位表示的一段时间长度 |
list | 匹配的文本、数字或日期,按输入顺序 |
estimate | 在你的 [min, max] 内、你的 step 网格上的分布,线性或对数刻度。 |
forecast | 序列每个未来步长的一个估计值 |
每个标量答案都附带 p_null(该值不在输入中的概率)和 confidence。每个 estimate 答案都附带中位数和 80% 区间(p10 到 p90),并可按需提供全部 99 个百分位数。字段数量没有限制:如果它们在一次传递中无法与输入并排放置,服务器会将它们拆分为多个并行传递,每个传递都能看到完整输入,然后合并答案。
以下是一些示例,用于说明该模型的功能。当然,在工作流中使用这些功能需要适当的输入。
示例:提取值
提取可能是当今交给 LLM 最常见的工作:"将发票号、供应商和到期日以 JSON 返回。" 大多数时候它都能工作,但失败模式很难被发现。输出可能不是有效的 JSON,数字在生成时可能被误读,而且一旦返回文本摘录,就无法追溯它在源文中出现的位置。大多数人会构建提取流水线来应对这一问题,包含多层解析、模式验证、重试和抽查。除此之外,你还要为每份文档的每个字段支付推理和输出 token 的费用。
Clairic 的运行方式不同;它不生成文本答案。相反,你会得到:
- 从输入中提取的值,因此答案是有依据的。
- 计算值,因此它可以解析非结构化数据而无需预先清洗。
- 字符偏移片段,因此你可以引用数据在输入中的位置。
- 置信度标签,因此你可以确定哪些值需要二次检查。
- 强类型输出,因此数字和日期按其类型的规则形成(例如,美分字段有两位小数)。
- 空值处理,缺失字段会以
null作为答案返回(同时附带估计的空值概率和一个猜测值)。 - 更便宜、更快的答案,因为每个字段都在同一次并行传递中作答。因此请求三十个字段的成本与请求三个字段大致相同。
让我们通过一个示例来说明 Clairic 从非结构化数据中提取值并做出估计的方式。以一封客户支持邮件为例:
你好,订单 A-88412 于 2026 年 9 月 28 日送达,屏幕有裂纹,边角有凹陷。我支付了 $649.00 外加 $52.10 税费。现在是 2026 年 10 月 9 日,我希望修复或退款。谢谢,Dana
你会从 Worker 向 Clairic 发出请求来处理这些数据:
const { answers } = await env.AI.run("@cf/cloudflare/clairic", {
  state: email,
  fields: {
    order_id:            { type: "text", instructions: "Order number" },
    delivered_on:        { type: "date", instructions: "Delivery date" },
    amount_paid:         { type: "number", decimals: 2, unit: "USD", instructions: "Total paid including tax" },
    days_since_delivery: { type: "duration", unit: "days", integer: true,
                           instructions: "Days from delivery to the date the customer wrote" },
    damage:              { type: "list", items: "text", instructions: "Each kind of damage described" },
    tracking_number:     { type: "text" },
  },
});
Clairic 返回提取的值、输入中的片段、空值概率(p_null)和置信度分数:
{
  "order_id": {
    "type": "text",
    "p_null": 3.4e-6,
    "span": [10, 17],
    "guess": "A-88412",
    "confidence": 0.999957,
    "value": "A-88412"
  },
  "delivered_on": {
    "type": "date",
    "p_null": 6.5e-8,
    "guess": "2026-09-28",
    "confidence": 0.999999,
    "value": "2026-09-28"
  },
  "amount_paid": {
    "type": "number",
    "p_null": 1.6e-5,
    "guess": 701.1,
    "confidence": 0.999944,
    "value": 701.1
  },
  "days_since_delivery": {
    "type": "duration",
    "p_null": 6.1e-9,
    "unit": "days",
    "guess": 11,
    "confidence": 0.999999,
    "value": 11
  },
  "damage": {
    "type": "list",
    "value": ["cracked screen", "dented corner"],
    "spans": [[50, 64], [71, 84]]
  },
  "tracking_number": {
    "type": "text",
    "p_null": 1,
    "span": [106, 112],
    "guess": "$52.10",
    "confidence": 0.416016,
    "value": null
  }
}
有几点需要注意:
amount_paid并未写在邮件中的任何地方。在此示例中,Clairic 在同一次传递中将价格和税费相加并返回总和。days_since_delivery也是根据文本中的两个日期计算出来的,而非直接来自输入。damage将两种损坏都列为精确片段,因此你可以在源文中高亮它们。tracking_number不在邮件中,因此返回null而不是看似合理的猜测。guess显示了模型原本会选取的值。
Clairic 也可处理图像
这是一张真实的收据照片——文字并不完美,图像的角度也不利于辨认。我们将这张图像传给 Clairic,看看它能提取出什么:
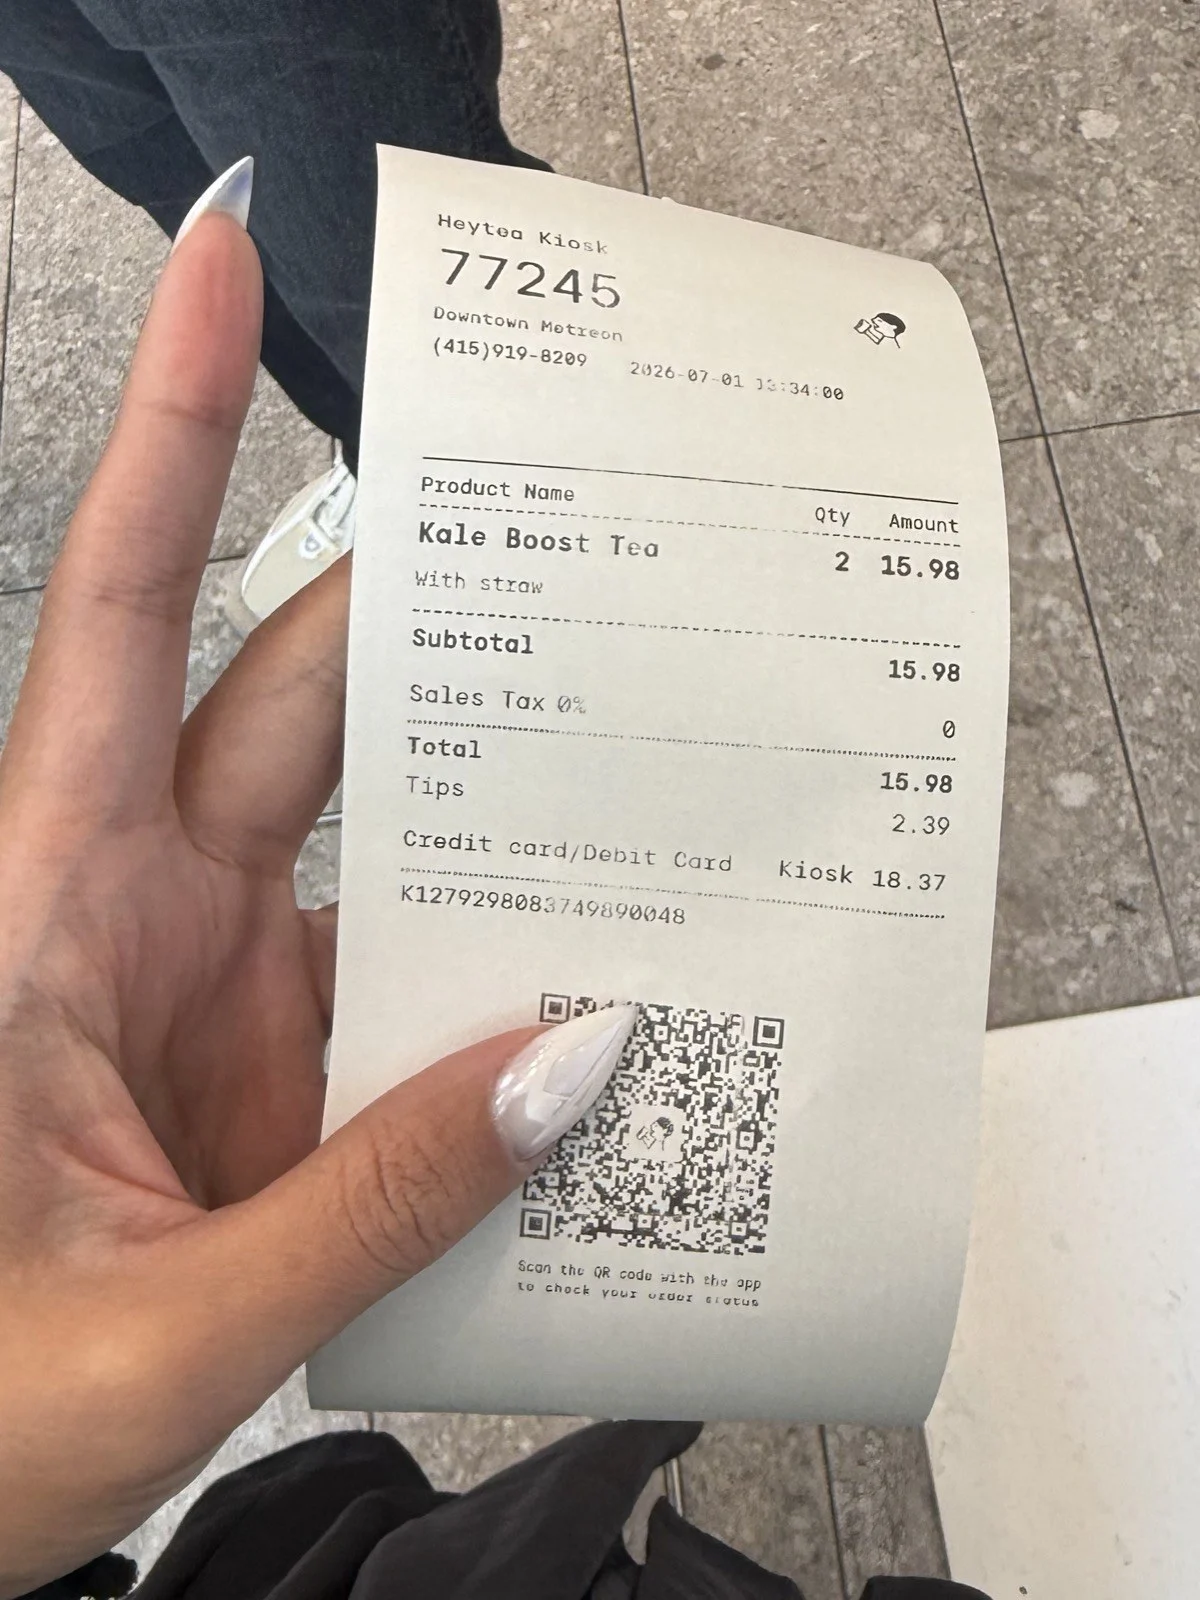
{
  "model": "clairic",
  "answers": {
   "order_number": {
    "type": "number",
    "p_null": 0.0040206750854849815,
    "guess": 77245,
    "confidence": 0.776249383996532,
    "value": 77245
   },
   "purchased_at": {
    "type": "datetime",
    "p_null": 4.136094133855295e-08,
    "guess": "2026-07-01T13:34:00",
    "confidence": 0.831464227002992,
    "value": "2026-07-01T13:34:00"
   },
   "quantity": {
    "type": "number",
    "p_null": 5.2313655629632194e-08,
    "guess": 2,
    "confidence": 0.9997007500403496,
    "value": 2
   },
   "unit_price": {
    "type": "number",
    "p_null": 0.001599092734977603,
    "guess": 7.99,
    "confidence": 0.9991279019989127,
    "value": 7.99
   },
   "subtotal": {
    "type": "number",
    "p_null": 9.69956488461321e-08,
    "guess": 15.98,
    "confidence": 0.9999881983893096,
    "value": 15.98
   },
   "sales_tax": {
    "type": "number",
    "p_null": 2.5511653802823275e-06,
    "guess": 0,
    "confidence": 0.9999800924450729,
    "value": 0
   },
   "tip": {
    "type": "number",
    "p_null": 5.953857908025384e-05,
    "guess": 2.39,
    "confidence": 0.9335768781214697,
    "value": 2.39
   },
   "discount": {
    "type": "number",
    "p_null": 0.9994148015975952,
    "guess": 0,
    "confidence": 0.91852733929319,
    "value": null
   }
  }
}
如你所见,它能够从图像中提取所有值,并附带置信度分数。它还正确指出收据中没有显示折扣,并将该值设为 null。
示例:估计值
有些值根本不在输入中,但输入携带了关于它们的证据。例如,值可能不在纯文本中,但可以从其周围的值推断出来。如果你让 LLM 进行估计,通常只会得到一个数字,而无法感知模型的确定程度。它会做出安全的猜测或产生幻觉,或者通过推理绕开答案。如果你得到一个估计值,任何下游处理都无法区分一个有把握的 $180 和一个没把握的 $180,因此它无法帮助你在特定情况下决定适合自动化什么。通过 LLM 进行推理也要慢得多、昂贵得多。
决策模型可以通过在桶("低于 $100"、"$100–500"、……)之间选择来近似估计,但桶是粗粒度的,每个桶都会增加输入 token,而且每个新类别都会在模型决策过程中增加更多混淆来源。
Clairic 在你声明的范围内返回一个分布:一个点值、一个中位数、一个 80% 区间,以及按需提供的每个百分位数。估计值被设计为落在你的边界内,因此之后无需钳制或舍入。区间的宽度反映数据置信度:窄范围表示高确定性,而宽范围表示低确定性,你可以利用这一信息来路由另一次检查。
这是另一个示例,Clairic 查看历史房价和可比销售额来确定估计值:
const { answers } = await env.AI.run("@cf/cloudflare/clairic", {
  state: `Comparable sales:
sqft,beds,year_built,neighborhood,sale_price
1450,3,1998,Elm Park,412000
2100,4,2006,Elm Park,585000
980,2,1975,Riverside,265000
1600,3,2003,Elm Park,449000
1300,3,1990,Riverside,318000

Subject property:
sqft,beds,year_built,neighborhood
1620,3,2001,Elm Park`,
  fields: {
    sale_price:     { type: "estimate", unit: "USD", min: 50000, max: 5000000, scale: "log", step: 1000 }
});
Clairic 将返回一个估计值:
{
  "sale_price":     { "type": "estimate", "value": 418000, "median": 415000, "p10": 370000, "p90": 470000, "p_below": 0.0, "p_above": 0.0 }
}
值始终落在你的边界内,区间的宽度显示输入对预测的贡献程度:价格较窄($370,000-$470,000),上市天数较宽(24-148)。由于字段数量不限且并行作答,你可以在一次调用中为许多项目评分(每个候选、线索或房源一个估计值),并在代码中对它们排序。
示例:预测数值
在时间序列中预测数值对通用模型来说相当困难——这通常意味着你要么必须为每个指标构建特定的流水线(解析数据、拟合模型、调优、部署),要么把 36 个月的数字粘贴到 LLM 中并要求预测未来三个月。第一种方法准确,但为每个新序列进行设置既昂贵又耗时。第二种方法简单,但你得到的是没有区间的点预测,预测会因提示词的措辞而漂移,而且答案的置信度有限。
Clairic 介于两者之间——它并不声称要取代专用的时间序列模型,但比常规 LLM 稍快且更便宜。forecast 字段在 state 中以纯文本形式接收历史数据,并针对每个预测步长返回一个值和一个 80% 区间,且落在你声明的边界内。它按照你已有的方式读取历史数据,无论是 CSV 导出、粘贴的仪表板,还是与备注混在一起的行,而且通常无需事先清理数据即可工作。
为了检验它在真实数据上的表现,我们使用了一个公开序列:美国运输安全管理局(TSA)每天在美国机场检查站筛查的人数。连续 21 天,我们每天早上根据迄今为止的真实计数,向 Clairic 询问第二天的计数:
const { answers } = await env.AI.run("@cf/cloudflare/clairic", {
  state: `Daily number of people screened at TSA checkpoints at US airports.
date,weekday,travelers
2026-07-16,Thu,2850229
...
2026-10-13,Tue,2353356
Forecast date: 2026-10-14 (Wed)`,
  fields: {
    travelers: { type: "forecast", horizon: 1, interval: "day",
                 min: 500000, max: 4000000, scale: "log",
                 instructions: "Number of people screened tomorrow" },
  },
});
返回结果为:
{
  "travelers": { "type": "forecast", "value": [2416117], "median": [2419283], "p10": [2270774], "p90": [2556769] }
}
实际上,TSA 当天筛查了 2,419,474 人,这正好接近 Clairic 预测的中位数 2,419,283。
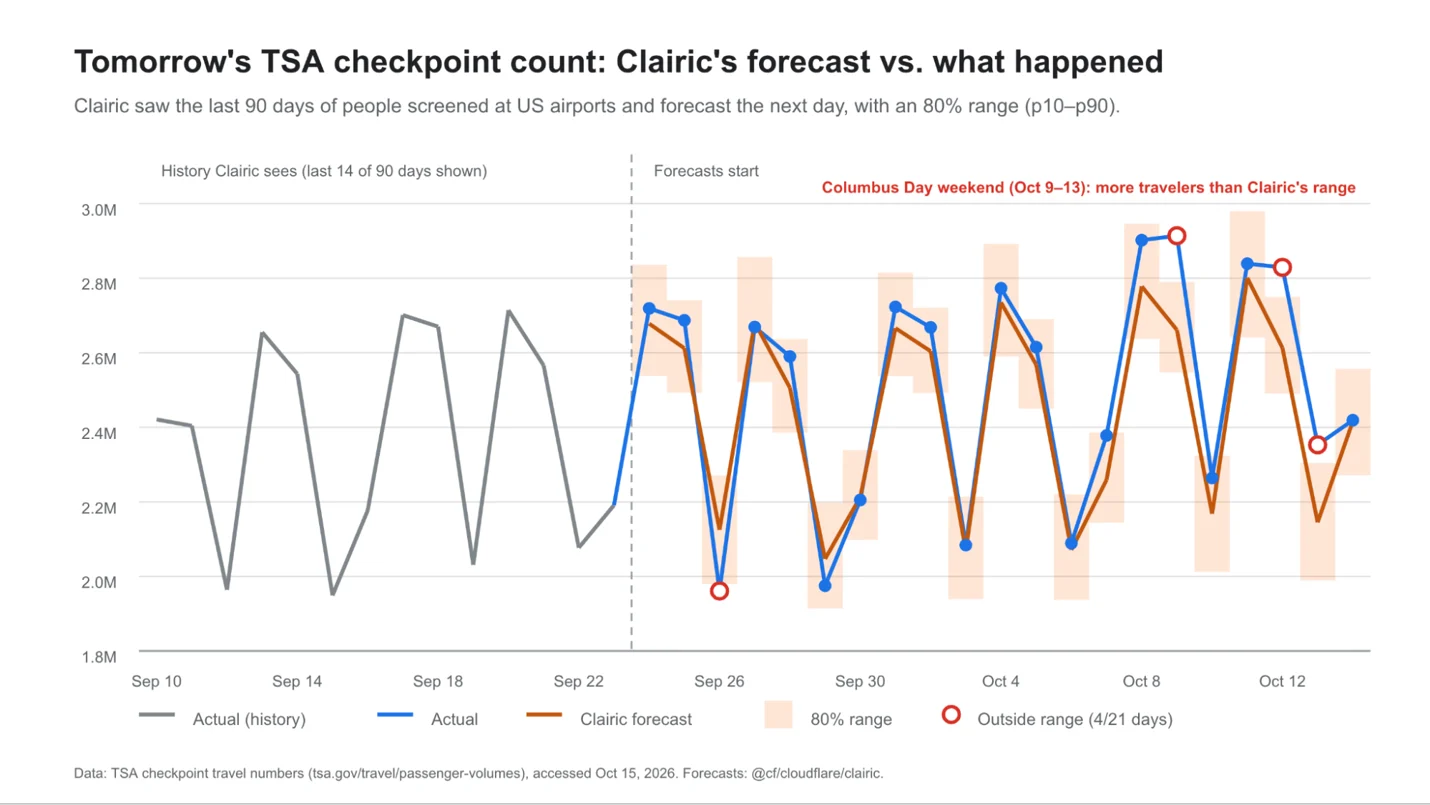
数据:TSA 检查站旅行人数,访问于 2026 年 10 月 15 日。
在这 21 天里,Clairic 的预测平均偏差为 3.3%,21 个实际计数中有 17 个落在其 80% 区间内,这符合 80% 区间应有的表现。它仅从数字中就捕捉到了每周的节奏:周二和周六较安静,周四、周五和周日较繁忙。
未命中的情况也很有趣:区间外的四天中有三天落在哥伦布日周末,当时乘飞机的人比前几周所暗示的要多。Clairic 根据序列中的模式进行预测,但不考虑序列未显示的事件,例如节假日。
快思考与慢思考
这些模型旨在与你现有的智能体工作流配合使用。提取模型预测数值,决策模型决定如何处理这些数值,而 LLM 则据此采取行动。这是 System One 与 System Two 模型之间的完美结合。它弥合了现有的差距:你要么必须为 LLM 手动提取数据,要么让 LLM 解析杂乱的数据(这既昂贵又耗时,还可能导致幻觉)。借助 System One 提取模型,你可以更快速、更高效、更精确地处理真实世界的数据。
下面是之前那个损坏产品索赔的示例,展示了所有模型如何协同工作。我们将其构建成了一个你可以在此处尝试的实时演示。
// 1. Clairic turns the email into values
const facts = (await env.AI.run("@cf/cloudflare/clairic", {
  state: email,
  fields: {
    customer_name:       { type: "text", instructions: "Customer's first name" },
    order_id:            { type: "text", instructions: "Order number" },
    amount_paid:         { type: "number", decimals: 2, unit: "USD", instructions: "Total paid including tax" },
    days_since_delivery: { type: "duration", unit: "days", integer: true,
                           instructions: "Days from delivery to the date the customer wrote" },
    damage:              { type: "list", items: "text", instructions: "Each kind of damage described" },
    repair_cost:         { type: "estimate", unit: "USD", min: 10, max: 5000, scale: "log", step: 1,
                           instructions: "Cost to repair the damage described" },
  },
})).answers;
const { customer_name, order_id, amount_paid, days_since_delivery, damage, repair_cost } = facts;

// 2. Clef decides from Clairic's values and the policy, not from the raw email
const options = {
  refund:  "Full refund of the amount paid",
  repair:  "Free repair, with a prepaid shipping label",
};
const { choice } = (await env.AI.run("@cf/cloudflare/clef", {
  state: `Damage claim for order ${order_id.value}.
Paid: $${amount_paid.value.toFixed(2)}. Delivered ${days_since_delivery.value} days ago.
Damage reported: ${damage.value.join(", ")}.
Estimated repair cost: $${repair_cost.median} (80% range $${repair_cost.p10}-$${repair_cost.p90}).
Policy: refunds within 30 days of delivery. Prefer repair when it costs less than 60% of the price and the damage doesn't stop the product from working.`,
  questions: {
    resolution: { type: "choice", instructions: "What should we offer?", criteria: options },
  },
})).answers.resolution;

// 3. An LLM writes the reply, from the decision and the facts it needs
const { response } = await env.AI.run("@cf/zai-org/glm-5.3", {
  messages: [{
    role: "user",
    content: `Write a short, warm reply to ${customer_name.value}. Use only these facts: order ${order_id.value}; ` +
             `damage: ${damage.value.join(", ")}; what happens next: ${options[choice]}. Under 60 words.`,
  }],
});
每一步获得的输入都比前一步更干净。Clef 根据五行类型化数值摘要做出决定,而不是根据自由格式的电子邮件(后者也可能容易受到提示注入的影响)。LLM 从不看到电子邮件,只看到它需要的决策和预测,因此它可以误用的数字更少。每一步都是类型化且可审计的,并且只有一步生成文本。在该流水线的全 LLM 版本中,所有三个步骤都是生成式调用,回复中的每个值都必须手动检查。
我们针对一个全 LLM 版本运行了该流水线,两者都由 GLM-5.3 撰写回复。在全 LLM 版本中,GLM-5.3 还根据相同的电子邮件、政策和提示词执行提取和决策:
| Clairic → Clef → GLM-5.3 | 每一步都使用 GLM-5.3 | |
| 端到端延迟 | 19.3 秒 | 61.7 秒 |
| 1. 提取 | Clairic:0.46 秒 | GLM-5.3:16.1 秒 |
| 2. 决策 | Clef:0.22 秒 | GLM-5.3:21.9 秒 |
| 3. 回复 | GLM-5.3:18.6 秒 | GLM-5.3:16.4 秒 |
| 输入 token | 701(每百万次索赔 $184) | 390(每百万次索赔 $546) |
| 输出 token | 1,329(每百万次索赔 $5,848) | 2,544(每百万次索赔 $11,194) |
| 每百万次索赔成本 | $6,032 | $11,740 |
级联流水线在 19.3 秒内完成,而全 LLM 版本为 61.7 秒:时间减少 69%,约快 3.2 倍。Clairic 和 Clef 合计在不到一秒内完成了提取和决策,而 GLM-5.3 完成同样两个步骤需要 38 秒。使用级联流水线相比全 LLM 流水线还降低了 49% 的成本。使用 GLM 时,两个流水线在每次运行中都正确获取了事实并做出了正确决策,但 Clairic 的维修估价每次完全相同,而 GLM-5.3 的估价每次运行都会变化($250、$250 和 $220,每次范围不同)。
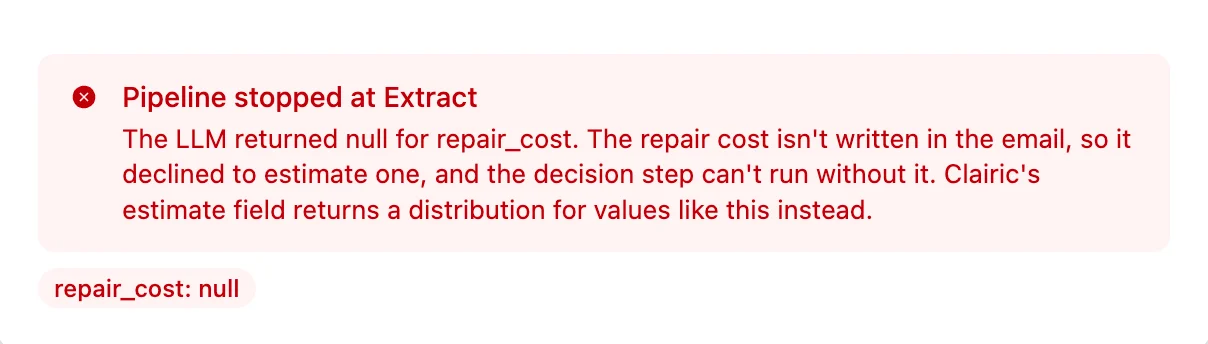
值得注意的是,在全 LLM 流水线下,Gemma 4 和 Qwen 在此任务上都失败了,因为它们无法从输入中推断出 repair_cost 等数值,这表明 LLM 并不擅长数据提取任务。
预览版发布
今天,我们在 Workers AI 上发布了 Clairic 的托管端点。我们打算很快以开放权重发布该模型。我们想先花时间介绍 System One 提取模型的概念,以便你可以开始思考这类模型如何融入合适的工作流。
当前端点是一个早期检查点,我们预计它会变得更好。以下是我们早期的印象:
- 阅读能力强,但多步算术还不行。一步和两步计算(总计、差值、转换、日期算术)似乎可靠。对于任何没有草稿纸的单次模型来说,较长的依赖步骤链都很困难。跨表格多行进行聚合也是如此。至少目前,让 Clairic 预测数值,让代码来做数学运算。
- 估计需要证据。Clairic 最适合从输入中的可比数据、历史记录或描述性文本中进行估计。要求它给出没有证据支持的数值,其具体性可能有限。
- 校准是经过测量的,而非保证的。区间经过训练以保持校准,并且在大多数留出集上都是如此,但在不熟悉的数据上它们可能会偏窄。
- 预测是基础功能。该模型并非设计用来准确替代或预测在特定数据上训练的时间序列模型。你应在适当场景使用它,例如非关键性的通用模式匹配,而非详细的长周期预测。
- 使用置信度。该架构使每个答案格式良好,但不一定正确。使用
confidence、p_null和区间来决定哪些可以自动化(在适当的工作流上下文中),哪些需要送去额外审查。
我们会在每个检查点继续改进模型的算术、估计和预测方面。再做一些工作之后,我们计划以开放权重形式发布该模型,供所有人试用。
试一试
Clairic 已在 Workers AI 上以 @cf/cloudflare/clairic 形式提供预览。你可以从 Worker 中使用 env.AI.run() 调用它,或通过 REST API 从任何地方调用。完整的模型文档见此处,另有一篇新的文档说明介绍提取模型 API 的形态。
附注:既然你们喜欢名字 Clef 的词源,这里说说我们是如何定下 Clairic 这个名字的。我们最初希望模型名称在主题和发音上都与 Clef 相近。Clair 浮现在脑海中,它共享同样的“cl”发音,也有音乐渊源(“Clair de Lune”)。更重要的是,我们希望名字能描述模型的本质。Clairic 模型应能帮助你完成文书类任务,比如从输入语料中清晰地提取数据,并在记账等任务中保持准确性。模型的预测特性则呼应了“Clair”词根——让你能够估计和预测未来数值,类似于千里眼(clairvoyance)。最后,我们喜欢让它成为 [Cl]oudflare 的 [AI R]egression 模型这一想法。于是,Clairic 就此诞生。希望你们喜欢。