2026年7月30日,Transformers 为 T5 启用了 PyTorch 的缩放点积注意力(SDPA)。副作用是,UMT5 的解码器可以关注到未来的 token。在训练期间,它可以偷看它本应预测的答案。没有任何崩溃,这个 bug 在 main 分支上停留了将近两个月。
当我们后来重放那些提交时,一个在 CPU 上运行的小型 UMT5 模型在每一个提交上都标记了它。这篇文章就是关于那个模型以及围绕它构建的测试。
为什么 bug 会进入 main 分支
Transformers 支持超过 750 种模型类型,其测试套件非常庞大:main 分支上有 88,000+ 个 CPU 测试,加上每日运行中的 200,000+ 个 GPU 测试。 模型测试只是其中一部分:我们还测试流水线、训练、分布式执行、量化和注意力内核。
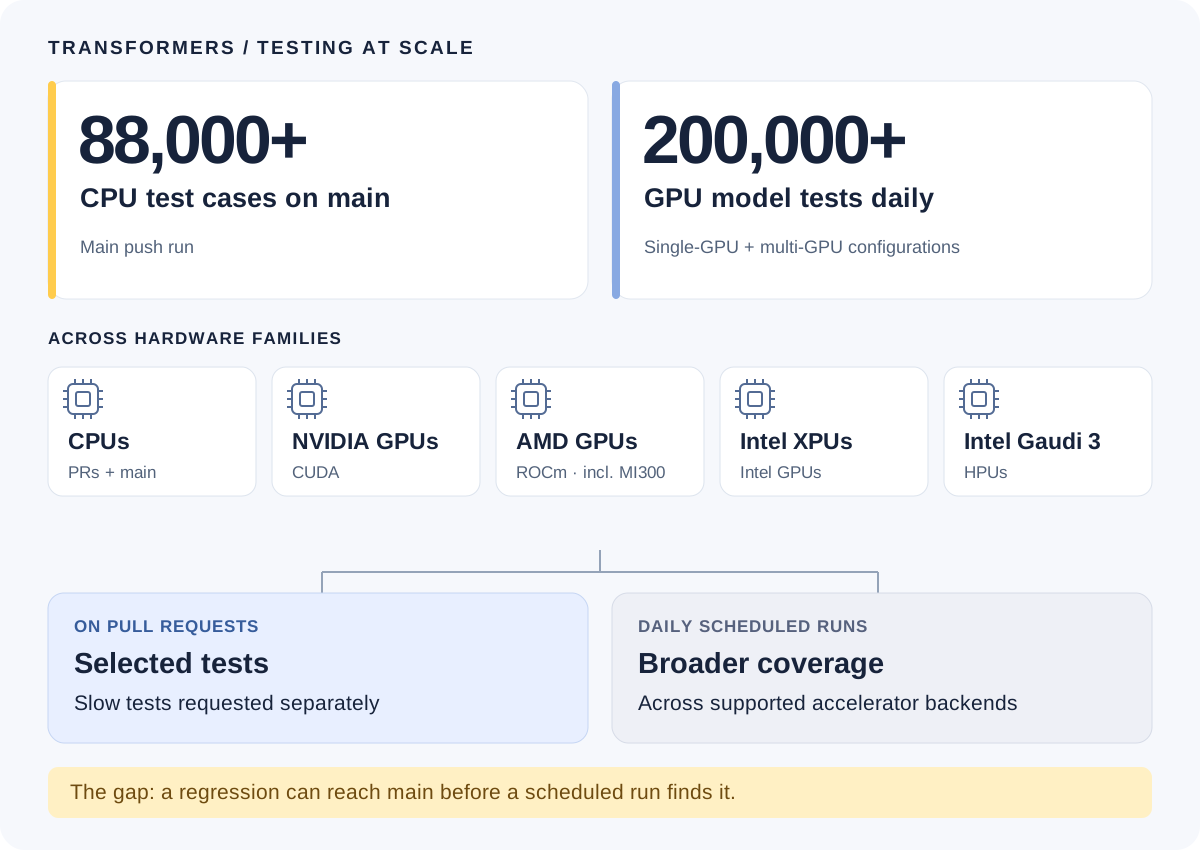
集成测试加载真实检查点并在真实硬件上运行模型的 API。在每个 PR 上运行所有这些意味着让大量 GPU 全天忙碌,这不切实际。等到定时运行发现回归时,它可能已经进入 main 分支了。
我们的方法是缩小模型。我们构建一个夹具:一个由真实检查点的配置制成的小模型,层数更少且更窄,但包含它拥有的每一种层,并且其分词器和处理器文件保持不变。它发布一次,然后重复使用。我们在廉价的 CPU 运行器上针对它运行“快速集成测试”。在我们的 CPU 研究中,实验性 UMT5 夹具使用了 66 MB 的权重;源检查点是 1,227 MB。
这也覆盖了非常大的模型:有些模型无法在我们的标准 GPU 运行器上运行,但它们的夹具可以在 CPU 上运行。
模型集成者已经构建了小型测试模型(Transformers 的 tiny-random-* 检查点)。我们想要一个通用的配方,以及超越加载模型和运行前向传递的检查。UMT5 的 bug 本来可以轻松通过前向传递。
夹具不会取代完整的集成测试,但在 PR 上它们给了我们在 bug 进入 main 分支之前抓住它们的机会。
引入模型集成契约
transformers-mic 是一个用于打包这些测试的提议标准。模型集成契约(MIC)包含三个部分:
- 一个夹具:上面描述的缩小模型,发布一次并固定
- 一个使用路径:一个可运行的 Markdown 示例,展示人们用模型做的事情,例如生成文本或运行训练步骤
- 基线:运行该示例时记录的输出,由人工审核
如果在夹具上运行使用路径仍然产生基线,则契约成立。
契约覆盖一个架构和一个使用路径,而不是单个检查点:兼容的检查点可以共享一个夹具,同时每个检查点保留自己的预期结果。我们在 huggingface-mic 中发布它们。
例如,SmolLM 契约从诸如“The capital of France is”的提示生成,并将其 token ID 与记录的答案进行比较。加载模型和分词器后,生成代码简化为一个提示:
inputs = tokenizer("The capital of France is", return_tensors="pt")
outputs = model.generate(**inputs, max_new_tokens=4, do_sample=False)
new_tokens = outputs[:, inputs["input_ids"].shape[1]:]
print(tokenizer.batch_decode(new_tokens, skip_special_tokens=True))
它还比较训练损失,检查梯度是否有限,并验证优化器步骤会改变权重。参见完整的 usage.md。
Hub 上的一个舰队数据集将每个 MIC 固定到一个冻结的修订版本,以及用于记录其基线的包版本。每次 CI 运行都会记录它使用的舰队修订版本,以便我们以后可以重现它。
在 PR 上,我们根据补丁更改的文件选择 MIC。
UMT5 回归
我们在五个月的 Transformers 提交上重放了冻结的 MIC。小型 UMT5 夹具从 2026年7月30日 引入回归到 9月28日 修复期间一直标记它。标签对数概率与审核基线相差 1.22,训练损失相差约 0.20。
一个细节很重要:契约使用了 SDPA,即默认的注意力路径。仅运行 eager 注意力变体错过了这个 bug。夹具只有在经过与真实检查点相同的代码时才有帮助。
然后我们在 Transformers 的 CI 中的一个证明分支上还原了修复。检查以相同的差异失败,并且选定的 T5 契约的运行器步骤在 CPU 上耗时 13.4 秒,不包括设置。
模型如何缩小
第一个配方很简单:使维度更小并保留更少的层。这对于混合架构来说不够。如果两层都使用滑动注意力而全注意力层消失,保留两层是没有用的。
配方现在有四个步骤:
- 缩小配置。 从真实检查点开始,减少隐藏大小、注意力头和深度。保留不同的层类型,包括滑动注意力和全注意力的混合,或密集层和 MoE 层的混合。一些架构需要额外的规则来保持其组件兼容。我们还查看模型自己的 Transformers 测试:
test_modeling_<model>.py中的ModelTester已经手动选择了一个小配置,因此对于我们的通用规则不知道名称的任何宽度,我们采用其大小。 - 保持预处理不变。 保留词汇表、特殊 token 和输入维度,并逐字节复制分词器和处理器文件。加载和预处理是我们想要测试的一部分。
- 构建并验证权重。 尝试带种子的随机权重并更改输入以检查模型是否响应。如果它不响应,尝试在契约的小批量示例上训练它。重新加载保存的模型并检查输出、损失和梯度是否有限。拒绝失败的构建。
- 冻结并记录。 保存接受的权重并在已知良好的 Transformers 构建上测量可重复的输出。审核每个支持的平台和精度的基线,然后发布一个固定的快照。CI 重用它;它不会为每个 PR 重建夹具。
我们还保留原始的权重文件格式。否则,我们就会跳过用户加载真实检查点时所运行的转换代码。完整配方有更多细节。
Llama 4 Scout 缩小报告展示了这在大型模型上的效果。1086 亿参数变成 4470 万。视觉栈从 34 层减少到 2 层,语言栈从 48 层减少到 4 层,同时保留所检查的层类型和 MoE 路由风格。
用智能体构建 MIC
我们的 CLI tmic 创建契约并构建夹具。对于新模型,由 LLM 起草用法代码和清单,CPU 和 GPU 运行测量候选基线。LLM 只起草,不批准。更改预期需要人工审核。
要在你的机器上试用,请用你的源检查点替换 org/model:
pip install "transformers-mic[runtime]" "hf-doc-builder @ git+https://github.com/huggingface/doc-builder.git"
hf auth login
tmic run org/model --local-only --fixtures-only --no-history --bill-to ''
它在你的机器上起草契约、构建夹具并记录其基线,要求你审核每一步,并在上传任何内容之前停止。对于新模型,草稿来自通过 Inference Providers 的 LLM,费用计入你自己的账户(--bill-to '')。CLI 文档涵盖了各个步骤。
我们使用智能体跨模型系列构建 MIC。当它们遇到边缘情况时,我们在模型专家的帮助下修复配方本身,而不是修复单个夹具。已发布的模型和剩余缺口在覆盖空间中。
随机权重 vs 过拟合
使用随机权重时,我们的 Whisper 夹具对音频变化几乎没有响应。它能运行,但这使它成为音频路径的糟糕测试。
因此,我们在几个音调上训练它,并配上“red”和“green”等词。我们不是在教它语音识别,只是让音频变化在其输出中可见。在我们的权重初始化研究中,随机 Whisper 夹具捕获了 24 个注入故障中的 18 个。过拟合夹具捕获了全部 24 个。
这给了我们两种构建权重的方式:
- 从随机权重和固定种子开始。
- 在几个示例上过拟合,例如“The capital of France is”=>“Paris”。
Whisper 的结果并不能确定哪种更好。那些是合成故障,我们还没有发现只有过拟合版本才能捕获的真实回归。两个版本都漏掉了一个由真实 Whisper 检查点暴露的辅助解码 bug。
因此,当随机权重通过检查时,我们保留它们;当需要更好的灵敏度或可读答案时,我们使用过拟合。训练只需几秒钟,但它是又一个可能无法收敛的步骤,也是又一件需要维护的事情。比较包含两者的结果。
开放问题
截至 2026 年 11 月 1 日,Transformers CI 中的 MIC 任务报告失败但不阻止 PR。它是否应该阻止取决于我们尚未测量的事情:
- 它在 PR 上(而不仅仅是重放中)能捕获多少真实 bug?
- 它多久会让我们去追查误报?
- 基线审核需要多少工作?
我们也不知道有多少 bug(比如 Whisper 辅助解码那个)只在真实权重下才会出现,或者过拟合是否能捕获随机权重漏掉的真实 bug。
覆盖范围仍然不完整,无论是跨模型系列还是人们使用的 API。当回归漏过时,我们可以添加缺失的用法路径,并在损坏和修复版本上重放它。我们将保留现有测试,直到其覆盖范围被纳入考虑。
最后,我们希望将原始 Hub 模型页面链接到它们的 MIC,这样使用检查点的开发者或智能体就可以从在该检查点、其环境和预期输出上测试过的示例开始。