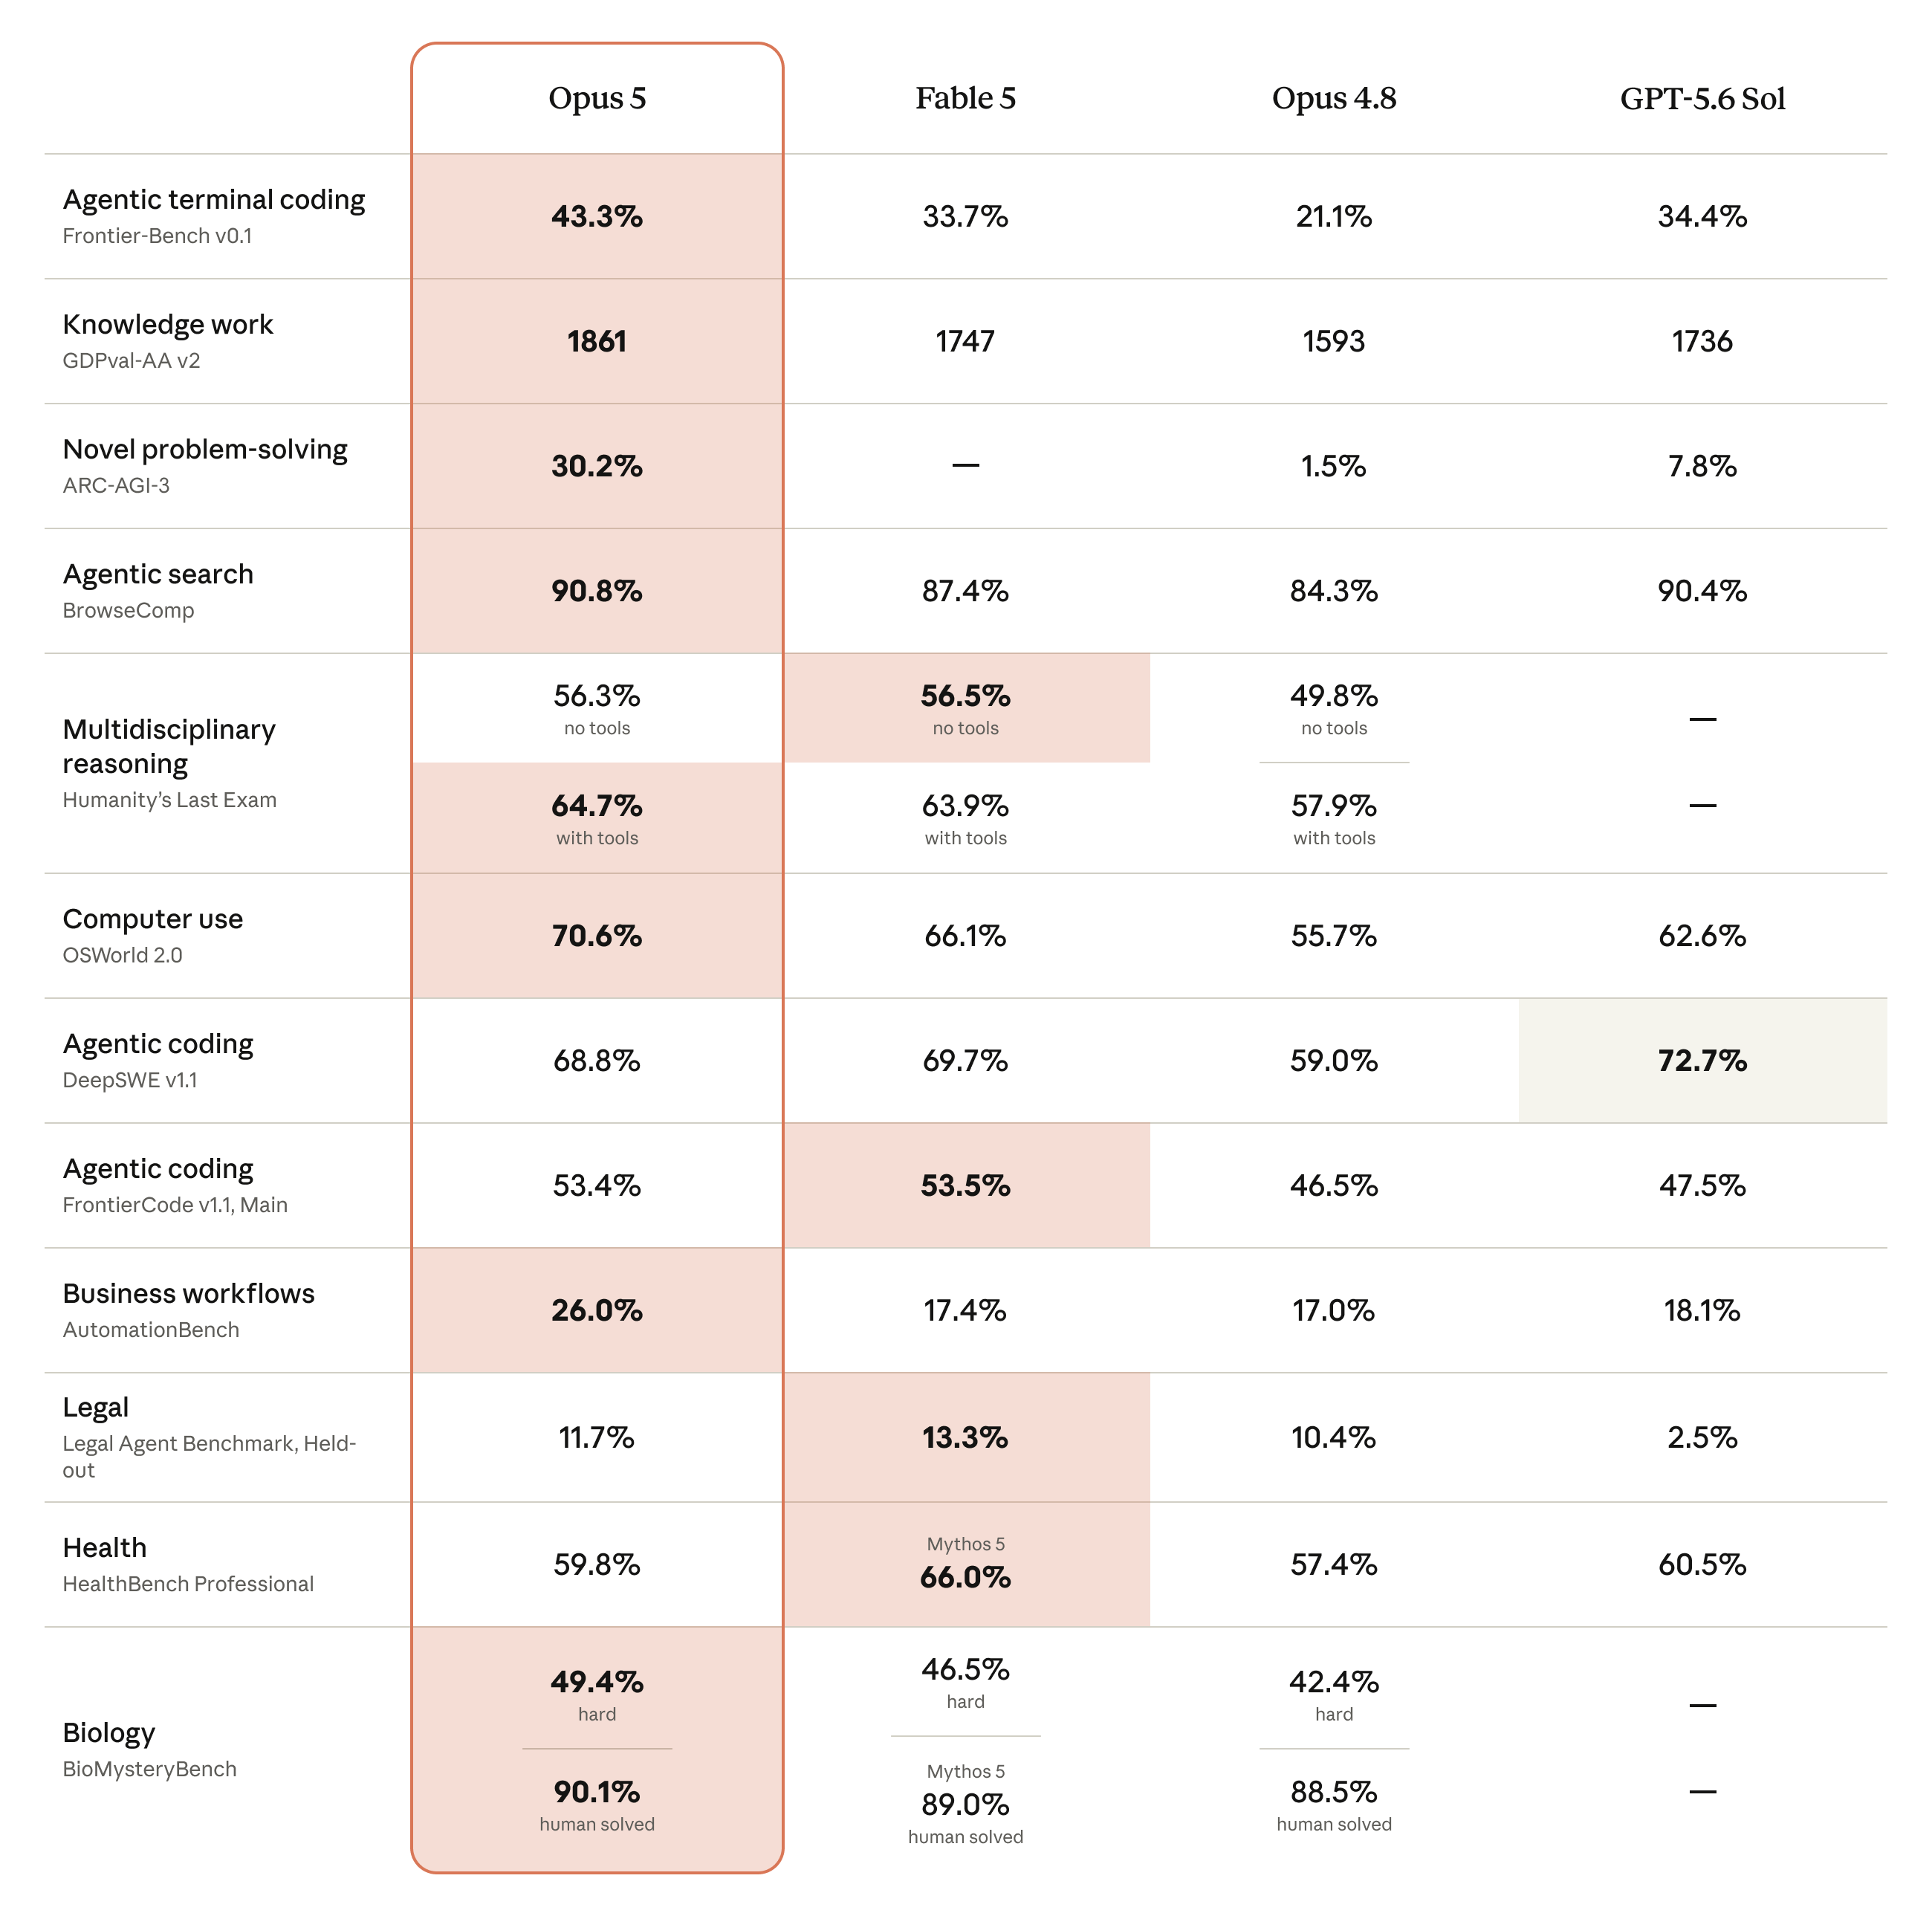
Claude Opus 5 今天正式发布。这是一款深思熟虑、主动性强的模型,智能水平接近 Claude Fable 5 的前沿水准,而价格只有后者的一半。
在 Frontier-Bench 和 GDPval-AA 等编程与知识工作评测中,Opus 5 刷新了业界最佳成绩,不过在网络安全任务上仍落后于 Mythos 5。
Opus 5 为日常使用而设计:它比其他模型工作起来更高效。它是 Claude Max 上新的默认模型,也是 Claude Pro 上最强的模型。
性能与成本效益
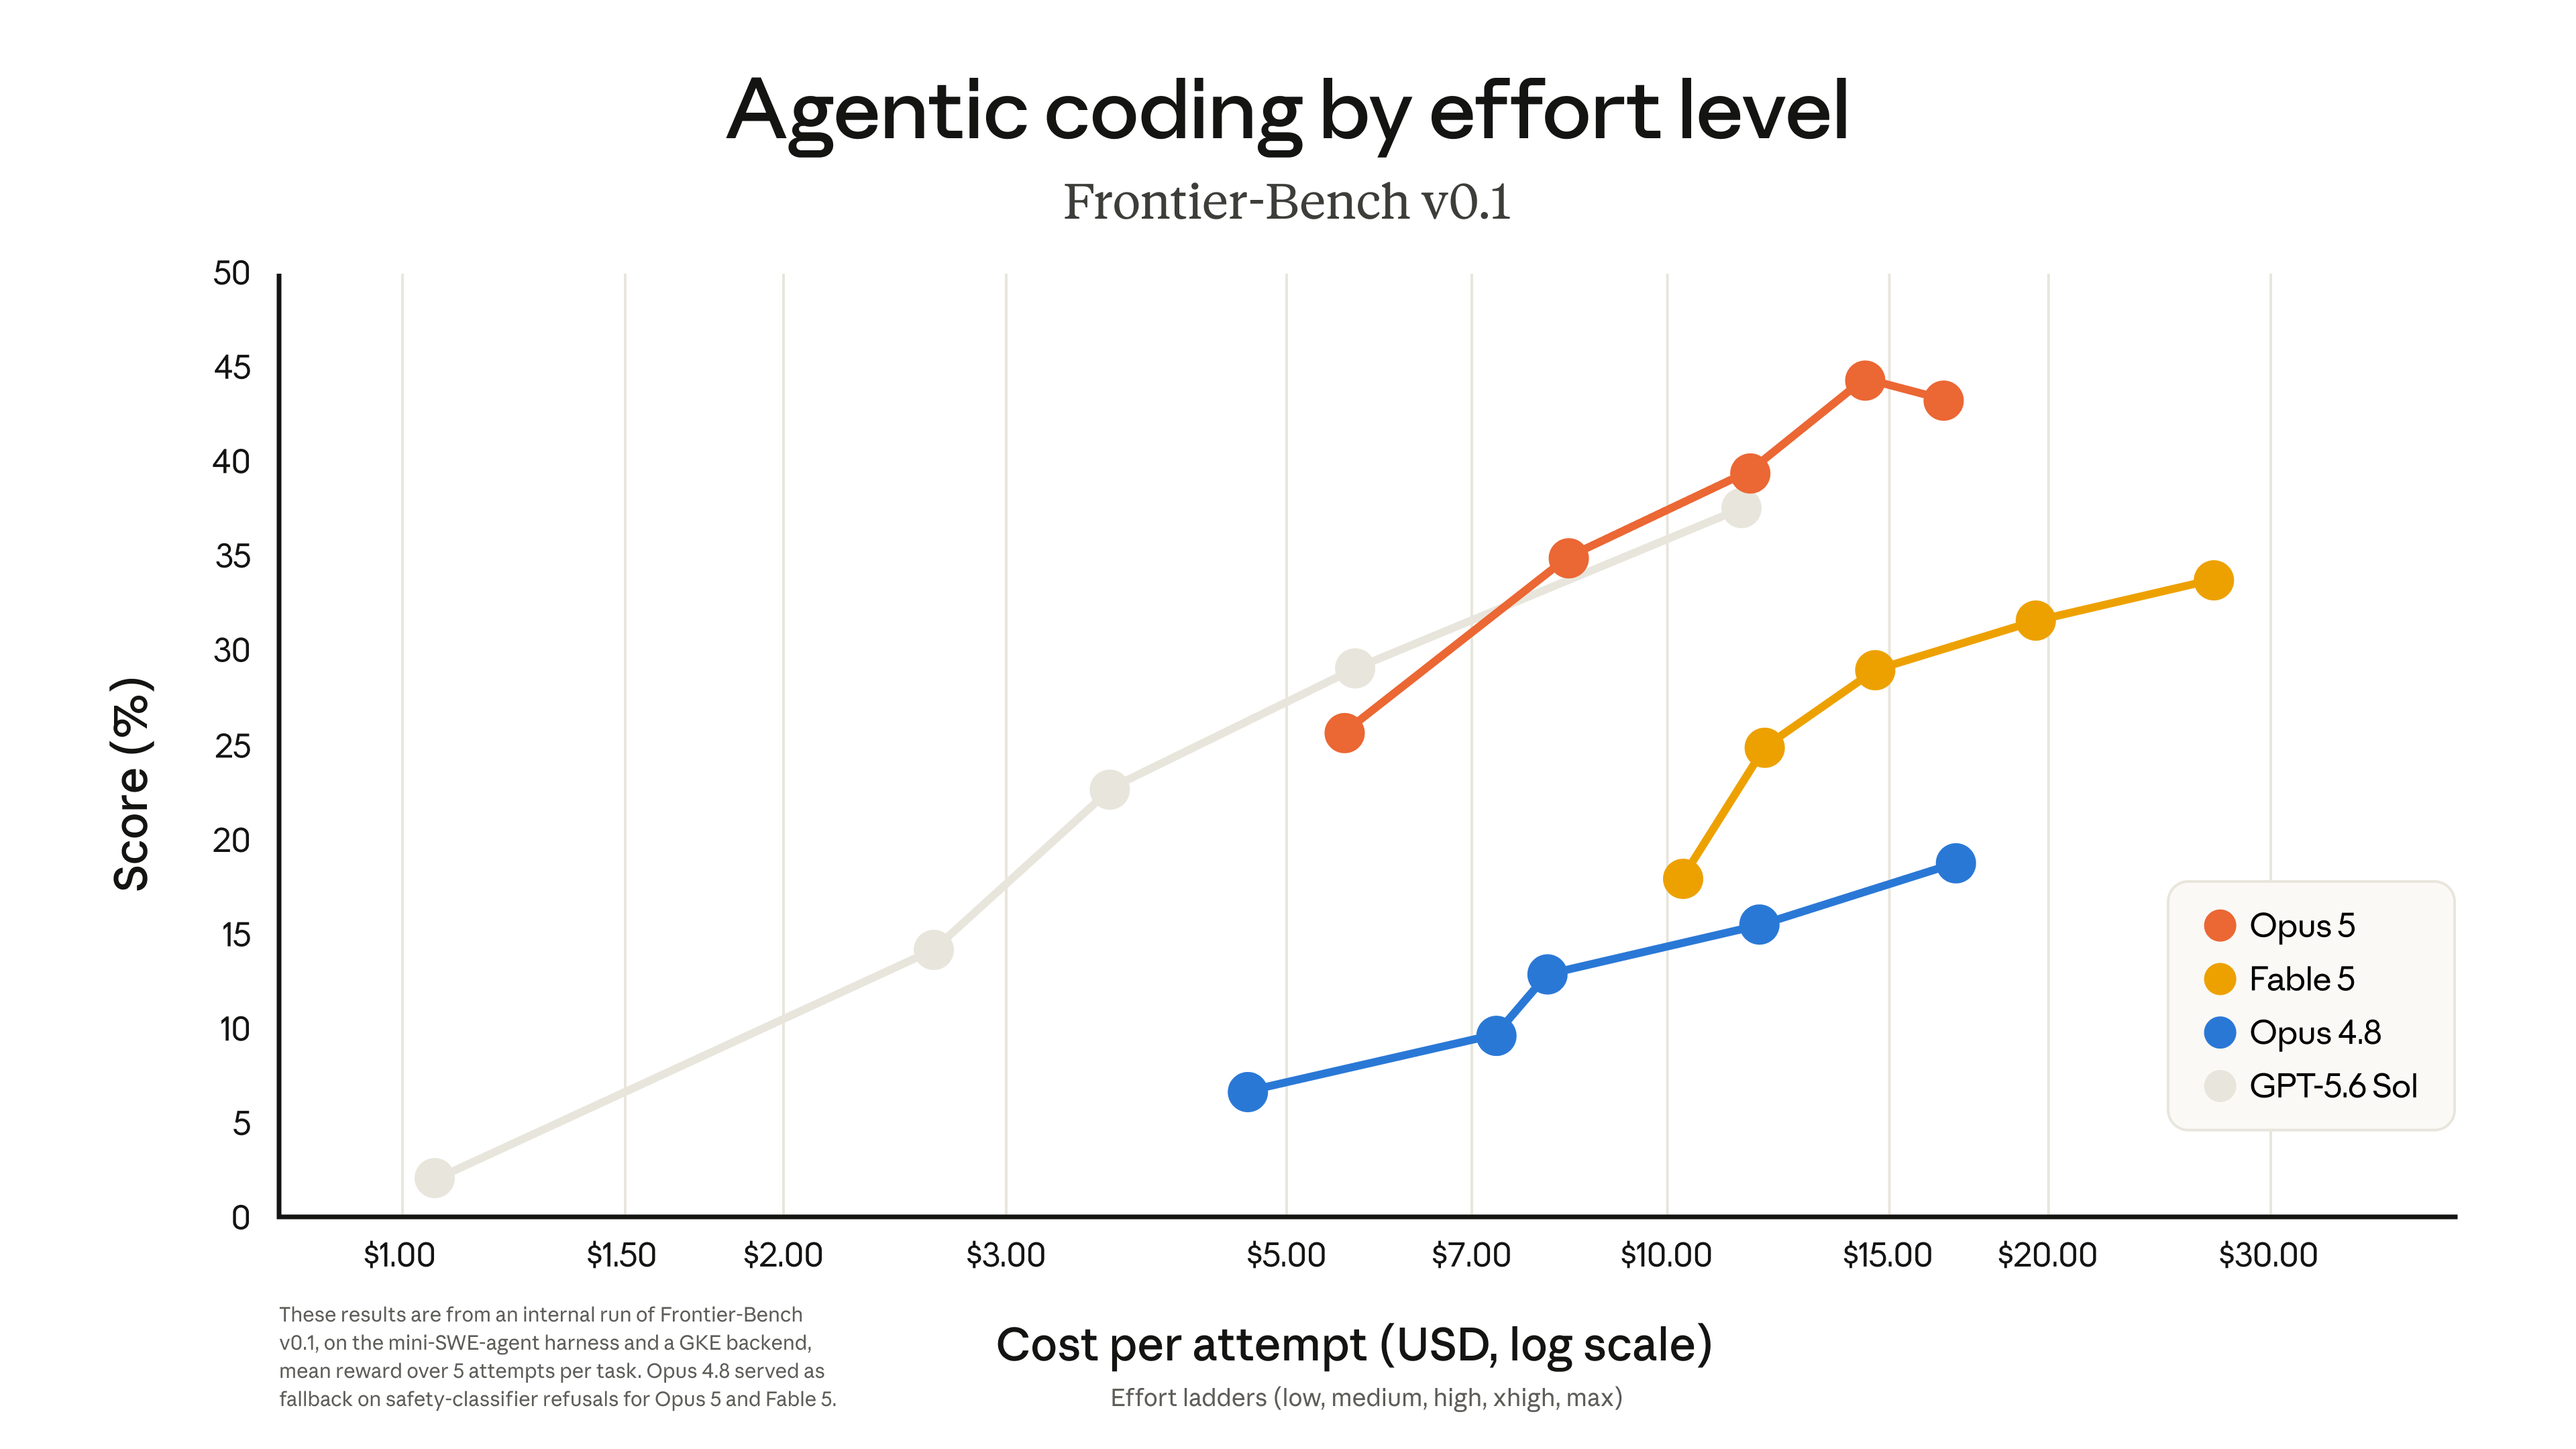
Claude Opus 5 在成本与前代 Opus 4.8 相同的情况下,性能大幅提升。本节图表展示了性能如何随模型的推理强度(effort)设置而变化,客户可以据此在智能水平与节省 token 之间取舍,以获得更快、更便宜的结果。
Opus 5 在高价值的软件工程任务上表现出色。例如在 Frontier-Bench v0.1 上,Opus 5 超越了所有其他模型,性能是 Opus 4.8 的两倍多,而每项任务的成本更低。在 CursorBench 3.2 上,最高强度下该模型的得分与 Fable 5 的峰值相差不到 0.5%,而每项任务的成本只有后者的一半;在 high、xhigh 和 max 强度下,它在相同成本下的表现也优于所有其他模型。
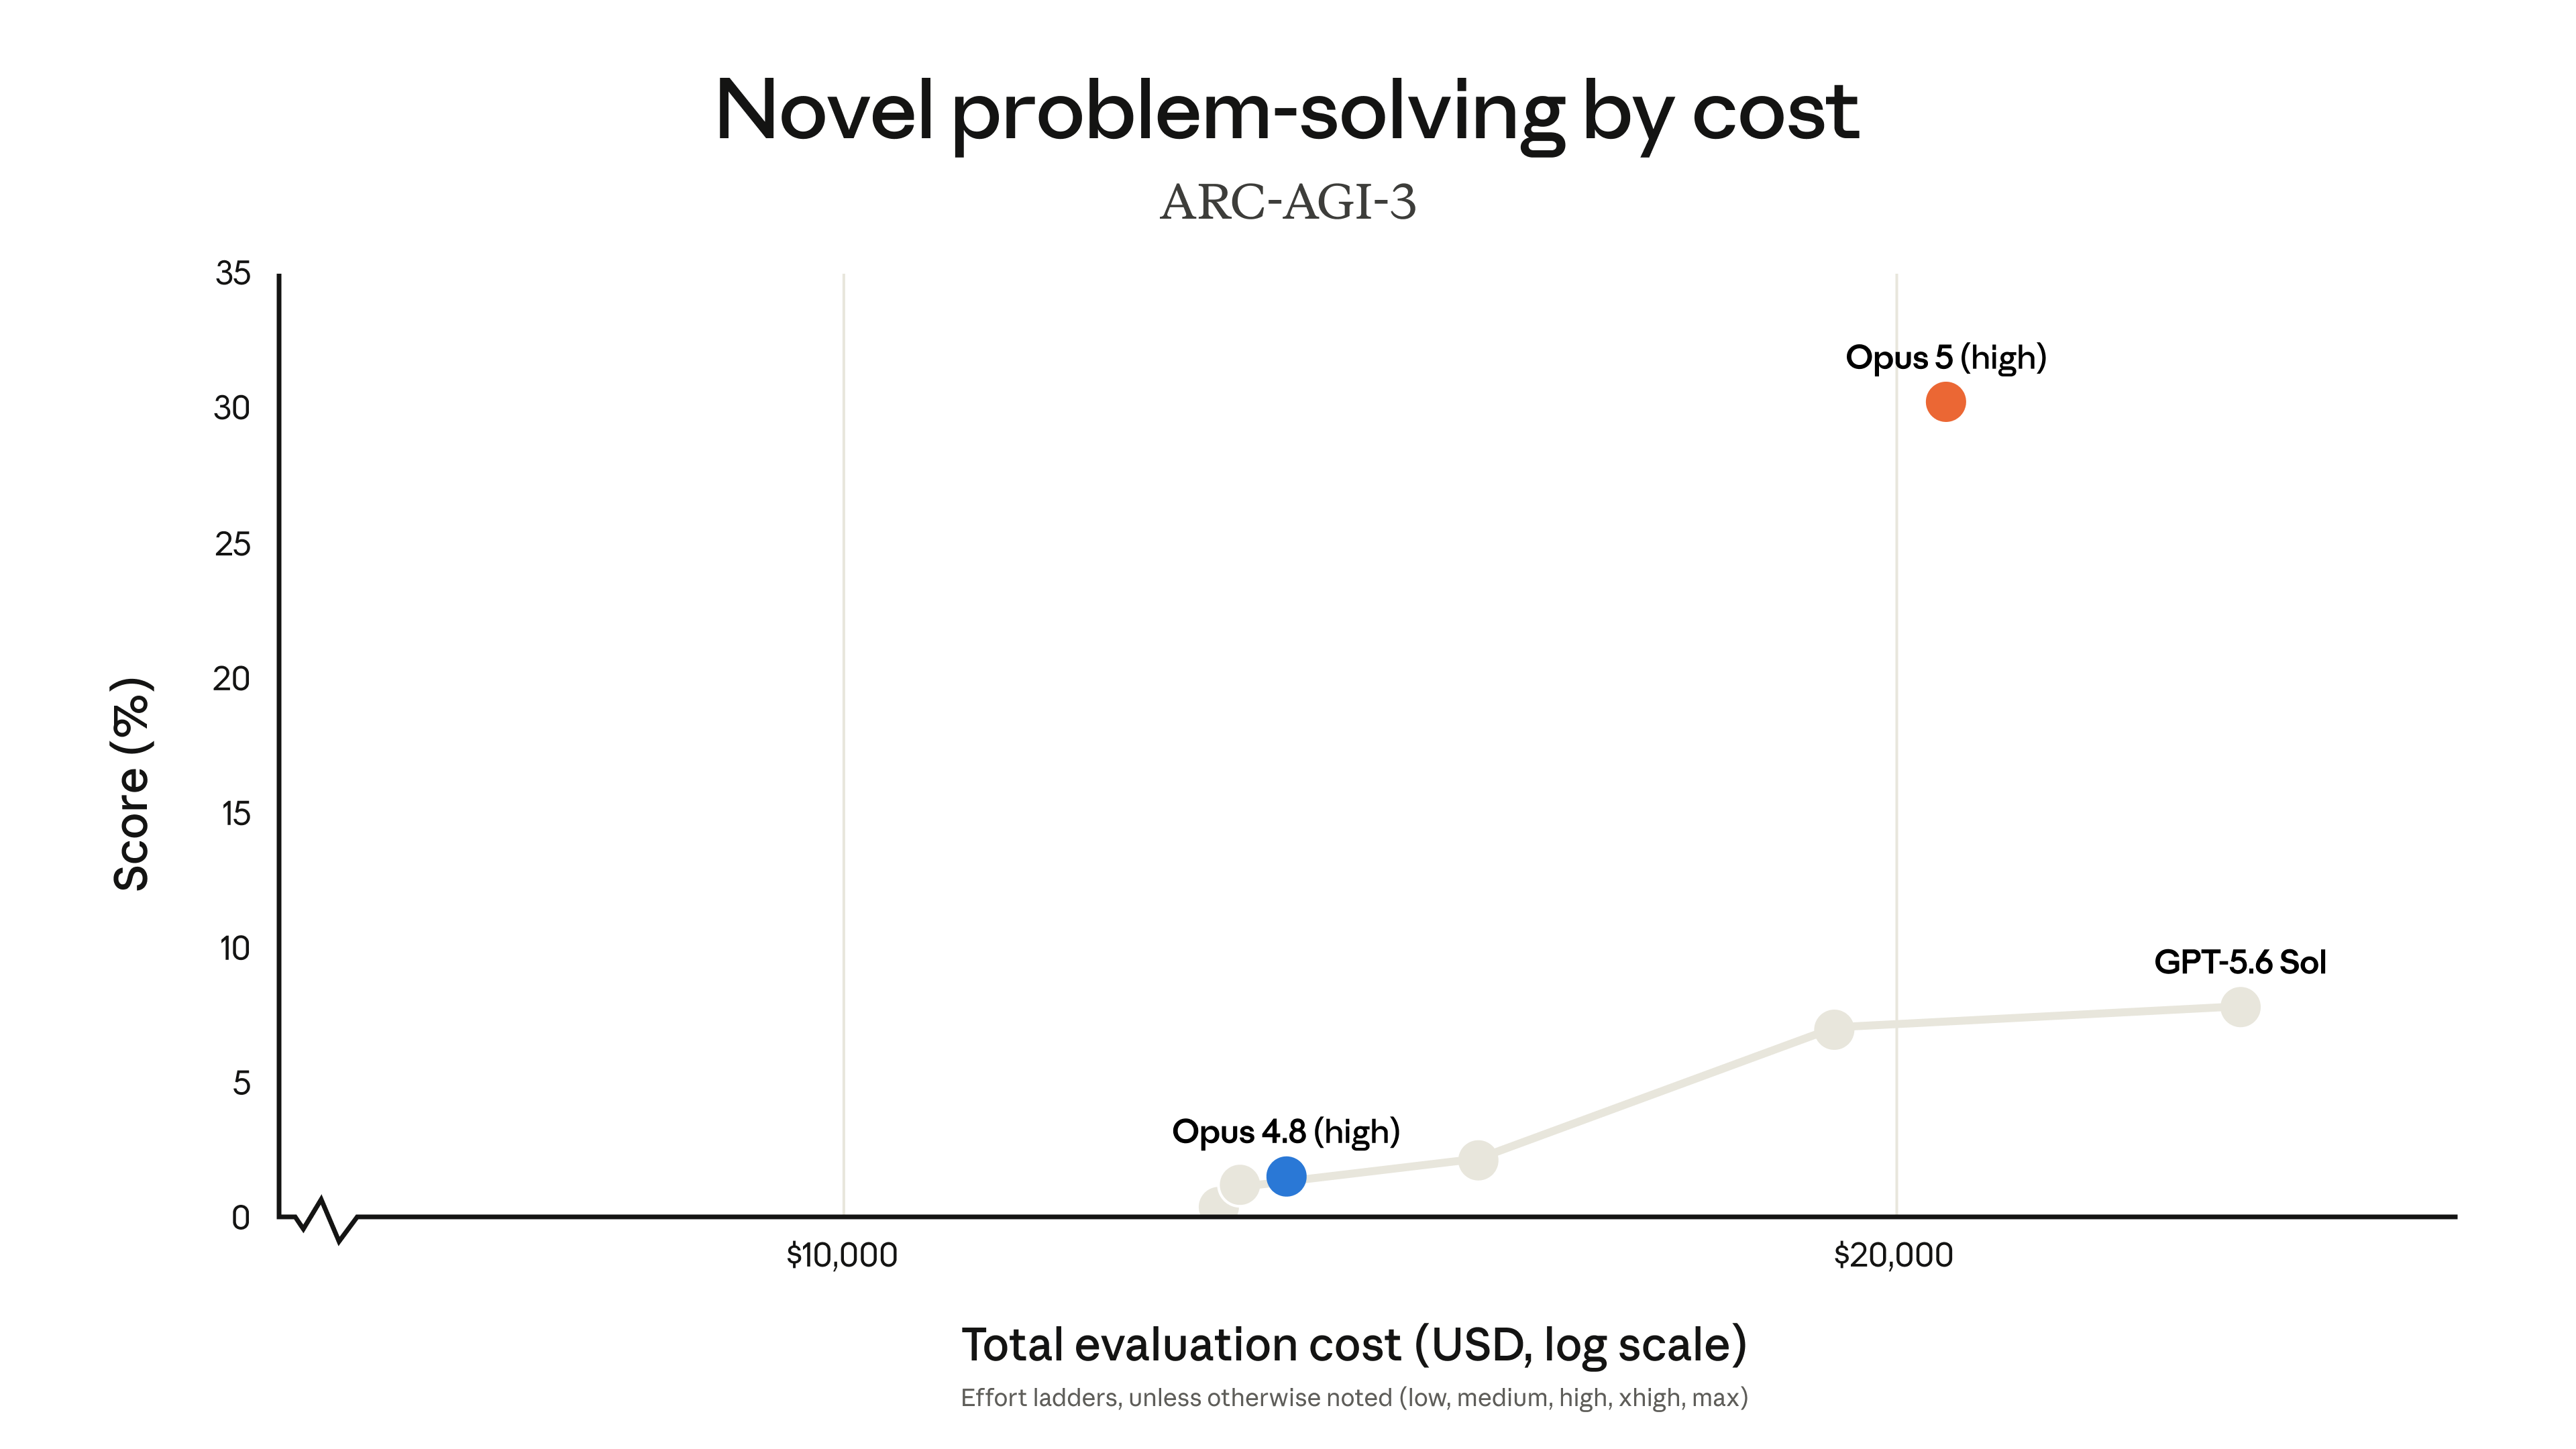
在知识工作和问题求解任务上,我们也看到了类似的结果。例如:
- 在 ARC-AGI 3(要求模型解决全新问题的评测)上,Opus 5 的得分是第二名模型的三倍。
- 在衡量模型能否从头到尾完成业务任务的 Zapier AutomationBench 上,在每项任务成本相同的情况下,Opus 5 的通过率约为第二名模型的 1.5 倍。即使在最低强度设置下,Opus 5 通过的任务数也超过其他任何模型。
- 在计算机使用基准测试 OSWorld 2.0 上,Opus 5 在任意成本下都优于其他所有模型,仅用略多于三分之一的成本就超过了 Fable 5 的最佳成绩。
在若干相关评测中,它同样是我们表现最好、成本效率最高的模型:
在科学研究方面,Opus 5 相比 Opus 4.8 有实质性提升。在我们所有的生命科学评测中,它的表现都优于 Opus 4.8,这些评测涵盖结构生物学、有机化学和生物信息学等主题。提升最明显的是有机化学任务,例如根据光谱数据推断分子结构(在我们的内部基准测试中比 Opus 4.8 高 10.2 个百分点),以及蛋白质相关任务,例如预测蛋白质序列的变化如何影响其功能(此项高 7.7 个百分点)。
最后,Opus 5 能够生成强得多的视觉输出:
Opus 5 将空气流过空气动力学(以及非空气动力学)物体的过程可视化了出来。你可以在这里尝试风洞中的不同设置。
与 Claude Opus 5 协作
Claude Opus 5 在验证自己的工作、并细致迭代直至成功方面强得多。在评测和早期访问测试中,我们和用户都发现了许多体现 Opus 5 自主性与严谨性的例子:
- 在一项 Frontier-Bench 任务中,Opus 5 拿到一张机械零件的图纸,被要求编写代码,将其重建为 FreeCAD 三维模型。但在这项任务里,模型被有意设置为无法直接查看图纸。Opus 5 的做法是自己编写一套计算机视觉流水线,从原始像素中提取几何形状,进而重建出完整的机械零件。它多次成功做到这一点;在相同设置下,没有任何竞品模型能在五次尝试内解决。
- 面对一个流行开源包管理器中的真实 bug,Opus 5 找到了根本原因,并修复了社区补丁遗漏的一个边界情况。而一个竞品模型只修复了表面症状(没有触及根本原因),随后就报告 bug 已解决。
- 一家交易公司的工程师用 Opus 5,在一次会话中就为一家新交易所构建了行情数据源。此前的模型即使有工程师给出的详尽方案,也完全无法完成这项任务。由于找不到可用于验证的实时数据源,Opus 5 甚至自己搭建了一套测试框架,来检查代码是否正确解析了交易所的数据。
以下是早期访问客户关于使用 Opus 5 体验的更多反馈:
在 FrontierCode 1.1 上,Claude Opus 5 以一半的成本接近 Fable 级别的表现。在 Devin 中,它在困难的调试和根因分析任务上也表现出特别的优势。
Claude Opus 5 以 Opus 的速度和成本,提供接近 Fable 5 的智能。在 CursorBench 上,它的得分仅略低于 Fable 5,并且具有许多相同的行为特征。我们很期待看到开发者在 Cursor 中如何使用它。
Claude Opus 5 登顶 Zapier 的 AutomationBench 排行榜,而且消耗的 token 并不比之前的 Claude 模型多。它拿到一份原始的账户健康度工作簿,端到端跑完了完整的流失预防流程:标记有风险的账户、通知合适的负责人,并为客户留存运营团队做出总结。之前的模型都没能通过;Opus 5 拿到了 100%。
在我们的基因组学分析工作中,Claude Opus 5 比我们运行过的任何模型都更像一位严谨的科学家。它会选用合适的统计检验来排除混杂因素,用独立的方法交叉验证自己的结果,并在漫长的多步分析中始终保持在正轨上。
在我们的内部评测中,Claude Opus 5 胜过其家族中的所有模型。在我们最难的智能体编程任务上,它不仅比 Opus 4.7 提升了 22%,而且更稳定,每次运行之间的方差小得多。对 Lovable 上数以百万计的构建者来说,这种一致性就是关键所在:每一次构建,都有可靠的结果。
Claude Opus 5 是自 4.5 以来 Opus 家族最大的一次飞跃。在相同的全栈应用构建任务上,前端最先体现出这一点:这是我们在 Opus 模型上见过的最好的动画、游戏和 3D 作品。

我们很喜欢 Claude Opus 5。对于我们的智能体所处理的这类开放式分析工作,它相比 Opus 4.8 是全面升级,而且提升最大的恰恰是最关键的地方:更难、更模糊的任务。回答更清晰、更简洁,在更高的强度级别下我们也看到效率有所提升。
对于我们的分析师每天运行的金融研究工作流,Claude Opus 5 相比 Opus 4.8 有显著提升。它在数值推理、表格处理方面表现突出,在对精度要求高的场合,批判性思维也更为敏锐。

Claude Opus 5 提供了分析专业企业内容所必需的行业智能和准确性。Box 发现,Opus 5 比 Opus 4.8 高出 8%,并在科技、医疗和公共部门机构每天依赖的数据分析(提升 11%)和尽职调查(提升 17%)工作流上取得了显著的性能提升。

Claude Opus 5 相比 Opus 4.8 是明显的代际跃升。在一个周末里,我让它担任我开发环境的“幕僚长”:它自己搭建了监控,逐台驱动每台机器,只在需要判断的时候才叫我介入。
Claude Opus 5 对我们的 Fundamental Research Assistant 代码库做了大规模改动,在整个智能体工作流中根据反馈不断调整,并且比我们用过的任何模型都更清楚地解释了自己的推理。这些工作我们通常会拆成小得多的部分来做,它却一次性处理了。
在我们一些最难的金融建模任务上,Claude Opus 5 在准确性和效率上都明显优于 Opus 4.8。它的性能下限显著更高,尤其是在深层的金融领域逻辑上。在各个强度级别上,它的准确率平均高出 9 个百分点,轮次和工具调用减少了三分之一,耗时减少了 60%。
Claude Opus 5 检查自己工作的方式就像一位真正的前端开发者。在我们的基准测试中,它在桌面和手机宽度下用浏览器打开自己做的页面,发现了藏在移动端首屏以下的商品和一个跑到屏幕之外的结账按钮,并在交付前把两处都修好了。
与之前的 Opus 模型相比,Claude Opus 5 在法律智能体工作上的表现有明显提升,我们在公司治理和仲裁等业务领域看到的提升最大。Opus 5 在较低推理级别下仍能保持质量,这同样给我们留下了深刻印象:与最高推理级别下的 Opus 4.8 相比,它取得了相近的表现,而平均少生成 26% 的 token。

对我们来说,Claude Opus 5 最大的提升体现在更长周期的工作上:先做出一份完整的演示文稿,再进行修改。产出物的质量决定了我们采用哪个模型,而这是我们见过的最明显的进步:视觉理解更好,格式更整洁,幻灯片问题更少。
Claude Opus 5 最突出的是它的判断力。交接 PR 时,它不会急于发布:它会核对分支、检查模板,并考虑对测试的影响,让交接干净利落。较旧的模型往往抢先一步,结果被我们的检查拦下。
在一次重新设计架构的过程中,Claude Opus 5 对我提出的设计提出了异议,而且在我坚持时并没有让步。相反,它准确说明了我的想法中有价值的部分,把自己的反对意见收窄为一个具体的设计问题,并提出了一个折中方案:保留好的部分,同时修正缺陷。正是这种判断力,让我们敢于在更少监督的情况下信任它。
在首轮合同修订(redline)上,Claude Opus 5 的得分是我们测试过的所有模型中最高的,几乎是 Opus 4.8 的两倍。批注也做得更好:在保密协议(NDA)上,它用更少的时间、更少的轮次就能完成修订,准确率保持不变或更高。
Claude Opus 5 写出的 diff 干净紧凑,没有死代码,并且在识别细微的、与具体代码库相关的隐患方面更强。我们正在把它用于生产工作负载。
我们一定会把 Cosmos(我们的统一智能体平台)中的一些用例迁移过去。我们期待越来越多地用 Claude Opus 5 做代码审查,我可以很有把握地说,我们更希望大家用 Opus 5,而不是 Opus 4.8。
Claude Opus 5 最突出的是判断力。它在写下第一行代码之前想得更深,在规划阶段就能发现自己的逻辑错误,而不是事后才发现;它会推理一个答案为什么正确,而不只是它能不能跑通。这是我们见过的 Claude 模型之间在问题求解上最明显的一次跃升,我们期待看到它在 JetBrains IDE 中被采用。
Claude Opus 5 是我们在交易基准测试上测过的最强的 Opus 模型,而它只用了 Opus 4.8 大约七分之一的推理 token,延迟不到后者的一半。用一小部分算力,得到更好的答案。
Claude Opus 5 让监控智能体能够在生产环境中管理自己的部分记忆,使它们在更长的周期里更自主、更可靠。智能体把自己的上下文当作一份活的文档:在标记出我们某项服务中的潜在异常后,它根据生产环境重新核对了自己的假设,发现该信号无害,把更正写入自己的记忆,并自行停用了相应的监控查询。
Claude Opus 5 是一款强大的智能体编程模型,专为长时间运行的多步骤工作而打造。它能深入理解你的代码库,在复杂任务中始终把握主线,在功能开发和 bug 修复中比 Opus 4.8 更有效地明确需求。开发者现在可以在 Kiro 中使用 Opus 5 进行构建,借助其先进能力去完成更有雄心的项目。
01 / 24
对齐与安全
对齐。在部署前测试期间,我们的自动化行为审计发现,Opus 5 是我们迄今对齐程度最高的模型(如下图所示)。它比 Opus 4.8、Sonnet 5 或 Fable 5 更好地遵循 Claude 宪法,欺骗行为的发生率最低,也最不容易被诱骗而被滥用。在避免可能带来难以挽回的副作用的鲁莽行为方面,它同样是我们迄今最安全的模型。
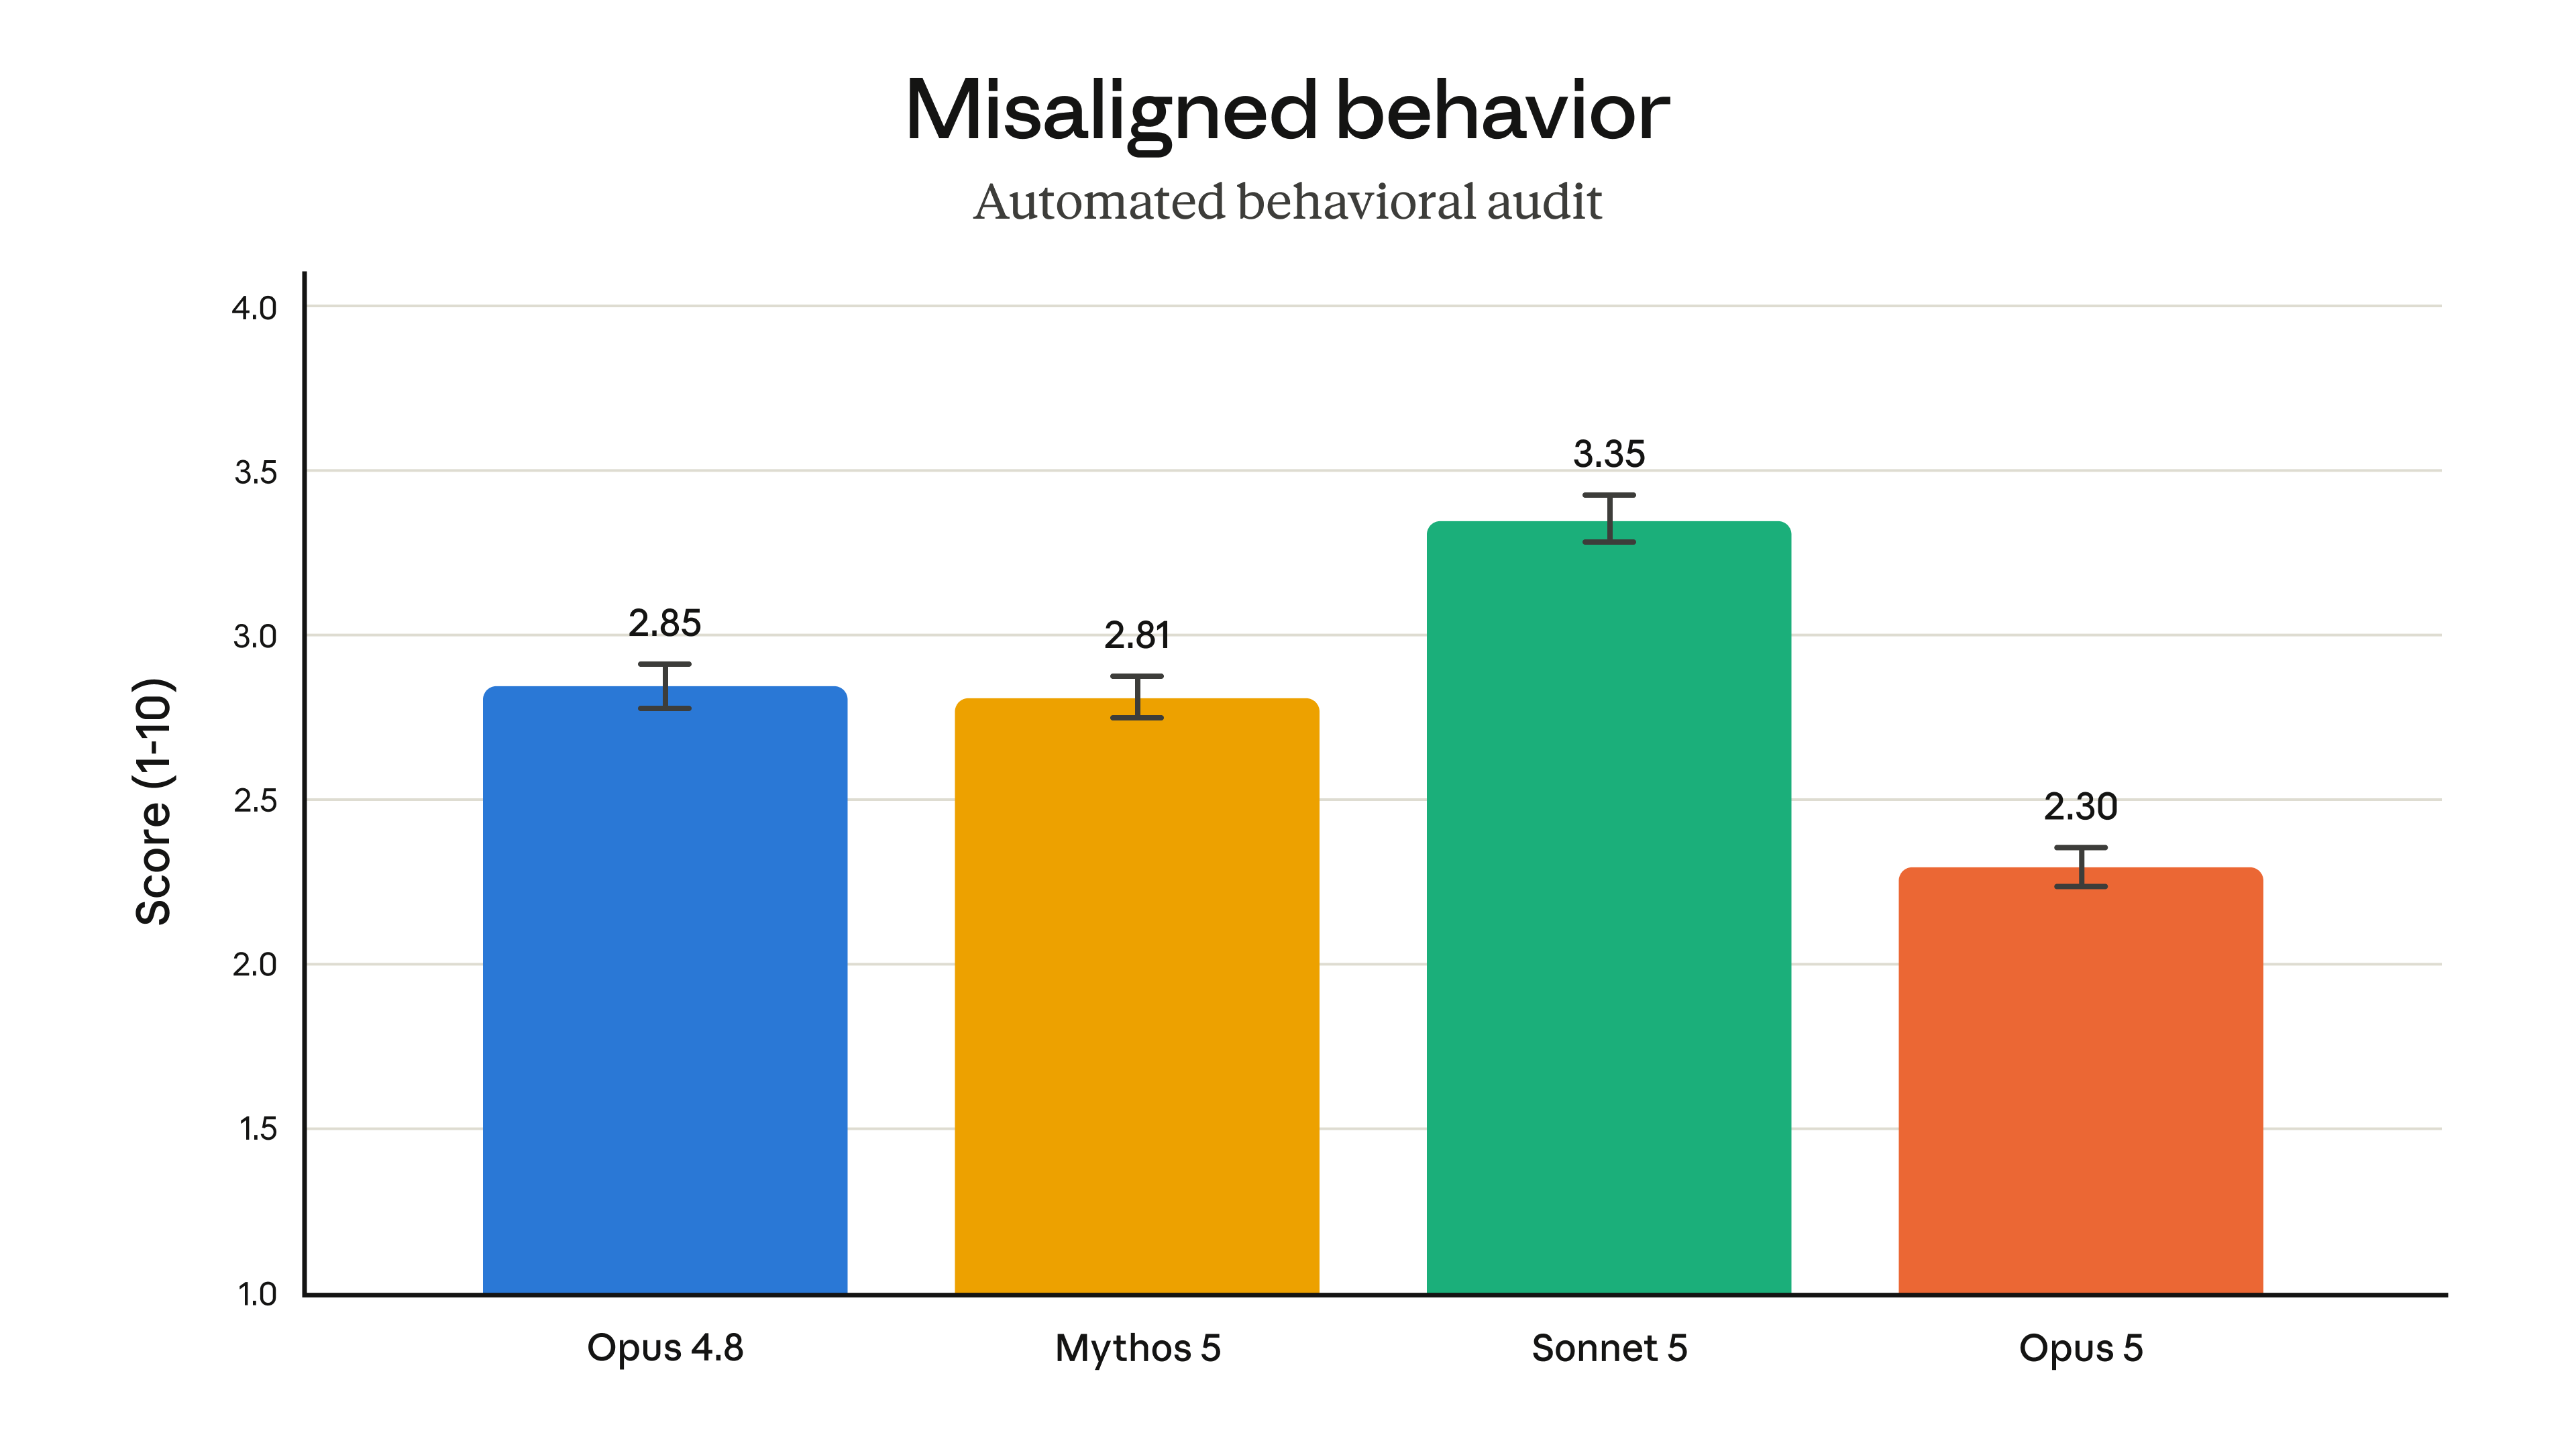
安全。Opus 5 并没有推进高风险双重用途能力的前沿。在与民营部门和政府合作伙伴共同开展的严格评测中,我们发现它在生物学研究和攻击性网络安全两方面仍落后于 Mythos 5。有关这些评测的更多信息,请参阅我们的系统卡。
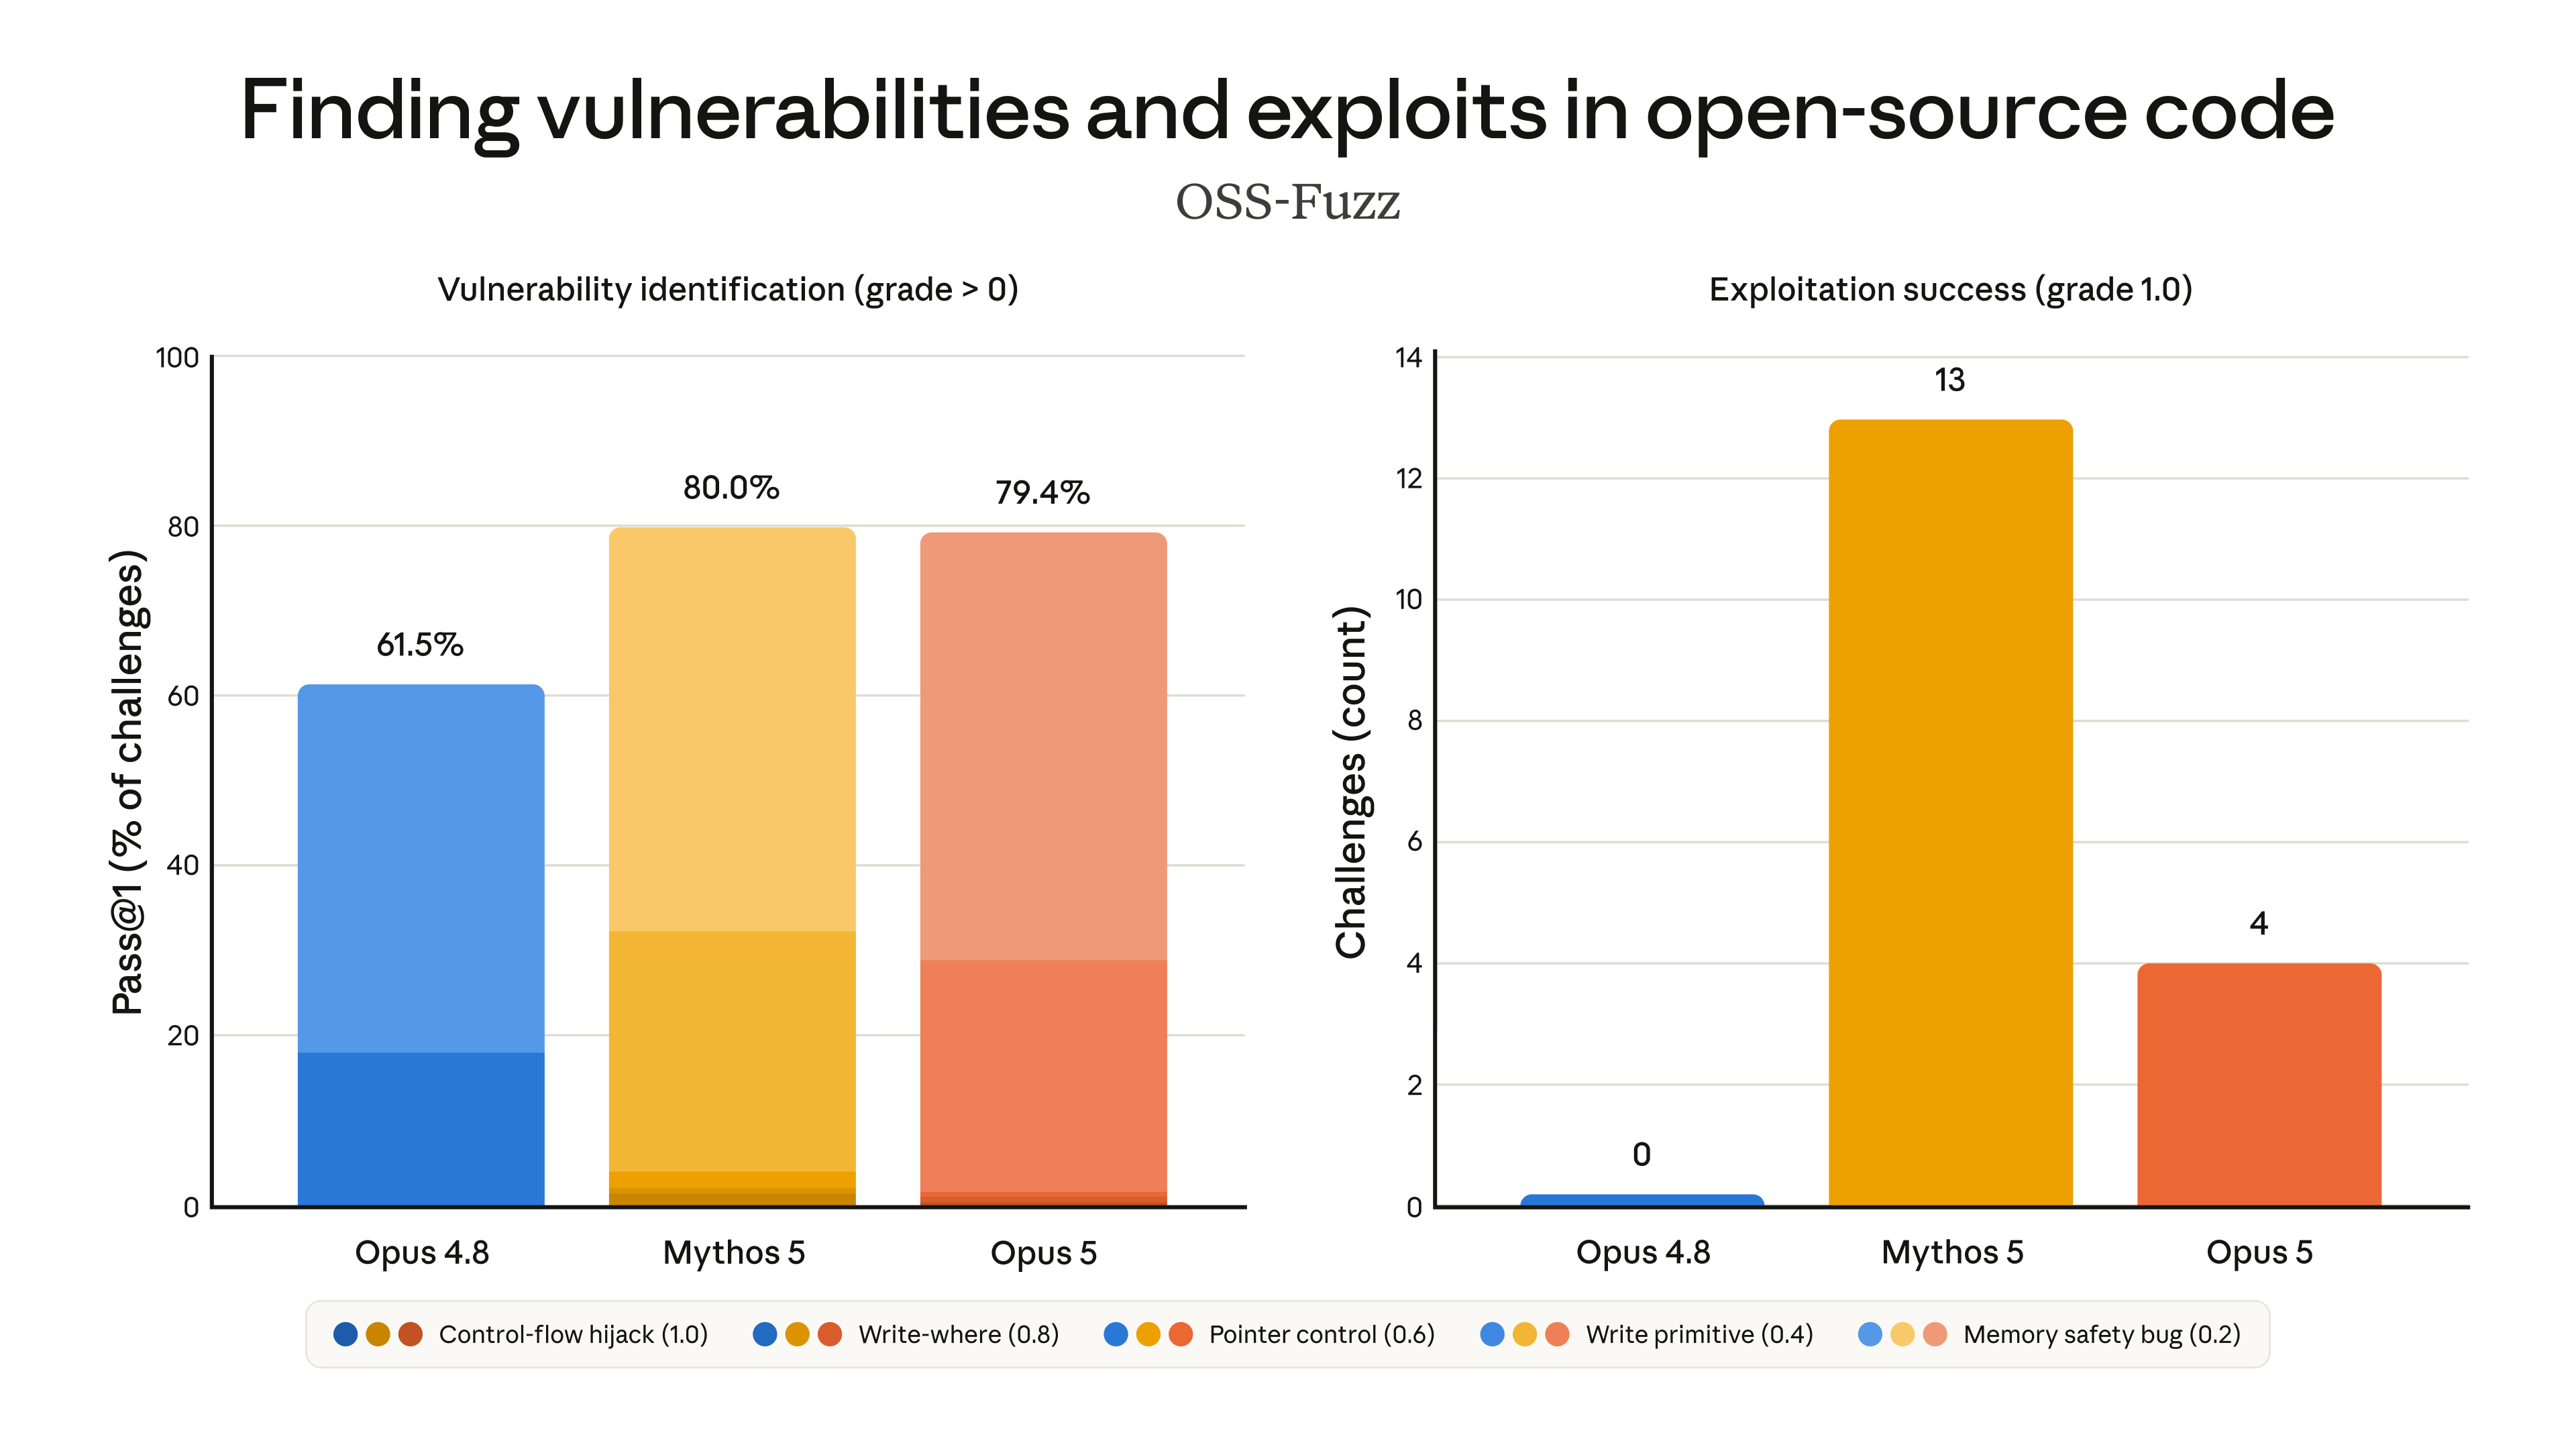
与前代 Opus 4.8 一样,我们有意避免在网络安全任务上训练 Opus 5。尽管如此,由于整体能力增强,该模型在这些任务上仍有大幅提升,在发现网络安全漏洞方面已接近 Mythos 5。不过,在利用这些漏洞方面,也就是把漏洞转化为实际的网络威胁方面,它仍远远落后于 Mythos 5。
Opus 5 在 OSS-Fuzz 上的表现说明了这一点。OSS-Fuzz 是我们开发的一项评测,用于评估模型在没有大量人工指导的情况下发现并利用漏洞的能力。虽然 Mythos 5 和 Opus 5 发现漏洞的成功率相近,但 Opus 5 在开发利用代码(exploit)方面的得分远低于 Mythos 5。
Opus 5 的防护措施
Claude Opus 5 的防护措施旨在允许该模型在网络安全和生物学领域的有益用途。这些措施与我们应用于 Opus 4.8 的类似,只是在一小部分网络安全任务上加强了防护。
网络安全。Opus 5 的网络安全分类器按比例比 Fable 5 的限制更少。它们允许 Opus 5 在源代码中查找漏洞,但会阻止“基于二进制”的漏洞扫描(这种方法更可能与恶意行为者相关联)、渗透测试和利用代码生成。
根据我们的测试,我们预计这些分类器的介入频率比 Fable 5 低约 85%。在 Claude.ai、Claude Code 和 Claude Cowork 中,任何被标记的请求默认都会回退到 Opus 4.8。在 API 上也可以启用回退到 Opus 4.8 的功能。
我们的网络安全验证计划(Cyber Verification Program,CVP)为那些原本会被模型防护措施阻碍的网络安全工作提供便利。已加入 CVP 的企业和研究人员可以立即使用安全限制较少的 Opus 5 版本。
生物学。由于 Opus 5 的防护措施与 Opus 4.8 相近,它现在是我们面向公众开放的、科研能力最强的模型。尽管如此,该模型在长时间运行的自主研究任务上仍有明显局限,而我们预计 AI 模型在生物学方面最实质性的风险正出在这类任务上。(对于这类生物学工作,Mythos 5 仍是更强的模型。)作为此次发布的一部分,在 Fable 5 上被拦截的生物学相关请求,现在将路由到 Opus 5,而不是 Opus 4.8。
快速上手
Claude Opus 5 今天已在所有平台上线,定价为每百万输入 token 5 美元、每百万输出 token 25 美元(与 Opus 4.8 相同)。开发者可以在 Claude API 上通过 claude-opus-5 开始使用。
它还提供 Fast 模式,运行速度约为默认速度的 2.5 倍。与 Opus 4.8 一样,Fast 模式在 Claude Platform 上的价格是 Opus 5 基础价格的两倍,在 Claude Code 中则通过使用额度(usage credits)提供。
随 Opus 5 一同发布的,还有两项处于 beta 阶段的更新:
- Claude Platform 上的对话中途工具变更。在一次对话中,开发者现在可以更改 Claude 可使用的工具,而不会使提示缓存(prompt cache)失效。
- API 上的自动回退。用户现在可以选择让 Opus 5(或 Fable 5)上被我们的安全分类器标记的请求自动路由到另一个模型。开启自动回退后,API 请求默认总是路由到可用的最佳模型,而不是被拦截。
与之前的 Opus 模型一致,Opus 5 对一般访问没有数据留存要求。
如需了解如何让 Opus 5 发挥最佳效果的更多指导,请参阅我们的提示词指南。