在强化学习(RL)后训练期间,训练轨迹是通过使用当前策略模型运行推理动态生成的。为了提高训练效率,通常会在分离式设置中,在独立的GPU资源上并行运行推理和训练。尽管策略模型仅在训练GPU上更新,但系统必须定期用训练GPU上生成的最新参数刷新推理GPU上的权重。这种在训练GPU和推理GPU之间传输模型权重的过程称为refit。
Refit涉及两个定义性特征,这些特征带来了挑战。首先,推理和训练具有不同的计算需求,因此权重通过不同的并行映射(数据、上下文、张量、专家和流水线并行)在推理实例和训练实例上以不同方式分布。
其次,由于refit必须更新推理GPU上的所有模型权重,通信负载量级相当于模型权重的总大小。对于最新的前沿模型,这一负载已经非常大,并且预计会持续增长。这些特征共同意味着refit需要在各种分布式源和目标布局之间进行高性能通信。
本文解释了AI训练框架如何使用Reshard集合通信来解决这些refit挑战,Reshard是一种新型集合通信,主要设计用于加速RL权重refit。NCCL M2N Reshard是Reshard集合通信的开源参考实现,可通过NVIDIA/nccl-extensions GitHub仓库获取。
随着模型规模扩大,当前权重refit方法的挑战
现有的refit实现通常使用收集-广播方法来处理训练和推理布局之间的差异。
针对每个模型参数的典型收集-广播权重refit序列结构如下:
- 训练GPU执行全收集(all-gather)其本地分片以重建完整参数。
- 完整的参数张量被广播到推理GPU。
- 每个推理GPU保留其本地布局所需的分片。
使用完整张量作为中间表示使得在不同布局之间传输权重变得简单直接。然而,即使推理GPU只需要一个分片,它也会接收到完整的参数。这个过程在收集和广播阶段都产生了冗余通信,这是次优的。
这种通信的大小随着模型规模增长而增长,而模型规模持续扩大。例如,Kimi K3包含2.8万亿参数,而Qwen 3.8 2.4T A95B包含2.4万亿参数。假设BF16权重每个参数占两个字节,它们的权重大小分别约为5.6 TB和4.8 TB。
考虑全收集和广播两个阶段,估计逻辑负载约为模型权重大小的两倍(表1)。
表1. 假设BF16权重的两阶段逻辑负载估计
| 模型 | 大小(字节) | Refit负载估计(全收集+广播) |
|---|---|---|
| Kimi K3 | 5.6 TB | ≈11.2 TB |
| Qwen 3.8 2.4T A95B | 4.8 TB | ≈9.6 TB |
对于当今最大的开放权重模型,每次refit的通信负载已经达到约10 TB,而每次训练步骤都必须执行refit。随着LLM持续扩展,与这一大负载相关的开销将变得更加显著。因此,需要一种更精细的方法来执行权重refit,以减少实际负载大小,同时正确处理多样化的权重布局。
将refit重新表述为DTensor到DTensor的传输问题
为了克服这些限制,从refit应仅传输理论最小量的权重数据这一原则出发。然而,实现这一点面临若干挑战。训练实例和推理实例可能使用不同的并行配置和GPU数量,产生不同的分片边界。因此,目标分片可能需要从多个源分片的部分组装而成,反之亦然。
复制进一步复杂化了映射,因为相同的权重可能从多个源GPU可用,或被多个目标GPU需要。确定哪些源GPU应向每个目标发送哪些张量区域,同时在所有可能的配置中实现高性能,并非易事。
解决这一挑战的关键是为这种独特的通信模式确定正确的抽象。团队转向了现有的PyTorch分布式张量(DTensor)抽象,它旨在表示在不同形式的数据和模型并行下跨GPU分片或复制的张量。关键见解是,无论两个实例使用何种并行配置,权重refit都可以重新表述为将DTensor从训练布局重新分片到推理布局。
DTensor布局由张量的全局形状、指定GPU逻辑排列的设备网格以及指定张量如何在该网格上分片或复制的放置来描述。Refit可以使用源描述来指定更新后的权重所在位置,并使用目标描述来指定每个推理GPU需要哪些权重。
例如,考虑一个8 x 8的权重矩阵,在行维度上跨两个训练GPU分割,在列维度上跨四个推理GPU分割。假设张量在训练GPU上按行维度分片,在推理GPU上按列维度分片,每个训练GPU持有4 x 8的分片,而每个推理GPU需要8 x 2的分片。每个目标可以通过从每个源接收4 x 2的区域来获得其所需的分片。这些区域直接来自源分片和目标分片之间的重叠,如图1所示。
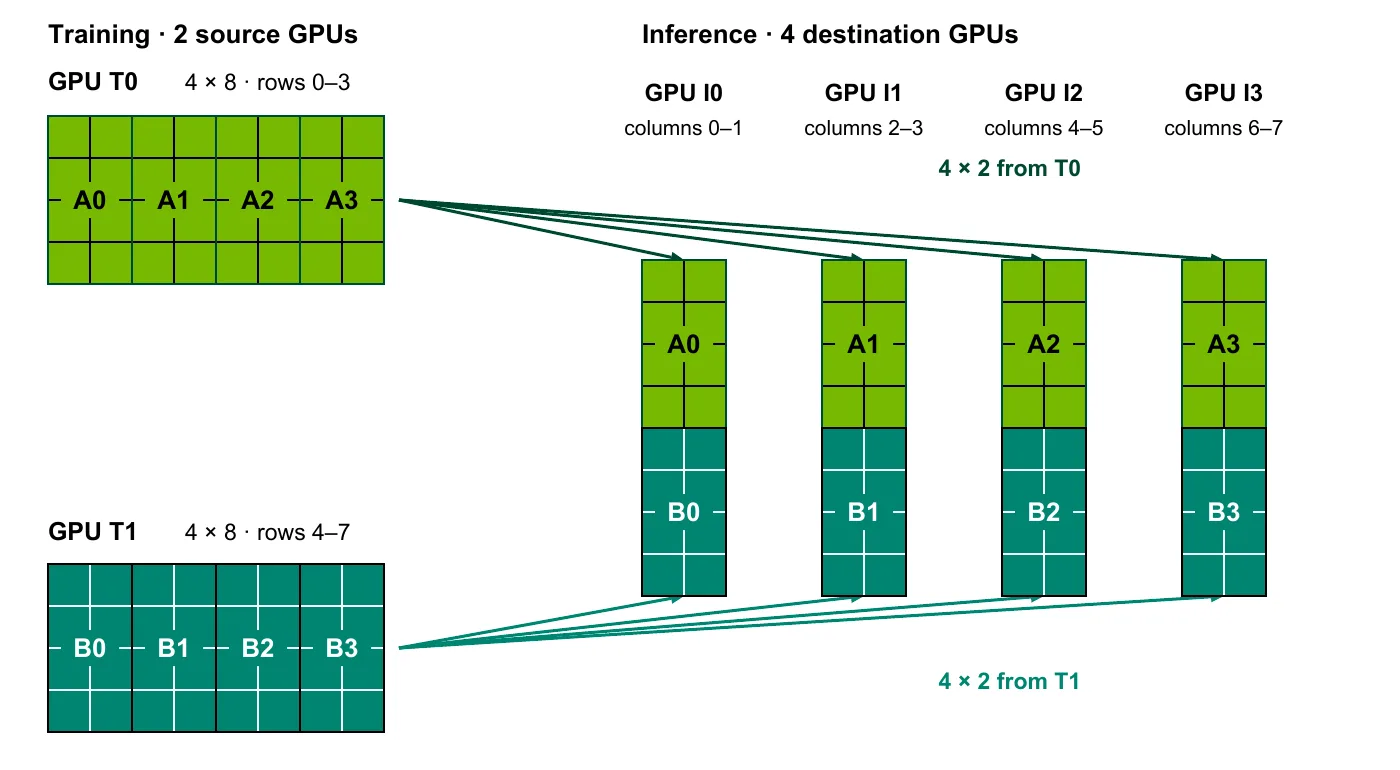
如图所示,任何类型的分片张量都可以轻松表示为DTensor格式,而refit可以重新定义为DTensor到DTensor的重分片问题。这一发现为Reshard集合通信提供了基础。
用于DTensor到DTensor传输的Reshard集合通信
Reshard是一种新型的集合通信调用,用于任意DTensor到DTensor的传输。与all-reduce、reduce-scatter、all-gather、broadcast等一样,reshard定义了一种通信模式,应用程序可以将其作为单个操作调用。它将逻辑张量的值从其源分布传输到其目标分布。
Reshard调用只需通过源和目标DTensor描述即可指定。这种抽象不仅简化了refit问题,还将通信逻辑封装在库中,使底层算法能够独立于应用程序演进和改进。
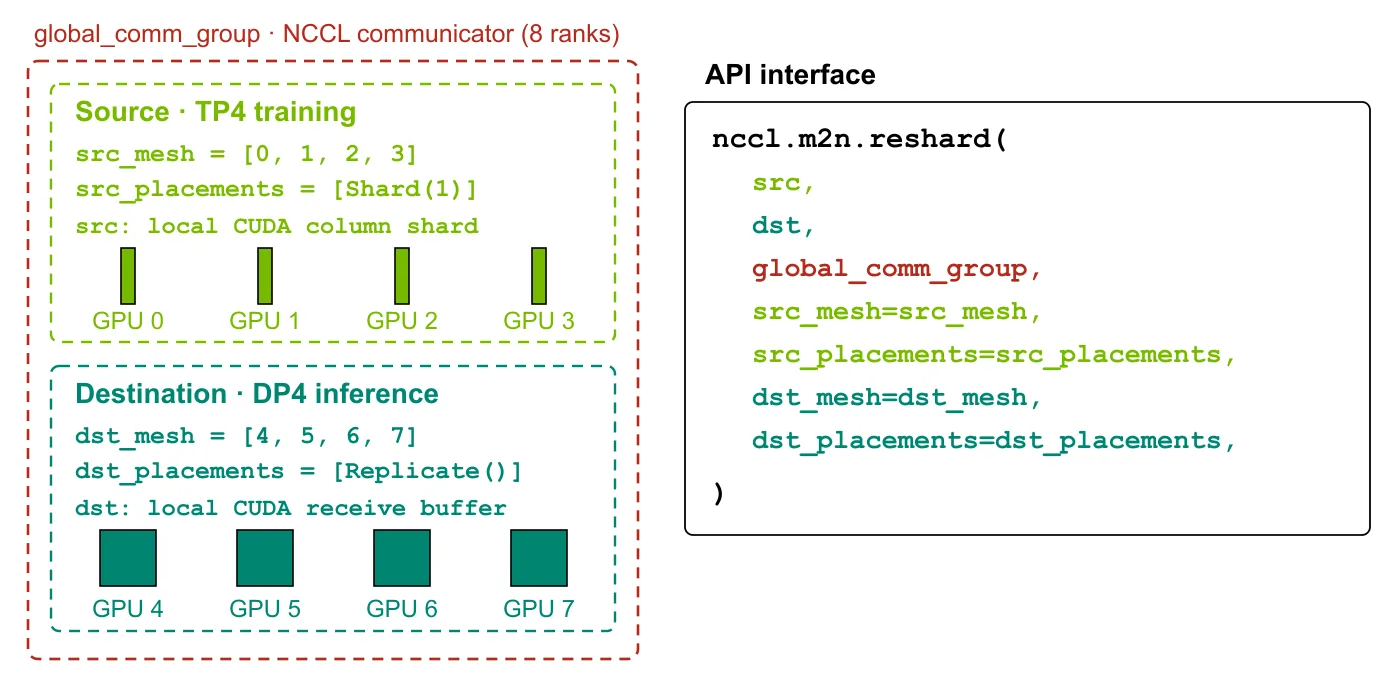
NCCL M2N Reshard是开源的,作为Reshard集合通信的首个参考实现提供给社区。该实现基于NCCL构建,将分布在M个源GPU上的张量传输到N个目标GPU所需的布局中。在RL refit中,训练GPU构成源组,推理GPU构成目标组。
图2展示了该实现如何接受布局描述和本地缓冲区来执行Reshard操作。
NCCL M2N Reshard如何释放最大网络带宽
NCCL M2N Reshard首先推导出源分片和目标分片之间的精确交集,然后将这些传输映射到物理GPU网络拓扑上。NCCL M2N不是将每个源贡献独立发送到每个目标副本,而是按NVIDIA NVLink域对副本进行分组。在每个域内,它尽可能均匀地将传入的贡献分配到副本rank上,使每个接收rank通过网络接收总数据的不同子集。
然后,接收rank通过NVLink交换这些子集,使每个副本能够组装完整的分片,而不会产生重复的网络流量。如果副本跨越多个NVLink域,则每个贡献的一个副本会通过各域转发,并在每个域内进行相同的均衡本地交换。网络传输和NVLink复制以流水线方式执行,以隐藏彼此的延迟。
图3展示了这种数据移动方案,其中张量从源端的TP4移动到目标端的TP2 x DP2,所有四个目标GPU位于一个NVLink域中。使用直接点对点传输(图3a),每个源分片被发送到两个数据并行(DP)副本。结果,每个分片在网络中被冗余传输两次。这意味着每个分片大约获得一半的网络带宽(假设每个分片饱和网络带宽)。
NCCL M2N Reshard仅通过网络传输每个源分片一次,为每个目标GPU提供其所需数据的一半(图3b)。目标GPU通过NVLink交换缺失的一半。例如,目标GPU 0通过网络从源GPU 0接收S0,并通过NVLink从目标GPU 2接收S1。网络传输和NVLink交换同时进行。这样,每个分片获得完整的网络带宽。

使用NVIDIA NeMo RL演示Reshard集合通信
为了演示Reshard集合通信在权重refit中的有效性,在NVIDIA NeMo RL框架中提供了参考实现。NeMo RL是一个开源框架,旨在简化和扩展RL后训练。Reshard集合通信的清晰抽象使得框架内所需的实现相对简单。对于给定的并行配置,框架只需为训练和推理实例的每个参数提供DTensor描述,这应该很直接,因为DTensor正是为此目的而设计的。
然而在实践中,层类型的多样性以及训练和推理引擎在每种并行配置下对参数分片方式的差异,使得通过Reshard集合通信处理每个边缘情况变得具有挑战性。
为了开发高效且可持续的设计,我们基于一个关键观察:transformer块中的前馈投影权重在权重refit负载中占主导地位。在最新的LLM中,这些权重约占模型参数的95%。
基于这一观察,我们的设计采用混合方法:占主导地位的前馈投影权重走reshard路径,而所有其他小权重(例如QKV投影或mamba权重)使用传统的gather-and-broadcast refit路径,该路径针对广泛的功能覆盖进行了优化。这种方法将针对大部分负载的高效reshard通信与和传统gather-and-broadcast refit相同的功能覆盖相结合。
分片布局可以在运行时随着故障恢复期间节点的增加或移除而改变。为了适应GPU成员的变化,框架可以销毁并重新创建通信组,或使用NCCL shrink and grow API来调整现有的通信器组。NeMo RL目前使用第一种方法来实现弹性支持。使用NCCL shrink and grow API的弹性支持计划在未来的更新中提供。
RL权重refit性能基准测试结果
表2总结了使用上文介绍的NeMo RL实现测得的基于reshard的refit延迟。基准测试涵盖了NVIDIA DGX H100(NVL8)和NVIDIA DGX GB200(NVL72)系统上的一系列模型。在各种基准测试中,reshard refit相比传统gather-and-broadcast refit实现了2.7倍到5.7倍的加速。
表2. 在NeMo RL中测得的refit延迟
| 平台 | 模型 | 训练 → 推理布局 | Gather-and-broadcast refit延迟 | Reshard refit延迟 |
|---|---|---|---|---|
| NVIDIA DGX H100 | Qwen 3 235B | TP4 x PP8 x EP16 → TP8 x DP16 | 6.4 s | 1.9 s |
| NVIDIA DGX H100 | DeepSeek v3 671B | PP16 x EP16 → TP32 x DP8 | 14.9 s | 2.6 s |
| NVIDIA DGX GB200 | DeepSeek v3 671B | PP16 x EP16 → TP32 x DP8 | 6.1 s | 2.3 s |
| NVIDIA DGX GB200 | Nemotron Ultra v3 | TP8 x EP32 x PP2 → TP8 x DP8 | 8.2 s | 2.3 s |
这种新的refit是为万亿参数模型设计的。在我们的仅refit微基准测试中,Reshard refit对于Qwen3.8 2.4T BF16模型仅需4.3秒,展示了其在其设计所针对的万亿参数规模上的有效性。
使用NeMo RL开始使用reshard权重refit
NVIDIA NeMo RL框架中的参考实现使您能够为自身的RL工作负载采用并扩展此方法。
要在NeMo RL中启用reshard refit路径,请使用以下配置:
policy:
  generation:
    colocated:
      enabled: false
    refit_transport: nccl_reshard
NeMo RL refit指南和NCCL Reshard配置要求描述了此功能支持的后端、布局和精度模式。
致谢
我们衷心感谢Ke Wen、Ching-Hsiang Chu、Guyue Huang、Seonjin Na和Nitin对NCCL M2N Reshard以及NeMo RL中nccl-reshard权重refit的贡献。